수학 ① 확률과 최대우도
World Model 은 미래를 하나의 숫자 가 아니라 확률 분포 로 예측하고, 그 모델은 최대우도 라는 원리로 학습됩니다. 딥러닝에서 아무렇지 않게 쓰는 평균 제곱 오차(MSE)와 교차 엔트로피 손실도 사실은 모두 최대우도에서 나온 것입니다. 이 장에서는 확률의 기초부터 시작해 이 사실을 한 줄씩 유도합니다.
- 확률변수, 확률질량함수 · 확률밀도함수 (밀도는 1 을 넘을 수 있다)
- 결합 · 주변 · 조건부 확률, 곱셈 법칙과 연쇄 법칙, 독립
- 베이즈 정리의 유도와 계산
- 기댓값 · 분산의 정의와 성질, 전체 기댓값의 법칙, 몬테카를로 추정과 큰 수의 법칙
- 가우시안 분포: 식의 각 부분, 정규화 상수 유도, 샘플링 $\mu + \sigma\epsilon$, 로그 밀도
- 최대우도 추정, 그리고 MSE · 이진 교차 엔트로피 · 교차 엔트로피가 모두 “음의 로그 가능도” 라는 사실
왜 확률이 필요한가
1장에서 World Model 이 “다음 상태를 예측하는 함수” 라고 했습니다. 그런데 세상에는 세 종류의 불확실성이 있습니다.
- 세상 자체의 무작위성. 주사위, 바람, 다른 사람의 선택. 같은 상황에서도 결과가 매번 다릅니다.
- 보이지 않는 정보. 그림 한 장으로는 진자의 속도를 모릅니다. 모르는 부분 때문에 다음 장면이 여러 가지로 가능해 보입니다.
- 모델 자신의 무지. 본 적 없는 상황에서는 모델도 확신할 수 없습니다.
이런 불확실성을 정직하게 다루려면 “다음 상태는 0.3 이다” 대신 “다음 상태는 0.3 근처일 가능성이 크고, 0.5 일 수도 있다” 처럼 말해야 합니다. 이렇게 “어떤 값이 얼마나 그럴듯한지” 를 나타내는 도구가 확률 분포 입니다. 이 장의 개념들이 뒤에서 어디에 쓰이는지 미리 보면 다음과 같습니다.
| 이 장의 개념 | 쓰이는 곳 |
|---|---|
| 조건부 확률 $p(y \mid x)$ | World Model $p_\theta(s_{t+1} \mid s_t, a_t)$, 정책 $\pi(a \mid s)$ — 모든 장 |
| 베이즈 정리 | 그림을 보고 숨은 상태를 추측하는 인코더 $q_\phi(z \mid o)$ (8 · 11장), POMDP 의 믿음 상태 (5장) |
| 기댓값 · 몬테카를로 | 리턴의 기댓값 (5장), ELBO 추정 (8장), λ-리턴 (12장) |
| 가우시안 · $\mu + \sigma\epsilon$ | 확률적 동역학 (7장), VAE 의 재매개변수화 (8장), RSSM (11장), 행동 분포 (12장) |
| 최대우도 · 음의 로그 가능도 | 모든 World Model 의 학습 손실 |
확률변수와 확률 분포
확률변수random variable 는 “무작위 실험의 결과에 붙인 숫자” 입니다. 주사위를 던져 나온 눈을 $X$ 라고 하면 $X$ 는 1 – 6 중 하나의 값을 가집니다. 관례상 확률변수 자체는 대문자 $X$, 그것이 실제로 가진 값은 소문자 $x$ 로 씁니다. (이 튜토리얼에서는 문맥이 분명하면 둘을 굳이 구별하지 않고 소문자로 쓰기도 합니다.)
이산 확률변수와 확률질량함수
값이 하나, 둘, 셋… 셀 수 있게 떨어져 있으면 이산(discrete) 확률변수입니다. 각 값의 확률을 주는 함수를 확률질량함수probability mass function, PMF 라고 하고 $P(X = x)$ 또는 줄여서 $p(x)$ 로 씁니다. 확률질량함수는 두 조건을 지켜야 합니다.
$$ 0 \le p(x) \le 1, \qquad \sum_{x} p(x) = 1 $$공정한 주사위라면 $p(1) = p(2) = \cdots = p(6) = \tfrac{1}{6}$ 이고, 여섯 개를 더하면 $6 \times \tfrac{1}{6} = 1$ 입니다.
연속 확률변수와 확률밀도함수
진자의 각도처럼 값이 실수 전체에 걸쳐 연속적이면 연속(continuous) 확률변수입니다. 연속에서는 “정확히 0.3000… 이 나올 확률” 이 0 입니다. 값이 빈틈없이 이어져 있어 셀 수 없이 많으므로, 점 하나하나에 0 보다 큰 확률을 주면 합이 1 을 넘어 버리기 때문입니다. 대신 구간 의 확률을 말하고, 이를 위해 확률밀도함수probability density function, PDF $p(x)$ 를 씁니다.
$$ P(a \le X \le b) = \int_a^b p(x)\,dx $$$\int_a^b p(x)\,dx$ 는 “$a$ 에서 $b$ 까지 $p(x)$ 그래프 아래의 넓이” 입니다. 적분이 낯설다면 이렇게 생각하세요. 구간을 폭 $\Delta x$ 인 얇은 막대 여러 개로 자르고, 각 막대의 넓이 $p(x)\,\Delta x$ 를 모두 더한 뒤, 막대를 한없이 얇게 만든 것입니다.
$$ \int_a^b p(x)\,dx = \lim_{\Delta x \to 0} \sum_{i} p(x_i)\,\Delta x $$밀도함수의 조건은 다음과 같습니다. 확률질량함수의 합이 적분으로 바뀌었을 뿐입니다.
$$ p(x) \ge 0, \qquad \int_{-\infty}^{\infty} p(x)\,dx = 1 $$확률질량은 1 을 넘을 수 없지만 확률밀도는 1 을 넘을 수 있습니다. 밀도는 “단위 길이당 확률” 이기 때문입니다. 아래 풀이처럼 좁은 구간에 확률 1 을 몰아넣으면 높이가 커집니다.
실습 코드로도 확인해 봅니다. 표준편차 0.2 인 좁은 가우시안(뒤에서 자세히 다룹니다)의 최고 높이는 약 2 이고, 밑넓이는 1 입니다.
[밀도] 최댓값 p(0) ≈ 1.9946 (1 보다 크다!), 밑넓이 ≈ 1.0000
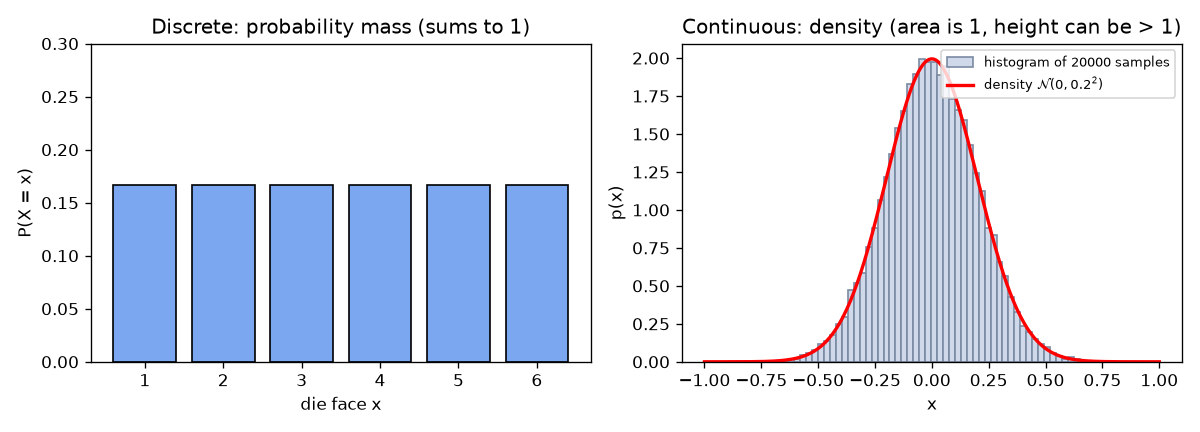
코드에서 np.sum(pdf) * (grid[1] - grid[0]) 가 바로 “높이 × 폭을 모두 더한” 리만 합, 곧 적분의 근삿값입니다.
여러 확률변수: 결합 · 주변 · 조건부
World Model 은 늘 여러 변수(지금 상태, 행동, 다음 상태)를 함께 다룹니다. 두 확률변수를 함께 보는 법을 작은 표로 익혀 봅시다. 날씨 $X$(맑음 · 비)와 우산 $Y$(안 씀 · 씀)를 100일 동안 기록해 비율로 정리했다고 합시다.
| 안 씀 | 씀 | 합 (주변 확률 $p(x)$) | |
|---|---|---|---|
| 맑음 | 0.45 | 0.05 | 0.50 |
| 비 | 0.10 | 0.40 | 0.50 |
| 합 (주변 확률 $p(y)$) | 0.55 | 0.45 | 1.00 |
- 결합 확률joint probability $p(x, y)$: 두 일이 함께 일어날 확률. 예: $p(\text{비}, \text{씀}) = 0.40$. 표의 안쪽 네 칸이 결합 분포이고 합은 1 입니다.
- 주변 확률marginal probability $p(x)$: 다른 변수는 신경 쓰지 않을 때의 확률. 다른 변수의 모든 경우를 더해서 없앱니다. 이 계산을 주변화marginalization 라고 합니다.
예: $p(\text{비}) = p(\text{비}, \text{안 씀}) + p(\text{비}, \text{씀}) = 0.10 + 0.40 = 0.50$. 표의 오른쪽 · 아래쪽 “합” 이 주변 확률입니다 (표의 가장자리(margin)에 적힌다고 해서 marginal 이라고 부릅니다).
- 조건부 확률conditional probability $p(y \mid x)$: $x$ 가 일어났다는 것을 알 때 $y$ 의 확률. 정의는 다음과 같습니다.
뜻: “비가 온 날만 모아 놓고(분모), 그중 우산을 쓴 날의 비율(분자)”. 비 오는 날 우산을 쓸 확률은 $p(\text{씀} \mid \text{비}) = 0.40 / 0.50 = 0.8$ 입니다. 조건부 확률도 $y$ 에 대해 더하면 1 입니다: $p(\text{안 씀} \mid \text{비}) + p(\text{씀} \mid \text{비}) = 0.2 + 0.8 = 1$.
곱셈 법칙과 연쇄 법칙
조건부 확률의 정의에서 양변에 $p(x)$ 를 곱하면 곱셈 법칙 을 얻습니다.
$$ p(x, y) = p(y \mid x)\, p(x) = p(x \mid y)\, p(y) $$두 번째 등호는 $x$ 와 $y$ 의 역할을 바꿔 같은 정의를 쓴 것입니다. 변수가 셋 이상이면 곱셈 법칙을 거듭 써서 연쇄 법칙(chain rule)을 얻습니다.
이 식은 World Model 에서 아주 중요합니다. 상태가 시간 순서로 $s_1, s_2, \dots$ 처럼 이어질 때, 연쇄 법칙은 “전체 이야기의 확률 = 한 장면씩 다음 장면의 확률을 곱한 것” 이라는 뜻입니다. 여기에 5장에서 배울 마르코프 성질(다음 상태는 바로 앞 상태 · 행동에만 달려 있다)을 더하면 $p(s_{t+1} \mid s_1, \dots, s_t, a_1, \dots, a_t) = p(s_{t+1} \mid s_t, a_t)$ 가 되어, 한 에피소드의 확률이 World Model 이 예측하는 한 스텝 전이 확률들의 곱이 됩니다. 11장의 순차 ELBO 는 바로 이 분해에서 출발합니다.
독립
두 확률변수가 서로에 대해 아무 정보도 주지 않으면 독립independent 이라고 합니다. 식으로는
$$ p(x, y) = p(x)\, p(y) \quad\Longleftrightarrow\quad p(y \mid x) = p(y) $$두 식이 같은 말인 까닭: 왼쪽 식을 조건부 확률의 정의에 넣으면 $p(y \mid x) = p(x)p(y)/p(x) = p(y)$ 입니다. 날씨와 우산은 독립일까요? $p(\text{비})\,p(\text{씀}) = 0.5 \times 0.45 = 0.225$ 인데 실제 $p(\text{비}, \text{씀}) = 0.40$ 이므로 독립이 아닙니다. 반면 주사위를 두 번 던진 결과는 독립입니다. 최대우도 추정에서 “데이터가 서로 독립” 이라는 가정을 곧 쓰게 됩니다.
베이즈 정리
베이즈 정리Bayes' theorem 는 “$x$ 가 주어졌을 때 $y$ 의 확률” 을 “$y$ 가 주어졌을 때 $x$ 의 확률” 로 뒤집는 공식입니다. 곱셈 법칙에서 바로 나옵니다.
각 부분에는 이름이 있습니다. 숨은 원인을 $y$, 관찰한 증거를 $x$ 라고 생각하면 이해하기 쉽습니다.
- $p(y)$: 사전 확률prior. 증거를 보기 전의 믿음.
- $p(x \mid y)$: 가능도likelihood. 원인이 $y$ 라면 증거 $x$ 가 나올 확률.
- $p(x)$: 증거evidence. 원인을 모를 때 $x$ 가 나올 전체 확률.
- $p(y \mid x)$: 사후 확률posterior. 증거를 본 뒤 고친 믿음.
이미 알고 있는 것 $C$ 가 하나 더 있을 때에도, 모든 확률에 같은 조건 $C$ 를 붙이면 베이즈 정리는 그대로 성립합니다. $C$ 가 주어진 세상 안에서 곱셈 법칙 $p(A, B \mid C) = p(A \mid B, C)\,p(B \mid C) = p(B \mid A, C)\,p(A \mid C)$ 를 쓰고 양변을 $p(B \mid C)$ 로 나누면 됩니다.
$$ p(A \mid B, C) = \frac{p(B \mid A, C)\, p(A \mid C)}{p(B \mid C)} $$5장에서 “지금까지의 기록 $C$” 를 조건으로 둔 채 새 관측으로 믿음을 고칠 때 이 꼴을 씁니다.
예제: 검사에서 양성이 나왔다면
어떤 병은 100명 중 1명이 걸립니다. 검사는 병이 있으면 99% 확률로 양성, 건강해도 5% 확률로 (잘못) 양성이 나옵니다. 내 검사가 양성일 때 정말 병이 있을 확률은?
직관적으로 보면 이렇습니다. 1만 명 중 환자는 100명이고 그중 99명이 양성입니다. 건강한 9900명 중 5%인 495명도 양성입니다. 양성 594명 중 환자는 99명, $99/594 \approx 0.167$. 병 자체가 드물기(사전 확률이 작기) 때문에 오진 양성이 훨씬 많은 것입니다. 시뮬레이션으로 확인해 봅니다.
[베이즈] 공식     P(양성) = 0.0594,  P(병 | 양성) = 0.1667
[베이즈] 시뮬레이션 양성 59489 명 중 병 9880 명 → P(병 | 양성) ≈ 0.1661
100만 명을 만들어 직접 세어 보니 공식과 거의 같은 0.1661 이 나옵니다. np.where(sick, u < p_pos_d, u < p_pos_nd) 는 “병이면 99% 확률로, 아니면 5% 확률로 양성” 을 그대로 옮긴 줄입니다.
그림을 보는 World Model 에서 “숨은 원인” 은 잠재 상태 $z$(예: 진자의 각도), “증거” 는 그림 $o$ 입니다. 우리가 알고 싶은 것은 사후 확률 $p(z \mid o)$, 즉 “이 그림을 만든 상태가 무엇이었을까” 입니다. 그런데 분모 $p(o) = \int p(o \mid z) p(z)\,dz$ 의 적분을 계산할 수 없어서, 8장에서는 신경망 $q_\phi(z \mid o)$ 로 사후 확률을 근사 합니다(8장은 VAE 논문의 관례대로 관측을 $o$ 대신 $x$ 로 씁니다).
기댓값
기댓값expectation, expected value 은 “확률로 가중한 평균” 입니다. 같은 실험을 아주 많이 되풀이했을 때 결과의 평균이 다가가는 값이기도 합니다.
$$ \E[X] = \sum_x x\, p(x) \qquad\text{(연속이면)}\qquad \E[X] = \int x\, p(x)\,dx $$주사위: $\E[X] = 1 \cdot \tfrac16 + 2 \cdot \tfrac16 + \cdots + 6 \cdot \tfrac16 = \tfrac{21}{6} = 3.5$. 기댓값 3.5 는 실제로 나올 수 없는 값이라는 점도 기억해 두세요(1장 “확률성과 다봉성” 에서 본, 평균이 일어날 수 없는 값이 되는 문제).
확률변수의 함수 $f(X)$ 의 기댓값은 각 값에서의 $f$ 를 확률로 가중해 더합니다. 이것을 $\E_{x \sim p}[f(x)]$ 처럼 “어떤 분포에 대한 기댓값인지” 를 아래에 적어 쓰기도 합니다.
$$ \E_{x \sim p}[f(x)] = \sum_x f(x)\, p(x) $$예: 주사위 눈의 제곱 $\E[X^2] = (1 + 4 + 9 + 16 + 25 + 36)/6 = 91/6 \approx 15.17$. 이 값은 곧 분산 계산에 씁니다.
기댓값의 선형성
기댓값의 가장 중요한 성질은 선형성 입니다. 상수배와 더하기를 기댓값 밖으로 꺼낼 수 있습니다.
곱은 다릅니다. $\E[XY] = \E[X]\,\E[Y]$ 는 일반적으로는 성립하지 않고, $X, Y$ 가 독립이면 성립합니다: $\sum_x\sum_y xy\,p(x)p(y) = (\sum_x x p(x))(\sum_y y p(y))$ 처럼 결합 확률이 곱으로 쪼개지면 두 합이 분리되기 때문입니다.
조건부 기댓값과 전체 기댓값의 법칙
$Y = y$ 라는 것을 알 때의 $X$ 의 평균을 조건부 기댓값conditional expectation 이라고 합니다. 보통의 기댓값에서 확률 $p(x)$ 자리에 조건부 확률 $p(x \mid y)$ 를 넣은 것입니다.
$$ \E[X \mid Y = y] = \sum_x x\, p(x \mid y) $$줄여서 $\E[X \mid y]$ 로도 씁니다. 경우를 나눠 구한 이 평균들을 각 경우의 확률로 가중해 다시 평균 내면 전체 평균이 됩니다. 이것을 전체 기댓값의 법칙law of total expectation 이라고 합니다.
날씨 · 우산 표로 확인해 봅니다(표에서는 날씨가 $X$, 우산이 $Y$ 이므로 법칙의 $X$ 와 $Y$ 자리를 서로 바꿔 씁니다). 우산을 쓰면 $Y = 1$, 안 쓰면 $Y = 0$ 이라고 하면 $\E[Y \mid \text{맑음}] = 0.05/0.50 = 0.1$, $\E[Y \mid \text{비}] = 0.40/0.50 = 0.8$ 입니다. 법칙대로 계산하면 $\E[Y] = 0.5 \times 0.1 + 0.5 \times 0.8 = 0.45$ 로, 표에서 바로 읽은 $p(\text{씀}) = 0.45$ 와 같습니다. 5장의 벨만 방정식(“첫 행동이 무엇이었나” 로 경우 나누기)과 7장의 앙상블(“어느 모델이 뽑혔나” 로 경우 나누기)이 이 법칙을 씁니다.
분산과 표준편차
분산variance 은 값이 평균에서 얼마나 퍼져 있는지를 잽니다. 평균에서의 거리를 제곱해 평균 낸 값입니다. $\mu = \E[X]$ 라고 쓰면
$$ \Var[X] = \E\big[(X - \mu)^2\big], \qquad \sigma = \sqrt{\Var[X]}\ \ \text{(표준편차, standard deviation)} $$계산할 때는 다음 공식이 더 편합니다.
주사위: $\Var[X] = 91/6 - 3.5^2 = 15.1667 - 12.25 = 2.9167$ ($= 35/12$), 표준편차 $\sigma = \sqrt{2.9167} \approx 1.708$.
분산의 성질 두 가지를 더 유도해 둡니다. 곧 몬테카를로에서 씁니다.
몬테카를로 추정과 큰 수의 법칙
기댓값 $\E_{x \sim p}[f(x)]$ 를 정확히 계산하려면 모든 $x$ 에 대해 더하거나 적분해야 하는데, 대부분의 경우 불가능합니다. 대신 분포에서 표본을 $N$ 개 뽑아 평균을 냅니다. 이것을 몬테카를로 추정Monte Carlo estimation 이라고 합니다.
$$ \E_{x \sim p}[f(x)] \approx \hat{\mu}_N = \frac{1}{N} \sum_{i=1}^{N} f(x_i), \qquad x_i \sim p \ \text{(서로 독립)} $$이 추정이 왜 믿을 만한지 두 가지를 유도합니다. 계산을 줄이려고 $Y_i = f(x_i)$, $\mu = \E[Y_i]$, $\sigma^2 = \Var[Y_i]$ 로 씁니다.
표본 평균이 $N \to \infty$ 일 때 기댓값에 다가가는 것을 큰 수의 법칙law of large numbers 이라고 하며, 위의 분산 공식이 그 이유를 보여 줍니다. 주사위로 확인해 봅니다. 주사위의 $\sigma = 1.708$ 이므로 100번 평균의 표준편차는 $1.708/\sqrt{100} = 0.171$ 이어야 합니다.
[큰 수의 법칙] 주사위 E[X] = 3.5, Var[X] = 2.9167, σ = 1.7078
[큰 수의 법칙] N=   10: 실험 표준편차 0.5440, 이론 σ/√N 0.5401
[큰 수의 법칙] N=  100: 실험 표준편차 0.1681, 이론 σ/√N 0.1708
[큰 수의 법칙] N= 1000: 실험 표준편차 0.0537, 이론 σ/√N 0.0540
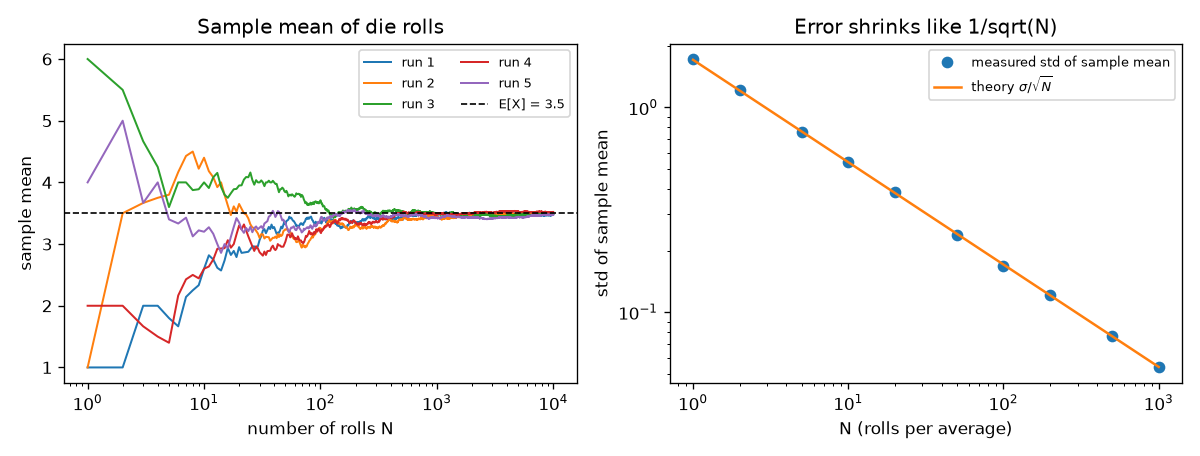
코드의 np.cumsum(rolls) / np.arange(1, n_rolls + 1) 는 “지금까지의 합 ÷ 지금까지의 횟수”, 곧 누적 평균입니다.
오른쪽 그래프는 표본 평균을 4000번 만들어 그 표준편차를 잰 것입니다.
미니배치 학습(4장)도 몬테카를로입니다. 전체 데이터의 평균 손실 대신, 무작위로 뽑은 데이터 몇십 개(배치 하나)의 평균 손실을 씁니다. 8장의 VAE 는 기댓값 $\E_{q}[\log p(o \mid z)]$ 를 표본 단 1개로 추정하는데, 그래도 학습이 되는 것은 수많은 반복에 걸쳐 오차가 평균으로 지워지기 때문입니다.
가우시안(정규) 분포
딥러닝과 World Model 에서 가장 많이 쓰는 연속 분포가 가우시안 분포Gaussian distribution, 또는 정규 분포normal distribution 입니다. 평균 $\mu$, 분산 $\sigma^2$ 인 가우시안의 밀도는 다음과 같습니다.
$$ \Normal(x;\, \mu, \sigma^2) = \frac{1}{\sigma\sqrt{2\pi}} \exp\!\left(-\frac{(x - \mu)^2}{2\sigma^2}\right) $$$\Normal(x;\,\mu,\sigma^2)$ 에서 세미콜론 앞의 $x$ 는 밀도를 재는 자리, 뒤의 $\mu, \sigma^2$ 는 분포를 정하는 매개변수입니다. $x \sim \Normal(\mu, \sigma^2)$ 처럼 분포 자체를 가리킬 때는 $x;$ 를 생략합니다. $\exp(u)$ 는 $e^u$ 를 읽기 쉽게 쓴 것입니다. 식을 안쪽부터 하나씩 해부해 봅시다.
- $(x - \mu)^2$: $x$ 가 평균 $\mu$ 에서 떨어진 거리의 제곱. 평균에서 0, 멀어질수록 커집니다. 왼쪽 · 오른쪽 대칭입니다.
- $\dfrac{(x-\mu)^2}{2\sigma^2}$: 거리를 “$\sigma$ 단위” 로 잽니다. $\sigma$ 가 크면 같은 거리도 작은 값이 되어 곡선이 넓게 퍼집니다.
- $\exp(-\,\cdot\,)$: 0 에서 1, 커질수록 빠르게 0 으로. 그래서 평균에서 가장 높고 양옆으로 빠르게 떨어지는 종 모양 이 됩니다.
- $\dfrac{1}{\sigma\sqrt{2\pi}}$: 곡선 아래 넓이를 정확히 1 로 맞추는 정규화 상수. 아래에서 유도합니다.
숫자 예: 표준 정규 분포($\mu = 0$, $\sigma = 1$)에서 $\Normal(0; 0, 1) = 1/\sqrt{2\pi} \approx 0.3989$, $\Normal(1; 0, 1) = 0.3989 \times e^{-0.5} \approx 0.2420$. $\sigma = 0.2$ 이면 $\Normal(0; 0, 0.04) = 1/(0.2\sqrt{2\pi}) \approx 1.995$ — 그림 2-1 의 높이 2 가 바로 이것입니다.
정규화 상수는 어디서 왔나
“넓이 = 1” 이 되려면 $\int_{-\infty}^{\infty} e^{-x^2/2}\,dx$ 의 값을 알아야 합니다. 이 적분은 고등학교 방법으로는 풀리지 않지만, 아주 아름다운 요령으로 풀립니다. 처음 읽을 때는 결과($\sqrt{2\pi}$)만 가져가도 됩니다.
표준 정규 분포와 샘플링 μ + σε
$\mu = 0$, $\sigma = 1$ 인 가우시안을 표준 정규 분포 라 하고, 여기서 뽑은 값을 흔히 $\epsilon \sim \Normal(0, 1)$ 로 씁니다. 어떤 가우시안에서든 표본을 뽑는 방법은 아주 간단합니다.
$$ x = \mu + \sigma\,\epsilon, \qquad \epsilon \sim \Normal(0, 1) \quad\Longrightarrow\quad x \sim \Normal(\mu, \sigma^2) $$이 식은 8장 VAE 의 핵심인 재매개변수화 의 바탕이므로 꼼꼼히 확인해 둡니다. 먼저 $\epsilon$ 의 평균이 0, 분산이 1 임을 보이고, 그다음 $x$ 의 평균 · 분산 · 모양을 확인합니다. $\varphi(t) = \frac{1}{\sqrt{2\pi}} e^{-t^2/2}$ 를 표준 정규 밀도라고 부르겠습니다.
가우시안에서 값의 약 68% 는 $\mu \pm \sigma$ 안에, 약 95% 는 $\mu \pm 2\sigma$ 안에, 약 99.7% 는 $\mu \pm 3\sigma$ 안에 있습니다. 그래서 $\sigma$ 는 “예측이 이 정도 폭으로 흔들릴 수 있다” 는 불확실성의 크기로 읽을 수 있습니다. 7장에서 World Model 이 $\mu$ 와 함께 $\sigma$ 를 예측하게 만드는 까닭이 여기에 있습니다.
여러 차원: 대각 가우시안
World Model 이 예측하는 것은 숫자 하나가 아니라 벡터(진자라면 3개, 잠재 변수라면 30개 남짓)입니다. 가장 흔한 방법은 각 차원을 서로 독립인 가우시안 으로 보는 것입니다. 각 차원 $d$ 가 평균 $\mu_d$, 표준편차 $\sigma_d$ 를 가지면, 독립이므로 결합 밀도는 곱입니다. 이것을 대각 가우시안diagonal Gaussian 이라고 합니다. 아래 식의 $\diag(\sigma^2)$ 는 분산 $\sigma_1^2, \dots, \sigma_D^2$ 을 표의 대각선에 늘어놓고 나머지 칸은 모두 0 으로 둔다는 표시입니다. 대각선 밖의 칸은 두 차원이 함께 움직이는 정도(공분산)를 적는 자리인데, 독립이라 모두 0 입니다. 이 표를 공분산 행렬이라고 부르지만 행렬 계산은 몰라도 됩니다.
$$ \Normal(x;\, \mu, \diag(\sigma^2)) = \prod_{d=1}^{D} \Normal(x_d;\, \mu_d, \sigma_d^2) = \frac{1}{(2\pi)^{D/2} \prod_d \sigma_d} \exp\!\left(-\sum_{d=1}^{D} \frac{(x_d - \mu_d)^2}{2\sigma_d^2}\right) $$오른쪽 식은 $D$ 개의 정규화 상수를 곱해 모으고($\sqrt{2\pi}$ 가 $D$ 번 곱해져 $(2\pi)^{D/2}$), 지수 함수들을 $e^a e^b = e^{a+b}$ 로 합친 것입니다.
로그 밀도
실제 계산에서는 밀도 자체보다 로그 밀도 를 씁니다(이유는 곧 최대우도에서 나옵니다). 로그의 성질 세 가지를 쓰면 곱 · 나눗셈 · 지수가 모두 덧셈으로 풀립니다.
| 로그의 성질 | 예 |
|---|---|
| $\log(ab) = \log a + \log b$ | $\log(2 \times 3) = \log 2 + \log 3$ |
| $\log(a/b) = \log a - \log b$, 특히 $\log(1/a) = -\log a$ | $\log(1/\sigma) = -\log\sigma$ |
| $\log(a^k) = k\log a$, 특히 $\log\sqrt{a} = \tfrac12\log a$ | $\log\sqrt{2\pi} = \tfrac12\log(2\pi)$ |
| $\log(e^u) = u$ | $\log e^{-3} = -3$ |
숫자로 확인: $x = 1$, $\mu = 0$, $\sigma = 1$ 이면 $-0.9189 - 0 - 0.5 = -1.4189$ 이고, $e^{-1.4189} = 0.2420$ 으로 앞에서 구한 밀도와 같습니다. 대각 가우시안의 로그 밀도는 차원마다의 로그 밀도를 더한 것 입니다(곱의 로그 = 로그의 합).
$$ \log \Normal(x;\, \mu, \diag(\sigma^2)) = -\frac{D}{2}\log(2\pi) - \sum_{d=1}^D \log\sigma_d - \sum_{d=1}^D \frac{(x_d - \mu_d)^2}{2\sigma_d^2} $$예: $D = 2$, $x = (1, 0)$, $\mu = (0, 0)$, $\sigma = (1, 2)$ 이면 $-\log(2\pi) - (\log 1 + \log 2) - (\tfrac{1}{2} + 0) = -1.8379 - 0.6931 - 0.5 = -3.0310$.
가능도와 최대우도 추정
이제 이 장의 핵심입니다. 데이터 $x_1, \dots, x_N$ 을 가지고 있고, 매개변수 $\theta$ 로 정해지는 모델 분포 $p_\theta(x)$ 가 있습니다(예: 가우시안이면 $\theta = (\mu, \sigma)$). 어떤 $\theta$ 가 “좋은” 것일까요? 가장 자연스러운 답은 관찰된 데이터를 가장 그럴듯하게 만드는 $\theta$ 입니다.
데이터가 서로 독립으로 같은 분포에서 나왔다고 가정하면(이 가정을 i.i.d., independent and identically distributed 라고 부릅니다), 데이터 전체의 확률은 곱입니다. 이것을 $\theta$ 의 함수로 본 것을 가능도likelihood 라고 합니다.
$$ L(\theta) = p_\theta(x_1, \dots, x_N) = \prod_{i=1}^{N} p_\theta(x_i) $$가능도를 최대로 만드는 $\theta$ 를 찾는 방법을 최대우도 추정maximum likelihood estimation, MLE 이라고 합니다.
왜 로그를 씌우는가
실제로는 가능도 대신 로그 가능도 를 최대화합니다. 이유는 세 가지입니다.
- 숫자가 사라지지 않게. 확률 0.1 짜리 데이터 1000개의 곱은 $10^{-1000}$ 인데, 컴퓨터의 실수(float64)는 약 $10^{-308}$ 보다 작은 수를 제대로 담지 못하고, 약 $10^{-324}$ 보다 작으면 아예 0 으로 만들어 버립니다. 로그를 씌우면 $1000 \times \log 0.1 = -2302.6$ 으로 아무 문제가 없습니다.
- 곱이 합이 된다. $\log \prod_i p_\theta(x_i) = \sum_i \log p_\theta(x_i)$. 합은 미분하기도, 미니배치로 나누기도 쉽습니다.
- 답이 바뀌지 않는다. $\log$ 는 증가 함수(큰 수의 로그가 더 큼)이므로, $L(\theta)$ 를 최대로 만드는 $\theta$ 와 $\log L(\theta)$ 를 최대로 만드는 $\theta$ 는 같습니다.
딥러닝은 관례상 “최소화” 를 하므로 부호를 바꾼 음의 로그 가능도negative log-likelihood, NLL 을 손실로 씁니다.
$$ \hat\theta_{\text{MLE}} = \argmax_\theta \sum_{i=1}^N \log p_\theta(x_i) = \argmin_\theta \underbrace{\left(-\frac{1}{N}\sum_{i=1}^N \log p_\theta(x_i)\right)}_{\text{NLL (평균)}} $$$1/N$ 을 곱해도 최적의 $\theta$ 는 같습니다. 평균으로 쓰면 데이터 수와 상관없이 손실의 크기가 비슷해서 편합니다.
예제 1: 동전의 최대우도
동전을 $N$ 번 던져 앞면이 $k$ 번 나왔습니다. 앞면 확률 $p$ 의 최대우도 추정값은? 앞면($x = 1$)의 확률 $p$, 뒷면($x = 0$)의 확률 $1 - p$ 인 분포를 베르누이 분포Bernoulli distribution 라고 합니다.
예제 2: 가우시안의 최대우도
데이터 $x_1, \dots, x_N$ 에 가우시안 $\Normal(\mu, \sigma^2)$ 를 맞춥니다. 앞에서 구한 로그 밀도를 데이터마다 더하면 로그 가능도는
$$ \log L(\mu, \sigma) = \sum_{i=1}^N \log\Normal(x_i; \mu, \sigma^2) = -\frac{N}{2}\log(2\pi) - N\log\sigma - \frac{1}{2\sigma^2}\sum_{i=1}^N (x_i - \mu)^2 $$(앞의 두 항은 $i$ 와 상관없으므로 $N$ 번 더해져 $N$ 배가 되었습니다.) 이것을 $\mu$ 와 $\sigma$ 로 각각 미분해 0 으로 놓습니다.
통계 수업에서는 표본 분산을 $N-1$ 로 나누라고 배웁니다. $N$ 으로 나눈 최대우도 추정값은 평균적으로 진짜 분산보다 조금 작게 나오기 때문입니다(편향). $N$ 이 크면 차이가 거의 없으므로 딥러닝에서는 신경 쓰지 않는 경우가 많습니다.
코드로 세 가지 방법(공식, 격자 탐색, 경사 하강)을 비교합니다. 진짜 $\mu = 3$, $\sigma = 2$ 인 가우시안에서 1000개를 뽑았습니다.
[MLE] 진짜 μ=3.0, σ=2.0  /  공식 μ̂=2.9492, σ̂=2.0321
[MLE] 격자 탐색   μ*=2.9500, σ*=2.0325
[MLE] 경사 하강   μ*=2.9492, σ*=2.0321
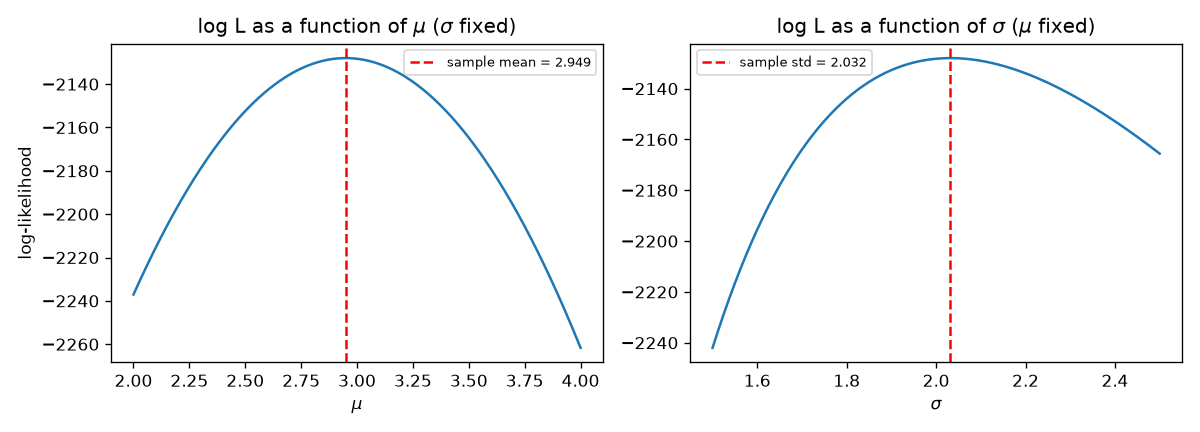
세 방법이 모두 같은 답을 냅니다. 진짜 값(3, 2)과 조금 다른 것은 표본이 1000개뿐이라서입니다(몬테카를로의 $\sigma/\sqrt{N}$ 오차).
경사 하강 부분(4장에서 배울 Adam 이라는 경사 하강법의 한 갈래를 씁니다)에서 log_sigma_p 를 학습하고 exp() 로 $\sigma$ 를 만드는 것에 주목하세요. $\sigma$ 는 늘 양수여야 하는데, $\log\sigma$ 는 아무 실수나 되어도
$\sigma = e^{\log\sigma} \gt 0$ 이 보장됩니다. World Model 이 분산을 예측할 때(7 · 8장) 똑같은 요령을 씁니다. 손실 줄
0.5 * math.log(2 * math.pi) + log_sigma_p + (xt - mu_p) ** 2 / (2 * sigma_p**2) 는 위에서 유도한 가우시안 NLL 을 그대로 옮긴 것입니다.
손실 함수의 정체: 음의 로그 가능도
지금까지는 데이터 $x$ 하나의 분포를 맞췄습니다. 딥러닝 · World Model 은 입력 $x$ 가 주어졌을 때 출력 $y$ 의 조건부 분포 $p_\theta(y \mid x)$ 를 배웁니다. World Model 이라면 $x = (s_t, a_t)$, $y = s_{t+1}$ 입니다. 신경망이 분포의 매개변수(예: 평균)를 출력하고, 데이터 $(x_i, y_i)$ 에 대한 NLL 을 최소화합니다. 이제 익숙한 손실 함수들이 사실 모두 NLL 이라는 것을 보이겠습니다.
평균 제곱 오차 = 가우시안 NLL
신경망 $f_\theta(x)$ 가 평균을 출력하고 표준편차는 $\sigma$ 로 고정된 가우시안을 생각합시다: $p_\theta(y \mid x) = \Normal(y;\, f_\theta(x), \sigma^2)$.
$\sigma = 1$ 이면 $\text{NLL} = \text{MSE}/2 + \frac12\log(2\pi) = \text{MSE}/2 + 0.9189$ 입니다. 이 절 끝의 코드에서 숫자로 확인합니다.
6장에서 진자 World Model 을 MSE 로 학습하는데, 이는 “다음 상태는 예측값을 중심으로 늘 같은 폭($\sigma$)으로 흔들리는 가우시안” 이라고 가정한 것과 같습니다. 어떤 곳은 예측이 쉽고 어떤 곳은 어려운데도 폭이 같다고 가정하는 것이 한계이며, 7장에서는 $\sigma$ 도 신경망이 예측하게 바꿉니다.
미리 보기: σ 까지 배우면
$\sigma$ 를 상수로 두지 않고 학습하면 NLL 의 $\log\sigma$ 항이 살아납니다. 데이터 하나에 대해 $\ell(\sigma) = \log\sigma + \frac{\delta^2}{2\sigma^2}$ ($\delta$ = 예측 오차. 자연상수 $e$ 와 헷갈리지 않게 $\delta$ 로 씁니다)를 $\sigma$ 로 미분하면
$\log\sigma$ 항은 “모른다고 해서 $\sigma$ 를 무작정 키우는 것” 을 막는 벌점이고, $\delta^2/(2\sigma^2)$ 항은 “자신 있는 척 $\sigma$ 를 줄였다가 틀리는 것” 을 벌합니다. 두 힘의 균형이 정직한 불확실성을 만듭니다. 7장에서 다시 만납니다.
이진 교차 엔트로피 = 베르누이 NLL
출력이 0 또는 1 인 경우(예: 픽셀이 켜졌나, 에피소드가 끝났나)에는 신경망이 “1 일 확률” $p = f_\theta(x) \in (0, 1)$ 를 출력하는 베르누이 모델을 씁니다.
F.binary_cross_entropy 와 정확히 같은 식입니다.손으로 계산해 봅시다. 정답 $y = (1, 0, 1, 1)$, 모델 확률 $p = (0.9, 0.2, 0.6, 0.99)$ 이면 각 항은 $-\log 0.9 = 0.1054$, $-\log(1 - 0.2) = 0.2231$, $-\log 0.6 = 0.5108$, $-\log 0.99 = 0.0101$ 이고 평균은 $0.8494/4 = 0.2123$ 입니다. 8장의 VAE 는 그림의 각 픽셀을 이런 베르누이로 보고 복원 손실을 계산합니다.
교차 엔트로피 = 범주형 NLL
출력이 $K$ 개 범주 중 하나인 경우, 신경망은 범주마다 아무 실수나 되는 점수 $l_1, \dots, l_K$ (로짓logit)를 출력하고, 소프트맥스softmax 로 확률로 바꿉니다.
$$ \pi_k = \operatorname{softmax}(l)_k = \frac{e^{l_k}}{\sum_{j=1}^{K} e^{l_j}} $$$e^{l_k}$ 는 늘 양수이고, 전체 합으로 나누었으니 $\pi_1 + \cdots + \pi_K = 1$ 입니다. 점수가 클수록 확률이 큽니다.
F.cross_entropy(logits, target) 가 계산하는 식입니다. 확률이 아니라 로짓을 넣는다는 점에 주의하세요. $l^{(i)}$ 는 $i$ 번째 입력에 대한 로짓입니다.$\log\sum_j e^{l_j}$ 를 log-sum-expLSE 라고 부릅니다. 로짓이 1000 처럼 크면 $e^{1000}$ 이 넘쳐 버리므로, 가장 큰 로짓 $m$ 을 빼고 계산합니다: $\sum_j e^{l_j} = e^{m}\sum_j e^{l_j - m}$ 이므로 $\log\sum_j e^{l_j} = m + \log\sum_j e^{l_j - m}$ (지수가 모두 0 이하라 안전). 9장의 혼합 밀도 네트워크에서 이 요령을 직접 씁니다.
숫자 예: 로짓 $(2.0, 1.0, 0.1)$, 정답 0번. $e^2 = 7.389$, $e^1 = 2.718$, $e^{0.1} = 1.105$, 합 11.212 이므로 $\pi_0 = 0.659$, 손실 $-\log 0.659 = 0.417$. 로짓 $(0.5, 2.5, 0.3)$, 정답 2번이면 $\pi_2 = 1.350/15.181 = 0.0889$, 손실 $2.420$. 둘의 평균은 $1.4185$ 입니다.
[손실] 가우시안 NLL = 1.037773
[손실] MSE/2 + ½log(2π) = 1.037773  (같다)
[손실] 베르누이 NLL = 0.212345,  F.binary_cross_entropy = 0.212345
[손실] softmax 확률 = [[0.659, 0.2424, 0.0986], [0.1086, 0.8025, 0.0889]]
[손실] 범주형 NLL = 1.418540,  F.cross_entropy = 1.418540
세 가지 모두 손으로 유도한 NLL 과 PyTorch 의 손실 함수가 소수점 여섯째 자리까지 같습니다. 정리하면 다음과 같습니다.
| 출력의 종류 | 가정한 분포 | NLL 이 되는 손실 | 이 튜토리얼에서 |
|---|---|---|---|
| 실수 (다음 상태 등) | 가우시안, $\sigma$ 고정 | MSE | 6장 동역학 모델 |
| 실수 + 불확실성 | 가우시안, $\sigma$ 도 예측 | 가우시안 NLL | 7장 확률적 앙상블 |
| 여러 봉우리의 실수 | 가우시안 혼합 | 혼합 NLL (log-sum-exp) | 9장 MDN-RNN |
| 0 / 1 | 베르누이 | 이진 교차 엔트로피 | 8장 픽셀 복원, 12장 “계속 여부” |
| $K$ 개 중 하나 | 범주형 + 소프트맥스 | 교차 엔트로피 | 12장 이산 잠재 변수 · two-hot |
- 이산은 확률질량(합이 1), 연속은 확률밀도(넓이가 1, 높이는 1 을 넘을 수 있음).
- 조건부 확률 $p(y \mid x) = p(x, y)/p(x)$, 곱셈 법칙과 연쇄 법칙 $p(x_{1:T}) = \prod_t p(x_t \mid x_{1:t-1})$, 베이즈 정리 $p(y \mid x) = p(x \mid y)p(y)/p(x)$.
- 기댓값은 선형: $\E[aX + b] = a\E[X] + b$, $\E[X + Y] = \E[X] + \E[Y]$. 전체 기댓값의 법칙 $\E[X] = \sum_y p(y)\,\E[X \mid y]$. 분산 $\Var[X] = \E[X^2] - (\E[X])^2$.
- 몬테카를로 평균은 불편 추정이고 분산은 $\sigma^2/N$ 로 줄어든다(큰 수의 법칙).
- 가우시안 $\Normal(\mu, \sigma^2)$ 의 정규화 상수 $1/(\sigma\sqrt{2\pi})$, 샘플링 $x = \mu + \sigma\epsilon$, 로그 밀도 $-\frac12\log 2\pi - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2}$.
- 최대우도 = 로그 가능도의 합을 최대화 = NLL 최소화. 가우시안의 MLE 는 표본 평균 · 표본 분산.
- MSE = 고정 분산 가우시안 NLL, BCE = 베르누이 NLL, 교차 엔트로피 = 범주형 NLL. 딥러닝의 손실은 대부분 “어떤 분포를 가정한 최대우도” 다.
확인 문제
날씨 · 우산 표에서 $p(\text{비} \mid \text{씀})$ 을 (가) 조건부 확률의 정의로, (나) 베이즈 정리로 각각 구해 같은지 확인하세요.
답 보기
(가) $p(\text{비}, \text{씀})/p(\text{씀}) = 0.40/0.45 \approx 0.889$.
(나) $p(\text{씀} \mid \text{비})\,p(\text{비})/p(\text{씀}) = 0.8 \times 0.5 / 0.45 = 0.40/0.45 \approx 0.889$. 같습니다.
$X$ 의 평균이 2, 분산이 3 일 때 $Y = 4X - 1$ 의 평균과 분산은?
답 보기
$\E[Y] = 4 \times 2 - 1 = 7$, $\Var[Y] = 4^2 \times 3 = 48$. 더하는 $-1$ 은 분산에 영향이 없습니다.
표준편차가 2 인 분포의 평균을 몬테카를로로 추정합니다. 추정값의 표준편차를 0.01 이하로 만들려면 표본이 몇 개 필요할까요?
답 보기
$\sigma/\sqrt{N} \le 0.01$ 이므로 $\sqrt{N} \ge 2/0.01 = 200$, $N \ge 40000$.
$\log\Normal(x; \mu, \sigma^2)$ 를 $x = 3$, $\mu = 1$, $\sigma = 2$ 에서 계산하세요. ($\log 2 \approx 0.6931$)
답 보기
$-0.9189 - 0.6931 - \frac{(3-1)^2}{2 \times 4} = -0.9189 - 0.6931 - 0.5 = -2.1120$.
표준편차를 $\sigma = 0.5$ 로 고정한 가우시안 NLL(평균)과 MSE 사이의 관계식을 쓰세요. MSE 가 0.1 이면 NLL 은 얼마인가요?
답 보기
$\text{NLL} = \frac{\text{MSE}}{2\sigma^2} + \frac12\log(2\pi) + \log\sigma = 2\,\text{MSE} + 0.9189 + \log 0.5$.
$\text{MSE} = 0.1$ 이면 $0.2 + 0.9189 - 0.6931 = 0.4258$. NLL 은 음수가 될 수도 있습니다(밀도가 1 보다 클 수 있으므로).
로짓이 $(1, 1, 1)$ 이고 정답이 0번일 때 교차 엔트로피 손실은? 로짓을 모두 100 씩 더한 $(101, 101, 101)$ 이면?
답 보기
소프트맥스가 $(1/3, 1/3, 1/3)$ 이므로 손실은 $-\log(1/3) = \log 3 \approx 1.0986$. 로짓에 같은 수를 더해도 소프트맥스는 바뀌지 않으므로(분자 · 분모에 같은 $e^{100}$ 이 곱해짐) 손실도 같습니다. log-sum-exp 요령이 성립하는 이유이기도 합니다.
다음 장에서는 “두 분포가 얼마나 다른가” 를 재는 도구인 엔트로피와 KL 발산을 배웁니다. 이 장의 최대우도가 사실 “데이터 분포와 모델 분포의 KL 을 줄이는 것” 이라는 사실도 거기서 밝혀집니다.