수학 ② 정보 이론과 KL 발산
VAE(8장), RSSM(11장), Dreamer(12장)의 손실 함수에는 빠짐없이 KL 발산 이 들어 있습니다. 두 확률 분포가 얼마나 다른지를 재는 값이죠. 이 장에서는 “놀람의 양” 이라는 직관에서 출발해 엔트로피, 교차 엔트로피, KL 발산을 차례로 유도하고, KL 이 왜 항상 0 이상인지, 두 가우시안 사이의 KL 이 왜 그런 식인지를 한 줄도 건너뛰지 않고 풀어 봅니다.
- 정보량이 왜 $-\log p$ 라는 꼴이어야 하는지
- 엔트로피 · 교차 엔트로피 · KL 발산의 정의와 관계 $\KL = H(p, q) - H(p)$
- 최대우도 = 데이터 분포와 모델 분포 사이 KL 최소화
- 볼록 함수와 젠센 부등식, 그리고 KL 이 늘 0 이상인 이유(두 가지 증명)
- KL 의 방향: forward KL(모드 덮기)과 reverse KL(모드 찾기)
- 두 가우시안 사이 KL 의 닫힌 꼴 유도와 VAE 가 쓰는 특수형
- 상호정보량, 그리고 8장 ELBO 의 미리 보기
왜 정보 이론인가
2장에서 모델을 데이터에 맞추는 원리(최대우도)를 배웠습니다. World Model 을 만들다 보면 이것 말고도 “두 분포를 가깝게 만들고 싶다” 는 상황이 계속 나옵니다.
- 8장 VAE: 인코더가 만든 잠재 분포 $q_\phi(z \mid o)$ 를 단순한 기준 분포 $p(z) = \Normal(0, I)$ 가까이에 붙잡아 두기. ($\Normal(0, I)$ 는 각 성분이 서로 독립인 표준 정규 분포라는 뜻입니다. 8장에서 다시 설명합니다.)
- 11장 RSSM: 그림을 보고 추측한 상태 분포(사후)와, 그림 없이 상상만으로 예측한 상태 분포(사전)를 가깝게 만들기.
- 12장 Dreamer: 정책이 너무 한쪽으로 치우치지 않게 엔트로피 를 높게 유지하기.
이때 “두 분포가 얼마나 다른가” 를 재는 표준 도구가 KL 발산이고, 그 뿌리가 1948년 클로드 섀넌(Claude Shannon)이 세운 정보 이론 입니다.
놀람의 양: 정보량
“내일 해가 동쪽에서 뜬다” 는 소식은 아무 정보가 없습니다. 당연하니까요. “내일 서울에 눈이 1미터 온다” 는 엄청난 정보입니다. 거의 일어나지 않는 일이니까요. 직관적으로 드문 사건일수록 그 사건이 일어났다는 소식은 더 놀랍고, 더 많은 정보를 담고 있습니다. 확률 $p$ 인 사건이 일어났을 때의 놀람, 곧 정보량information content, surprisal 을 $I(p)$ 라고 할 때, 다음 세 가지를 바랍니다.
- 확실한 사건($p = 1$)은 놀랍지 않다: $I(1) = 0$.
- 드물수록 더 놀랍다: $p$ 가 작아지면 $I(p)$ 가 커진다.
- 독립인 두 사건이 함께 일어나면 놀람은 더해진다: $I(p_1 p_2) = I(p_1) + I(p_2)$. 동전 앞면과 주사위 6 이 함께 나왔다는 소식의 놀람은 각각의 놀람의 합이어야 자연스럽습니다(독립이면 함께 일어날 확률은 곱 $p_1 p_2$).
놀랍게도 이 세 조건만으로 $I$ 의 꼴이 정해집니다.
$c = 1$ 이고 자연로그를 쓰면 단위는 내트(nat), 밑이 2 인 로그를 쓰면 bit(비트)입니다($\log_2 p = \log p / \log 2$ 이므로 $c = 1/\log 2$). 이 튜토리얼은 자연로그(내트)를 씁니다.
| 사건의 확률 $p$ | 정보량 (내트) $-\log p$ | 정보량 (bit) $-\log_2 p$ |
|---|---|---|
| 1 (확실) | 0 | 0 |
| 1/2 (동전 앞면) | 0.693 | 1 |
| 1/8 | 2.079 | 3 |
| 0.01 | 4.605 | 6.644 |
“공정한 동전 한 번의 결과 = 1 비트” 라는 익숙한 말이 여기서 나옵니다. 그리고 2장의 NLL $-\log p_\theta(x)$ 는 “모델이 데이터를 보고 느끼는 놀람” 이었던 것입니다. 최대우도 학습은 모델이 실제 데이터에 덜 놀라도록 만드는 일입니다.
엔트로피: 평균 놀람
분포 $p$ 에서 결과가 나올 때마다 놀람 $-\log p(x)$ 를 느낀다면, 평균적으로 얼마나 놀랄까요? 이 기댓값이 엔트로피entropy 입니다.
$$ H(p) = \E_{x \sim p}[-\log p(x)] = -\sum_x p(x)\log p(x) $$엔트로피는 “결과가 얼마나 예측하기 어려운가”, 곧 분포의 불확실성 을 잽니다. 확률이 0 인 결과는 $0 \cdot \log 0$ 이 되는데, 이것은 0 으로 칩니다. $p$ 가 0 에 가까워질 때 $p\log p$ 가 0 으로 가기 때문입니다: $0.1\log 0.1 = -0.230$, $0.01\log 0.01 = -0.046$, $0.001\log 0.001 = -0.0069$, … → 0. (로그는 $-\infty$ 로 가지만 앞의 $p$ 가 그보다 빨리 0 이 됩니다.)
동전의 엔트로피
앞면 확률이 $p$ 인 동전의 엔트로피는
$$ H(p) = -p\log p - (1 - p)\log(1 - p) $$- $p = 0.5$: $H = -2 \times 0.5\log 0.5 = \log 2 = 0.693$ 내트 (= 1 bit). 가장 예측하기 어렵습니다.
- $p = 0.9$: $H = -(0.9 \times (-0.1054) + 0.1 \times (-2.3026)) = 0.0948 + 0.2303 = 0.325$ 내트.
- $p = 0.99$: $H = 0.056$ 내트. 거의 늘 앞면이니 거의 놀랍지 않습니다.
$p = 0.5$ 에서 정말 가장 큰지 미분으로 확인합니다.
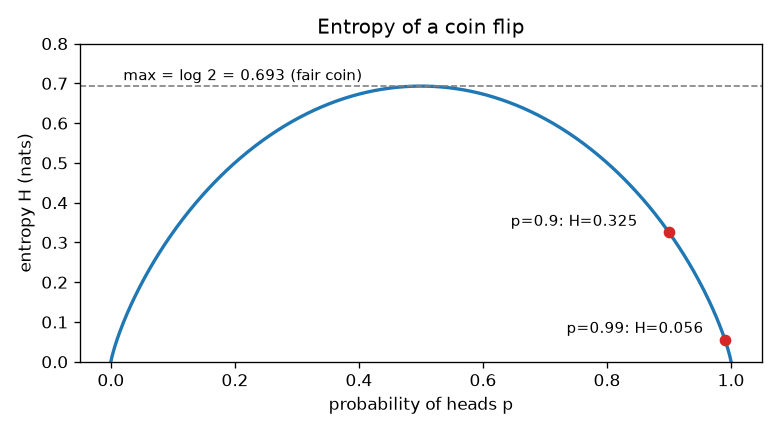
일반적으로 결과가 $K$ 가지인 분포의 엔트로피는 균등 분포일 때 최대 이고 그 값은 $\log K$ 입니다. 이것은 뒤에서 KL 의 성질로 아주 짧게 증명합니다.
연속 분포의 엔트로피: 가우시안
연속 분포에서는 합 대신 적분으로 $H(p) = -\int p(x)\log p(x)\,dx$ 를 씁니다(미분 엔트로피라고 부릅니다). 가우시안의 엔트로피를 구해 봅시다. 12장 Dreamer 의 행동 분포 엔트로피 계산이 이 식에서 출발합니다(거기서는 행동을 $\tanh$ 로 누르는 데 따른 보정 항이 하나 더 붙습니다).
$\sigma = 1$ 이면 $\frac12\log(2\pi e) = 1.419$ 내트, $\sigma = 0.1$ 이면 $1.419 + \log 0.1 = -0.884$ 내트입니다. 미분 엔트로피는 음수일 수 있습니다(밀도가 1 을 넘을 수 있으니 $-\log p$ 가 음수일 수 있음).
교차 엔트로피
실제 결과는 분포 $p$ 에서 나오는데, 우리는 그것이 분포 $q$ 라고 믿고 있다고 합시다. 그러면 결과 $x$ 를 볼 때마다 우리가 느끼는 놀람은 $-\log q(x)$ 이고, 그 평균은 실제 분포 $p$ 로 냅니다. 이것이 교차 엔트로피cross-entropy 입니다.
$$ H(p, q) = \E_{x \sim p}[-\log q(x)] = -\sum_x p(x)\log q(x) $$숫자 예로 진짜 분포 $p = (0.5, 0.3, 0.2)$, 모델 $q = (0.4, 0.4, 0.2)$ 를 씁니다.
2장의 분류 손실 “교차 엔트로피” 가 바로 이것입니다. 정답이 범주 $y$ 라는 것은 진짜 분포 $p$ 가 $y$ 에만 1 을 준 분포(원-핫)라는 뜻이고, 그러면 $H(p, q) = -1 \cdot \log q(y) = -\log q(y)$, 곧 범주형 NLL 이 됩니다.
KL 발산: 두 분포의 차이
틀린 믿음 $q$ 때문에 더 놀란 양, 곧 교차 엔트로피에서 엔트로피를 뺀 것을 KL 발산Kullback–Leibler divergence 이라고 합니다. 1951년 쿨백(Kullback)과 라이블러(Leibler)가 정의했습니다.
앞의 예에서 $\KL(p \,\|\, q) = 1.05492 - 1.02965 = 0.0253$ 입니다. 정의대로 직접 계산해도 같습니다: $0.5\log\frac{0.5}{0.4} + 0.3\log\frac{0.3}{0.4} + 0.2\log\frac{0.2}{0.2} = 0.1116 - 0.0863 + 0 = 0.0253$. 순서를 바꾸면 $\KL(q \,\|\, p) = 0.4\log\frac{0.4}{0.5} + 0.4\log\frac{0.4}{0.3} + 0 = -0.0893 + 0.1151 = 0.0258$ 로 값이 다릅니다. KL 은 대칭이 아닙니다.
[엔트로피] 앞면 확률  0.5: H = 0.6931 내트 = 1.0000 bit
[엔트로피] 앞면 확률  0.9: H = 0.3251 내트 = 0.4690 bit
[엔트로피] 앞면 확률 0.99: H = 0.0560 내트 = 0.0808 bit
[이산] H(p) = 1.0297,  H(p,q) = 1.0549
[이산] KL(p‖q) = 0.0253,  H(p,q) - H(p) = 0.0253
[이산] KL(q‖p) = 0.0258   ← 순서를 바꾸면 값이 다르다 (비대칭)
[이산] 균등 분포 3칸의 엔트로피 = 1.0986 = log 3 = 1.0986
코드의 mask = p > 0 은 $p(x) = 0$ 인 항을 빼는 줄입니다. $0 \cdot \log(0/q) = 0$ 으로 치는 약속을 구현한 것입니다.
KL 의 성질 (먼저 결과만)
- 늘 0 이상: $\KL(p \,\|\, q) \ge 0$. 같은 분포일 때만 0. (곧 증명합니다.)
- 비대칭: 일반적으로 $\KL(p \,\|\, q) \ne \KL(q \,\|\, p)$. 그래서 “거리(distance)” 가 아니라 “발산(divergence)” 이라고 부릅니다.
- $q$ 가 0 인 곳에 $p$ 가 있으면 무한대: $p(x) \gt 0$, $q(x) = 0$ 이면 $\log(p/0) = \infty$. “일어날 수 있는 일을 불가능하다고 믿은” 대가입니다.
최대우도는 KL 최소화다
2장의 최대우도와 KL 을 연결하는 아주 중요한 사실이 있습니다. 데이터를 만든 진짜 분포를 $p_{\text{data}}$, 모델을 $p_\theta$ 라고 합시다.
최대우도 학습 = 모델 분포를 데이터 분포 쪽으로 KL 이 작아지게 끌어당기는 것 이고, 그 KL 의 방향은 $\KL(p_{\text{data}} \,\|\, p_\theta)$ (데이터가 앞) 입니다. 이 방향이 어떤 성격을 갖는지는 뒤의 “forward / reverse KL” 에서 봅니다.
볼록 함수와 젠센 부등식
KL 이 왜 늘 0 이상인지 증명하려면, 그리고 8장의 ELBO 를 유도하려면 젠센 부등식Jensen's inequality 이 필요합니다. 먼저 볼록 함수부터 정의합니다.
함수 $f$ 가 볼록convex 하다는 것은 그래프 위의 두 점을 이은 선분(현)이 늘 그래프 위 에 있다는 뜻입니다. 두 점 $a, b$ 와 섞는 비율 $w \in [0, 1]$ 에 대해
$$ f\big(w\,a + (1 - w)\,b\big) \;\le\; w\,f(a) + (1 - w)\,f(b) $$왼쪽은 “두 점을 섞은 곳에서의 함숫값”(곡선 위의 점), 오른쪽은 “함숫값을 섞은 것”(현 위의 점)입니다. 그릇처럼 아래로 볼록한(밑이 둥근) 모양을 떠올리면 됩니다. 반대로 현이 늘 그래프 아래 에 있으면 오목concave 하다고 하고 부등호가 뒤집힙니다.
두 번 미분할 수 있는 함수는 $f''(x) \ge 0$ 이면 볼록, $f''(x) \le 0$ 이면 오목입니다(기울기가 줄지 않으면 곡선이 현 위로 올라갈 수 없어 그릇 모양이 됩니다. 엄밀한 증명은 평균값 정리를 쓰며 여기서는 생략합니다). 예를 들면
- $f(x) = x^2$: $f'' = 2 \ge 0$ → 볼록.
- $f(x) = -\log x$ ($x \gt 0$): $f' = -1/x$, $f'' = 1/x^2 \gt 0$ → 볼록.
- $f(x) = \log x$: $f'' = -1/x^2 \lt 0$ → 오목.
- $f(x) = e^x$: $f'' = e^x \gt 0$ → 볼록.
두 점에 대한 정의를 여러 점으로 넓히면 젠센 부등식이 됩니다.
가중치 $w_i$ 를 확률 $p(x_i)$ 로 보면 $\sum_i w_i x_i = \E[X]$, $\sum_i w_i f(x_i) = \E[f(X)]$ 이므로, 젠센 부등식은 다음과 같이 쓸 수 있습니다(연속 분포도 같습니다).
$$ \text{볼록 } f: \quad f(\E[X]) \le \E[f(X)], \qquad\qquad \text{오목 } f: \quad f(\E[X]) \ge \E[f(X)] $$특히 $\log$ 는 오목하므로
$$ \log \E[X] \;\ge\; \E[\log X] $$이 한 줄이 이 장과 8장에서 가장 많이 쓰는 부등식입니다.
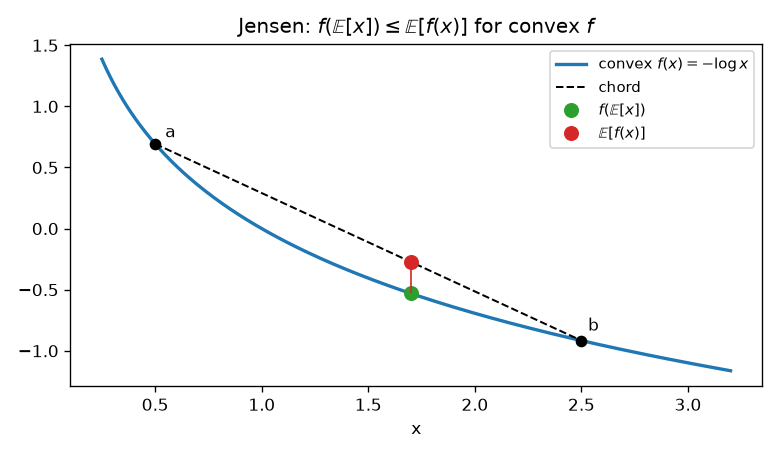
[젠센] log E[X] = 0.2233  ≥  E[log X] = 0.1554
[젠센] (E[X])² = 0.0000  ≤  E[X²] = 0.9981   (x² 는 볼록)
$X$ 가 0.5 와 2 사이의 균등 분포면 손으로도 확인할 수 있습니다: $\E[X] = 1.25$ 이므로 $\log 1.25 = 0.2231$. $\E[\log X] = \frac{1}{1.5}\int_{0.5}^{2}\log x\,dx = \frac{1}{1.5}\big[x\log x - x\big]_{0.5}^{2} = \frac{(1.3863 - 2) - (-0.3466 - 0.5)}{1.5} = 0.1553$. 둘째 줄은 2장의 “분산 ≥ 0, 곧 $\E[X^2] \ge (\E[X])^2$” 와 같은 이야기입니다($x^2$ 이 볼록).
KL 은 왜 항상 0 이상인가
두 가지 방법으로 증명합니다. 둘 다 짧지만, 각각 다른 도구를 보여 줍니다.
KL ≥ 0 에서 바로 두 가지 결과가 따라 나옵니다.
- 교차 엔트로피 ≥ 엔트로피(깁스 부등식): $H(p, q) = H(p) + \KL(p \,\|\, q) \ge H(p)$. 틀린 믿음으로는 진짜 분포보다 덜 놀랄 수 없습니다. 그래서 같은 입력에도 정답이 여러 가지로 나올 수 있는 데이터에서는 분류 손실의 평균이 0 까지 내려가지 못하고, 정답 분포 자체의 엔트로피가 바닥입니다(정답이 늘 하나로 정해지는 원-핫이면 $H(p) = 0$ 이라 바닥도 0).
- 엔트로피 ≤ log K: 균등 분포 $u(x) = 1/K$ 와의 KL 을 계산하면 $\KL(p \,\|\, u) = \sum_x p\log\frac{p}{1/K} = \sum_x p\log p + \log K\sum_x p = -H(p) + \log K \ge 0$. 그러므로 $H(p) \le \log K$, 등호는 $p = u$ 일 때. 앞에서 말한 “균등 분포의 엔트로피가 최대” 의 증명입니다(3칸이면 $\log 3 = 1.0986$, 코드 출력과 같음).
KL 의 방향: forward 와 reverse
KL 이 비대칭이라는 것은 실제로 큰 차이를 만듭니다. 맞추고 싶은 분포가 $p$, 우리가 조절할 수 있는 모델이 $q$ 일 때 두 가지 방향이 있습니다.
- forward KL $\KL(p \,\|\, q) = \E_{x\sim p}[\log p(x) - \log q(x)]$: 평균을 $p$ 로 냅니다. $p$ 가 있는 곳에서 $q$ 가 작으면 $-\log q$ 가 폭발하므로, $q$ 는 $p$ 가 있는 모든 곳을 덮으려고 넓게 퍼집니다(mode covering). 2장의 최대우도가 이 방향입니다.
- reverse KL $\KL(q \,\|\, p) = \E_{x\sim q}[\log q(x) - \log p(x)]$: 평균을 $q$ 로 냅니다. $q$ 가 있는 곳에서 $p$ 가 작으면 벌을 받으므로, $q$ 는 $p$ 가 거의 없는 곳을 피해 봉우리 하나에 몸을 숨깁니다(mode seeking). 8장의 변분 추론(VAE 인코더 학습)이 이 방향입니다.
봉우리가 두 개인 분포 $p(x) = \frac12\Normal(x; -2, 0.6^2) + \frac12\Normal(x; 2, 0.6^2)$ 에 가우시안 $q = \Normal(\mu, \sigma^2)$ 하나를 맞추는 실험으로 확인합니다. 먼저 forward KL 의 답을 손으로 구해 봅시다.
reverse KL 은 닫힌 꼴로 풀리지 않아 격자 탐색으로 구합니다. 그러나 답의 크기는 짐작할 수 있습니다.
[forward KL(p‖q) 최소] μ = +0.00, σ = 2.08  (KL = 0.555)
[reverse KL(q‖p) 최소] μ = -2.00, σ = 0.60  (KL = 0.692)
[참고] p 의 평균 = 0, 분산 = 0.6² + 2² = 4.36 → 표준편차 2.09
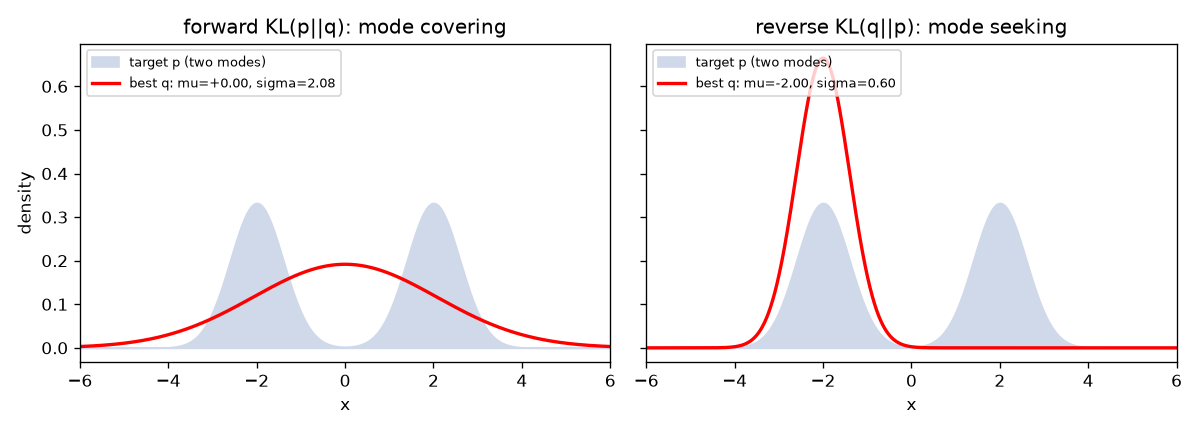
MSE(가우시안 최대우도)로 학습한 World Model 이 갈림길에서 흐릿한 평균을 예측하는 것(1장의 다봉성 문제)은 forward KL 의 “덮기” 성질 때문입니다. 한편 VAE 의 인코더는 reverse KL 로 학습되어 실제 사후 분포보다 좁은(자신만만한) 분포를 내는 경향이 있습니다. 어느 쪽이 좋고 나쁜 것이 아니라, 성격이 다르다는 것을 기억해 두세요.
데모에서 $q$ 를 좁게 만들어 $p$ 의 한가운데에 두면 $\KL(q \,\|\, p)$ 는 작지만 $\KL(p \,\|\, q)$ 는 큽니다($p$ 의 꼬리를 $q$ 가 못 덮음). 반대로 $q$ 를 넓게 하면 반대가 됩니다. 두 값이 같아지는 것은 두 분포가 같을 때(둘 다 0)나 두 표준편차가 같을 때($\sigma_p = \sigma_q = \sigma$ 이면 둘 다 $(\mu_p - \mu_q)^2/(2\sigma^2)$) 같은 특별한 경우뿐입니다. 아래 절에서 이 데모가 쓰는 공식을 유도합니다.
가우시안 사이의 KL: 닫힌 꼴 유도
VAE · RSSM · Dreamer 는 매 학습 스텝마다 두 가우시안 사이의 KL 을 계산합니다. 다행히 이것은 적분 없이 평균 · 표준편차만으로 바로 계산되는 식(닫힌 꼴, closed form)이 있습니다. $q = \Normal(\mu_1, \sigma_1^2)$, $p = \Normal(\mu_2, \sigma_2^2)$ 라고 하고 $\KL(q \,\|\, p)$ 를 구합니다.
식이 맞는지 간단히 점검합니다.
- 같은 분포($\mu_1 = \mu_2$, $\sigma_1 = \sigma_2$): $\log 1 + \frac{\sigma^2 + 0}{2\sigma^2} - \frac12 = 0 + \frac12 - \frac12 = 0$. ✓
- 숫자 예 $q = \Normal(1, 0.5^2)$, $p = \Normal(0, 1)$: $\log\frac{1}{0.5} + \frac{0.25 + 1}{2} - \frac12 = 0.6931 + 0.625 - 0.5 = 0.8181$.
- 순서를 바꾸면 $\KL(p \,\|\, q)$, 곧 $\mu_1 = 0, \sigma_1 = 1, \mu_2 = 1, \sigma_2 = 0.5$: $\log\frac{0.5}{1} + \frac{1 + 1}{2 \times 0.25} - \frac12 = -0.6931 + 4 - 0.5 = 2.8069$. 비대칭이 크죠.
VAE 가 쓰는 특수형: 표준 정규와의 KL
8장에서는 기준 분포가 표준 정규 $p = \Normal(0, 1)$ 인 경우만 씁니다. $\mu_2 = 0$, $\sigma_2 = 1$ 을 넣고 $\mu_1 = \mu$, $\sigma_1 = \sigma$ 로 쓰면
$\mu = 1$, $\sigma = 0.5$ 이면 $\frac12(1 + 0.25 - 1 - \log 0.25) = \frac12(0.25 + 1.3863) = 0.8181$ — 앞의 일반식과 같은 값입니다.
여러 차원: 대각 가우시안의 KL 은 차원별 KL 의 합
잠재 변수는 보통 수십 차원이고, 각 차원이 독립인 대각 가우시안(2장)입니다. 이때 KL 은 차원별 KL 을 더하기만 하면 됩니다.
예: $\mu = (1, -0.5, 0)$, $\sigma = (0.5, 1, 2)$ 이면 차원별로 $0.8181$, $\frac12(0.25 + 1 - 1 - 0) = 0.125$, $\frac12(0 + 4 - 1 - \log 4) = 0.8069$, 합 $1.75$.
이제 닫힌 꼴, 몬테카를로 추정, PyTorch 의 torch.distributions.kl_divergence 를 모두 비교해 봅니다.
[가우시안 KL] 닫힌 꼴 0.8181  /  몬테카를로(1000000개) 0.8176  /  torch 0.8181
[가우시안 KL] 특수형 ½(μ²+σ²-1-log σ²) = 0.8181
[가우시안 KL] 순서를 바꾼 KL(p‖q) = 2.8069
[대각 다변량] 차원별 [0.8181, 0.125, 0.8069] → 합 1.7500 (torch 1.7500)
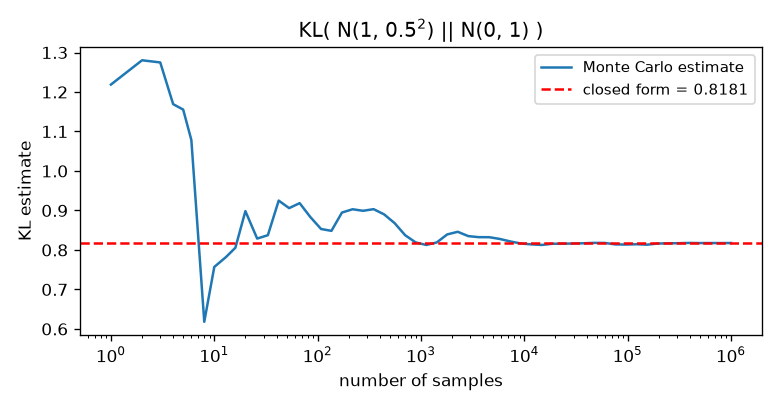
닫힌 꼴이 있으면 몬테카를로 추정보다 정확하고(흔들림이 없음) 빠르므로, 가우시안끼리의 KL 은 늘 닫힌 꼴로 계산합니다. 8장 VAE 코드에서는 이 식이 다음 한 줄이 됩니다.
# 인코더는 σ 대신 logvar = log σ² 를 출력한다 (σ² = exp(logvar) > 0 이 저절로 보장됨)
kl = 0.5 * torch.sum(mu.pow(2) + logvar.exp() - 1.0 - logvar) / batch   # 차원별 KL 을 모두 더해 그림 한 장당 평균
logvar.exp() 가 $\sigma^2$, logvar 가 $\log\sigma^2$, torch.sum(...) 이 차원별 KL 의 합, / batch 가 그림 한 장당 평균입니다. 위에서 유도한 식과 한 글자씩 대응합니다.
범주형 분포 사이의 KL
DreamerV2 · V3(12장)는 잠재 변수를 가우시안 대신 범주형 분포 여러 개로 씁니다. 범주형 KL 은 정의 그대로 계산합니다. $q = (0.7, 0.2, 0.1)$ 과 균등 분포 $p = (\frac13, \frac13, \frac13)$ 의 예:
DreamerV2 의 잠재 상태는 “32개 범주를 가진 범주형 변수 32개” 이므로, KL 은 32개 범주형 KL 의 합입니다(독립인 차원의 KL 은 더해진다는 성질 그대로).
상호정보량
두 확률변수가 서로에 대해 얼마나 알려 주는지를 재는 값이 상호정보량mutual information 입니다. “실제 결합 분포” 가 “독립이라고 가정한 분포(주변 분포의 곱)” 와 얼마나 다른지를 KL 로 잽니다.
$$ I(X; Y) = \KL\big(p(x, y) \,\|\, p(x)\,p(y)\big) = \sum_{x, y} p(x, y)\log\frac{p(x, y)}{p(x)\,p(y)} $$독립이면 두 분포가 같으므로 $I = 0$ 이고, 그 밖에는 KL 이라서 늘 양수입니다. 다른 모습으로도 쓸 수 있습니다.
2장의 날씨 · 우산 표로 계산해 봅니다.
[상호정보량] p(x) = [0.5, 0.5], p(y) = [0.55, 0.45]
[상호정보량] I(X;Y) = 0.2754 내트   (독립이면 0)
[상호정보량] 독립인 결합 분포로 계산하면 I = 0.0000
손으로 점검: $H(X) = \log 2 = 0.6931$. 우산을 안 쓴 날의 날씨 분포는 $(0.45, 0.10)/0.55 = (0.818, 0.182)$ 로 엔트로피 $0.4741$, 쓴 날은 $(0.05, 0.40)/0.45 = (0.111, 0.889)$ 로 엔트로피 $0.3488$. 평균 $H(X \mid Y) = 0.55 \times 0.4741 + 0.45 \times 0.3488 = 0.4177$. $I = 0.6931 - 0.4177 = 0.2754$. 우산을 보면 날씨에 대한 불확실성이 약 40% 줄어듭니다. 상호정보량은 이 튜토리얼에서 손실로 직접 쓰지는 않지만, 표현 학습 논문을 읽다 보면 자주 만나는 개념이라 14장 용어집에도 정리해 두었습니다.
ELBO 미리 보기: 젠센 부등식의 쓰임
마지막으로 이 장의 도구들이 8장에서 어떻게 합쳐지는지 미리 봅니다. 잠재 변수 모델은 관측 $x$ 의 확률을 숨은 $z$ 에 대해 주변화한 적분으로 씁니다. (00장 표기 규칙의 관측 $o$ 와 같은 것입니다. 8장이 VAE 논문의 관례대로 $x$ 를 쓰므로 여기서도 $x$ 로 씁니다.)
$$ p(x) = \int p(x \mid z)\,p(z)\,dz $$이 적분은 보통 계산할 수 없습니다. 그래서 아무 분포 $q(z)$ 를 하나 들여와, 젠센 부등식으로 $\log p(x)$ 의 아래쪽 한계 를 만듭니다.
이 장에서 배운 모든 것이 들어 있습니다. 첫째 항은 2장의 로그 가능도(NLL 의 반대), 둘째 항은 방금 유도한 가우시안 KL 닫힌 꼴로 계산되고, 둘을 잇는 것은 젠센 부등식입니다. 8장에서는 이 부등식이 언제 등식이 되는지, $q$ 를 어떻게 고르는지($q_\phi(z \mid x)$), 그리고 $\E_q$ 를 거쳐 어떻게 미분하는지(재매개변수화)를 다룹니다.
- 정보량 $-\log p$ 는 “독립 사건의 놀람은 더해진다” 는 요구에서 유일하게 나오는 꼴. 단위는 내트(자연로그) 또는 bit.
- 엔트로피 $H(p) = \E_p[-\log p]$ = 평균 놀람 = 불확실성. 균등 분포에서 최대 $\log K$. 가우시안은 $\frac12\log(2\pi e\sigma^2)$.
- 교차 엔트로피 $H(p, q) = \E_p[-\log q]$, KL $= H(p, q) - H(p) = \E_p[\log(p/q)]$. 최대우도 = $\KL(p_{\text{data}} \,\|\, p_\theta)$ 최소화.
- 젠센: 볼록 $f$ 는 $f(\E X) \le \E f(X)$, 오목한 $\log$ 는 $\log\E X \ge \E\log X$. 이것으로 $\KL \ge 0$ 이 증명된다.
- forward KL $\KL(p \,\|\, q)$ 은 모드를 덮고(평균 · 분산 맞추기), reverse KL $\KL(q \,\|\, p)$ 은 모드 하나를 찾는다.
- $\KL(\Normal(\mu_1,\sigma_1^2) \,\|\, \Normal(\mu_2,\sigma_2^2)) = \log\frac{\sigma_2}{\sigma_1} + \frac{\sigma_1^2 + (\mu_1-\mu_2)^2}{2\sigma_2^2} - \frac12$, 표준 정규와는 $\frac12(\mu^2 + \sigma^2 - 1 - \log\sigma^2)$, 대각이면 차원별 합.
- 상호정보량 $I(X;Y) = \KL(p(x,y) \,\|\, p(x)p(y)) = H(X) - H(X \mid Y)$.
- ELBO: $\log p(x) \ge \E_q[\log p(x \mid z)] - \KL(q(z) \,\|\, p(z))$ — 8장의 출발점.
확인 문제
공정한 주사위 한 번의 엔트로피를 내트와 bit 로 구하세요. ($\log 6 \approx 1.792$)
답 보기
균등 분포이므로 $H = \log 6 \approx 1.792$ 내트 $= \log_2 6 \approx 2.585$ bit. 결과가 6가지인 분포가 가질 수 있는 최대 엔트로피입니다.
$p = (0.5, 0.5)$, $q = (0.9, 0.1)$ 일 때 $\KL(p \,\|\, q)$ 와 $\KL(q \,\|\, p)$ 를 계산하세요.
답 보기
$\KL(p \,\|\, q) = 0.5\log\frac{0.5}{0.9} + 0.5\log\frac{0.5}{0.1} = 0.5(-0.5878) + 0.5(1.6094) = 0.5108$.
$\KL(q \,\|\, p) = 0.9\log\frac{0.9}{0.5} + 0.1\log\frac{0.1}{0.5} = 0.9(0.5878) + 0.1(-1.6094) = 0.3681$. 비대칭입니다.
$\KL(\Normal(2, 1) \,\|\, \Normal(0, 1))$ 과 $\KL(\Normal(0, 4) \,\|\, \Normal(0, 1))$ 을 닫힌 꼴로 구하세요. ($\log 2 \approx 0.693$, $\log 4 \approx 1.386$)
답 보기
첫째: 특수형 $\frac12(\mu^2 + \sigma^2 - 1 - \log\sigma^2) = \frac12(4 + 1 - 1 - 0) = 2$. 분산이 같으면 KL 은 $(\mu_1 - \mu_2)^2/(2\sigma^2)$ 입니다.
둘째: $\sigma^2 = 4$ 이므로 $\frac12(0 + 4 - 1 - \log 4) = \frac12(3 - 1.386) = 0.807$.
젠센 부등식을 써서, 양수 $a, b$ 에 대해 산술평균 ≥ 기하평균 $\frac{a + b}{2} \ge \sqrt{ab}$ 를 증명하세요.
답 보기
$\log$ 는 오목하므로 $\log\frac{a + b}{2} \ge \frac12\log a + \frac12\log b = \log\sqrt{ab}$ (가중치 1/2, 1/2 인 젠센). $\log$ 는 증가 함수이므로 $\frac{a+b}{2} \ge \sqrt{ab}$.
데이터 분포가 봉우리 두 개인데 모델이 가우시안 하나뿐이라면, 최대우도로 학습한 모델은 어떤 모양이 될까요? 그 이유를 KL 의 방향으로 설명하세요.
답 보기
최대우도는 forward KL $\KL(p_{\text{data}} \,\|\, p_\theta)$ 최소화입니다. 데이터가 있는 곳에서 모델 확률이 작으면 큰 벌을 받으므로, 모델은 두 봉우리를 모두 덮는 넓은 가우시안(평균은 두 봉우리 사이)이 됩니다. 그림 3-3 왼쪽과 같습니다.
ELBO 유도에서 젠센 부등식이 등식이 되려면 $\frac{p(x \mid z)p(z)}{q(z)}$ 가 $z$ 에 따라 바뀌지 않는 상수여야 합니다. 이 조건은 $q(z)$ 가 무엇일 때 성립할까요? (힌트: 베이즈 정리)
답 보기
$\frac{p(x \mid z)p(z)}{q(z)} = c$ 이면 $q(z) \propto p(x \mid z)p(z) = p(x, z)$. 합이 1 이 되게 정규화하면 $q(z) = \frac{p(x, z)}{p(x)} = p(z \mid x)$, 곧 진짜 사후 분포 입니다. 이때 상수는 $c = p(x)$ 이고 ELBO $= \log p(x)$. 8장에서 이 사실을 “$\log p(x) = \text{ELBO} + \KL(q \,\|\, p(z \mid x))$” 라는 등식으로 다시 유도합니다.
확률과 정보 이론이라는 수학 도구가 갖춰졌습니다. 다음 장에서는 이 손실 함수들을 실제로 최소화하는 기계, 곧 신경망과 경사 하강법, 역전파를 PyTorch 와 함께 배웁니다.