강화학습 기초
World Model 은 혼자 쓰이지 않습니다. 언제나 “어떻게 행동해야 보상을 많이 받을까?” 를 고민하는 에이전트 곁에 있습니다. 이 장에서는 그 고민을 수학으로 쓰는 틀인 강화학습을 처음부터 쌓습니다. 리턴과 할인, 가치 함수, 벨만 방정식을 한 줄씩 유도하고, 격자 세계에서 가치 반복을 손으로 돌려 본 뒤, 정책 경사(REINFORCE)를 유도해 직접 학습시킵니다. 마지막으로 진자 문제를 강화학습으로 정식화하고, 6 · 7장의 World Model 이 넘어야 할 기준 점수를 구합니다.
- 에이전트 · 환경 · 상태 · 행동 · 보상 · 정책 · 에피소드, 마르코프 성질과 MDP
- 리턴과 할인율: 등비급수 $\frac{1}{1-\gamma}$, 유효 지평, 재귀식 $G_t = r_t + \gamma G_{t+1}$
- 가치 함수 $V^\pi$, $Q^\pi$ 와 벨만 기대 방정식 · 벨만 최적 방정식의 단계별 유도
- 가치 반복을 손으로 · 코드로 돌리기, 그리고 왜 수렴하는지
- 정책 경사 REINFORCE 의 유도(로그 미분 트릭), 기준선 · 이점 · TD 오차 · 액터-크리틱
- 점수 함수 기울기와 재매개변수화 기울기의 차이(12장 Dreamer 의 열쇠)
- 부분 관측(POMDP)과 믿음 상태, 모델 프리 vs 모델 기반, Dyna
- 진자를 강화학습 문제로 정식화하고 기준 정책들의 점수 구하기
에이전트와 환경
강화학습reinforcement learning, RL은 “시행착오로 배우는 법” 을 다룹니다. 등장인물은 둘입니다. 행동을 고르는 에이전트agent와, 그 행동에 반응하는 환경environment. 둘은 다음 고리를 시간 $t = 0, 1, 2, \dots$ 마다 되풀이합니다.
| 용어 | 뜻 | 진자에서는 |
|---|---|---|
| 상태state $s_t$ | 지금 세상의 모든 사정 | 각도와 각속도 $(\theta, \dot\theta)$ |
| 행동action $a_t$ | 에이전트가 고르는 것 | 토크 $u \in [-2, 2]$ |
| 보상reward $r_t$ | 그 행동이 얼마나 좋았는지 나타내는 숫자 하나 | $-(\theta^2 + 0.1\dot\theta^2 + 0.001u^2)$ |
| 정책policy $\pi$ | 상태 → 행동 규칙. 에이전트의 “두뇌” | 예: “기울어진 반대쪽으로 민다” |
| 에피소드episode | 시작부터 끝까지 한 판 | 200 스텝(10초) |
| 궤적trajectory $\tau$ | 한 판의 기록 $(s_0, a_0, r_0, s_1, a_1, r_1, \dots)$ | collect_episodes 가 모으는 것 |
정책에는 두 종류가 있습니다. 결정적 정책 $a = \mu(s)$ 는 같은 상태에서 늘 같은 행동을, 확률적 정책 $a \sim \pi(a \mid s)$ 는 행동을 확률로 뽑습니다. “다양하게 해 보기(탐험)” 가 필요하고 미분하기도 편해서, 학습에는 주로 확률적 정책을 씁니다. 예를 들어 $\pi(a \mid s) = \Normal(a;\ \mu_\psi(s), \sigma^2)$ 는 “신경망이 정한 평균 근처에서 행동을 뽑는다” 는 정책입니다.
정답 행동을 알려 주는 선생님은 없습니다. 보상이라는 점수만 받습니다. 그리고 점수는 늦게 옵니다 — 진자를 세우려면 처음에는 오히려 반대로 흔들어야(보상이 나빠져도) 합니다. 강화학습의 목표는 당장의 보상이 아니라 앞으로 받을 보상의 합을 최대로 하는 정책을 찾는 것입니다.
마르코프 성질과 MDP
“다음에 무슨 일이 일어날지는 현재만 알면 되고, 과거가 어떻게 흘러왔는지는 필요 없다” 는 성질을 마르코프 성질Markov property이라 합니다.
$$ p(s_{t+1} \mid s_t, a_t, s_{t-1}, a_{t-1}, \dots, s_0) = p(s_{t+1} \mid s_t, a_t) $$진자에서 $(\theta, \dot\theta)$ 를 알면 다음 순간은 물리 법칙으로 정해집니다. 그러므로 $(\theta, \dot\theta)$ 는 마르코프 상태입니다. 하지만 각도 $\theta$ 만 알면? 같은 각도라도 시계 방향으로 도는 중인지 반대인지에 따라 미래가 다릅니다. 각도만으로는 마르코프가 아닙니다. 이 구별이 이 장 뒷부분의 부분 관측 문제로, 그리고 9 · 11장의 “기억” 으로 이어집니다.
마르코프 성질을 만족하는 의사결정 문제를 마르코프 결정 과정Markov decision process, MDP이라 하고, 다섯 가지로 정의합니다.
$$ \text{MDP} = (\mathcal{S},\ \mathcal{A},\ p,\ r,\ \gamma) $$- $\mathcal{S}$: 가능한 상태의 집합, $\mathcal{A}$: 가능한 행동의 집합
- $p(s' \mid s, a)$: 전이 확률 — $s$ 에서 $a$ 를 하면 $s'$ 로 갈 확률. 이것이 곧 “세상의 규칙” 이고, World Model 이 배우려는 대상입니다.
- $r(s, a)$ (또는 $r(s, a, s')$): 보상 함수
- $\gamma \in [0, 1)$: 할인율 (다음 절)
시작 상태의 분포 $\rho_0(s_0)$ 를 더하면, 정책 $\pi$ 를 따를 때 궤적 하나가 나올 확률을 쓸 수 있습니다. 이 식은 뒤에서 정책 경사를 유도할 때 핵심 재료가 됩니다.
리턴과 할인
리턴
시각 $t$ 부터 앞으로 받을 보상의 (할인된) 합을 리턴return $G_t$ 라고 합니다.
$$ G_t = r_t + \gamma r_{t+1} + \gamma^2 r_{t+2} + \cdots = \sum_{k=0}^{\infty} \gamma^k\, r_{t+k} $$할인율discount factor $\gamma$ (0 과 1 사이)는 “미래의 보상을 지금 가치로 얼마나 깎을지” 입니다. $\gamma = 0.9$ 면 한 스텝 뒤의 보상 1 은 지금의 0.9, 두 스텝 뒤는 0.81 의 값어치입니다. 할인하는 이유는 세 가지입니다.
- 수학: 끝없이 이어지는 문제에서도 합이 유한해집니다(바로 아래 유도).
- 불확실성: 먼 미래일수록 예측이 부정확하고, 세상이 끝날 수도 있습니다. $\gamma$ 를 “매 스텝 살아남을 확률” 로 볼 수도 있습니다.
- 선호: 같은 보상이면 빨리 받는 쪽이 낫습니다(격자 세계에서 지름길을 고르게 만듭니다).
등비급수와 유효 지평
$\gamma$ 는 에이전트가 “얼마나 먼 미래까지 신경 쓰는지” 도 정합니다. $k$ 스텝 뒤 보상의 가중치 $\gamma^k$ 가 $e^{-1} \approx 0.37$ 로 줄어드는 $k$ 를 유효 지평이라 부릅니다.
리턴의 재귀식
재귀식 덕분에 리턴을 뒤에서부터 한 번에 계산할 수 있습니다. 보상 $(1, 0, 0, 5)$, $\gamma = 0.9$ 의 예: $G_3 = 5$, $G_2 = 0 + 0.9 \times 5 = 4.5$, $G_1 = 0 + 0.9 \times 4.5 = 4.05$, $G_0 = 1 + 0.9 \times 4.05 = 4.645$. 직접 더해도 $1 + 0.9^3 \times 5 = 1 + 3.645 = 4.645$ 로 같습니다.
이 장의 실습은 모두 ch05_rl_basics.py 하나에 있고 numpy 와 matplotlib 만 씁니다(torch 는 필요 없습니다). wm_envs.py 와 같은 폴더에서
python ch05_rl_basics.py 로 돌리면 전체가 약 10~20초 만에 끝나고, 그림은 figures/ 에 저장됩니다.
보상        : [1.0, 0.0, 0.0, 5.0]
리턴 G_t    : [4.645, 4.05, 4.5, 5.0]
G_0 직접 계산: 4.6450000000000005
γ=0.9: 보상 1 을 5000번 받은 리턴 = 10.0000,  1/(1−γ) = 10.0000
γ=0.99: 보상 1 을 5000번 받은 리턴 = 100.0000,  1/(1−γ) = 100.0000
컴퓨터의 실수는 2진법으로 저장되어 0.9 같은 수를 정확히 표현하지 못합니다. 그래서 마지막 자리에 아주 작은 오차가 생깁니다. 걱정하지 않아도 됩니다.
가치 함수
리턴 $G_t$ 는 정책과 환경의 우연에 따라 판마다 다릅니다. 그래서 그 평균(기댓값)으로 상태의 좋고 나쁨을 잽니다.
$$ \begin{aligned} V^\pi(s) &= \E_\pi\big[\,G_t \mid s_t = s\,\big] &&\text{상태 가치: } s \text{ 에서 시작해 } \pi \text{ 를 따를 때의 평균 리턴}\\ Q^\pi(s, a) &= \E_\pi\big[\,G_t \mid s_t = s,\ a_t = a\,\big] &&\text{행동 가치: } s \text{ 에서 일단 } a \text{ 를 하고, 그 뒤로 } \pi \text{ 를 따를 때} \end{aligned} $$$V^\pi(s)$ 는 “이 상태가 앞으로 얼마나 좋은가”, $Q^\pi(s, a)$ 는 “이 상태에서 이 행동이 얼마나 좋은가” 입니다. 진자로 말하면, 거의 서 있고 천천히 움직이는 상태는 $V$ 가 높고(0 에 가까움), 아래로 매달려 빠르게 도는 상태는 $V$ 가 낮습니다(큰 음수). 둘 사이에는 다음 관계가 있습니다.
벨만 기대 방정식
가치 함수는 정의대로라면 무한한 미래를 평균 내야 해서 계산할 수 없을 것 같습니다. 그런데 리턴의 재귀식을 가치 함수에 적용하면, 한 스텝만 보는 방정식이 됩니다. 강화학습 전체의 뼈대인 벨만 방정식Bellman equation입니다. 각 줄에서 어떤 성질을 쓰는지 표시해 두었습니다.
같은 방법으로 $Q$ 에 대해서도 씁니다(첫 행동이 이미 정해져 있으므로 $\pi(a\mid s)$ 의 평균이 바깥에 없습니다).
$$ Q^\pi(s, a) = \sum_{s'} p(s' \mid s, a)\,\big[\, r(s, a, s') + \gamma\, V^\pi(s')\,\big] = \sum_{s'} p(s'\mid s,a)\Big[\, r + \gamma\sum_{a'}\pi(a'\mid s')\,Q^\pi(s', a')\Big] $$작은 격자로 확인하기
2×3 격자를 봅시다. 칸은 위 줄 A, B, G, 아래 줄 C, D, E 이고, G 는 목표입니다. 행동은 위 · 아래 · 왼쪽 · 오른쪽, 벽으로 가면 제자리에 머뭅니다. G 로 들어가면 보상 +1 을 받고 끝나며, 다른 이동의 보상은 0, $\gamma = 0.9$, 이동은 항상 의도대로(결정적) 됩니다.
정책 $\pi$ = “A · B · C · D 에서는 오른쪽, E 에서는 위” 로 두고 벨만 기대 방정식을 써 봅니다. 결정적이라 합이 모두 항 하나로 줄어듭니다.
벨만 최적 방정식과 가치 반복
최적 가치
가장 좋은 정책 $\pi^\ast$ 를 따를 때의 가치를 최적 가치 $V^\ast(s) = \max_\pi V^\pi(s)$, $Q^\ast(s,a) = \max_\pi Q^\pi(s,a)$ 라고 합니다. 최적 정책은 매 순간 가장 좋은 행동을 고르므로, 벨만 기대 방정식의 “정책으로 평균” 이 “가장 좋은 것 고르기($\max$)” 로 바뀝니다.
$$ \begin{aligned} V^\ast(s) &= \max_a \sum_{s'} p(s' \mid s, a)\,\big[\, r(s,a,s') + \gamma\, V^\ast(s')\,\big] \\ Q^\ast(s, a) &= \sum_{s'} p(s' \mid s, a)\,\big[\, r(s,a,s') + \gamma \max_{a'} Q^\ast(s', a')\,\big] \end{aligned} $$이것이 벨만 최적 방정식Bellman optimality equation입니다. $V^\ast$ 를 알면 최적 정책은 “$\sum_{s'} p(s'\mid s,a)[r + \gamma V^\ast(s')]$ 가 가장 큰 행동” 을 고르면 됩니다. 단, 이 계산에는 전이 확률 $p(s'\mid s, a)$ 가 필요합니다 — 꼭 기억해 두세요.
가치 반복을 손으로
가치 반복value iteration은 벨만 최적 방정식의 오른쪽을 계산해 왼쪽에 덮어쓰기를 되풀이합니다.
$$ V_{k+1}(s) \leftarrow \max_a \sum_{s'} p(s' \mid s, a)\,\big[\, r(s,a,s') + \gamma\, V_k(s')\,\big], \qquad V_0(s) = 0 $$코드로 같은 계산을 합니다. 환경의 규칙 $p(s', r \mid s, a)$ 를 transitions() 가 목록으로 돌려줍니다.
  반복 1: A=0.000  B=1.000  G=0.000  C=0.000  D=0.000  E=1.000
  반복 2: A=0.900  B=1.000  G=0.000  C=0.000  D=0.900  E=1.000
  반복 3: A=0.900  B=1.000  G=0.000  C=0.810  D=0.900  E=1.000
  반복 4: A=0.900  B=1.000  G=0.000  C=0.810  D=0.900  E=1.000
  탐욕 정책: {'A': '→', 'B': '→', 'C': '↑', 'D': '↑', 'E': '↑'}
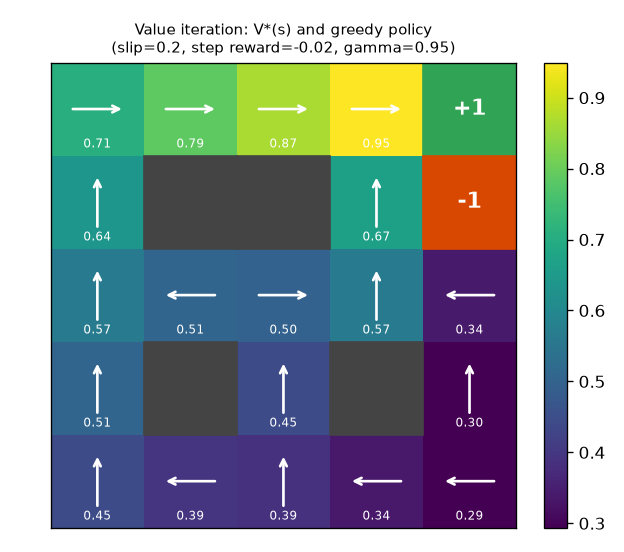
손계산과 똑같습니다. 이번에는 더 그럴듯한 세상으로 키워 봅니다. 5×5 격자에 벽(#), 목표 G(+1), 구덩이 P(−1)가 있고, 20% 확률로 의도와 직각 방향으로 미끄러지며(그래서 전이가 확률적), 이동마다 $-0.02$ 의 작은 벌점이 있습니다. $\gamma = 0.95$.
  5×5 미끄러운 격자: 38번 반복 만에 수렴
   +0.707 +0.788 +0.866 +0.950   G
   +0.638   ##     ##   +0.667   P
   +0.567 +0.508 +0.501 +0.567 +0.341
   +0.508   ##   +0.445   ##   +0.295
   +0.445 +0.393 +0.388 +0.339 +0.294
가치 반복은 왜 수렴하는가
핵심은 “한 번 반복할 때마다 정답과의 오차가 $\gamma$ 배 이하로 줄어든다” 는 성질(수축)입니다. 먼저 작은 도움 정리 하나가 필요합니다.
가치 반복은 데이터를 한 번도 모으지 않고, 환경의 규칙 $p(s'\mid s,a)$ 와 보상 $r$ 만으로 최적 행동을 계산했습니다. 이렇게 모델을 써서 행동을 정하는 것을 계획planning이라 합니다. 문제는 현실에서는 규칙을 모른다는 것이고, 바로 그 규칙을 데이터로 배우는 것이 World Model 입니다. 6 · 7장은 진자의 규칙을 배워서 그 안에서 계획합니다.
정책 경사: REINFORCE
이번에는 정반대 접근입니다. 규칙을 모르는 채, 정책 자체를 신경망 $\pi_\psi$ 로 두고 리턴이 커지는 쪽으로 $\psi$ 를 직접 고칩니다. 목표는 리턴의 기댓값입니다.
$$ J(\psi) = \E_{\tau \sim p_\psi}\big[ R(\tau) \big], \qquad R(\tau) = \sum_{t=0}^{T-1}\gamma^t r_t $$4장의 경사 하강을 거꾸로 하면 됩니다(키우고 싶으므로 경사 상승 $\psi \leftarrow \psi + \eta\nabla_\psi J$). 그런데 $J$ 는 환경을 실제로 돌려야 나오는 값이고, 환경은 미분할 수 없는 블랙박스입니다. 어떻게 기울기를 구할까요? 열쇠는 로그 미분 트릭log-derivative trick입니다.
기준선: 분산 줄이기
위 추정은 평균은 맞지만(편향 없음) 잡음이 매우 큽니다. 잡음을 줄이는 핵심 도구가 다음 성질입니다.
이 성질 덕분에 리턴에서 행동 $a_t$ 와 무관한 아무 값 $b(s_t)$ — 기준선baseline — 을 빼도 기울기의 기댓값이 그대로입니다: $\E[(G - b(s))\nabla\log\pi] = \E[G\,\nabla\log\pi] - b(s)\cdot\E[\nabla\log\pi] = \E[G\,\nabla\log\pi] - 0$. 같은 논리로, 시각 $t$ 의 행동은 그 이전의 보상에 영향을 줄 수 없으므로(그 보상들은 $a_t$ 를 고르기 전에 정해진 상수와 같으므로) $R(\tau)$ 대신 “그때부터의 리턴” $G_t$ 를 써도 됩니다. 실제로 쓰는 REINFORCE 는 이렇습니다.
$$ \nabla_\psi J \approx \frac{1}{N}\sum_{\text{궤적}}\ \sum_{t}\big(G_t - b(s_t)\big)\,\nabla_\psi\log\pi_\psi(a_t \mid s_t) $$($\gamma^t$ 배의 차이는 실무에서 보통 무시합니다.) 기준선의 좋은 선택은 그 상태의 평균 리턴, 즉 $V^\pi(s_t)$ 입니다. 그러면 $G_t - b(s_t)$ 는 “이번에는 평소보다 얼마나 잘했나” 가 되어, 평소보다 잘한 행동만 올리고 못한 행동은 내립니다.
소프트맥스 정책의 점수 함수
행동이 몇 개뿐이면 상태마다 로짓 $\psi_{s,a}$ 를 두고 소프트맥스로 정책을 만듭니다. 4장의 교차 엔트로피 기울기와 같은 계산입니다.
grad_log_pi 가 정확히 이것입니다.실습: 복도와 밴딧
칸 0~4 의 1차원 복도에서 칸 0 에서 출발해 칸 4 에 닿으면 +1 을 받습니다(15 스텝 안에 못 닿으면 0). 최적은 오른쪽으로만 네 번 가서 리턴 $0.9^3 = 0.729$ 를 받는 것입니다.
grad += (g_t - b) * grad_log_pi(...) 한 줄이 위 식 $\sum_t (G_t - b(s_t))\nabla\log\pi$ 이고, logits += lr * grad 가 경사 상승입니다.
(코드는 간단히 하려고 에피소드 도중에 기준선 V[s] 를 고칩니다. 엄밀하게는 에피소드가 끝난 뒤에 고쳐야 기준선이 그 에피소드의 행동과 완전히 무관해집니다.)
먼저 기준선이 정말 “평균은 그대로, 잡음만 줄이는지” 확인합니다. 처음 정책(반반)에서 기울기 추정을 4000번 뽑아 평균과 분산을 비교합니다.
다음으로, 기준선의 효과가 극적으로 드러나는 예를 봅니다. 팔이 두 개인 슬롯머신(밴딧bandit)에서 팔 0 은 평균 10, 팔 1 은 평균 11 의 보상을 줍니다. 모든 보상에 “10” 이라는 큰 공통 값이 섞여 있어서, 기준선이 없으면 어느 팔을 당기든 그 팔의 확률을 크게 올려 버립니다.
  기준선 없음: 기울기 평균(칸0,오른쪽) = +0.0825,  분산 합 = 0.5944
  기준선 b(s): 기울기 평균(칸0,오른쪽) = +0.0806,  분산 합 = 0.3862
  복도 기준선 없음: 마지막 50 에피소드 평균 리턴 0.690  (최적 = 0.9³ = 0.729)
  복도 기준선 있음: 마지막 50 에피소드 평균 리턴 0.695  (최적 = 0.9³ = 0.729)
  학습 뒤 π(오른쪽|s): [0.872, 0.949, 0.957, 0.948]
  밴딧(보상 평균 10 vs 11): 기준선의 효과
  밴딧 기준선 없음: 1000 스텝 뒤 π(좋은 팔) 평균 0.758,  나쁜 팔로 굳은 시드 22%
  밴딧 기준선 있음: 1000 스텝 뒤 π(좋은 팔) 평균 0.989,  나쁜 팔로 굳은 시드 0%
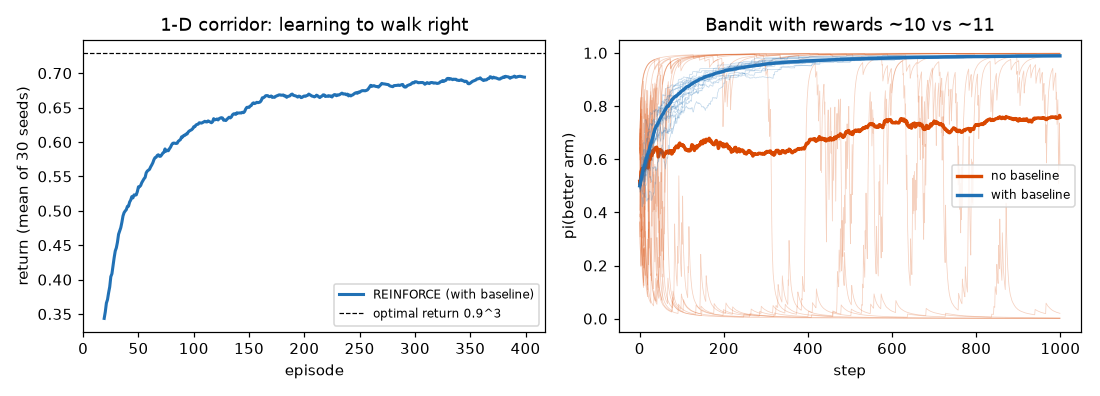
결과를 읽어 봅시다. 기울기의 평균(0.0825 vs 0.0806)은 표본 잡음 범위에서 같고, 분산은 35% 줄었습니다. 복도처럼 보상이 0 과 1 뿐인 문제에서는 학습 곡선의 차이가 작지만, 밴딧처럼 보상에 큰 공통 값이 있으면 기준선 없이는 학습이 크게 망가집니다. 진자의 보상은 늘 약 $-16.3$ ~ $0$ 의 음수라서 바로 이런 경우입니다.
액터-크리틱 · 이점 · TD 오차
기준선으로 $V^\pi(s)$ 를 쓰려면 $V^\pi$ 를 알아야 합니다. 그래서 가치 함수도 신경망 $v_\xi(s)$ 로 두고 함께 배웁니다. 정책 $\pi_\psi$ 를 액터actor, 가치 함수 $v_\xi$ 를 크리틱critic이라 부르고, 이 구조를 액터-크리틱이라 합니다. 12장 Dreamer 가 상상 속에서 배우는 것이 정확히 이 액터와 크리틱입니다.
$Q^\pi(s,a) - V^\pi(s)$ 를 이점advantage $A^\pi(s, a)$ 라고 합니다. “이 행동이 이 상태의 평균보다 얼마나 나은가” 입니다. $G_t - V(s_t)$ 는 이점의 추정입니다. 한 스텝만 보고 추정할 수도 있는데, 그것이 TD 오차temporal difference error입니다.
$$ \delta_t = r_t + \gamma V^\pi(s_{t+1}) - V^\pi(s_t) $$크리틱은 “목표값 $y_t = r_t + \gamma\,v_\xi(s_{t+1})$ 에 가까워지도록” MSE 로 배웁니다: $\big(y_t - v_\xi(s_t)\big)^2$. 이때 목표값 쪽으로는 기울기를 흘리지 않습니다 (목표가 따라 움직이면 불안정해지기 때문입니다). 이를 기울기 차단(stop-gradient)이라 하고 $\sg(y_t)$ 라고 쓰며, 12장에서 다시 만납니다.
그래도 목표값은 크리틱 자신이 만들기 때문에, 크리틱을 고칠 때마다 목표도 함께 움직입니다(“움직이는 과녁”). 이를 줄이려고 목표값을 만드는 신경망을 따로 두기도 합니다. 크리틱의 복사본을 하나 만들어 가끔씩만(또는 아주 천천히) 본래 크리틱을 따라오게 하고, 목표값 $y_t$ 는 이 느린 복사본으로 계산합니다. 이것을 목표 신경망target network이라 하며, DQN(Mnih et al., 2015)이 학습을 안정시키려고 쓴 장치입니다. 12장의 “느린 크리틱” 이 같은 생각입니다.
재매개변수화 경사: 미분할 수 있는 세계라면
REINFORCE 는 환경을 블랙박스로 보기 때문에, 리턴을 행동으로 미분하는 정보(“토크를 조금 더 주면 보상이 얼마나 오르나”)를 전혀 쓰지 못합니다. 그런데 World Model 은 신경망이라 미분할 수 있습니다! 그러면 훨씬 정확한 기울기를 얻을 수 있습니다. 차이를 가장 단순한 예로 보겠습니다.
행동 $a \sim \Normal(\mu, 1)$ 을 뽑고 “보상” $f(a) = a^2$ 을 받는다고 합시다. $J(\mu) = \E[a^2] = \mu^2 + 1$ 이므로 참 기울기는 $\nabla_\mu J = 2\mu$ 입니다. 이 기울기를 표본으로 추정하는 방법이 두 가지 있습니다.
import numpy as np

rng = np.random.default_rng(0)
mu, n = 1.0, 1_000_000
eps = rng.standard_normal(n)
a = mu + eps                       # a ~ N(μ, 1)

score = a**2 * (a - mu)            # f(a) · ∇_μ log N(a; μ, 1)
pathwise = 2 * a                   # ∇_a f(a) · ∂a/∂μ

print("참값 2μ      :", 2 * mu)
print("점수 함수    : 평균 %.3f, 분산 %.2f" % (score.mean(), score.var()))
print("재매개변수화 : 평균 %.3f, 분산 %.2f" % (pathwise.mean(), pathwise.var()))
참값 2μ : 2.0 점수 함수 : 평균 2.005, 분산 30.12 재매개변수화 : 평균 2.002, 분산 4.01
진짜 환경은 거슬러 미분할 수 없어서 REINFORCE 같은 점수 함수 추정이나 따로 학습한 가치 함수에 기대야 하지만, 학습된 World Model 안에서 상상하면 상태 → 행동 → 다음 상태 → 보상이 모두 신경망이라 리턴을 정책 매개변수로 곧바로 미분할 수 있습니다. Dreamer 가 (연속 행동에서) 상상 속에서 효율적으로 행동을 배우는 비결이 바로 이 재매개변수화 경사입니다.
부분 관측: POMDP 와 믿음 상태
지금까지는 에이전트가 진짜 상태 $s_t$ 를 본다고 가정했습니다. 하지만 8장부터 에이전트는 64×64 그림 $o_t$ 만 봅니다. 그림에는 각도는 보이지만 각속도는 보이지 않습니다. 같은 그림이라도 막대가 올라가는 중일 수도, 내려가는 중일 수도 있습니다. 관측이 상태의 일부만 보여 주는 문제를 부분 관측 마르코프 결정 과정partially observable MDP, POMDP이라 합니다.
$$ \text{POMDP} = (\mathcal{S}, \mathcal{A}, p, r, \gamma,\ \mathcal{O},\ p(o \mid s)) $$MDP 에 관측의 집합 $\mathcal{O}$ 와 관측 모델 $p(o \mid s)$ (상태 $s$ 일 때 무엇이 보이는가)를 더한 것입니다. 상태를 모르니, 지금까지의 관측과 행동으로 “지금 상태가 무엇일지에 대한 확률 분포” 를 들고 다녀야 합니다. 이것이 믿음 상태belief state $b_t(s) = p(s_t = s \mid o_{1:t}, a_{1:t-1})$ 입니다($o_{1:t}$ 는 $o_1, \dots, o_t$ 를 줄여 쓴 것이고, 여기서는 첫 관측의 시각을 1 로 세었습니다. 0 부터 세어도 식은 같습니다). 믿음은 새 관측이 올 때마다 베이즈 정리로 고칩니다.
진자로 말하면, 그림 두 장을 보면 각도 변화로 속도를 추정할 수 있습니다($\dot\theta \approx (\theta_t - \theta_{t-1})/\Delta t$). 믿음 갱신은 이것을 확률적으로, 여러 장에 걸쳐 일반화한 것입니다. 실제 문제에서는 상태 공간이 너무 커서 이 합을 정확히 계산할 수 없으므로, World Model 들은 신경망으로 된 요약을 대신 씁니다. 9장 MDN-RNN 의 은닉 상태 $h_t$, 11장 RSSM 의 잠재 상태 $(h_t, z_t)$ 가 바로 “학습된 믿음 상태” 이고, 11장 RSSM 의 구조는 위 식의 “예측 → 바로잡기” 두 단계를 그대로 닮았습니다.
모델 프리 vs 모델 기반, 그리고 Dyna
이제 강화학습 방법들을 크게 두 갈래로 나눌 수 있습니다.
| 모델 프리(model-free) | 모델 기반(model-based) | |
|---|---|---|
| 무엇을 배우나 | 정책 · 가치를 경험에서 직접 | 먼저 환경의 모델 $p_\theta(s'\mid s,a)$, $r_\theta$ (= World Model)를 배우고, 그 안에서 계획하거나 정책을 배움 |
| 예 | REINFORCE, 액터-크리틱, DQN, PPO, SAC | 가치 반복(모델을 알 때), Dyna, PETS(7장), World Models(10장), PlaNet(11장), Dreamer(12장), MuZero(13장) |
| 장점 | 모델 오차의 영향이 없음. 구현 단순. | 데이터 효율: 실제 경험 하나로 모델을 고치고, 모델 안에서 상상 경험을 무한히 만들 수 있음. 계획 · 새 목표에의 재사용. |
| 단점 | 환경과 아주 많이 상호작용해야 함(수백만 스텝). | 모델 오차: 오차가 쌓이고(6장), 모델이 틀린 곳을 정책이 파고드는 모델 착취가 생길 수 있음(7 · 10장). 구현 복잡. |
두 세계를 잇는 고전적인 생각이 서튼(Richard Sutton)의 DynaDyna architecture(Sutton, 1990 – 1991)입니다. 실제 경험으로 모델과 가치 함수를 함께 고치고, 모델이 만든 가상의 경험으로 가치 함수를 여러 번 더 고칩니다.
되풀이:
    1. 실제 환경에서 행동 a 를 하고 (s, a, r, s') 를 얻는다
    2. 이 실제 경험으로 가치 함수(또는 정책)를 고친다          ← 모델 프리 학습
    3. 이 경험으로 모델 p_θ(s'|s,a), r_θ 를 고친다             ← World Model 학습
    4. n 번 되풀이:                                            ← 상상(계획)
         지금까지 본 상태 s 와 행동 a 를 하나 고르고
         모델로 가상의 (r̂, ŝ') 를 만들어
         그 가상 경험으로 가치 함수를 고친다
3 번이 World Model 학습, 4 번이 “꿈속에서 연습하기” 입니다. 이 튜토리얼의 나머지는 이 뼈대를 점점 강력하게 만드는 이야기라고 봐도 좋습니다: 6장에서 3 번(모델 학습)을, 7장에서 4 번을 계획(MPC)으로, 10 · 12장에서 4 번을 정책 학습으로 구현합니다.
진자를 강화학습 문제로
마지막으로 이 튜토리얼의 무대를 강화학습의 언어로 정리하고, 앞으로 비교할 기준 점수를 구합니다.
| 요소 | 진자 환경 (wm_envs.Pendulum) |
|---|---|
| 상태 $s$ | $(\theta, \dot\theta)$ — 마르코프 상태 |
| 관측 $o$ | 6 · 7장: $[\cos\theta, \sin\theta, \dot\theta]$ (상태와 정보가 같음 → MDP). 8장~: 64×64 그림 (속도가 안 보임 → POMDP) |
| 행동 $a$ | 토크 $u \in [-2, 2]$ (연속 행동) |
| 전이 $p$ | 결정적 물리 법칙 $\ddot\theta = \frac{3g}{2l}\sin\theta + \frac{3}{ml^2}u$ (6장에서 유도), 오일러 적분 $\Delta t = 0.05$, 각속도는 $\pm 8$ 에서 자름 |
| 시작 상태 | $\theta$ 는 $[-\pi, \pi]$, $\dot\theta$ 는 $[-1, 1]$ 에서 고르게 무작위 |
| 보상 $r$ | $-(\theta^2 + 0.1\dot\theta^2 + 0.001u^2)$ ($\theta$ 는 $[-\pi, \pi)$ 로 접은 값). 범위 약 $[-16.3,\ 0]$: 가장 나쁜 경우가 $\pi^2 + 0.1\cdot 8^2 + 0.001\cdot 2^2 \approx 16.27$ |
| 에피소드 | 200 스텝에서 끊음(종료 상태는 없음). 평가 점수는 할인 없는 200 스텝 보상의 합 |
| 할인율 | 학습할 때 보통 $\gamma = 0.99$ (유효 지평 약 100 스텝 = 5초) |
손으로 만든 정책: 에너지 펌핑 + PD 제어
물리를 아는 사람이라면 진자를 세우는 정책을 직접 쓸 수 있습니다. 비교 기준으로 삼기 위해 하나 만들어 봅니다. 핵심은 에너지입니다.
그래서 정책은 둘로 나뉩니다. 맨 위 근처($\cos\theta \gt 0.9$, 약 ±26°)가 아니면 목표 에너지 5 와의 차이만큼 도는 방향으로 밀고(에너지 펌핑), 위 근처에서는 PD 제어 $u = -K_p\theta - K_d\dot\theta$ ($K_p = 10$, $K_d = 2$)로 균형을 잡습니다. 위 근처에서 $\sin\theta \approx \theta$ 로 근사하면 $\ddot\theta \approx 15\theta + 3u = 15\theta - 30\theta - 6\dot\theta = -15\theta - 6\dot\theta$ 가 되어, 용수철(복원력 $-15\theta$)과 마찰($-6\dot\theta$)이 있는 안정된 운동이 됩니다(단, 토크가 ±2 로 잘리므로 이 식은 $|10\theta + 2\dot\theta| \le 2$ 인 좁은 범위에서만 정확합니다. 그 밖에서는 에너지 펌핑이 알맞은 속도로 올려 보내 준 덕분에 균형이 잡힙니다).
[4] 진자: 세 가지 정책의 리턴 (할인 없이 200 스텝 보상 합)
  random      : 평균  -1233.7  표준편차  298.4  최소  -1867.0  최대   -754.2  (100 에피소드)
  zero torque : 평균  -1239.6  표준편차  367.3  최소  -1898.6  최대   -494.8  (100 에피소드)
  energy + PD : 평균   -182.5  표준편차  106.3  최소   -368.2  최대     -0.0  (100 에피소드)
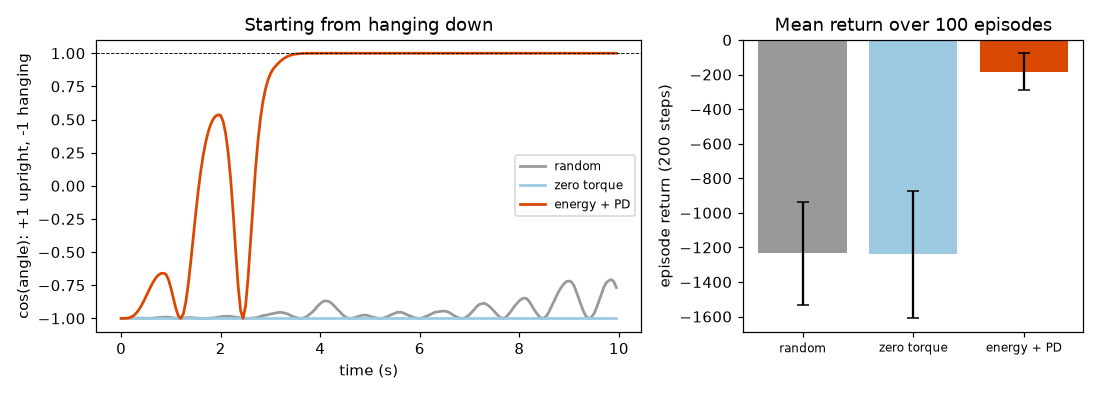
무작위 정책 약 −1234, 물리를 아는 사람이 만든 정책 약 −183. 손으로 만든 정책은 물리 법칙(에너지 식)을 알아야 쓸 수 있었습니다. 6 · 7장의 목표는 물리 법칙을 전혀 모른 채, 무작위로 모은 데이터만으로 World Model 을 배우고 그 안에서 계획해 이 점수(−200 안팎)에 다가가는 것입니다.
정리와 확인 문제
- MDP $(\mathcal{S}, \mathcal{A}, p, r, \gamma)$: 마르코프 성질 덕분에 궤적 확률이 $\rho_0\prod_t \pi(a_t\mid s_t)\,p(s_{t+1}\mid s_t,a_t)$ 로 분해된다.
- 리턴 $G_t = \sum_k \gamma^k r_{t+k} = r_t + \gamma G_{t+1}$. $\sum\gamma^k = \frac{1}{1-\gamma}$, 유효 지평 $\approx \frac{1}{1-\gamma}$.
- 벨만 기대 방정식 $V^\pi(s) = \sum_a\pi\sum_{s'}p\,[r + \gamma V^\pi(s')]$ 은 선형성 · 전체 기댓값 · 마르코프 성질로 유도된다. 최적이면 평균 대신 $\max$.
- 가치 반복은 오차를 매번 $\gamma$ 배 이하로 줄여 수렴한다. 단, 전이 확률 $p$ (= 모델)가 필요하다.
- 정책 경사 $\nabla J = \E[\sum_t (G_t - b)\nabla\log\pi]$: 로그 미분 트릭으로 환경 항이 사라진다. 기준선은 평균을 바꾸지 않고 분산을 줄인다.
- TD 오차 $\delta = r + \gamma V(s') - V(s)$ 의 기댓값은 이점. 액터-크리틱은 이것으로 정책과 가치를 함께 배운다.
- 미분 가능한 World Model 안에서는 재매개변수화 경사로 훨씬 정확한 기울기를 얻는다(12장).
- 그림만 보면 POMDP. 믿음 갱신 = 모델로 예측 → 관측으로 바로잡기. RNN · RSSM 은 이를 학습된 요약으로 대신한다.
- 진자 기준 점수: 무작위 −1234, 손으로 만든 정책 −183.
$\gamma = 0.5$ 이고 보상이 $(2, 0, 4)$ 일 때 $G_0$, $G_1$, $G_2$ 를 뒤에서부터 구하세요.
답 보기
$G_2 = 4$, $G_1 = 0 + 0.5 \times 4 = 2$, $G_0 = 2 + 0.5 \times 2 = 3$. 검산: $2 + 0.5^2 \times 4 = 3$.
매 스텝 보상이 $-1$ 이고 끝없이 이어진다면 $\gamma = 0.95$ 일 때 리턴은? 유효 지평은 대략 몇 스텝?
답 보기
$-1 \times \frac{1}{1 - 0.95} = -20$. 유효 지평 $\approx \frac{1}{0.05} = 20$ 스텝($0.95^{20} \approx 0.358$).
2×3 격자에서 $\gamma = 0.5$ 로 바꾸면 $V^\ast(C)$ 는 얼마인가요?
답 보기
C 에서 목표까지 최소 3번 이동(예: C → A → B → G), 마지막 이동에서 +1. $V^\ast(C) = \gamma^2 \times 1 = 0.25$.
REINFORCE 의 기울기 식에 환경의 전이 확률 $p(s'\mid s,a)$ 가 나타나지 않는 이유는?
답 보기
궤적 확률의 로그가 $\log\rho_0 + \sum\log\pi_\psi + \sum\log p$ 로 나뉘고, $\rho_0$ 와 $p$ 는 정책 매개변수 $\psi$ 와 무관하므로 $\psi$ 로 미분하면 0 이 되기 때문입니다. 환경은 궤적을 “뽑아 주는” 데만 쓰입니다.
기준선 $b(s)$ 를 빼도 정책 경사의 기댓값이 바뀌지 않는 이유를 한 줄로 설명하세요. 기준선이 행동 $a$ 에 따라 달라져도 될까요?
답 보기
$\E_{a\sim\pi}[\nabla\log\pi(a\mid s)] = \nabla\sum_a\pi = \nabla 1 = 0$ 이라 $b(s)$ 를 곱한 항의 기댓값이 0 이기 때문입니다. $b$ 가 $a$ 에 따라 달라지면 $b$ 를 기댓값 밖으로 꺼낼 수 없어 이 논리가 깨지고, 일반적으로 편향이 생깁니다.
진자 그림 한 장만 보는 에이전트에게 “지금 막대가 시계 방향으로 도는 중인지” 를 알려 주려면 어떤 정보가 더 필요할까요? 이 장의 용어로 답하세요.
답 보기
이전 관측(최소 한 장 더)과 행동의 기록이 필요합니다. 관측이 상태의 일부만 보여 주는 POMDP 이므로, 기록을 요약한 믿음 상태(또는 RNN 의 은닉 상태)를 들고 다녀야 합니다.
이제 재료가 모두 모였습니다. 다음 장에서 드디어 첫 번째 World Model 을 만듭니다. 진자의 물리 법칙을 뉴턴 법칙에서 유도해 “정답” 을 확인한 뒤, 그 법칙을 모르는 척하고 무작위 데이터만으로 신경망이 배우게 해 보겠습니다.