첫 번째 World Model
드디어 첫 World Model 을 만듭니다. 먼저 진자가 따르는 물리 법칙을 뉴턴 법칙에서 직접 유도해 “정답” 을 손에 쥡니다. 그다음 그 정답을 한 번도 보여 주지 않은 신경망에게 (상태, 행동, 다음 상태) 데이터만 주고, 같은 법칙을 얼마나 잘 배우는지 확인합니다. 마지막으로 이 모델로 여러 스텝을 이어서 “상상” 하면 오차가 어떻게 쌓이는지 수식과 실험으로 따져 봅니다.
- 진자의 운동 방정식 $\ddot{\theta} = \frac{3g}{2l}\sin\theta + \frac{3}{ml^2}u$ 를 토크 · 관성 모멘트에서 유도하기
- 미분 방정식을 컴퓨터로 푸는 오일러 적분과,
wm_envs.py코드 세 줄과의 대응 - World Model 학습을 “입력 4개 → 출력 4개” 의 지도 학습 문제로 바꾸기
- 학습을 쉽게 만드는 두 요령: 표준화, 다음 상태 대신 변화량 예측
- MSE 손실이 왜 “가우시안 최대우도” 와 같은지
- 열린 고리 롤아웃과 오차 누적: 립시츠 상수로 오차의 상한을 유도하고, 다스텝 손실로 줄이기
이 장의 큰 그림
0장에서 World Model 을 “지금 상태에서 이 행동을 하면 다음에 무슨 일이 일어날지 예측하는 학습된 시뮬레이터” 라고 정의했습니다. 이 장에서는 그 정의를 가장 단순한 형태 그대로 구현합니다. 관측은 숫자 3개 $o_t = [\cos\theta_t,\ \sin\theta_t,\ \dot\theta_t]$, 행동은 숫자 1개(토크 $a_t = u_t$)이고, 모델은 작은 신경망(MLP) 하나입니다.
이 장의 순서는 다음과 같습니다. ① 진짜 환경의 법칙을 유도해 “무엇을 배워야 하는지” 정확히 압니다. ② 그 법칙을 컴퓨터가 어떻게 한 스텝씩 계산하는지 봅니다. ③ 모델이 배울 문제를 정식화하고 데이터를 모읍니다. ④ 모델을 만들고 학습합니다. ⑤ 한 스텝 예측과 여러 스텝 상상이 얼마나 정확한지 잽니다.
진자의 물리 법칙 유도하기
World Model 은 물리 법칙을 몰라도 데이터에서 배울 수 있습니다. 그래도 정답을 알고 있으면 모델이 무엇을 배워야 하는지, 어디가 어려운지, 결과가 맞는지를 판단할 수 있습니다. 이 절은 고등학교 물리의 “힘 = 질량 × 가속도” 에서 출발합니다.
진자를 그림으로
회전의 뉴턴 법칙
물체가 직선으로 움직일 때는 뉴턴의 제2법칙 $F = ma$ 를 씁니다. 힘 $F$ 가 클수록, 질량 $m$ 이 작을수록 가속도 $a$ 가 큽니다. 물체가 축을 중심으로 돌 때는 이 법칙의 회전판을 씁니다.
$$ \tau = I\,\ddot{\theta} $$| 직선 운동 | 회전 운동 | 뜻 |
|---|---|---|
| 힘 $F$ | 토크torque $\tau$ | 밀거나(직선) 돌리는(회전) 정도 |
| 질량 $m$ | 관성 모멘트moment of inertia $I$ | 움직임을 바꾸기 어려운 정도 |
| 가속도 $a$ | 각가속도 $\ddot\theta$ | 속도가 1초에 얼마나 바뀌는지 |
토크 는 “힘 × 지렛대 팔” 입니다. 문을 열 때 경첩에서 먼 손잡이를 밀면 쉽고, 경첩 바로 옆을 밀면 어렵습니다. 같은 힘이라도 회전축에서 멀리, 그리고 팔에 수직으로 밀수록 잘 돌아갑니다. 정확히 쓰면, 회전축에서 힘이 걸리는 점까지의 벡터를 $\vec r$, 힘을 $\vec F$ 라 할 때 토크는 외적(cross product) $\vec\tau = \vec r \times \vec F$ 이고, 그 크기는
$$ |\tau| = |\vec r|\,|\vec F|\,\sin\alpha $$입니다. 여기서 $\alpha$ 는 $\vec r$ 과 $\vec F$ 사이의 각입니다. $\sin\alpha$ 가 붙는 까닭은 힘 가운데 팔에 수직인 성분 $|\vec F|\sin\alpha$ 만 돌리는 데 쓰이고, 팔과 나란한 성분은 축을 밀거나 당길 뿐이기 때문입니다. 같은 값을 “힘 $\times$ (회전축에서 힘의 작용선까지의 수직 거리)” 로 읽을 수도 있습니다. 이 수직 거리 $|\vec r|\sin\alpha$ 를 지렛대 팔 이라고 부릅니다.
관성 모멘트를 적분으로 구하기
질량 $m$ 인 점 하나가 회전축에서 거리 $r$ 에 있으면 관성 모멘트는 $I = m r^2$ 입니다. (점에 수직으로 힘 $F$ 를 주면 $F = m a = m\,r\ddot\theta$ 이고, 토크는 $\tau = rF = m r^2 \ddot\theta$ 이므로 $\tau = I\ddot\theta$ 와 비교하면 $I = mr^2$ 입니다.) 막대는 점이 아니라 길이 $l$ 에 질량이 고르게 퍼져 있으므로, 막대를 아주 잘게 잘라 각 조각의 $m_i r_i^2$ 을 모두 더합니다.
숫자로 확인해 보면 ($m = l = 1$), $n = 4$ 일 때 $\frac{30}{64} = 0.46875$, $n = 10$ 일 때 $0.385$, $n = 100$ 일 때 $0.33835$, $n = 1000$ 일 때 $0.33383$ 으로 $\frac13 = 0.3333\ldots$ 에 다가갑니다. 같은 계산을 적분으로 쓰면 한 줄입니다. 조각의 길이를 $dr$ 로 아주 작게 하면 조각의 질량은 $dm = \frac{m}{l}dr$ 이므로
$$ I = \int_0^l r^2\,dm = \int_0^l r^2\,\frac{m}{l}\,dr = \frac{m}{l}\Big[\frac{r^3}{3}\Big]_0^l = \frac{m}{l}\cdot\frac{l^3}{3} = \frac{1}{3}ml^2 $$입니다. $\int r^2 dr = \frac{r^3}{3}$ 는 “$\frac{r^3}{3}$ 을 미분하면 $r^2$” 이라는 사실을 거꾸로 쓴 것입니다(4장에서 미분을 다룹니다). 우리 진자는 $m = l = 1$ 이므로 $I = \frac13$ 입니다.
중력이 만드는 토크
중력은 막대의 모든 조각을 아래로 당기지만, 균일한 막대에서는 그 효과가 질량 중심(막대의 한가운데, 축에서 $l/2$)에 전체 무게 $mg$ 가 걸린 것과 같습니다. 이제 이 힘이 만드는 토크를 구합니다.
운동 방정식
막대에 걸리는 토크는 중력 토크 $\tau_g$ 와 모터 토크 $u$ 두 가지입니다. 회전의 뉴턴 법칙에 넣고 $\ddot\theta$ 에 대해 풉니다.
wm_envs.py 의 3.0 * self.g / (2.0 * self.l) * np.sin(th) + 3.0 / (self.m * self.l**2) * u 가 바로 이 식입니다.왜 한 번에 들어 올릴 수 없는가
막대가 수평($\theta = \pi/2$, $\sin\theta = 1$)일 때 중력 항은 $15$ 입니다. 모터 항은 아무리 세게 해도 $3 \times 2 = 6$ 입니다. 막대를 수평에 붙잡아 두려면 $\ddot\theta = 0$, 즉 $15 + 3u = 0$, $u = -5$ 가 필요한데, 토크 한계가 $2$ 이므로 불가능합니다. 그래서 에이전트는 그네처럼 앞뒤로 흔들어 운동 에너지를 모은 뒤, 그 기세로 위까지 올라가야 합니다. “지금 당장 각도를 줄이는 행동” 이 아니라 “잠시 반대로 가는 행동” 이 필요하다는 점이 이 문제를 흥미롭게 만들고, 7장에서 여러 스텝 앞을 내다보는 계획 이 필요한 까닭이 됩니다.
미분 방정식을 컴퓨터로 풀기: 오일러 적분
운동 방정식은 “각가속도가 지금 각도에 따라 정해진다” 는 미분 방정식differential equation 입니다. 컴퓨터는 연속된 시간을 다룰 수 없으므로, 시간을 $\Delta t = 0.05$ 초 간격으로 잘라 한 칸씩 계산합니다. 가장 간단한 방법이 오일러 적분입니다.
미분의 정의를 거꾸로 쓰기
명시적 오일러와 반암시적 오일러
위 두 식을 적용하는 순서에 따라 두 가지 방법이 있습니다. 아래 첨자 $t$ 는 “$t$ 번째 스텝” 입니다.
| 명시적 오일러 (explicit) | 반암시적 오일러 (semi-implicit) |
|---|---|
| $\dot\theta_{t+1} = \dot\theta_t + \ddot\theta_t\,\Delta t$ $\theta_{t+1} = \theta_t + \dot\theta_{\color{#c33}t}\,\Delta t$ |
$\dot\theta_{t+1} = \dot\theta_t + \ddot\theta_t\,\Delta t$ $\theta_{t+1} = \theta_t + \dot\theta_{\color{#c33}t+1}\,\Delta t$ |
| 각도를 옛 속도로 갱신 | 각도를 새 속도로 갱신 |
차이는 아주 작아 보이지만 결과는 크게 다릅니다. 토크 없이($u=0$) $\theta_0 = 2.0$, $\dot\theta_0 = 0$ 에서 200 스텝(10초)을 돌리며
역학적 에너지 $E = \frac12 I\dot\theta^2 + mg\frac{l}{2}\cos\theta$ 를 재면(적분 방법만 비교하려고 각속도 자르기는 뺐습니다), 에너지는 원래 보존되어야 하는데(마찰이 없으므로)
명시적 오일러는 $-2.081 \to 18.015$ 로 에너지가 저절로 불어나 진자가 점점 더 크게 휘돕니다. 반암시적 오일러는 $-2.081 \to -2.292$ 로 처음 값 근처에 머뭅니다.
그래서 Gym 의 진자(와 우리 wm_envs.py)는 반암시적 오일러를 씁니다.
$\theta_0 = \pi/2$ (수평), $\dot\theta_0 = 0$, $u = 0$ 에서 반암시적 오일러로 한 스텝($\Delta t = 0.05$) 진행한 $\dot\theta_1$, $\theta_1$ 은?
답 보기
$\ddot\theta_0 = 15\sin(\pi/2) + 3\cdot 0 = 15$. $\dot\theta_1 = 0 + 15 \times 0.05 = 0.75$. $\theta_1 = \pi/2 + 0.75\times0.05 = 1.5708 + 0.0375 = 1.6083$. (명시적 오일러였다면 $\theta_1 = \pi/2 + 0\times0.05 = 1.5708$ 로 각도가 아직 그대로입니다.)
코드와 한 줄씩 짝짓기
이제 0장에서 보았던 환경 코드를 다시 봅니다. step() 의 핵심 세 줄이 지금까지 유도한 식과 정확히 대응합니다.
| 수식 | 코드 |
|---|---|
| $u \leftarrow \mathrm{clip}(a_t, -2, 2)$ | u = float(np.clip(..., -self.max_torque, self.max_torque)) |
| $r_t = -(\theta_t^2 + 0.1\dot\theta_t^2 + 0.001u^2)$ | cost = angle_normalize(th) ** 2 + 0.1 * thdot**2 + 0.001 * u**2 |
| $\dot\theta_{t+1} = \dot\theta_t + \left(\frac{3g}{2l}\sin\theta_t + \frac{3}{ml^2}u\right)\Delta t$ | thdot_new = thdot + (3.0 * self.g / (2.0 * self.l) * np.sin(th) + ...) * self.dt |
| $\dot\theta_{t+1} \leftarrow \mathrm{clip}(\dot\theta_{t+1}, -8, 8)$ | thdot_new = float(np.clip(thdot_new, -self.max_speed, self.max_speed)) |
| $\theta_{t+1} = \theta_t + \dot\theta_{t+1}\Delta t$ | th_new = th + thdot_new * self.dt |
보상식의 $\theta_t$ 는 $[-\pi, \pi)$ 로 접은 각도입니다. 환경 안의 th 는 여러 바퀴 돌면 $2\pi$ 를 넘어 계속 커지므로,
보상을 계산할 때 angle_normalize 로 접어 “똑바로 선 자세에서 얼마나 벗어났는지” 만 잽니다.
$\Delta t = 0.05$ 는 꽤 큰 간격이라 오일러 적분에는 오차가 있고, 각속도를 $\pm 8$ 에서 자르는 것도 진짜 물리에는 없는 규칙입니다. 하지만 World Model 의 관점에서는 상관없습니다. 모델이 배워야 할 “세상” 은 바로 이 코드 자체이기 때문입니다. 모델은 진짜 물리가 아니라 이 환경이 만들어 내는 데이터 를 흉내 냅니다.
관측을 (cos θ, sin θ, θ̇) 로 주는 까닭
환경은 각도 $\theta$ 를 그대로 주지 않고 $\cos\theta$, $\sin\theta$ 두 숫자로 나누어 줍니다. 각도에는 이음매 가 있기 때문입니다. $\theta = 3.1$ 과 $\theta = -3.1$ 은 둘 다 거의 아래로 매달린 자세라 물리적으로 아주 가깝습니다(실제 각도 차이는 $6.2 - 2\pi \approx -0.083$). 그런데 숫자로는 $6.2$ 나 떨어져 있습니다. 신경망 입장에서는 비슷한 두 입력에 대해 비슷한 출력을 내야 하는데, 입력 숫자가 크게 다르면 배우기 어렵습니다.
반면 $(\cos\theta, \sin\theta)$ 로 바꾸면 두 자세의 거리는 실제 각도 차이를 그대로 반영합니다. 이것을 유도해 보겠습니다.
$a = 3.1$, $b = -3.1$ 을 넣으면 $d = 2|\sin 3.1| = 2 \times 0.04158 = 0.0832$ 로, 실제 각도 차이 $0.0832$ 와 같습니다. $6.2$ 가 아닙니다.
반대로 관측에서 각도를 되살릴 때는 atan2(sin θ, cos θ) 를 씁니다. 이 함수는 두 값의 부호까지 보고 $[-\pi, \pi]$ 의 각도를 돌려줍니다.
World Model 문제를 지도 학습으로 바꾸기
이제 모델이 풀 문제를 정확히 적습니다. 환경과 몇 번 상호작용해 전이(transition) 데이터를 모읍니다.
$$ \mathcal{D} = \big\{ (o_t,\ a_t,\ o_{t+1},\ r_t) \big\} $$그리고 입력 $x = [o_t,\ a_t]$ (숫자 4개)를 받아 정답 $y = [o_{t+1},\ r_t]$ (숫자 4개)에 가까운 값을 내는 함수 $f_\theta$ 를 찾습니다(실제 신경망은 뒤에서 설명할 이유로 표준화한 변화량을 출력합니다. $f_\theta$ 는 그 후처리까지 포함한 “모델 전체” 를 가리키는 이름으로 씁니다).
$$ f_\theta:\ \underbrace{[\cos\theta_t,\ \sin\theta_t,\ \dot\theta_t,\ u_t]}_{\text{입력 4개}} \ \longmapsto\ \underbrace{[\hat o_{t+1},\ \hat r_t]}_{\text{출력 4개}} $$“입력과 정답의 짝을 많이 보여 주고, 입력에서 정답을 맞히는 함수를 배운다” — 4장에서 배운 지도 학습supervised learning 의 회귀(regression) 문제 그대로입니다. World Model 이 특별한 이유는 문제가 어려워서가 아니라, 이렇게 배운 함수를 계속 이어 붙여 미래를 상상하는 데 쓴다는 점에 있습니다.
보상 함수 $r = -(\theta^2 + 0.1\dot\theta^2 + 0.001u^2)$ 는 우리가 정한 “과제” 라서 대개 알고 있습니다. 이 장에서는 연습 삼아 보상까지 모델이 예측하게 하고,
7장의 계획에서는 알고 있는 보상 함수(pendulum_reward)를 그대로 씁니다. 그림을 보는 8장 이후처럼 보상을 상태에서 바로 계산할 수 없을 때는 보상도 반드시 배워야 합니다.
데이터 모으기
아직 좋은 정책이 없으므로 행동은 $[-2, 2]$ 에서 무작위로 고릅니다. 학습용 50 에피소드(10,000 전이)와, 시드(난수 씨앗)를 달리한 검증용 10 에피소드(2,000 전이)를 따로 모읍니다. 먼저 에피소드 목록을 전이 배열로 펴는 함수입니다.
에피소드 하나의 obs 는 시작 관측을 포함해 길이가 $T+1 = 201$ 입니다. 그래서 ep["obs"][:-1](앞의 200개)가 $o_t$,
ep["obs"][1:](뒤의 200개)가 $o_{t+1}$ 이 되어 한 칸씩 어긋난 짝이 만들어집니다.
make_inputs_targets 는 입력 $[o_t, a_t]$ 와 정답 $[o_{t+1} - o_t,\ r_t]$ 를 만듭니다. 정답에 $o_{t+1}$ 이 아니라 차이 $o_{t+1} - o_t$ 를 쓰는 까닭은 곧 설명합니다.
device: cpu
train transitions: 10000, val transitions: 2000
무작위 행동으로는 진자를 세울 수 없으므로, 이 데이터에는 “위에서 천천히 균형 잡는 상태” 가 거의 없습니다. 실제로 학습 데이터에서 $|\theta| \lt 0.3$ 이고 $|\dot\theta| \lt 1$ 인 전이는 $1.45\%$ 뿐이고, 아래쪽($|\theta| \gt \pi - 0.5$)은 $28.6\%$ 입니다. 모델은 데이터가 많은 곳에서는 정확하고, 드문 곳에서는 부정확할 것입니다. 7장에서는 모델로 계획한 행동으로 새 데이터를 모아 이 빈틈을 메웁니다.
학습을 쉽게 만드는 두 가지 요령
요령 1: 표준화
입력과 정답의 숫자 크기가 제각각입니다. 실제 학습 데이터의 정답 표준편차를 보면 $\Delta\cos\theta$ 는 $0.125$, $\Delta\sin\theta$ 는 $0.134$, $\Delta\dot\theta$ 는 $0.538$, 보상은 $3.756$ 입니다(입력 쪽도 $\cos\theta$ 는 $0.67$, $\dot\theta$ 는 $3.67$ 로 다릅니다). 이대로 MSE(오차 제곱의 평균)를 쓰면 보상 오차가 손실을 거의 다 차지합니다. 오차의 크기가 각자의 표준편차 정도라고 하면 제곱 오차는 $3.756^2 \approx 14.1$ 대 $0.125^2 \approx 0.016$ 으로 약 900 배 차이가 나서, 모델은 보상만 열심히 맞히고 $\cos\theta$ 의 변화는 무시하게 됩니다.
그래서 열마다 평균 $\mu$ 를 빼고 표준편차 $\sigma$ 로 나누는 표준화standardization 를 합니다.
$$ \tilde{x} = \frac{x - \mu}{\sigma}, \qquad \mu = \frac1N\sum_{i=1}^N x_i, \qquad \sigma = \sqrt{\frac1N\sum_{i=1}^N (x_i - \mu)^2} $$예: 학습 데이터에서 보상 열의 평균은 $-5.965$, 표준편차는 $3.756$ 이므로, 보상 $-1.0$ 은 $\frac{-1.0 - (-5.965)}{3.756} = 1.32$ 로 바뀝니다. 모델은 이렇게 표준화된 공간에서 배우고, 예측할 때는 거꾸로 $x = \tilde x\,\sigma + \mu$ 로 되돌립니다.
$\mu$, $\sigma$ 는 학습 데이터로만 구하고, 검증 · 실제 사용 때도 같은 값을 씁니다. 검증 데이터의 통계를 쓰면 검증 데이터의 정보가 학습에 새어 들어가 성능을 실제보다 좋게 착각할 수 있습니다. 또 $\sigma$ 가 0 인 열(값이 늘 같은 열)이 있으면 0 으로 나누게 되므로 코드에서는 $\sigma + 10^{-6}$ 으로 나눕니다.
요령 2: 다음 상태 대신 변화량을 예측하기
$\Delta t = 0.05$ 초 동안 진자는 많이 움직이지 않으므로 $o_{t+1}$ 은 $o_t$ 와 매우 비슷합니다. 모델이 $o_{t+1}$ 을 통째로 내게 하면 “입력을 거의 그대로 베끼기” 와 “아주 작은 변화 더하기” 를 함께 배워야 하는데, 중요한 정보는 작은 변화 쪽에 다 들어 있습니다. 그래서 변화량 $\Delta o_t = o_{t+1} - o_t$ 를 예측하게 하고, 다음 관측은 더해서 만듭니다.
$$ \hat o_{t+1} = o_t + \widehat{\Delta o}_t $$숫자로 보면 차이가 분명합니다. $\dot\theta_t = 5.0$, $\dot\theta_{t+1} = 5.3$ 이라고 합시다. $o_{t+1}$ 을 통째로 예측하면서 $1\%$ 오차를 내면 $0.053$ 이 틀리는데, 이것은 실제 변화 $0.3$ 의 약 $18\%$ 나 됩니다. 변화량을 예측하면서 $1\%$ 오차를 내면 $0.003$ 만 틀립니다. 이 아이디어는 ResNet 의 “잔차 연결(residual connection)” 과 같은 생각으로, 거의 모든 동역학 모델이 씁니다.
모델 만들기: MLP 동역학 모델
한 줄씩 읽어 보겠습니다.
-
self.net: 입력 4개 → 너비 128 인 은닉층 3개 → 출력 4개($\Delta o$ 3개 + 보상 1개)의 MLP 입니다(4장). 층 사이의 활성 함수는 SiLUSigmoid Linear Unit, Swish $\mathrm{SiLU}(x) = x\cdot\sigma(x) = \frac{x}{1+e^{-x}}$ 입니다. ReLU 와 비슷하지만 0 근처에서 매끄러워서, 매끄러운 물리 법칙을 흉내 내기에 알맞습니다. - 매개변수 수(가중치 + 편향): 첫 층 $4\times128 + 128 = 640$, 둘째 · 셋째 층 각각 $128\times128 + 128 = 16{,}512$, 마지막 층 $128\times4 + 4 = 516$, 합계 $640 + 16{,}512 \times 2 + 516 = 34{,}180$ 개입니다.
-
register_buffer: 표준화 통계 $\mu_x, \sigma_x, \mu_y, \sigma_y$ 를 모델 안에 보관합니다. 경사 하강법으로 바뀌지는 않지만,model.to("cuda")나torch.save때 가중치와 함께 따라다니므로 “모델 파일 하나에 필요한 것이 다 들어 있게” 됩니다. forward_normalized: 표준화된 입력 $\tilde x$ 를 넣어 표준화된 출력 $\tilde y$ 를 냅니다. 학습은 이 공간에서 합니다.-
predict: 사용할 때의 함수입니다. $\tilde y$ 를 원래 단위로 되돌리고($y = \tilde y\odot\sigma_y + \mu_y$), 앞의 3개를 현재 관측에 더해 다음 관측을, 마지막 1개를 보상으로 돌려줍니다. 수식으로는 $\hat o_{t+1} = o_t + [\tilde y\odot\sigma_y + \mu_y]_{1:3}$, $\hat r_t = [\tilde y\odot\sigma_y + \mu_y]_4$ 입니다.
모델이 $\cos\theta$ 와 $\sin\theta$ 를 따로 예측하므로 $\hat c^2 + \hat s^2$ 이 정확히 1 이 아닐 수 있습니다. 한 스텝에서는 아주 작은 차이지만 여러 스텝 이어 붙이면 커질 수 있습니다.
이 장에서는 그대로 두고, 각도를 되살릴 때 atan2 를 써서(두 값의 비율만 보므로) 영향을 줄입니다. 예측 뒤에 $(\hat c, \hat s)$ 를 길이 1 로 나눠 주는 방법도 있습니다.
손실 함수: MSE 는 가우시안 최대우도다
모델을 학습하려면 “예측이 얼마나 틀렸는지” 를 하나의 숫자로 재는 손실 함수가 필요합니다. 여기서는 표준화된 공간의
평균 제곱 오차mean squared error, MSE 를 씁니다.
이 절의 식에서 $f_\theta(\tilde x)$ 는 표준화된 입력을 받아 표준화된 출력을 내는 신경망 자체(코드의 forward_normalized)를 가리킵니다.
왜 하필 제곱일까요? 2장에서 본 최대우도와 연결하면 이유가 분명해집니다. “진짜 값 = 모델의 예측 + 가우시안 잡음” 이라고 가정해 봅시다.
$$ \tilde y = f_\theta(\tilde x) + \epsilon, \qquad \epsilon \sim \Normal(0, \sigma^2) $$그러면 모델이 주는 정답의 확률 밀도는 $p_\theta(\tilde y \mid \tilde x) = \Normal\big(\tilde y;\ f_\theta(\tilde x),\ \sigma^2\big)$ 이고, 데이터 전체의 음의 로그 가능도(NLL)를 최소화하는 것이 최대우도 학습입니다.
즉 MSE 를 쓰는 순간 우리는 “잡음은 가우시안이고, 그 크기는 모든 곳에서 같다” 고 가정한 것입니다. 진자는 결정적이라(같은 상태 · 행동이면 늘 같은 다음 상태) 이 가정이 크게 문제 되지 않습니다. 7장에서는 $\sigma$ 까지 모델이 예측하게 해서 “여기는 잘 모르겠다” 를 표현하는 확률적 모델로 넓힙니다.
MSE 의 기울기도 간단합니다. 예측 하나에 대해 $\frac{\partial}{\partial \hat y}(\hat y - y)^2 = 2(\hat y - y)$ 이므로, 예측이 정답보다 $0.3$ 크면 기울기는 $0.6$, 경사 하강법은 예측을 줄이는 쪽으로 가중치를 고칩니다. 많이 틀릴수록 많이 고칩니다.
학습하기
- 표준화:
model.set_normalizer(inputs, targets)로 학습 데이터의 통계를 정하고, 정답도 같은 통계로 표준화해 $\tilde y$ 를 만듭니다. - 에폭과 미니배치: 한 에폭epoch 은 데이터 전체를 한 번 훑는 것입니다. 매 에폭 순서를 섞고(
randperm), 256개씩 잘라 기울기를 계산합니다. 10,000개면 에폭당 40번 가중치를 고칩니다. - 한 스텝:
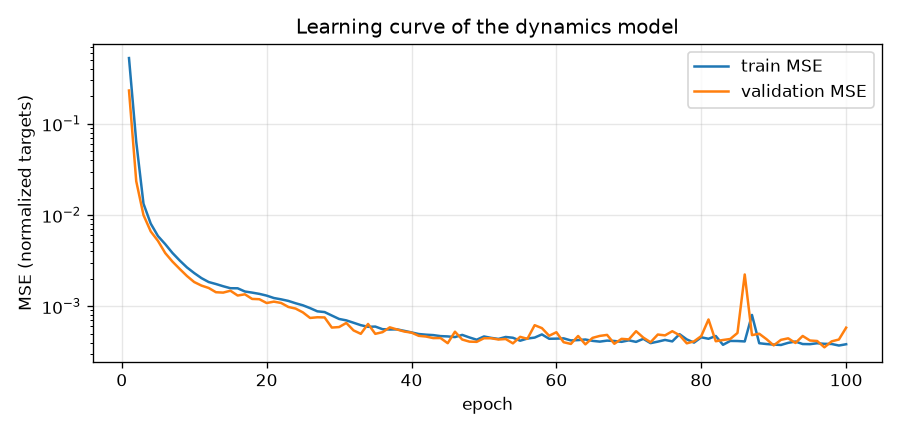
forward_normalized로 예측 →((pred - y) ** 2).mean()으로 MSE →zero_grad·backward·step으로 Adam 갱신(4장). - 검증 손실: 학습에 쓰지 않은 검증 데이터의 MSE 를 매 에폭 잽니다. 학습 손실만 줄고 검증 손실이 늘면 과적합overfitting(외우기만 하고 일반화 못 함)입니다.
epoch    1 | train MSE 0.52619 | val MSE 0.23190
epoch   10 | train MSE 0.00231 | val MSE 0.00184
epoch   20 | train MSE 0.00131 | val MSE 0.00108
epoch   30 | train MSE 0.00073 | val MSE 0.00059
epoch   40 | train MSE 0.00052 | val MSE 0.00051
epoch   50 | train MSE 0.00047 | val MSE 0.00045
epoch   60 | train MSE 0.00044 | val MSE 0.00052
epoch   70 | train MSE 0.00042 | val MSE 0.00043
epoch   80 | train MSE 0.00046 | val MSE 0.00047
epoch   90 | train MSE 0.00038 | val MSE 0.00037
epoch  100 | train MSE 0.00038 | val MSE 0.00058
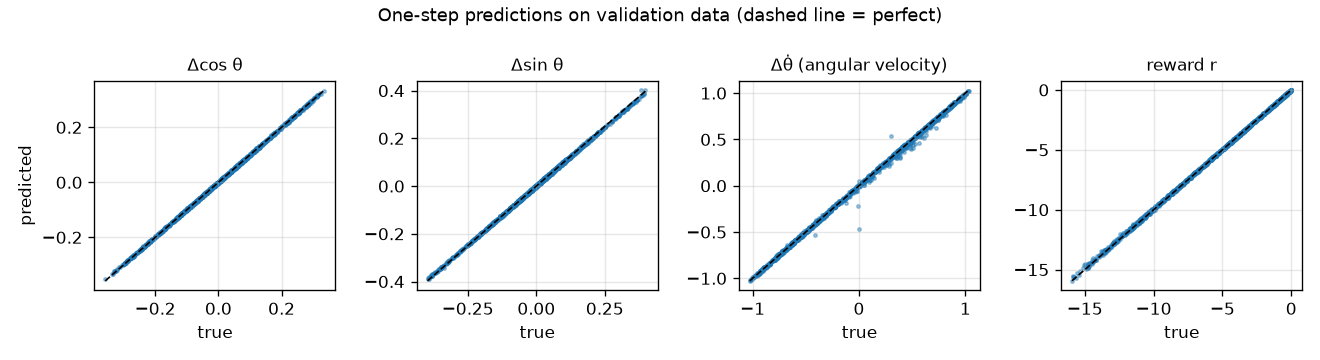
one-step accuracy on validation data:
  d_cos    RMSE 0.00161  (target std 0.1412)  R^2 0.99987
  d_sin    RMSE 0.00275  (target std 0.1470)  R^2 0.99965
  d_thdot  RMSE 0.02024  (target std 0.5686)  R^2 0.99873
  reward   RMSE 0.06770  (target std 4.0399)  R^2 0.99972
전체 스크립트(python ch06_dynamics.py)는 이 튜토리얼을 쓴 환경(노트북 CPU 4스레드)에서 약 46초 걸렸습니다. --quick 은 5초 남짓입니다.
얼마나 잘 맞히나: 1스텝 예측
위 출력의 두 지표를 정의해 둡니다. $y_i$ 는 정답, $\hat y_i$ 는 예측, $\bar y$ 는 정답의 평균입니다.
$$ \text{RMSE} = \sqrt{\frac1N\sum_{i}(\hat y_i - y_i)^2}, \qquad R^2 = 1 - \frac{\sum_i (\hat y_i - y_i)^2}{\sum_i (y_i - \bar y)^2} $$RMSE 는 “평균적으로 얼마나 틀리는지” 를 원래 단위로 나타냅니다. $R^2$ 의 분모는 “평균 $\bar y$ 하나로 모든 것을 찍었을 때의 오차” 이고, 분자는 모델의 오차입니다. 그래서 $R^2 = 1$ 이면 완벽, $R^2 = 0$ 이면 평균 찍기와 같은 수준입니다. $\Delta\dot\theta$ 의 RMSE 는 $0.020$ 으로, 검증 데이터 정답의 퍼짐(표준편차 $0.569$)에 비하면 아주 작아 $R^2 = 0.9987$ 입니다. 모델은 물리 법칙을 한 번도 보지 않고도, 데이터만으로 운동 방정식을 거의 그대로 흉내 냈습니다. 보상도 $R^2 = 0.9997$ 로 배웠습니다.
상상을 이어 붙이기: 열린 고리 롤아웃
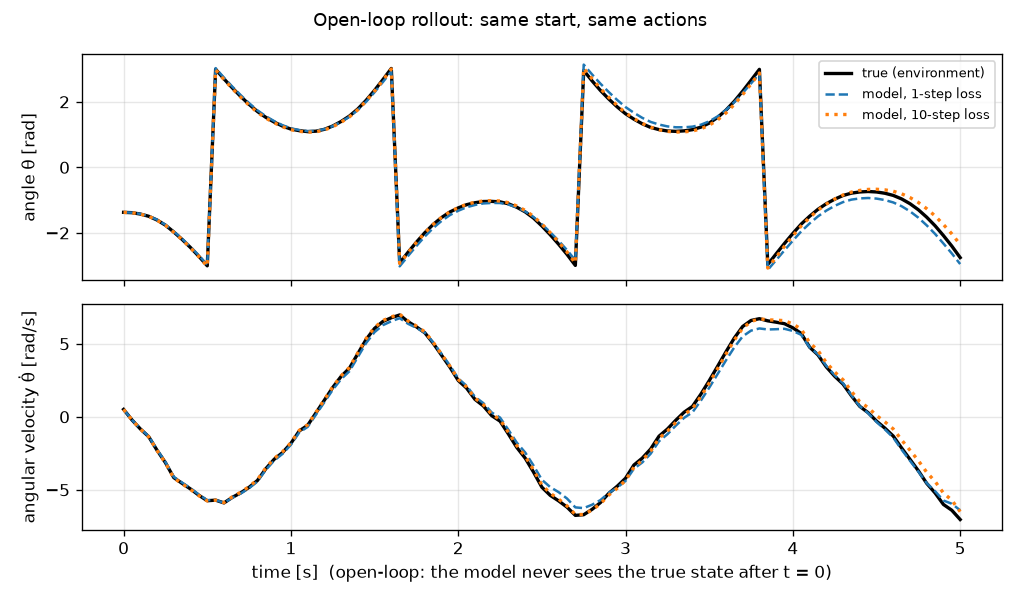
1스텝 예측이 정확하다고 해서 끝이 아닙니다. World Model 의 진짜 쓰임새는 여러 스텝 앞 을 상상하는 것입니다. 시작 관측 $o_0$ 하나와 행동열 $a_0, a_1, \dots, a_{H-1}$ 만 주고, 모델의 예측을 다시 모델의 입력으로 넣어 $H$ 스텝을 굴립니다.
$$ \hat o_1 = f_\theta(o_0, a_0),\quad \hat o_2 = f_\theta(\hat o_1, a_1),\quad \dots,\quad \hat o_H = f_\theta(\hat o_{H-1}, a_{H-1}) $$중간에 진짜 관측을 다시 보지 않으므로 이것을 열린 고리 롤아웃open-loop rollout 이라고 합니다. (반대로 매 스텝 진짜 관측을 보고 다시 시작하는 것은 닫힌 고리(closed-loop), 곧 되먹임(feedback)이 있는 방식입니다.)
o, r = model.predict(o, actions[:, k]) 한 줄에서 o 가 자기 자신의 예측으로 덮어씌워지는 것이 핵심입니다.
배치 차원 B 를 두어 여러 롤아웃을 한꺼번에 계산합니다. @torch.no_grad() 는 학습이 아니라 사용하는 중이므로 기울기를 기록하지 않게 해 빠르고 가볍게 만듭니다.
오차는 왜 쌓이는가: 오차 누적 분석
그림 6-6 처럼 롤아웃이 길어질수록 진짜와 멀어지는 현상을 오차 누적compounding error 이라고 합니다. 얼마나 빨리 쌓이는지 수식으로 따져 보겠습니다. 표기를 간단히 하려고 행동은 생략하고, 진짜 환경을 $s_{k+1} = f(s_k)$, 모델을 $\hat s_{k+1} = \hat f(\hat s_k)$ 로 씁니다. $k$ 스텝 뒤의 오차를 $e_k = \|\hat s_k - s_k\|$ 라 합니다($\|\cdot\|$ 은 벡터의 길이).
두 가지 가정을 둡니다.
- 1스텝 오차가 작다: 모든 상태 $s$ 에서 $\|\hat f(s) - f(s)\| \le \varepsilon$. (같은 곳에서 출발하면 한 스텝 뒤 많아야 $\varepsilon$ 만큼 틀린다.)
- 모델이 립시츠 연속이다: 모든 $s, s'$ 에서 $\|\hat f(s) - \hat f(s')\| \le L\,\|s - s'\|$. 입력이 $\delta$ 만큼 다르면 출력은 많아야 $L\delta$ 만큼 다르다는 뜻이고, $L$ 을 립시츠 상수Lipschitz constant 라고 합니다. $L \gt 1$ 이면 작은 차이가 한 스텝마다 최대 $L$ 배로 커질 수 있고, $L \lt 1$ 이면 줄어듭니다.
증폭 계수는 $L$ 에 따라 성격이 완전히 다릅니다.
| 경우 | 상한 | 뜻 | 예: $\varepsilon = 0.01$, $k = 20$ |
|---|---|---|---|
| $L \lt 1$ (차이를 줄이는 모델) | $\varepsilon\frac{1 - L^k}{1-L} \lt \frac{\varepsilon}{1-L}$ | 오차가 일정 값 아래에 머문다 | $L = 0.9$: $0.01\times\frac{1-0.9^{20}}{0.1} = 0.088$ |
| $L = 1$ | $k\,\varepsilon$ | 오차가 스텝 수에 비례해 늘어난다 | $0.01\times 20 = 0.2$ |
| $L \gt 1$ (차이를 키울 수 있는 모델) | $\varepsilon\frac{L^k - 1}{L-1}$ | 오차가 지수적으로 커진다 | $L = 1.1$: $0.01\times\frac{1.1^{20}-1}{0.1} = 0.573$ |
($L = 1$ 인 경우는 $\sum_{j=0}^{k-1} 1^j = k$ 이므로 따로 계산했습니다. $1.1^{20} \approx 6.727$, $0.9^{20} \approx 0.122$ 입니다.) 같은 1스텝 오차라도 $L = 1.1$ 이면 20 스텝 뒤 상한이 $L = 0.9$ 일 때의 6배가 넘습니다. 오차 누적은 모델이 나빠서만이 아니라 세상 자체가 작은 차이를 키우는 성질 을 가질 때 특히 심해집니다.
진짜 진자가 작은 차이를 얼마나 키우는지 계산해 볼 수 있습니다(잘 배운 모델도 이 성질을 그대로 흉내 냅니다). 똑바로 선 자세 근처($\theta \approx 0$)에서 $\sin\theta \approx \theta$ 로 근사하고 $u = 0$ 이면, 반암시적 오일러 한 스텝은 다음과 같습니다($\Delta t = 0.05$, $15\Delta t = 0.75$).
$$ \dot\theta_{t+1} = \dot\theta_t + 0.75\,\theta_t, \qquad \theta_{t+1} = \theta_t + 0.05\,\dot\theta_{t+1} = 1.0375\,\theta_t + 0.05\,\dot\theta_t $$(둘째 식은 첫째 식을 대입해 $\theta_t + 0.05(\dot\theta_t + 0.75\theta_t)$ 를 정리한 것입니다.) 행렬로 쓰면 $\begin{pmatrix}\theta_{t+1}\\ \dot\theta_{t+1}\end{pmatrix} = A\begin{pmatrix}\theta_t\\ \dot\theta_t\end{pmatrix}$, $A = \begin{pmatrix}1.0375 & 0.05\\ 0.75 & 1\end{pmatrix}$ 입니다. 여러 스텝에 걸쳐 작은 차이가 한 스텝마다 평균 몇 배씩 되는지는 $A$ 의 고윳값 $\lambda$ 가 알려 줍니다. 고윳값은 $\det(A - \lambda I) = 0$ 의 해입니다.
$$ (1.0375 - \lambda)(1 - \lambda) - 0.05\times0.75 = 0 \ \Rightarrow\ \lambda^2 - 2.0375\lambda + 1 = 0 $$(전개하면 $\lambda^2 - 2.0375\lambda + 1.0375 - 0.0375$ 입니다.) 근의 공식으로 $\lambda = \frac{2.0375 \pm \sqrt{2.0375^2 - 4}}{2} = \frac{2.0375 \pm 0.3891}{2}$, 곧 $\lambda_1 \approx 1.2133$, $\lambda_2 \approx 0.8242$ 입니다. 위에 선 자세 근처에서는 작은 차이가 길게 보면 한 스텝마다 약 1.21 배 커집니다. 20 스텝(1초) 뒤면 $1.2133^{20} \approx 47.8$ 배입니다. 반대로 매달린 자세($\theta \approx \pi$) 근처에서 같은 계산을 하면 $\lambda^2 - 1.9625\lambda + 1 = 0$ 이 되고, 판별식 $1.9625^2 - 4 \lt 0$ 이라 두 고윳값은 크기가 정확히 1 인 복소수가 됩니다. 차이가 커지지도 줄지도 않고 빙글빙글 돌기만(진동) 한다는 뜻입니다. 그래서 같은 모델이라도 진자를 세우는 순간을 상상할 때 오차가 가장 빨리 커집니다.
엄밀히 말하면 고윳값과 립시츠 상수 $L$ 은 같은 것이 아닙니다. $L$ 은 “한 스텝에서 최악의 경우 몇 배까지 커질 수 있는가” 이고(보통의 벡터 길이로 재면 위 $A$ 에서 약 $1.48$, 매달린 자세에서도 약 $1.41$), 고윳값은 “여러 스텝을 이어 갈 때 실제로 한 스텝마다 평균 몇 배씩 커지는가” 입니다. 그래서 앞의 상한 $\varepsilon\frac{L^k-1}{L-1}$ 은 넉넉하게 잡은 값이고, 길게 굴릴 때 오차가 실제로 불어나는 속도는 고윳값이 정합니다.
실험으로 확인하기
이제 실제로 잽니다. 검증 에피소드의 아무 시점 300곳에서 출발해, 기록된 행동으로 50 스텝 롤아웃하고 각 스텝 $k$ 에서 각도 오차 $|\hat\theta - \theta|$ 와 각속도 오차를 잽니다. 각도의 차이는 $[-\pi, \pi)$ 로 접어서 잽니다(앞에서 본 이음매 문제).
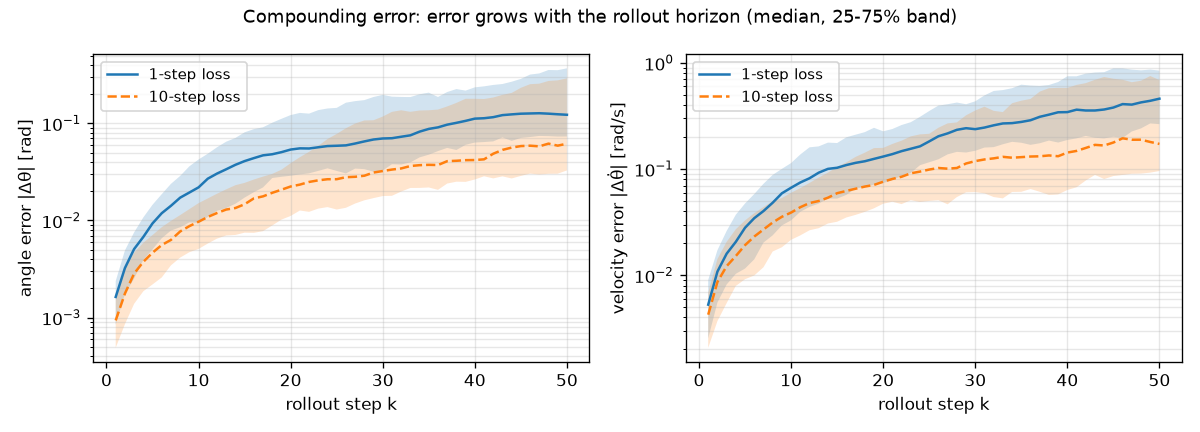
  horizon  1: 1-step model angle err 0.0016 rad, vel err 0.0053 | 10-step model angle 0.0009, vel 0.0043   (median)
  horizon  5: 1-step model angle err 0.0093 rad, vel err 0.0280 | 10-step model angle 0.0047, vel 0.0192   (median)
  horizon 10: 1-step model angle err 0.0219 rad, vel err 0.0667 | 10-step model angle 0.0097, vel 0.0389   (median)
  horizon 20: 1-step model angle err 0.0538 rad, vel err 0.1311 | 10-step model angle 0.0224, vel 0.0760   (median)
  horizon 30: 1-step model angle err 0.0700 rad, vel err 0.2375 | 10-step model angle 0.0323, vel 0.1188   (median)
  horizon 50: 1-step model angle err 0.1228 rad, vel err 0.4600 | 10-step model angle 0.0618, vel 0.1724   (median)
1스텝 손실 모델(각 줄의 앞쪽 숫자)의 각속도 오차 중앙값은 1 스텝에서 $0.0053$ 이지만 50 스텝에서 $0.46$ 으로 약 87배 커졌습니다. 7장에서 계획할 때는 25 스텝 정도를 내다볼 것이므로, 이 정도 오차라면 “대략 맞는 상상” 으로 쓸 만합니다.
오차 누적을 줄이는 방법
다스텝 손실
1스텝 손실로 학습할 때 모델은 늘 진짜 관측을 입력으로 받습니다. 그런데 롤아웃할 때는 자기 예측 을 입력으로 받습니다. 학습 때 본 적 없는, 조금씩 어긋난 입력에서 어떻게 행동해야 하는지 배운 적이 없는 셈입니다. 그래서 학습할 때도 롤아웃을 해 보고, 그 오차를 직접 줄이게 할 수 있습니다.
$$ \mathcal{L}_{k\text{-step}}(\theta) = \frac{1}{k}\sum_{j=1}^{k}\left[\ \big\|\, (\hat o_{t+j} - o_{t+j}) \oslash \sigma_{\Delta o} \big\|^2 + \Big(\frac{\hat r_{t+j-1} - r_{t+j-1}}{\sigma_r}\Big)^2\ \right], \qquad \hat o_{t+j} = f_\theta(\hat o_{t+j-1}, a_{t+j-1}),\ \hat o_t = o_t $$($\oslash$ 는 원소별 나눗셈입니다. 오차를 $\Delta o$ 의 표준편차 단위로 재서 1스텝 손실과 크기를 맞췄고, 코드에서는 여기에 4 로 나눈 평균을 씁니다.) $k = 1$ 이면 1스텝 손실과 같습니다. 핵심은 $\hat o_{t+j}$ 가 모델 자신의 예측이고, 그 예측을 거쳐 기울기도 흐른다 는 점입니다. 그래서 “지금 조금 틀리면 몇 스텝 뒤에 크게 틀린다” 는 정보가 앞 스텝의 가중치 갱신에도 전달됩니다.
같은 데이터 · 같은 크기 · 같은 에폭으로 $k = 10$ 다스텝 손실 모델을 학습하면(위 출력의 뒤쪽 숫자, 그림 6-7 의 주황 점선), 50 스텝 뒤 오차 중앙값이 각도 $0.123 \to 0.062$, 각속도 $0.46 \to 0.17$ 로, 각도는 절반쯤 · 각속도는 3분의 1 남짓으로 줄어듭니다. 1 스텝 오차도 조금 줄었습니다. 대신 학습 한 스텝에 모델을 $k$ 번 통과하므로 학습 시간이 대략 $k$ 배 듭니다.
그 밖의 방법들
- 짧게 상상하고 자주 다시 보기: 길게 상상할수록 틀리므로, 짧은 구간만 상상하고 매 스텝 진짜 관측으로 다시 시작합니다. 7장의 MPC 가 정확히 이 방법입니다.
- 불확실성을 알기: 모델이 “여기는 잘 모르겠다” 를 말할 수 있으면 그런 곳의 상상을 덜 믿을 수 있습니다. 7장 후반의 확률적 앙상블입니다.
- 필요한 곳의 데이터 더 모으기: 모델을 써서 행동하며 데이터를 모으면, 실제로 가게 될 상태(예: 위로 선 자세) 주변의 데이터가 늘어납니다(7장).
- 좋은 잠재 공간에서 예측하기: 관측 대신 압축된 잠재 상태에서 예측하면 예측할 것이 단순해집니다. 8 – 12장의 주제입니다.
이 모델로 무엇을 할 수 있나
우리는 이제 진자의 “머릿속 시뮬레이터” 를 가졌습니다. 이 시뮬레이터는 진짜 환경과 달리
- 한 번에 수백 개의 미래를 동시에(배치로) 상상할 수 있고,
- 실패해도 진자가 부서지지 않으며(실제 로봇이라면 중요합니다),
- 미분할 수 있어서(신경망이므로) 기울기를 이용한 최적화에도 쓸 수 있습니다(12장의 Dreamer).
다음 장에서는 첫 번째 쓰임새를 실제로 해 봅니다. “이 행동열을 하면 어떻게 될까?” 를 수백 개 상상해 보고, 가장 좋은 것을 골라 실행하는 계획 으로 진자를 세웁니다.
--episodes 5로 데이터를 1/10 로 줄이면 1스텝 · 다스텝 오차가 어떻게 바뀌는지 보세요.make_inputs_targets에서 정답을next_obs - obs대신next_obs로 바꾸고,predict에서obs +를 지워 “다음 상태를 통째로 예측” 하게 해 보세요. 1스텝 RMSE 가 어떻게 되나요?set_normalizer에서 표준화를 끄면(평균 0, 표준편차 1 로 고정) 학습 곡선이 어떻게 달라지나요?train_multistep의k를 1, 3, 20 으로 바꿔 그림 6-7 이 어떻게 변하는지 보세요.
- 진자의 운동 방정식 $\ddot\theta = \frac{3g}{2l}\sin\theta + \frac{3}{ml^2}u$ 는 $\tau = I\ddot\theta$, $I = \frac13ml^2$, 중력 토크 $\frac{l}{2}mg\sin\theta$ 에서 나옵니다. 환경은 이것을 반암시적 오일러로 $\Delta t = 0.05$ 씩 계산합니다.
- World Model 학습은 $[o_t, a_t] \mapsto [o_{t+1}, r_t]$ 의 회귀 문제입니다. 각도는 이음매가 없는 $(\cos\theta, \sin\theta)$ 로 다룹니다.
- 표준화(열마다 평균 0 · 표준편차 1)와 변화량 $\Delta o$ 예측이 학습을 쉽게 합니다. 통계는 학습 데이터로만 구합니다.
- MSE 를 최소화하는 것은 분산이 고정된 가우시안 잡음을 가정한 최대우도 학습과 같습니다.
- 매개변수 34,180 개의 MLP 가 1스텝을 $R^2 \approx 0.999$ 로 맞혔지만, 열린 고리 롤아웃에서는 오차가 쌓입니다. 상한은 $e_k \le \varepsilon\frac{L^k - 1}{L - 1}$ 로 $L \gt 1$ 이면 지수적으로 커질 수 있고, 실제로는 불안정한 곳(진자가 서 있는 자세, 고윳값 약 1.21)에서 가장 빨리 커집니다.
- 다스텝 손실로 학습하면 롤아웃 오차를 절반 안팎으로 줄일 수 있습니다. 짧게 상상하고 자주 다시 보는 MPC 는 다음 장에서 다룹니다.
확인 문제
같은 막대(질량 $m$, 길이 $l$)를 끝이 아니라 한가운데 를 축으로 돌리면 관성 모멘트는 얼마일까요? 적분 구간을 바꿔 계산해 보세요.
답 보기
축이 가운데이므로 $r$ 은 $-\frac l2$ 부터 $\frac l2$ 까지입니다. $I = \int_{-l/2}^{l/2} r^2\frac{m}{l}dr = \frac{m}{l}\Big[\frac{r^3}{3}\Big]_{-l/2}^{l/2} = \frac{m}{l}\cdot\frac13\left(\frac{l^3}{8} + \frac{l^3}{8}\right) = \frac{m}{l}\cdot\frac{l^3}{12} = \frac{1}{12}ml^2$. 끝을 축으로 할 때($\frac13 ml^2$)의 $\frac14$ 로, 질량이 축 가까이 모여 있을수록 돌리기 쉽다는 뜻입니다.
토크 한계가 $|u| \le 2$ 일 때, 막대를 가만히 붙잡아 둘 수 있는($\ddot\theta = 0$ 이 가능한) 각도의 범위는? ($\theta$ 는 위에서 잰 각도)
답 보기
$15\sin\theta + 3u = 0$ 에서 $u = -5\sin\theta$ 이고, $|u| \le 2$ 이려면 $|\sin\theta| \le 0.4$ 여야 합니다. $\arcsin 0.4 \approx 0.4115$ rad $\approx 23.6°$ 이므로, 똑바로 선 자세에서 약 $\pm 23.6°$ 이내이거나, 매달린 자세에서 약 $\pm 23.6°$ 이내($|\theta| \ge \pi - 0.4115$)입니다. 그 사이 각도에서는 어떤 토크로도 멈춰 있을 수 없으므로 흔들어서 지나가야 합니다.
어떤 열의 학습 데이터 평균이 $\mu = 2$, 표준편차가 $\sigma = 0.5$ 입니다. 모델이 표준화된 공간에서 $\tilde y = -1.2$ 를 예측했습니다. 원래 단위의 예측은? 또 표준화된 공간의 MSE 가 $0.0004$ 라면, 원래 단위의 RMSE 는 대략 얼마일까요?
답 보기
$y = \tilde y\,\sigma + \mu = -1.2\times0.5 + 2 = 1.4$. 표준화된 오차 $\tilde e$ 와 원래 오차 $e$ 는 $e = \tilde e\,\sigma$ 관계이므로(평균은 서로 빼지면서 사라집니다) RMSE 는 $\sqrt{0.0004}\times0.5 = 0.02\times0.5 = 0.01$ 입니다.
1스텝 오차 상한이 $\varepsilon = 0.005$ 이고 립시츠 상수가 $L = 1.2$ 인 모델로 $e_0 = 0$ 에서 10 스텝 롤아웃하면 오차의 상한은? ($1.2^{10} \approx 6.19$)
답 보기
$e_{10} \le 0.005\times\frac{1.2^{10}-1}{1.2-1} = 0.005\times\frac{5.19}{0.2} = 0.005\times25.95 \approx 0.13$. 1스텝 오차의 약 26배입니다.
1스텝 손실로 학습한 모델이 1스텝 오차는 아주 작은데도 롤아웃에서 오차가 커지는 까닭을 “학습 때의 입력” 과 “사용할 때의 입력” 이라는 말로 설명해 보세요.
답 보기
학습 때 모델의 입력은 언제나 진짜 관측 $o_t$ 입니다. 롤아웃할 때의 입력은 조금씩 틀린 자기 예측 $\hat o_t$ 입니다. 모델은 이런 “살짝 어긋난 입력” 의 분포를 학습 때 보지 못했으므로, 거기서의 예측이 얼마나 정확할지 보장되지 않고, 어긋남이 다음 스텝으로 넘어가며 커집니다(학습 분포와 사용 분포의 차이, distribution shift). 다스텝 손실은 학습 때도 자기 예측을 입력으로 넣어 이 차이를 줄입니다.
다음 장에서는 이 모델을 “머릿속 시험장” 으로 써서, 수백 개의 행동열을 상상으로 시험해 보고 가장 좋은 것을 고르는 계획 으로 진자를 실제로 세워 봅니다.