상상으로 계획하기: MPC 와 CEM
6장에서 만든 World Model 은 “이 행동을 하면 어떻게 될까?” 에 꽤 정확히 답합니다. 이 장에서는 그 능력을 처음으로 행동에 씁니다. 수백 개의 행동열을 모델 속에서 상상으로 시험해 보고, 가장 좋은 것의 첫 행동만 실행한 뒤 다시 계획하는 모델 예측 제어(MPC) 로 진자를 실제로 세웁니다. 정책 신경망 없이, 보상은 알고 있는 식을 그대로 쓰고, 모델과 탐색만으로 말입니다. 후반부에서는 모델이 “모르는 것을 모른다고 말하게” 만드는 확률적 앙상블과 PETS 를 다룹니다.
- 계획(planning)을 “행동열에 대한 최적화 문제” 로 쓰기
- 모델 예측 제어(MPC): 길게 계획하고, 첫 행동만 실행하고, 다시 계획하는 까닭
- 랜덤 슈팅과 교차 엔트로피 방법(CEM). CEM 의 갱신식을 최대우도로 유도하기
- “모으기 → 모델 학습 → 계획하며 모으기” 고리로 진자를 실제로 세우기
- 모델 착취 문제와, 평균 · 분산을 함께 예측하는 확률적 모델의 NLL 손실 유도
- 우연적 · 인식적 불확실성, 부트스트랩 앙상블, PETS 의 궤적 표본 전파(TS∞)
계획이란: 행동열 최적화
지금 관측이 $o_t$ 일 때, 앞으로 $H$ 스텝 동안 할 행동열 $a_{t:t+H-1} = (a_t, a_{t+1}, \dots, a_{t+H-1})$ 을 하나 정했다고 합시다. World Model $f_\theta$ 가 있으면 진짜로 해 보지 않고도 그 결과를 상상할 수 있습니다.
$$ \hat o_t = o_t, \qquad \hat o_{t+k+1} = f_\theta(\hat o_{t+k},\ a_{t+k}) \quad (k = 0, 1, \dots, H-1) $$그리고 상상한 궤적의 보상을 모두 더해 그 행동열의 “점수” 를 매깁니다.
$$ J(a_{t:t+H-1}) = \sum_{k=0}^{H-1} r\big(\hat o_{t+k},\ a_{t+k}\big) $$계획planning 은 이 점수를 가장 크게 만드는 행동열을 찾는 것입니다.
$$ a^*_{t:t+H-1} = \argmax_{a_{t:t+H-1}\ \in\ [-2,\,2]^H}\ J(a_{t:t+H-1}) $$
$[-2, 2]^H$ 는 “각 성분이 $-2$ 와 $2$ 사이인 길이 $H$ 의 벡터 전체” 라는 뜻입니다. 여기서 보상 $r$ 은 6장에서 말한 대로 알고 있는 함수
pendulum_reward 를 씁니다. 모델이 대신하는 것은 “다음 관측이 무엇인가” 뿐입니다.
5장의 강화학습은 상태를 넣으면 행동을 내는 정책 $\pi(a \mid s)$ 를 학습해 두고, 행동할 때는 정책을 한 번 계산합니다. 계획은 정책을 따로 학습하지 않고, 매번 그 자리에서 최적화로 행동을 계산 합니다. 계산은 무겁지만, 보상 함수를 바꾸면(예: “거꾸로 매달려 있어라”) 다시 학습할 필요 없이 바로 새 목표에 맞춰 계획할 수 있다는 장점이 있습니다.
왜 모든 행동열을 다 시험할 수 없나
행동을 $\{-2, -1, 0, 1, 2\}$ 다섯 값으로만 나눠도, $H = 25$ 스텝의 행동열은 $5^{25} = 298{,}023{,}223{,}876{,}953{,}125 \approx 3\times10^{17}$ 개입니다. 1초에 백만 개씩 시험해도 9천 년이 넘게 걸립니다. 그래서 전부 시험하는 대신 똑똑하게 일부만 시험하는 방법이 필요합니다. 이 장에서는 미분을 쓰지 않는 두 가지 표본 기반 방법(랜덤 슈팅, CEM)을 씁니다. 이들은 구현이 간단하고, 수백 개의 후보를 GPU · CPU 에서 한꺼번에 계산하기 좋고, 모델이 매끄럽지 않아도(예: 각속도 잘림) 동작합니다. 모델을 미분해 기울기로 행동을 고치는 방법은 12장의 Dreamer 에서 다룹니다.
후보 행동열에 점수 매기기
두 방법 모두 “후보 행동열 $N$ 개의 점수를 한꺼번에 계산하는” 함수를 씁니다.
obs.expand(N, -1): 지금 관측 하나를 $N$ 번 복사한 것처럼 보이게 합니다(실제 메모리는 복사하지 않습니다). 모든 후보가 같은 출발점에서 상상을 시작합니다.- 반복문은 시간 $k$ 에 대해서만 돕니다. 후보 $N$ 개는 배치 차원으로 한꺼번에 계산되므로, $N = 400$ 이어도 신경망 호출은 $H$ 번입니다.
total += pendulum_reward(o, a)가 $J$ 의 $\sum_k r(\hat o_{t+k}, a_{t+k})$ 이고,o, _ = model.predict(o, a)가 $\hat o_{t+k+1} = f_\theta(\hat o_{t+k}, a_{t+k})$ 입니다.
모델 예측 제어 (MPC)
계획으로 $H$ 스텝짜리 행동열을 얻었다고 그것을 끝까지 실행하지는 않습니다. 6장에서 보았듯 상상은 길어질수록 틀리기 때문입니다. 대신 다음을 매 스텝 되풀이합니다.
- 지금의 진짜 관측 $o_t$ 에서 $H$ 스텝을 계획한다: $a^*_{t:t+H-1}$.
- 그 가운데 첫 행동 $a^*_t$ 하나만 진짜 환경에서 실행한다.
- 새 진짜 관측 $o_{t+1}$ 을 받아 1번으로 돌아가 처음부터 다시 계획한다.
이것이 모델 예측 제어model predictive control, MPC 입니다. 계획하는 창이 시간과 함께 한 칸씩 밀려가므로 후퇴 지평receding horizon 제어라고도 부릅니다. 1970 – 80년대 화학 공정 제어에서 널리 쓰이기 시작해, 지금은 로봇 · 자율주행 제어의 기본 도구입니다.
MPC 가 6장의 오차 누적 문제와 잘 맞는 까닭은 두 가지입니다.
- 상상은 짧게: $H$ 스텝만 상상하므로, 오차가 무한히 쌓이기 전에 끊깁니다.
- 되먹임: 매 스텝 진짜 관측에서 다시 시작하므로(닫힌 고리), 지난 계획의 오차가 다음 계획으로 넘어가지 않습니다. 모델이 조금 틀려도, 실제로 일어난 일을 보고 바로 고칩니다.
대가는 계산량입니다. 행동 하나를 고르기 위해 수만 번 모델을 호출합니다. 진자 정도의 작은 모델은 괜찮지만, 큰 모델에서는 이것이 무거워서 12장의 Dreamer 처럼 계획 대신 정책을 상상 속에서 학습하는 방법이 나옵니다.
planner(obs) 가 매 스텝 새 관측으로 다시 불리는 것이 MPC 의 전부입니다. 계획기는 계획 전체가 아니라 실행할 첫 행동 하나만 돌려줍니다.
랜덤 슈팅
가장 단순한 계획기입니다.
- $[-2, 2]$ 에서 고르게(uniform) 무작위 행동열 $N$ 개를 뽑는다.
- 모델 속에서 각각의 점수 $J$ 를 계산한다.
- 점수가 가장 높은 행동열의 첫 행동을 고른다.
이름은 “과녁을 향해 아무렇게나 많이 쏘고, 가장 가까운 것을 고른다” 는 뜻입니다. 단순하지만 놀랍게 잘 동작해서, 신경망 World Model 과 MPC 를 결합한 초기 연구(Nagabandi 외, 2018)도 랜덤 슈팅을 썼습니다. 하지만 지평이 길어지면 금방 한계에 부딪힙니다.
좋은 후보를 뽑을 확률
무작위 행동열 가운데 “충분히 좋은” 것의 비율이 $p$ 라고 합시다. $N$ 개를 독립적으로 뽑을 때 좋은 것이 하나라도 들어 있을 확률은 얼마일까요?
예: $p = 0.001$, $N = 1000$ 이면 정확한 값 $1 - 0.999^{1000} = 0.6323$, 근사 $1 - e^{-1} = 0.6321$ 로 거의 같습니다. 문제는 $p$ 가 지평 $H$ 에 따라 지수적으로 작아진다는 점입니다. 매 스텝 “괜찮은 행동” 의 비율이 절반이라고만 해도, 25 스텝 모두 괜찮을 비율은 $0.5^{25} \approx 3\times10^{-8}$ 입니다. 무작위로 뽑아서는 이런 바늘을 찾을 수 없습니다. 좋은 후보 근처를 집중적으로 뽑는 방법이 필요합니다.
교차 엔트로피 방법 (CEM)
교차 엔트로피 방법cross-entropy method, CEM 은 랜덤 슈팅을 여러 번 되풀이하되, 매번 앞에서 잘한 후보들 근처 에서 다시 뽑습니다(Rubinstein, 1999). 행동열의 각 성분마다 가우시안을 하나씩 둡니다.
$$ a_{t+k} \sim \Normal(\mu_k,\ \sigma_k^2), \qquad k = 0, 1, \dots, H-1 $$한 번의 반복은 다음과 같습니다.
- 뽑기: 가우시안에서 행동열 $N$ 개를 뽑는다. $a^{(i)}_{t+k} = \mu_k + \sigma_k\,\epsilon^{(i)}_k$, $\epsilon \sim \Normal(0, 1)$, 그리고 $[-2, 2]$ 로 자른다.
- 점수 매기기: 모델 속에서 각 후보의 $J$ 를 계산한다.
- 정예 고르기: 점수 상위 $K$ 개를 정예elite 로 고른다.
- 다시 맞추기: 정예 $K$ 개에 가장 잘 맞는 가우시안으로 $\mu$, $\sigma$ 를 바꾼다.
이것을 몇 번(여기서는 5번) 되풀이하면 가우시안이 점점 좋은 행동열 쪽으로 옮겨 가며 좁아집니다. 마지막 평균 $\mu_0$ 이 실행할 첫 행동입니다.
행동이 두 개($x$, $y$)뿐인 장난감 문제입니다. 배경이 진할수록 점수가 높습니다(오른쪽 위가 가장 높은 봉우리, 왼쪽 아래는 낮은 봉우리). “한 번 반복” 을 누르면 회색 점 60개를 뽑고, 점수 상위 10개(색 점)에 가우시안(타원 = 평균 ± 2σ)을 다시 맞춥니다. 대여섯 번이면 타원이 봉우리 위로 좁아집니다. “처음으로” 를 여러 번 눌러 다시 해 보면 열 번에 한 번쯤은 낮은 봉우리에 갇히기도 합니다. CEM 은 전역 최적을 보장하지 않는 국소 탐색 이라는 뜻입니다.
“정예에 다시 맞추기” 의 정체: 최대우도
4번 단계의 “가장 잘 맞는 가우시안” 은 2장의 최대우도 추정 그대로입니다. 한 성분(시간 $k$ 하나)만 보면, 정예 $K$ 개의 값 $x_1, \dots, x_K$ 에 대해 로그 가능도 $\sum_i \log\Normal(x_i; \mu, \sigma^2)$ 를 가장 크게 하는 $\mu$, $\sigma^2$ 를 찾는 것입니다.
elites.mean(dim=0), elites.std(dim=0, unbiased=False) 가 이 두 식입니다.이름의 “교차 엔트로피” 도 여기서 나옵니다. 정예 $K$ 개를 고르게 가진 분포 $\hat p$ (각 정예에 확률 $\frac1K$)와 우리의 가우시안 $q$ 사이의 교차 엔트로피(3장)는 (여기의 $H(\cdot,\cdot)$ 는 계획 길이가 아니라 3장의 교차 엔트로피입니다) $H(\hat p, q) = -\E_{x\sim\hat p}[\log q(x)] = -\frac1K\sum_{i=1}^K \log q(x_i)$ 이므로, 교차 엔트로피를 최소화하는 것 = 정예의 로그 가능도를 최대화하는 것 입니다. “정예의 분포를 가장 잘 흉내 내는 가우시안을 찾는다” 는 뜻입니다.
평활과 웜 스타트
두 가지 작은 장치를 더합니다. 첫째, 평활(smoothing): 새 값으로 단번에 바꾸지 않고 옛 값을 비율 $\alpha$ 만큼 섞습니다.
$$ \mu \leftarrow \alpha\,\mu_{\text{old}} + (1-\alpha)\,\hat\mu, \qquad \sigma \leftarrow \alpha\,\sigma_{\text{old}} + (1-\alpha)\,\hat\sigma $$$\alpha = 0.1$ 이면 새 값을 90% 믿습니다. 정예가 우연히 한쪽에 몰려 $\sigma$ 가 갑자기 0 에 가까워지는(더 이상 탐색하지 못하는) 일을 막아 줍니다. 예: $\mu_{\text{old}} = 0$, $\hat\mu = 1.5$ 이면 $\mu = 0.1\times0 + 0.9\times1.5 = 1.35$ 입니다. (PETS 의 공개 구현은 표준편차 $\sigma$ 가 아니라 분산 $\sigma^2$ 을 같은 식으로 섞습니다. 여기서는 $\sigma$ 를 섞었고, 하는 일은 같습니다.)
둘째, 웜 스타트(warm start): MPC 는 매 스텝 다시 계획하는데, 바로 전 스텝의 계획 $\mu_{0:H-1}$ 은 이번 스텝에도 여전히 좋은 출발점입니다. 첫 행동은 이미 실행했으므로 한 칸 당겨서 $(\mu_1, \mu_2, \dots, \mu_{H-1}, 0)$ 을 이번 계획의 처음 평균으로 씁니다. 그러면 매번 0 에서 시작할 때보다 적은 반복으로도 좋은 계획에 도달합니다.
코드의 1) – 5) 주석이 위 단계와 하나씩 대응합니다. returns.topk(self.K).indices 가 점수 상위 $K$ 개의 번호이고,
self.mean = torch.cat([mean[1:], ...]) 가 웜 스타트입니다. evaluate 메서드를 따로 둔 것은 후반부의 PETS 가 이 부분만 바꿔 끼우기 위해서입니다.
하이퍼파라미터
| 이름 | 이 장의 값 | 키우면 | 줄이면 |
|---|---|---|---|
| 지평 $H$ | 25 (1.25초) | 더 먼 미래를 고려하지만, 모델 오차가 쌓이고 계산이 늘어남 | 근시안적이 되어 “일단 반대로 흔들기” 같은 행동을 못 찾음 |
| 후보 수 $N$ | 400 | 더 좋은 행동열을 찾을 확률 증가, 계산 증가 | 탐색이 거칠어짐 |
| 정예 수 $K$ | 40 (10%) | 가우시안이 천천히 좁아짐(탐색 많이) | 빨리 좁아짐(잘못된 곳에 갇힐 위험) |
| 반복 수 | 5 | 더 정밀한 최적화, 계산 증가 | 덜 정밀 |
| 평활 $\alpha$ | 0.1 | 변화가 느려짐 | 정예에 바로 맞춤 |
| 초기 $\sigma$ | 1.0 | 처음에 넓게 탐색 | 처음부터 평균 근처만 |
이 설정에서 행동 하나를 고르는 데 모델을 $5\times400\times25 = 50{,}000$ 번(배치로는 125번) 호출하고, 200 스텝 에피소드 하나면 천만 번입니다. 노트북 CPU 4스레드에서 행동 하나에 약 0.09초, 에피소드 하나에 약 18초가 걸렸습니다.
진자를 세우기: 모델 기반 강화학습 고리
이제 모든 조각을 맞춥니다. 처음에는 데이터가 거의 없으므로 다음 고리를 되풀이합니다.
매 반복마다 모델을 처음부터 다시 학습합니다(fit_model 은 데이터 크기와 상관없이 약 3,000 번의 기울기 스텝을 밟도록 에폭 수를 정합니다).
이어서 학습하는 것보다 느리지만, 예전 데이터에 맞춰진 가중치가 새 데이터 학습을 방해하는 일이 없어 단순하고 안정적입니다.
전체 스크립트는 노트북 CPU 4스레드에서 6분(다른 계산과 CPU 를 나눠 쓸 때는 10분)쯤 걸렸습니다. --quick 은 20초 남짓입니다.
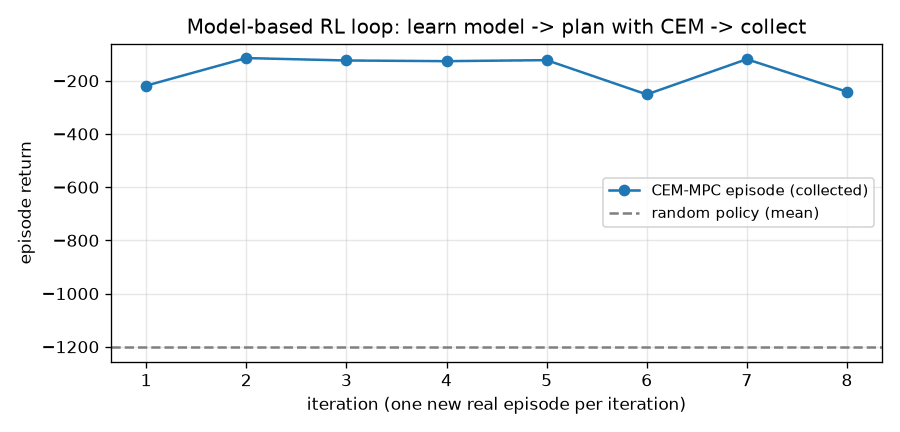
seed data: 1 random episodes, mean return -1071.9
iter  1 | data  2 episodes | model loss 0.00005 | CEM-MPC return   -218.4 |    40s
iter  2 | data  3 episodes | model loss 0.00005 | CEM-MPC return   -114.7 |    70s
iter  3 | data  4 episodes | model loss 0.00007 | CEM-MPC return   -123.9 |   103s
iter  4 | data  5 episodes | model loss 0.00010 | CEM-MPC return   -126.4 |   128s
iter  5 | data  6 episodes | model loss 0.00005 | CEM-MPC return   -122.5 |   164s
iter  6 | data  7 episodes | model loss 0.00014 | CEM-MPC return   -251.5 |   209s
iter  7 | data  8 episodes | model loss 0.00010 | CEM-MPC return   -119.0 |   244s
iter  8 | data  9 episodes | model loss 0.00007 | CEM-MPC return   -241.5 |   291s
무작위 에피소드 단 하나(200 전이)로 학습한 모델로 첫 MPC 에피소드에서 이미 $-218$ 을 얻었습니다. 무작위 행동의 평균 리턴($-1202$)과 비교하면 엄청난 차이입니다. 진자는 상태가 3차원뿐이고 물리가 매끄러워, 200 개의 전이만으로도 “흔들어 올리기” 에 필요한 만큼 정확한 모델이 나온 것입니다. 반복마다 리턴이 $-115$ 와 $-250$ 사이를 오가는 것은 주로 시작 상태 때문입니다. 시작 각도가 바닥에 가까워 한 번에 올리지 못하고 한 번 더 흔들어야 하는 에피소드는 $-250$ 근처, 한 번에 올라가는 에피소드는 $-115$ 근처가 됩니다(아래 그림 7-4 의 평가 궤적에서도 같은 모습을 볼 수 있습니다).
세 방법 비교
마지막 데이터(9 에피소드)로 학습한 모델 하나를 두고, 무작위 정책 · 랜덤 슈팅 MPC($N = 1000$) · CEM MPC 를 같은 10개의 시작 상태 에서 비교했습니다.
random policy       : mean return  -1202.1 ±  183.2  (episodes: -866, -1248, -1183, -1173, -1397, -1307, -1506, -1296, -1068, -975)
random shooting MPC : mean return   -147.1 ±  106.4  (episodes: -1, -119, -125, -120, -243, -123, -366, -248, -126, -1)
CEM MPC             : mean return   -110.4 ±   66.6  (episodes: -0, -119, -126, -119, -124, -116, -249, -123, -128, -0)
| 방법 | 평균 리턴 (10 에피소드) | 표준편차 | 행동 하나당 모델 호출 |
|---|---|---|---|
| 무작위 정책 | $-1202.1$ | $183.2$ | 0 |
| 랜덤 슈팅 MPC ($N=1000$, $H=25$) | $-147.1$ | $106.4$ | 25,000 |
| CEM MPC ($N=400$, $K=40$, 5회, $H=25$) | $-110.4$ | $66.6$ | 50,000 |
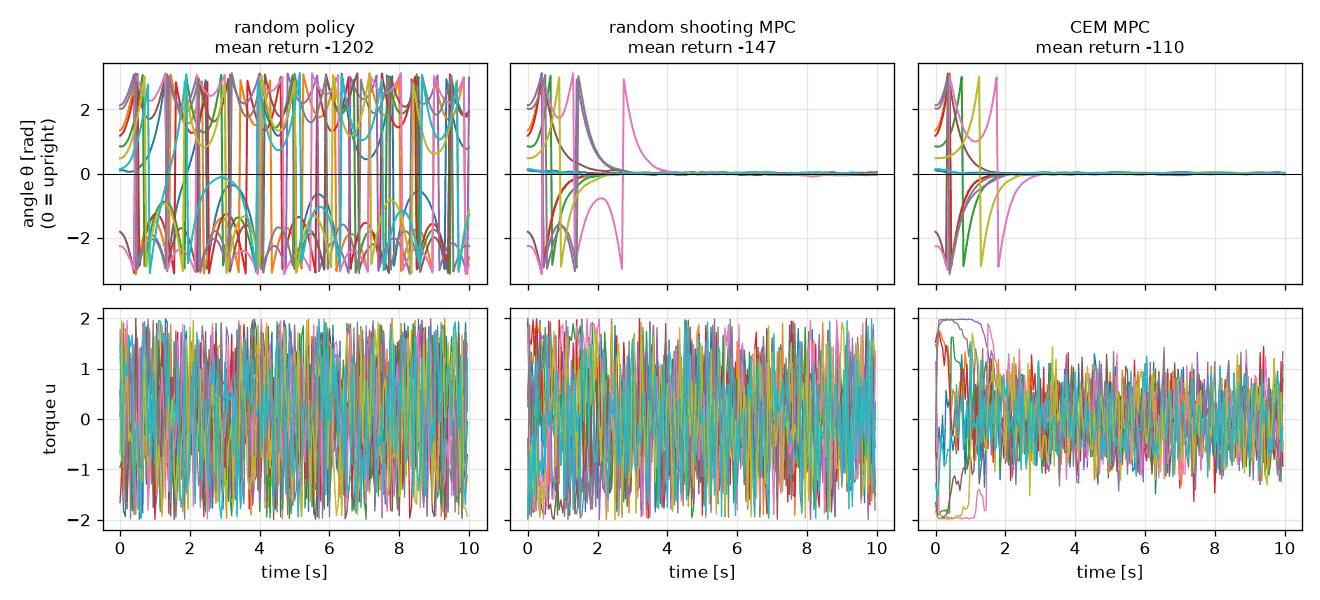
5장에서 구해 둔 기준 점수와 견주어 봅시다. 5장은 시작 상태 100개에서 무작위 정책 약 $-1234$, 물리 법칙(에너지 식)을 알고 손으로 만든 정책 약 $-183$ 이었습니다. CEM MPC 의 $-110$ 은 물리 법칙을 전혀 쓰지 않고도 그 손으로 만든 정책보다 좋은 점수입니다. 다만 여기서는 시작 상태가 10개뿐이고 5장과 시드(시작 상태 · 무작위 행동)가 달라서 엄밀한 비교는 아닙니다. 무작위 정책의 평균이 5장($-1234$)과 여기($-1202$)에서 조금 다른 것도 같은 까닭입니다.
정책 학습 없이, “데이터로 배운 World Model + 그 안에서의 탐색(CEM) + 매 스텝 다시 계획하기(MPC)” 만으로 진자 스윙업을 풀었습니다. 진짜 환경과의 상호작용은 9 에피소드(1,800 스텝)뿐이었습니다. 시행착오를 진짜 세상 대신 머릿속에서 하는 것 — World Model 이 주는 가장 직접적인 이득입니다.
모델 착취 문제
계획기는 모델이 말하는 점수를 무조건 믿고, 그 점수를 가장 크게 만드는 행동열을 열심히 찾습니다. 그런데 모델이 어딘가에서 틀리게 “여기로 가면 보상이 아주 크다” 고 예측한다면, 계획기는 바로 그 틀린 곳을 찾아냅니다. 최적화는 오차를 고르게 겪는 것이 아니라, 자기에게 유리한 쪽으로 틀린 오차 를 골라 이용합니다. 이것을 모델 착취model exploitation 라고 합니다.
특히 위험한 곳은 데이터가 없는 곳 입니다. 모델은 데이터가 있는 곳에서는 진짜를 따라 배우지만, 데이터가 없는 곳의 예측은 아무 제약 없이 멋대로입니다. 계획기가 그곳에서 “우연히 낙관적인” 예측을 찾으면, 진짜로 실행했을 때 기대와 전혀 다른 결과가 나옵니다. 진자에서는 모델이 매끄럽고 데이터가 고르게 퍼져 있어 크게 문제 되지 않았지만, 상태 · 행동이 많은 문제에서는 자주 일어납니다. 대처 방법은 다음과 같습니다.
- 고리를 돌기: 착취한 행동을 진짜로 실행하면 그 결과가 데이터에 들어가 모델이 고쳐집니다. 위의 고리가 저절로 하는 일입니다.
- 지평을 짧게, 자주 다시 계획하기: 틀린 상상이 길게 이어지지 않게 합니다(MPC).
- 모델이 모르는 곳을 알게 하기: 모델이 “여기는 자신 없다” 를 말할 수 있으면, 그런 곳의 낙관적인 예측을 믿지 않을 수 있습니다. 이것이 이 장 후반부의 주제입니다.
확률적 모델: 평균과 분산을 함께 예측하기
6장의 모델은 다음 상태를 숫자 하나로만 예측했습니다. 이제 각 출력에 대해 평균 $\mu_\theta(x)$ 와 분산 $\sigma^2_\theta(x)$ 를 함께 내게 해서, 다음 상태를 하나의 값이 아니라 분포 로 예측합니다.
$$ p_\theta(y \mid x) = \Normal\big(y;\ \mu_\theta(x),\ \sigma_\theta^2(x)\big) $$분산이 입력 $x$ 마다 다를 수 있다는 점이 중요합니다(이분산, heteroscedastic). “이 상태에서는 결과가 늘 거의 같다(분산 작음)” 와 “이 상태에서는 결과가 들쭉날쭉하다(분산 큼)” 를 구별할 수 있습니다.
손실 함수: 분산까지 배우는 가우시안 NLL
6장에서는 분산을 고정해서 NLL 이 MSE 가 되었습니다. 이번에는 분산도 모델이 정하므로 NLL 의 모든 항이 살아 있습니다. 신경망은 분산 대신 로그 분산 $s = \log\sigma^2$ 을 냅니다. $\sigma^2 = e^{s}$ 는 $s$ 가 어떤 실수여도 늘 양수이고, 아주 작은 분산과 아주 큰 분산을 비슷한 크기의 숫자로 다룰 수 있기 때문입니다.
((target - mean) ** 2) * torch.exp(-logvar) + logvar 가 정확히 이 식입니다.두 항이 줄다리기를 합니다. 각 매개변수에 대한 기울기를 구해 보면 그 뜻이 분명해집니다.
숫자로 해 봅시다. 정답 $y = 1.0$, 예측 $\mu = 0.4$, $s = 0$ ($\sigma^2 = 1$) 이면 $\mathcal{L} = 0.36\times1 + 0 = 0.36$, $\frac{\partial\mathcal{L}}{\partial\mu} = -2\times0.6/1 = -1.2$ (그래서 $\mu$ 를 키운다), $\frac{\partial\mathcal{L}}{\partial s} = 1 - 0.36 = 0.64$ (그래서 $s$ 를 줄인다 — 분산 1 은 실제 오차 $0.36$ 에 비해 너무 크다).
어떤 데이터 점에서 $\mu$ 가 정답을 정확히 맞히면 $(y-\mu)^2 = 0$ 이고, 그때 $\mathcal{L} = s$ 는 $s \to -\infty$ (분산 → 0)로 끝없이 작아질 수 있습니다. 반대로 모델이 포기하고 $s$ 를 아주 크게 만들어 오차 항을 없애는 것도 가능합니다. 그래서 로그 분산을 일정 범위 안에 가둡니다.
로그 분산을 부드럽게 가두기: softplus
torch.clamp 로 자르면 범위 밖에서 기울기가 0 이 되어 학습이 멈춥니다. 그래서 PETS 는 softplussoftplus
$\mathrm{softplus}(x) = \log(1 + e^{x})$ 로 부드럽게 가둡니다. softplus 는 늘 0 보다 크고, $x$ 가 크면 $\approx x$, $x$ 가 아주 작으면 $\approx 0$ 인 “부드러운 ReLU” 입니다.
예: $s_{\max} = 0.5$, $s_{\text{raw}} = 3$ 이면 $s' = 0.5 - \log(1 + e^{-2.5}) = 0.5 - 0.0789 = 0.421$ 로 $0.5$ 를 넘지 않습니다. 이어서 $s_{\min} = -10$ 이면 $s = -10 + \log(1+e^{10.421}) \approx 0.421$ 로 거의 그대로입니다. $s_{\max}$, $s_{\min}$ 도 학습되는 매개변수이고, 손실에 $0.01\,(s_{\max} - s_{\min})$ 을 더해 범위가 쓸데없이 넓어지지 않게 합니다.
두 가지 불확실성과 앙상블
모델의 예측이 불확실한 까닭은 두 가지로 나뉩니다.
| 우연적 불확실성 (aleatoric) | 인식적 불확실성 (epistemic) | |
|---|---|---|
| 원인 | 세상 자체가 무작위다 (주사위, 센서 잡음) | 모델이 아직 충분히 보지 못했다 (데이터 부족) |
| 데이터를 더 모으면 | 줄지 않는다 | 줄어든다 |
| 예 | 같은 힘으로 던져도 공이 떨어지는 곳이 조금씩 다름 | 한 번도 가 본 적 없는 상태의 결과 |
| 모델에서 | 각 모델이 내는 분산 $\sigma^2_\theta(x)$ | 여러 모델의 예측이 서로 다른 정도 |
분산을 내는 모델 하나는 우연적 불확실성만 표현합니다. 데이터가 없는 곳에서 모델이 자신 있게 틀리는 것(인식적 불확실성)은 모델 하나로는 알 수 없습니다. 그래서 모델을 여러 개 학습시키는 앙상블ensemble 을 씁니다. 모델들은 데이터가 있는 곳에서는 모두 데이터를 따라 비슷한 답을 내고, 데이터가 없는 곳에서는 저마다의 초기값 · 학습 경로에 따라 제멋대로 다른 답을 냅니다. 서로 의견이 갈리는 정도 가 곧 인식적 불확실성입니다.
앙상블의 전체 분산 = 우연적 + 인식적
멤버 $E$ 개가 각자 $\Normal(\mu_e, \sigma_e^2)$ 를 예측할 때, “멤버 하나를 고르게 골라 그 분포에서 뽑기” 로 만든 전체 분포의 분산을 구해 봅시다.
코드의 장난감 실험(toy_uncertainty_figure)이 이 두 항을 따로 계산합니다: aleatoric = var.mean(0), epistemic = mu.var(0).
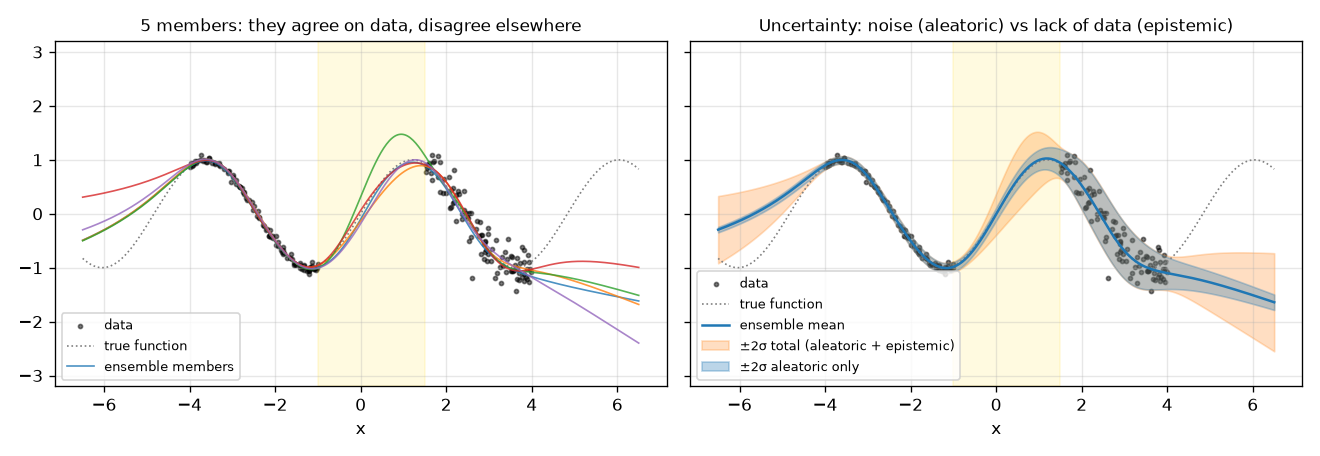
  toy x=-2.50: aleatoric std 0.044, epistemic std 0.024
  toy x= 0.25: aleatoric std 0.071, epistemic std 0.238
  toy x= 2.75: aleatoric std 0.270, epistemic std 0.036
  toy x= 6.00: aleatoric std 0.080, epistemic std 0.389
데이터를 만들 때 쓴 잡음의 표준편차는 왼쪽 $0.04$, 오른쪽 $0.25$ 였습니다. 학습된 우연적 표준편차($0.044$, $0.270$)가 이 값을 잘 찾아냈고, 데이터가 없는 $x = 0.25$, $x = 6$ 에서는 인식적 표준편차($0.238$, $0.389$)가 데이터 위($0.024$, $0.036$)보다 열 배 가까이 큽니다.
부트스트랩: 멤버마다 다른 데이터
멤버들이 서로 다른 의견을 갖게 하려고, 초기값을 다르게 할 뿐 아니라 멤버마다 학습 데이터도 조금씩 다르게 줍니다. $N$ 개의 데이터에서 복원 추출(뽑은 것을 다시 넣고 또 뽑기)로 $N$ 개를 뽑는 부트스트랩bootstrap 입니다. 그러면 어떤 데이터는 두세 번 뽑히고, 어떤 데이터는 한 번도 뽑히지 않습니다. 한 데이터가 한 번도 안 뽑힐 확률은 $\left(1 - \frac1N\right)^N$ 이고, $N$ 이 크면 이것은 $e^{-1} \approx 0.368$ 에 가까워집니다(앞의 랜덤 슈팅 유도에서 $p = \frac1N$ 으로 둔 것과 같은 계산). 그래서 멤버마다 원래 데이터의 약 $63.2\%$ 만 보게 됩니다.
멤버 5개를 따로 만들어 반복문으로 돌리면 느리므로, EnsembleLinear 는 가중치를 (E, in, out) 모양 하나로 두고
torch.baddbmm(배치 행렬곱 + 편향)으로 다섯 멤버를 한 번에 계산합니다. 입력도 (E, B, in) 모양이라 멤버마다 다른 입력을 넣을 수 있습니다.
마지막 층은 출력 차원의 두 배를 내서 앞 절반을 평균, 뒤 절반을 (가두기 전의) 로그 분산으로 씁니다.
boot[e] 가 멤버 $e$ 의 부트스트랩 번호 목록이고, 매 스텝 각 멤버가 자기 목록에서 미니배치를 뽑습니다(torch.gather).
손실은 다섯 멤버의 NLL 평균에 $0.01\sum_d (s_{\max,d} - s_{\min,d})$ (출력 차원마다 하나씩 더함) 을 더한 것입니다.
PETS: 확률적 앙상블로 계획하기
PETS(Probabilistic Ensembles with Trajectory Sampling, Chua 외, NeurIPS 2018)는 지금까지의 조각을 합칩니다. 모델은 확률적 앙상블, 계획기는 CEM, 그리고 그 사이를 잇는 것이 궤적 표본 전파trajectory sampling, TS 입니다.
궤적 표본 전파 (TS∞)
확률적 모델로는 행동열 하나의 결과가 하나로 정해지지 않습니다. 그래서 행동열마다 입자(particle) $P$ 개를 띄워 각각 따로 굴립니다.
- 입자 $p$ 마다 앙상블 멤버 하나 $e(p)$ 를 정해 두고, 상상이 끝날 때까지 바꾸지 않는다(그래서 TS∞).
- 매 스텝 입자 $p$ 는 자기 멤버의 분포에서 다음 상태를 뽑는다: $\hat o^{(p)}_{k+1} = \hat o^{(p)}_k + \mu_{e(p)} + \sigma_{e(p)}\,\epsilon$, $\epsilon \sim \Normal(0, I)$ (표준화를 되돌리는 계산은 생략하고 썼습니다).
- 행동열의 점수는 입자들의 총 보상의 평균이다: $\hat J = \frac1P\sum_{p=1}^P \sum_k r(\hat o^{(p)}_k, a_k)$.
3번은 2장의 몬테카를로 추정입니다. “기대 리턴 $\E[J]$” 를 표본 $P$ 개의 평균으로 어림합니다. 1번이 핵심인데, 입자마다 멤버를 고정하면 각 입자는 “데이터와 맞는 그럴듯한 세상 하나” 에서 끝까지 사는 셈입니다. 멤버들이 갈리는 곳(데이터가 없는 곳)에서는 입자들이 서로 다른 세상으로 흩어집니다. PETS 의 점수는 입자들의 단순 평균일 뿐 “불확실하면 감점” 같은 항이 따로 있지는 않습니다. 그래도 두 가지 까닭으로 모델 착취가 줄어듭니다. 첫째, 멤버 하나만 우연히 낙관적으로 틀린 곳은 나머지 멤버의 입자와 평균 나면서 점수가 깎입니다. 둘째, 우리 보상처럼 목표에서 멀어질수록 제곱으로 벌점을 주는 경우에는 흩어짐 자체가 평균 보상을 낮춥니다 ($\E[-\theta^2] = -\E[\theta]^2 - \Var[\theta]$ 이므로 입자들의 분산만큼 손해입니다). 그래서 CEM 은 모델들이 의견을 모으는(데이터가 있는) 쪽 의 행동열을 고르기 쉬워집니다.
sample_next 는 재매개변수화(8장에서 자세히 다룹니다) 형태 $\mu + \sigma\odot\epsilon$ 으로 표본을 뽑습니다. 입력 모양이 (E, B, 3) 이라
첫 번째 차원이 곧 “어느 멤버가 굴리는가” 를 정합니다.
배치를 (E, N·m, 3) 모양으로 짜는 것이 요령입니다. 후보 $N$ 개마다 멤버 하나가 입자 $m = P/E$ 개를 맡으므로, 후보 하나에는 멤버마다 $m$ 개, 모두 $P$ 개의 입자가 붙습니다.
repeat_interleave(m, dim=0) 는 후보 $n$ 의 행동을 행 $n m, \dots, nm + m - 1$ 에 복사하고, 마지막에 view(E, N, m) 으로 같은 모양으로 되돌려 후보별 평균을 냅니다.
이 장의 설정($N = 200$, $P = 10$, $E = 5$, $m = 2$)이면 한 스텝에 $5\times400 = 2{,}000$ 행을 계산합니다.
PETSPlanner 는 CEM 을 그대로 물려받고 evaluate 만 바꿔 끼웁니다.
데이터가 없는 곳을 상상하면 입자가 흩어진다
TS∞ 의 입자가 정말로 “모르는 곳” 을 드러내는지 확인해 봅니다. 두 앙상블을 학습합니다. 하나는 늘 매달린 자세 근처에서 시작하는 에피소드 20개로만 (무작위 행동으로는 위쪽 절반에 한 번도 가지 못해서, 이 데이터에서 $\cos\theta$ 의 최댓값은 $-0.33$ 입니다), 다른 하나는 시작 자세가 고른 에피소드 20개로 학습합니다. 그리고 둘 다 거의 선 자세($\theta = 0.4$)에서 같은 무작위 행동열로 입자 50개를 굴립니다.
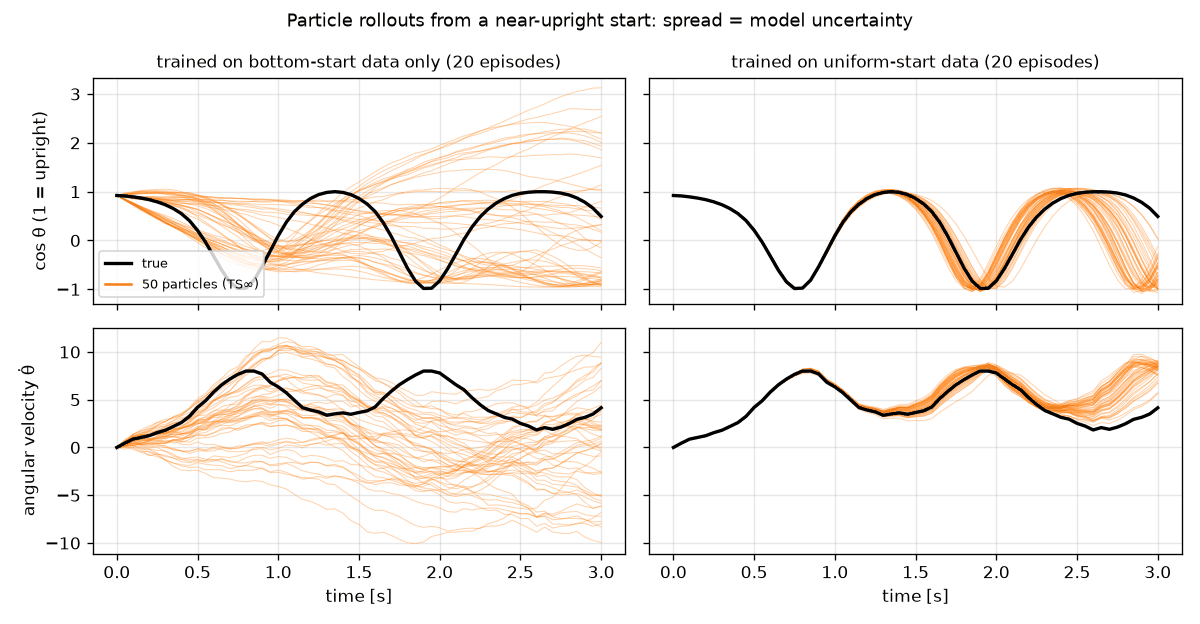
  bottom-start data only  : particle std of θ̇ at step 10/30/60 = 1.958 / 3.792 / 5.273
  uniform-start data      : particle std of θ̇ at step 10/30/60 = 0.037 / 0.455 / 0.753
PETS 로 진자 세우기
iter  1 | data  2 episodes | NLL  -8.821 | PETS return   -221.8 |   127s
iter  2 | data  3 episodes | NLL  -9.090 | PETS return   -115.1 |   261s
iter  3 | data  4 episodes | NLL  -7.906 | PETS return   -123.9 |   418s
iter  4 | data  5 episodes | NLL  -9.217 | PETS return   -127.0 |   532s
iter  5 | data  6 episodes | NLL  -8.947 | PETS return   -124.1 |   629s
iter  6 | data  7 episodes | NLL  -9.025 | PETS return   -253.8 |   682s
iter  7 | data  8 episodes | NLL  -9.100 | PETS return   -119.6 |   751s
iter  8 | data  9 episodes | NLL  -8.872 | PETS return   -243.3 |   796s
PETS (eval)         : mean return   -110.5 ±   66.4  (episodes: -1, -119, -123, -120, -125, -118, -248, -124, -128, -1)
평가 10 에피소드의 평균 리턴은 $-110.5 \pm 66.4$ 로, 결정적 모델 + CEM($-110.4 \pm 66.6$)과 사실상 같습니다.
에피소드별로 보아도 같은 시작 상태에서 거의 같은 점수(예: $-119$ 대 $-119$, $-248$ 대 $-249$)이고, 고리를 도는 동안의 리턴도 앞의 결정적 고리와 거의 같습니다.
반면 계산은 훨씬 무겁습니다. 같은 CPU 에서 행동 하나에 약 0.23초(후보 200 × 입자 10, 정예 30)로 결정적 CEM(약 0.09초, 후보 400)의 2.5배였고,
전체 스크립트(python ch07_pets.py)는 다른 계산과 CPU 를 나눠 쓰는 상태에서 약 19분 걸렸습니다. GPU 에서는 행동 하나에 약 0.09초로 2.6배 빨랐습니다.
출력의 NLL 열은 학습 마지막 미니배치의 손실(앞에서 본 $(y-\mu)^2e^{-s} + s$ 의 평균에 범위 벌점 $0.01\sum_d (s_{\max,d} - s_{\min,d})$ (출력 차원마다 하나씩 더함) 을 더한 값)입니다.
값이 $-9$ 근처인 것은 로그 분산 $s$ 가 아래 한계(처음 값 $-10$. 한계도 학습되어 조금 움직입니다) 근처까지 내려갔다는 뜻입니다. 진자에는 잡음이 없어서 모델이 분산을 줄일 수 있는 데까지 줄인 것입니다.
우리 진자는 잡음이 전혀 없고(우연적 불확실성 0), 상태가 3차원뿐이라 데이터 몇 에피소드면 거의 모든 곳을 덮습니다. 그래서 결정적 모델로도 충분했고, 확률적 앙상블의 장점이 드러날 자리가 거의 없습니다. PETS 논문에서 확률적 앙상블이 결정적 모델보다 뚜렷이 나았던 것은 상태가 스무 차원 안팎인 로봇 팔 · HalfCheetah 같은 과제였습니다. 불확실성을 다루는 기술은 “문제가 어렵고 데이터가 부족할 때” 빛납니다. 대신 계산은 입자 수 $P$ 배만큼 늘어납니다.
정리: 계획하는 World Model 의 장단점
| 장점 | 단점 |
|---|---|
| 정책을 학습하지 않아도 바로 행동할 수 있다 | 행동 하나마다 무거운 최적화(수만 번의 모델 호출) |
| 보상 함수를 바꾸면 다시 학습 없이 새 목표에 맞춰 계획 | 계획 길이(지평) $H$ 밖의 일은 고려하지 못한다(가치 함수가 없으므로) |
| 진짜 환경과의 상호작용이 아주 적다(데이터 효율) | 행동 차원 · 지평이 커지면 표본 기반 탐색이 어려워진다 |
| 매 스텝 다시 계획해 모델 오차를 되먹임으로 바로잡는다 | 모델 착취: 최적화가 모델의 허점을 찾아낸다 |
두 번째 단점(지평 밖을 못 본다)은 지평 끝에 “거기서부터 앞으로 얻을 보상의 추정” 인 가치 함수를 더해 해결할 수 있고(13장의 TD-MPC), 첫 번째 단점(무거운 계산)은 상상 속에서 정책을 학습해 두는 방법으로 해결합니다(12장의 Dreamer). 그 전에, 관측이 숫자 3개가 아니라 그림 일 때 World Model 을 어떻게 만드는지부터 봐야 합니다.
python ch07_mpc.py --horizon 8처럼 지평을 줄이면 진자를 세울 수 있나요? 몇부터 실패하나요? (힌트: 흔들어 올리려면 “잠시 반대로” 가야 합니다.)CEMPlanner의n_iters를 1 로 하면 랜덤 슈팅과 무엇이 같고 무엇이 다른가요?run_episode에서 계획한 행동열 전체를 다시 계획하지 않고 끝까지 실행하도록(열린 고리) 바꾸면 어떻게 되나요?pendulum_reward대신 “매달린 자세에서 가만히 있기” 보상을 직접 만들어 계획해 보세요. 모델은 다시 학습할 필요가 없습니다.
- 계획 = 모델 속에서 상상한 총 보상 $J(a_{t:t+H-1}) = \sum_k r(\hat o_{t+k}, a_{t+k})$ 를 최대화하는 행동열 찾기.
- MPC 는 매 스텝 $H$ 스텝을 계획하고 첫 행동만 실행한 뒤 다시 계획합니다. 짧은 상상 + 되먹임으로 모델 오차를 견딥니다.
- 랜덤 슈팅은 좋은 후보의 비율 $p$ 가 지평에 따라 지수적으로 줄어 한계가 있습니다($1 - e^{-pN}$).
- CEM 은 정예에 가우시안을 최대우도로 다시 맞추기(평균 = 표본 평균, 분산 = 표본 분산)를 되풀이하고, 평활 · 웜 스타트를 씁니다.
- “모으기 → 학습 → 계획하며 모으기” 고리로, 진짜 경험 9 에피소드 만에 진자를 세웠습니다(무작위 $-1202$ → CEM $-110$).
- 확률적 모델은 NLL $(y-\mu)^2e^{-s} + s$ 로 평균과 로그 분산을 함께 배우고, 학습된 분산은 제곱 오차에 맞춰집니다.
- 앙상블의 전체 분산 = 분산의 평균(우연적) + 평균의 분산(인식적). PETS 는 TS∞ 입자로 이 불확실성을 계획에 반영합니다.
확인 문제
좋은 행동열의 비율이 $p = 10^{-4}$ 일 때, 좋은 후보를 적어도 하나 얻을 확률을 95% 로 하려면 후보가 대략 몇 개 필요할까요? ($\log 20 \approx 3.0$)
답 보기
$1 - e^{-pN} = 0.95$ 에서 $e^{-pN} = 0.05$, $pN = -\log 0.05 = \log 20 \approx 3.0$, 그래서 $N \approx 3.0/10^{-4} = 30{,}000$ 개입니다.
한 시각의 행동에 대해 정예 $K = 4$ 개의 값이 $1.0,\ 1.4,\ 1.8,\ 1.8$ 입니다. 옛 평균 · 표준편차가 $\mu_{\text{old}} = 0$, $\sigma_{\text{old}} = 1$, 평활 $\alpha = 0.1$ 일 때 새 $\mu$, $\sigma$ 는?
답 보기
$\hat\mu = (1.0+1.4+1.8+1.8)/4 = 1.5$. $\hat\sigma^2 = [(−0.5)^2 + (−0.1)^2 + 0.3^2 + 0.3^2]/4 = (0.25 + 0.01 + 0.09 + 0.09)/4 = 0.11$, $\hat\sigma = 0.3317$. $\mu = 0.1\times0 + 0.9\times1.5 = 1.35$, $\sigma = 0.1\times1 + 0.9\times0.3317 = 0.3985$.
어떤 입력 근처의 데이터 세 개에서 모델의 평균 예측 오차가 $y - \mu = 0.1,\ -0.3,\ 0.2$ 이고, 이 근처에서 모델이 하나의 로그 분산 $s$ 를 낸다면, NLL 의 합 $\sum_i[(y_i-\mu_i)^2e^{-s} + s]$ 을 최소로 하는 $\sigma^2 = e^s$ 는?
답 보기
$s$ 로 미분하면 $\sum_i[-(y_i-\mu_i)^2e^{-s} + 1] = -e^{-s}\sum_i(y_i-\mu_i)^2 + 3 = 0$, 그래서 $\sigma^2 = e^s = \frac13\sum_i (y_i-\mu_i)^2 = \frac{0.01+0.09+0.04}{3} = 0.0467$. 평균 제곱 오차와 같습니다.
멤버 세 개가 어떤 입력에서 $(\mu_e, \sigma_e^2) = (1.0, 0.04),\ (1.2, 0.04),\ (1.4, 0.07)$ 을 예측했습니다. 우연적 · 인식적 · 전체 분산은?
답 보기
우연적 = $(0.04 + 0.04 + 0.07)/3 = 0.05$. $\bar\mu = 1.2$, 인식적 = $[(−0.2)^2 + 0^2 + 0.2^2]/3 = 0.08/3 \approx 0.0267$. 전체 = $0.05 + 0.0267 = 0.0767$.
입자마다 멤버를 끝까지 고정하는 대신, 매 스텝 멤버를 무작위로 다시 고르면(PETS 논문의 TS1) 무엇이 달라질까요?
답 보기
매 스텝 멤버를 바꾸면 한 입자가 여러 “세상” 을 섞어 사는 셈이라, 멤버 사이의 체계적인 차이(인식적 불확실성)가 스텝마다 평균 나며 일부 상쇄됩니다. TS∞ 는 한 입자가 한 세상에 끝까지 머물러 멤버 사이의 차이가 궤적 끝까지 그대로 벌어지므로 인식적 불확실성이 더 분명하게 드러납니다. (PETS 논문은 두 방식을 모두 실험했고, 과제에 따라 성능 차이는 크지 않았습니다.)
다음 장부터는 관측이 64×64 그림으로 바뀝니다. 그림 4,096 픽셀을 그대로 예측하는 대신, 먼저 그림을 작은 잠재 벡터로 압축하는 “눈” 인 VAE 를 만듭니다.