눈 만들기: VAE
6 · 7장의 World Model 은 진자의 상태를 숫자 3개 $[\cos\theta, \sin\theta, \dot\theta]$ 로 받았습니다. 하지만 진짜 세상은 숫자를 건네주지 않습니다. 로봇은 카메라 그림을 보고, 게임 에이전트는 화면을 봅니다. 이 장부터 에이전트는 64×64 흑백 그림 만 봅니다. 그림을 그대로 예측하는 대신, 먼저 그림을 작은 숫자 벡터로 압축하는 눈 을 만듭니다. 그 눈이 변분 오토인코더(VAE) 입니다.
- 왜 그림을 압축해야 하는지, 오토인코더가 무엇이고 어디서 막히는지
- 잠재 변수 모델 $p_\theta(x) = \int p_\theta(x \mid z)\,p(z)\,dz$ 와, 그 사후 분포가 왜 계산되지 않는지
- ELBO 를 두 가지 방법(젠센 부등식, KL 분해)으로 한 줄씩 유도하기
- 재매개변수화 트릭으로 “무작위로 뽑는 과정” 을 미분하는 법
- KL 항의 닫힌 꼴, 디코더 가능도(BCE · MSE)의 선택, β-VAE 와 사후 붕괴
- 합성곱 VAE 를 PyTorch 로 구현하고, 진자 그림에서 무엇을 배웠는지 읽어 내기
왜 그림을 압축해야 하나
PixelPendulum 환경의 관측 $o_t$ 는 64×64 = 4096개 의 픽셀이고, 픽셀마다 0 – 255 의 밝기를 가집니다.
World Model 이 할 일은 “지금 그림과 행동을 보고 다음 그림을 예측하기” 입니다. 4096개의 숫자를 통째로 예측하는 것은 어렵고 낭비가 큽니다.
- 대부분의 픽셀은 늘 0(검정)입니다. 막대가 차지하는 픽셀은 수백 개 남짓입니다.
- 그림이 달라지는 방식은 사실 하나뿐입니다. 진자 그림은 각도 $\theta$ 하나만 정해지면 완전히 정해집니다. 4096차원 공간 안에서 진자 그림들은 각도를 따라 한 바퀴 도는 가느다란 고리 위에만 놓여 있습니다.
- 가능한 그림의 수와 실제로 나오는 그림의 수가 비교도 안 됩니다. 256단계 픽셀 4096개로 만들 수 있는 그림은 $256^{4096}$ 가지이지만, 진자 그림은 그중 한 줄짜리 고리입니다.
이렇게 고차원 데이터가 실제로는 훨씬 낮은 차원의 “면” 이나 “선” 위에 놓여 있다는 생각을 다양체 가설manifold hypothesis 이라고 부릅니다. 그렇다면 그림을 그 선 위의 좌표 로 바꾸어 예측은 좌표에서 하고, 필요할 때만 좌표를 그림으로 되돌리면 됩니다. 이것이 Ha & Schmidhuber(2018) 의 World Models 가 택한 전략이고(10장), 이 장에서 만드는 VAE 는 그 구조의 V(Vision, 눈) 에 해당합니다.
오토인코더와 그 한계
오토인코더: 스스로를 맞히는 신경망
가장 단순한 압축기는 오토인코더autoencoder, AE 입니다. 두 신경망을 이어 붙입니다.
- 인코더 $f_\phi$: 그림 $x$ 를 받아 작은 벡터 $z = f_\phi(x)$ 를 냅니다.
- 디코더 $g_\theta$: $z$ 를 받아 그림 $\hat{x} = g_\theta(z)$ 를 냅니다.
그리고 “출력이 입력과 같아지도록” 학습합니다. 정답이 입력 자신이므로 사람이 정답을 달아 줄 필요가 없습니다(자기 지도 학습). 가운데 $z$ 가 입력보다 훨씬 작으므로, 네트워크는 그림을 되살리는 데 꼭 필요한 정보만 $z$ 에 담는 법을 배워야 합니다.
$$ \min_{\phi,\theta}\; \frac{1}{N}\sum_{n=1}^{N} \text{재구성 오차}\big(x^{(n)},\; g_\theta(f_\phi(x^{(n)}))\big) $$재구성 오차로는 픽셀별 제곱 오차(MSE)나 이진 교차 엔트로피(BCE)를 씁니다. 둘 중 무엇을 쓰는지는 뒤에서 “확률 모델” 의 관점으로 다시 정합니다.
오토인코더로는 부족한 두 가지
오토인코더도 재구성은 아주 잘 합니다(뒤의 그림 8-5). 문제는 잠재 공간 $z$ 의 모양 입니다. 이 장의 코드는 비교를 위해 VAE 와 똑같은 구조의 오토인코더도 함께 학습합니다. 그 결과에서 두 가지 문제가 드러납니다.
- 잠재 벡터가 어디에 있는지 모릅니다. 오토인코더는 $z$ 가 어떤 범위에 있어야 하는지 아무 제약을 받지 않습니다. 실제로 학습된 오토인코더의 $z$ 는 성분 하나의 크기가 최대 36, 주성분 축으로 재면 ±60 안팎까지 퍼져 있었습니다(그림 8-7 오른쪽). “아무 $z$ 나 하나 뽑아 그림을 만들어 보자” 고 해도, 어디서 뽑아야 할지 알 수 없습니다.
- 잠재 공간이 듬성듬성합니다. 디코더는 학습 데이터가 실제로 떨어진 점들에서만 훈련됩니다. 그 점들 사이나 바깥의 $z$ 를 넣으면 디코더는 한 번도 본 적 없는 입력을 받으므로 엉뚱한 그림을 냅니다(그림 8-9 의 AE 줄).
World Model 에게 이 두 문제는 치명적입니다. 9장의 M 모델은 잠재 공간에서 다음 $z$ 를 뽑아 미래를 상상합니다. 뽑은 $z$ 가 디코더가 모르는 곳에 떨어지면 상상은 곧바로 엉망이 됩니다. 우리에게 필요한 것은 “$z$ 가 어떤 분포를 따르는지 알고, 그 분포에서 뽑은 어떤 $z$ 도 그럴듯한 그림이 되는” 잠재 공간입니다. 이것을 확률 모델 로 정면에서 풀어낸 것이 VAE 입니다.
잠재 변수 모델: 그림이 만들어지는 이야기
생성 이야기
VAE 는 먼저 “그림이 어떻게 만들어지는지” 에 대한 이야기(생성 과정)를 가정합니다.
- 먼저 잠재 벡터 $z$ 를 표준 정규 분포에서 뽑는다: $z \sim p(z) = \Normal(0, I)$. ($I$ 는 단위 행렬. 32개 성분이 서로 독립이고 각각 평균 0, 분산 1)
- 그다음 $z$ 를 디코더에 넣어 그림의 분포를 정하고, 거기서 그림을 뽑는다: $x \sim p_\theta(x \mid z)$.
$z$ 는 데이터에 직접 보이지 않는 변수라서 잠재 변수latent variable 라고 부릅니다. 이 이야기를 믿으면, 그림 $x$ 하나가 나올 확률은 “모든 가능한 $z$ 에 대해, 그 $z$ 가 뽑힐 확률 × 그 $z$ 에서 $x$ 가 나올 확률” 을 모두 더한 것입니다.
학습 목표는 2장의 최대우도 입니다. 가진 그림들 $x^{(1)}, \dots, x^{(N)}$ 이 나올 확률이 가장 크도록 $\theta$ 를 고릅니다.
$$ \theta^\ast = \argmax_\theta \sum_{n=1}^{N} \log p_\theta\big(x^{(n)}\big) $$왜 그대로는 계산할 수 없나
문제는 $\int p_\theta(x \mid z)\,p(z)\,dz$ 입니다. $z$ 가 32차원이므로 이것은 32겹 적분입니다. 각 축을 고작 10칸씩만 나눠도 $10^{32}$ 개의 칸에서 디코더를 돌려야 합니다.
“그렇다면 $z$ 를 사전 분포 $p(z)$ 에서 몇 개 뽑아 평균을 내면 되지 않을까?” (2장의 몬테카를로 추정) 라고 생각할 수 있습니다.
$$ p_\theta(x) = \E_{z \sim p(z)}\big[p_\theta(x \mid z)\big] \approx \frac{1}{S}\sum_{s=1}^{S} p_\theta\big(x \mid z^{(s)}\big),\qquad z^{(s)} \sim p(z) $$식은 맞지만 실제로는 쓸모가 없습니다. 특정한 진자 그림 $x$ (예: 막대가 오른쪽 45°) 를 만들어 내는 $z$ 는 잠재 공간의 아주 작은 구역뿐입니다. 아무렇게나 뽑은 $z$ 는 거의 모두 다른 각도의 그림을 만들므로 $p_\theta(x \mid z^{(s)})$ 는 사실상 0 이고, 그 구역에 우연히 떨어지는 드문 표본 하나가 평균을 좌우합니다. 추정값이 표본마다 크게 흔들려(분산이 커서) 학습 신호로 쓸 수 없습니다.
사후 분포도 같은 벽에 막힌다
“$x$ 를 만든 $z$ 가 어디쯤 있을까?” 를 알면 그 근처에서만 뽑으면 됩니다. 그 답이 사후 분포posterior $p_\theta(z \mid x)$ 이고, 베이즈 정리(2장)로 쓸 수 있습니다.
$$ p_\theta(z \mid x) = \frac{p_\theta(x \mid z)\, p(z)}{p_\theta(x)} = \frac{p_\theta(x \mid z)\, p(z)}{\int p_\theta(x \mid z')\, p(z')\, dz'} $$분자는 디코더를 한 번 돌리면 계산됩니다. 그런데 분모가 바로 방금 계산할 수 없다던 그 적분 입니다. 결국 우리는 $p_\theta(x)$ 도, $p_\theta(z \mid x)$ 도 계산할 수 없습니다. 이런 상황을 “사후 분포가 다루기 어렵다intractable” 라고 말합니다.
변분 추론: 사후 분포를 추측하는 신경망
계산할 수 없는 $p_\theta(z \mid x)$ 대신, 다루기 쉬운 분포 $q_\phi(z \mid x)$ 로 근사 하자는 것이 변분 추론variational inference 의 아이디어입니다. VAE 는 이 $q_\phi$ 를 신경망(인코더)으로 만듭니다.
$$ q_\phi(z \mid x) = \Normal\!\big(z;\ \mu_\phi(x),\ \diag(\sigma^2_\phi(x))\big) $$- 인코더는 그림 $x$ 를 받아 32개의 평균 $\mu_\phi(x)$ 와 32개의 분산 $\sigma^2_\phi(x)$ 를 냅니다. “이 그림을 만든 $z$ 는 대략 $\mu$ 근처, 오차 $\sigma$ 정도” 라는 추측입니다.
- $\diag(\cdot)$ 은 대각 공분산, 즉 32개 성분이 서로 독립인 가우시안이라는 뜻입니다. 단순하지만 계산이 쉽습니다.
- 실제로는 $\sigma^2$ 대신 $\log \sigma^2$ 을 출력합니다. 신경망의 출력은 음수도 될 수 있는데 분산은 양수여야 하므로, 로그 분산을 내고 $\sigma = \exp(\tfrac{1}{2}\log\sigma^2)$ 로 바꾸면 늘 양수가 됩니다. 또 $\sigma$ 가 0.001 이든 100 이든 $\log\sigma$ 로는 −6.9 와 4.6(로그 분산으로는 그 두 배인 −13.8 과 9.2)이라 숫자 범위도 얌전합니다.
그림마다 따로 최적화 문제를 푸는 대신 신경망 하나가 모든 그림의 $q$ 를 한 번에 내놓으므로 이를 분할 상환 추론amortized inference 이라고도 합니다. 이제 남은 질문은 “무엇을 최대화하면 $q_\phi$ 가 좋은 추측이 되고, 동시에 $p_\theta(x)$ 도 커지는가?” 입니다. 그 답이 ELBO 입니다.
ELBO 유도 ① 젠센 부등식으로
3장에서 배운 젠센 부등식 을 다시 떠올립니다. 로그처럼 위로 볼록한(오목한) 함수는 “평균의 로그 ≥ 로그의 평균” 을 만족합니다.
$$ \log \E[Y] \;\ge\; \E[\log Y] $$숫자로 확인해 봅니다. $Y$ 가 반반의 확률로 1 또는 4 라면 $\log \E[Y] = \log 2.5 \approx 0.916$, $\E[\log Y] = \tfrac{1}{2}(\log 1 + \log 4) \approx 0.693$ 이므로 정말 앞쪽이 큽니다. 이 부등식 하나로 계산할 수 없는 $\log p_\theta(x)$ 의 아래 경계 를 만듭니다.
오른쪽의 두 항은 모두 계산할 수 있습니다. 첫 항은 $q_\phi$ 에서 $z$ 를 뽑아 디코더에 넣으면 되고, 둘째 항은 두 가우시안 사이의 KL 이라 공식으로 바로 나옵니다(뒤에서 유도). 계산할 수 없는 $\log p_\theta(x)$ 대신 계산할 수 있는 아래 경계를 최대화 하는 것, 이것이 VAE 학습입니다.
ELBO 유도 ② 차이가 정확히 무엇인가
젠센 부등식은 “ELBO 가 $\log p_\theta(x)$ 보다 작다” 는 것만 알려 줍니다. 얼마나 작은지도 정확히 알 수 있습니다. 이번에는 부등식 없이 등식만으로 유도합니다. 출발점은 “근사 $q_\phi(z \mid x)$ 와 진짜 사후 분포 $p_\theta(z \mid x)$ 가 얼마나 다른가” 입니다.
이 등식에서 VAE 학습의 뜻이 모두 나옵니다.
- KL ≥ 0 이므로 ELBO ≤ log p(x). 유도 ①의 부등식과 같은 결론이고, 등호는 $q_\phi(z \mid x) = p_\theta(z \mid x)$ 일 때만 성립합니다.
- 인코더 $\phi$ 에 대해 ELBO 를 올리면 간격이 줄어듭니다. 왼쪽 $\log p_\theta(x)$ 는 $\phi$ 와 상관없는 고정된 값이므로, $\phi$ 를 바꿔 ELBO 가 커졌다면 그만큼 KL 이 줄었다는 뜻입니다. 즉 인코더는 진짜 사후 분포를 점점 더 잘 흉내 냅니다.
- 디코더 $\theta$ 에 대해 ELBO 를 올리면 대체로 $\log p_\theta(x)$ 가 올라갑니다. 아래 경계를 밀어 올리면 그 위의 값도 따라 올라가기 때문입니다.
VAE 는 하나의 목표, ELBO 를 인코더 $\phi$ 와 디코더 $\theta$ 에 대해 동시에 최대화합니다. 그러면 인코더는 “좋은 추측꾼” 이 되고 디코더는 “좋은 생성기” 가 됩니다. 손실 함수로는 부호를 바꾼 −ELBO 를 최소화합니다.
ELBO 의 두 항: 재구성과 KL
$$ \text{ELBO} = \underbrace{\E_{q_\phi(z \mid x)}\big[\log p_\theta(x \mid z)\big]}_{\text{(1) 재구성 항}} \;-\; \underbrace{\KL\big(q_\phi(z \mid x)\,\|\,p(z)\big)}_{\text{(2) KL 항 (정규화)}} $$- 재구성 항: 인코더가 추측한 $z$ 를 뽑아 디코더에 넣었을 때, 원래 그림 $x$ 가 나올 로그 확률. 클수록 좋습니다. 오토인코더의 “재구성 오차를 줄여라” 와 같은 역할입니다.
- KL 항: 그림마다의 추측 $q_\phi(z \mid x)$ 가 사전 분포 $\Normal(0, I)$ 에서 너무 멀어지지 않도록 붙잡는 줄. 작을수록 좋습니다.
KL 항이 오토인코더의 두 문제를 어떻게 푸는지 보겠습니다.
- 어디서 뽑을지 알게 됩니다. 모든 그림의 $q_\phi(z \mid x)$ 가 원점 근처, 크기 1 정도에 모이도록 끌려가므로 “전체 $z$ 는 대략 $\Normal(0, I)$ 를 따른다” 고 기대할 수 있습니다. 그래서 새 그림을 만들고 싶으면 $\Normal(0, I)$ 에서 $z$ 를 뽑으면 됩니다.
- 잠재 공간이 촘촘해집니다. 인코더가 점이 아니라 폭 $\sigma$ 를 가진 구름 을 내고, 학습 때는 그 구름 안 아무 점이나 뽑아 디코더에 넣습니다. 디코더는 한 점이 아니라 그 주변 전체에서 같은 그림을 내도록 배우므로, 가까운 $z$ 는 비슷한 그림이 됩니다. 구름들이 원점 쪽으로 끌려와 서로 겹치면서 빈틈도 줄어듭니다. KL 항은 $\sigma$ 가 0 으로 줄어드는 것도 막습니다($\sigma \to 0$ 이면 아래 식의 $-\log\sigma^2$ 이 무한히 커집니다).
두 항은 서로 줄다리기를 합니다. 재구성만 생각하면 구름을 아주 작게, 서로 멀리 떨어뜨리는 게 유리하고(오토인코더처럼), KL 만 생각하면 모든 그림을 똑같이 $\Normal(0, I)$ 로 보내는 게 유리합니다(그러면 $z$ 에 정보가 없어 재구성이 불가능). VAE 는 그 사이의 균형점을 찾습니다.
KL 항의 닫힌 꼴
KL 항은 두 가우시안 사이의 KL 이므로 적분 없이 공식으로 계산됩니다. 3장에서 일반적인 두 가우시안의 KL 을 유도했지만, 여기서 쓰는 특별한 경우를 처음부터 다시 풀어 둡니다.
한 차원
결과의 각 항을 읽어 봅니다. $\mu^2$ 은 “평균이 0 에서 멀수록 벌점”, $\sigma^2 - 1 - \log\sigma^2$ 은 “$\sigma$ 가 1 에서 멀수록 벌점” 입니다. $g(s) = s - 1 - \log s$ ($s = \sigma^2$)를 미분하면 $g'(s) = 1 - \frac{1}{s}$ 이고, 이것이 0 이 되는 곳은 $s = 1$ 입니다. $s \lt 1$ 에서는 $g' \lt 0$(감소), $s \gt 1$ 에서는 $g' \gt 0$(증가)이므로 $s = 1$ 에서 최솟값 $g(1) = 0$ 을 가집니다. 즉 이 항은 늘 0 이상이고 $\sigma = 1$ 일 때만 0 입니다.
32차원으로 넓히기
0.5 * sum(mu**2 + logvar.exp() - 1 - logvar) 한 줄입니다.숫자 예: 2차원에서 $\mu = (0.5,\ 0)$, $\sigma = (1,\ 0.5)$ 이면 $\tfrac{1}{2}(0.25 + 1 - 1 - 0) + \tfrac{1}{2}(0 + 0.25 - 1 - \log 0.25) = 0.125 + \tfrac{1}{2}(-0.75 + 1.386) = 0.125 + 0.318 = 0.443$ 입니다. 몬테카를로로 확인해 봅니다.
import torch

mu = torch.tensor([0.5, 0.0])
sigma = torch.tensor([1.0, 0.5])

# 닫힌 꼴: ½ Σ (μ² + σ² − 1 − log σ²)
closed = 0.5 * torch.sum(mu**2 + sigma**2 - 1 - torch.log(sigma**2))

# 몬테카를로: z ~ q 를 많이 뽑아 log q(z) − log p(z) 를 평균
q = torch.distributions.Normal(mu, sigma)
p = torch.distributions.Normal(torch.zeros(2), torch.ones(2))
z = q.sample((1_000_000,))
mc = (q.log_prob(z) - p.log_prob(z)).sum(-1).mean()

print(f"닫힌 꼴 {closed.item():.4f} | 몬테카를로 {mc.item():.4f}")
닫힌 꼴 0.4431 | 몬테카를로 0.4432
KL(q ‖ N(0,1)) = 내트 · 파란 선: 인코더의 추측 q, 회색 선: 사전 분포 N(0, 1)
재구성 항: 디코더 가능도 고르기
재구성 항 $\E_{q_\phi}[\log p_\theta(x \mid z)]$ 를 계산하려면 두 가지를 정해야 합니다. 기댓값을 어떻게 계산할지, 그리고 $p_\theta(x \mid z)$ 가 어떤 분포인지입니다.
기댓값은 표본 하나로
$q_\phi(z \mid x)$ 에서 $z$ 를 딱 하나 뽑아 $\log p_\theta(x \mid z^{(1)})$ 로 기댓값을 대신합니다. 2장의 몬테카를로 추정을 $S = 1$ 로 한 것입니다. 표본 하나는 흔들리지만 평균적으로는 정답과 같고(불편 추정), 어차피 미니배치 128장에 대해 평균을 내며 수천 번 갱신하므로 흔들림은 평균되어 사라집니다. 앞에서 사전 분포에서 뽑을 때는 쓸모없던 몬테카를로가 여기서는 잘 되는 까닭은, 이제 $z$ 를 $x$ 를 보고 추측한 $q_\phi(z \mid x)$ 에서 뽑기 때문입니다. 대부분의 표본이 $x$ 를 잘 만드는 구역에 떨어집니다.
베르누이 디코더 → 이진 교차 엔트로피
진자 그림은 대부분 검정(0)이고 막대는 밝은 회색(0.85), 끝의 추는 흰색(1)입니다. 그래서 픽셀 $i$ 의 밝기 $x_i \in [0, 1]$ 을 “흰색일 확률 $p_i$ 인 동전 던지기(베르누이)” 로 봅니다. 디코더는 픽셀마다 로짓 $\ell_i$ 를 내고 $p_i = \text{sigmoid}(\ell_i) = \frac{1}{1 + e^{-\ell_i}}$ 로 확률을 만듭니다. 픽셀들이 $z$ 가 주어지면 서로 독립이라고 가정합니다.
binary_cross_entropy_with_logits(..., reduction="sum") 입니다.막대 몸통은 밝기 0.85 로 칠했고 가장자리도 부드럽게 칠해서, 0 과 1 사이의 회색 픽셀이 많습니다. 엄밀히는 베르누이가 아니지만 실무에서 흔히 이렇게 씁니다. 대신 BCE 가 0 이 될 수 없다는 점을 알아 두세요. 목표 $x \in (0, 1)$ 에 대해 $\text{BCE}(x, p)$ 를 $p$ 로 미분하면 $-\frac{x}{p} + \frac{1 - x}{1 - p}$ 이고, 이것이 0 인 곳은 $x(1-p) = (1-x)p$, 즉 $p = x$ 입니다. 그때의 값은 $-\big(x\log x + (1-x)\log(1-x)\big)$, 곧 픽셀의 엔트로피 입니다. 그래서 완벽한 디코더도 그림당 “회색 픽셀들의 엔트로피 합” 만큼의 BCE 가 남습니다. 코드가 계산한 이 바닥값은 그림당 약 80 내트였습니다(그 절반쯤은 밝기 0.85 인 막대 몸통에서, 나머지는 가장자리의 회색 픽셀에서 나옵니다).
가우시안 디코더 → 제곱 오차(MSE)
색이 다양한 자연 그림에서는 픽셀 값을 “디코더가 낸 $\hat{x}_i$ 를 평균으로 하는 가우시안” 으로 보기도 합니다. Ha & Schmidhuber 는 이 방식(MSE)을 썼습니다.
여기서 $s$ 는 단순한 상수처럼 보이지만, KL 항과의 가중치 비율 을 정합니다. 이 점은 뒤의 β-VAE 에서 다시 봅니다.
재매개변수화 트릭
무엇이 문제인가
ELBO 를 경사 하강법(4장)으로 최대화하려면 인코더 매개변수 $\phi$ 에 대한 기울기가 필요합니다. 그런데 재구성 항 $\E_{z \sim q_\phi}[\log p_\theta(x \mid z)]$ 에서 $\phi$ 는
“$z$ 를 어느 분포에서 뽑는가” 에 숨어 있습니다. 코드로 쓰면 z = torch.normal(mu, sigma) 같은 줄인데, 이런 “무작위로 뽑기” 는 미분할 수 있는 함수가 아닙니다.
$\mu$ 를 조금 바꿨을 때 뽑힌 $z$ 가 어떻게 변하는지 정의되지 않기 때문입니다. 역전파는 이 줄에서 끊깁니다.
해법: 무작위성을 바깥으로 빼기
가우시안에는 좋은 성질이 있습니다. 표준 정규 분포에서 뽑은 $\epsilon$ 을 늘리고($\times\sigma$) 옮기면($+\mu$) 원하는 가우시안의 표본이 됩니다.
$$ z \sim \Normal(\mu, \sigma^2) \quad\Longleftrightarrow\quad z = \mu + \sigma\,\epsilon,\quad \epsilon \sim \Normal(0, 1) $$확인: $\E[\mu + \sigma\epsilon] = \mu + \sigma\E[\epsilon] = \mu$, $\Var(\mu + \sigma\epsilon) = \sigma^2\Var(\epsilon) = \sigma^2$ 이고, 가우시안을 늘리고 옮겨도 가우시안입니다. 이제 무작위성은 $\phi$ 와 상관없는 $\epsilon$ 에만 있고, $z$ 는 $\mu, \sigma$ 의 평범한 미분 가능 함수 가 됩니다. 이것이 재매개변수화 트릭reparameterization trick 입니다(Kingma & Welling, 2014).
손으로 확인해 봅니다. $f(z) = z^2$ 이면 $\E[z^2] = \mu^2 + \sigma^2$ 이므로 정답 기울기는 $\frac{\partial}{\partial\mu} = 2\mu$, $\frac{\partial}{\partial\sigma} = 2\sigma$ 입니다. 위 공식으로는 $\E_\epsilon[2(\mu + \sigma\epsilon)] = 2\mu + 2\sigma\E[\epsilon] = 2\mu$ ✓, $\E_\epsilon[2(\mu+\sigma\epsilon)\epsilon] = 2\mu\E[\epsilon] + 2\sigma\E[\epsilon^2] = 0 + 2\sigma\cdot 1 = 2\sigma$ ✓ 로 똑같습니다. ($\E[\epsilon] = 0$, $\E[\epsilon^2] = \Var(\epsilon) + 0^2 = 1$.) 코드로도 확인합니다. 코드에서는 VAE 처럼 $\log\sigma$ 로 매개변수화했으므로 $\frac{\partial}{\partial \log\sigma}(\mu^2 + \sigma^2) = 2\sigma\cdot\frac{\partial\sigma}{\partial\log\sigma} = 2\sigma\cdot\sigma = 2\sigma^2$ 이 정답입니다.
import torch

torch.manual_seed(0)
mu = torch.tensor(1.5, requires_grad=True)
log_sigma = torch.tensor(0.0, requires_grad=True)   # σ = e^0 = 1

eps = torch.randn(100_000)                  # ε ~ N(0, 1): μ, σ 와 상관없는 잡음
z = mu + log_sigma.exp() * eps              # z = μ + σ ε  ← 미분이 지나가는 길
loss = (z ** 2).mean()                      # E[z²] 의 몬테카를로 추정
loss.backward()

print(f"E[z^2] 추정  {loss.item():.3f}   (정답 μ²+σ² = {1.5**2 + 1:.3f})")
print(f"dE/dμ 추정   {mu.grad.item():.3f}   (정답 2μ = {2*1.5:.3f})")
print(f"dE/dlogσ 추정 {log_sigma.grad.item():.3f}   (정답 2σ² = {2*1.0:.3f})")
E[z^2] 추정 3.245 (정답 μ²+σ² = 3.250) dE/dμ 추정 2.995 (정답 2μ = 3.000) dE/dlogσ 추정 1.998 (정답 2σ² = 2.000)
분포를 재매개변수화할 수 없을 때(예: 이산적인 선택)는 $\nabla_\phi\E_{q_\phi}[f(z)] = \E_{q_\phi}[f(z)\,\nabla_\phi\log q_\phi(z)]$ 라는 점수 함수(REINFORCE) 추정량을 씁니다. 5장의 정책 경사와 같은 식입니다. 어떤 분포에도 쓸 수 있지만 표본마다의 흔들림(분산)이 훨씬 커서, 가능하면 재매개변수화를 씁니다. 12장의 Dreamer 는 두 방법을 모두 씁니다.
구현: 합성곱 VAE
데이터 모으기
무작위 토크로 진자를 200 에피소드 움직여 그림 40,200장을 모읍니다. 시작 각도가 고르게 무작위이므로 모든 각도의 그림이 골고루 들어 있습니다. 정답 상태(각도)도 함께 저장하지만, 이것은 나중에 “VAE 가 무엇을 배웠는지” 확인하는 데만 쓰고 학습에는 쓰지 않습니다.
합성곱 층의 출력 크기 계산
그림에는 4장에서 배운 합성곱(convolution) 이 잘 맞습니다. 인코더는 크기 4, 보폭(stride) 2 인 합성곱을 네 번 거치며 그림을 줄이고, 디코더는 전치 합성곱transposed convolution 으로 다시 키웁니다. Ha & Schmidhuber 의 구조를 흑백 1채널로 바꾼 것입니다. 층마다 크기가 어떻게 변하는지 직접 계산해 봅니다.
| 층 | 설정 | 출력 모양 (채널, 높이, 폭) | 매개변수 수 |
|---|---|---|---|
| 입력 | 흑백 그림 | (1, 64, 64) | — |
| 합성곱 1 | 32채널, 4×4, 보폭 2, ReLU | (32, 31, 31) | 1·32·16 + 32 = 544 |
| 합성곱 2 | 64채널, 4×4, 보폭 2, ReLU | (64, 14, 14) | 32·64·16 + 64 = 32,832 |
| 합성곱 3 | 128채널, 4×4, 보폭 2, ReLU | (128, 6, 6) | 64·128·16 + 128 = 131,200 |
| 합성곱 4 | 256채널, 4×4, 보폭 2, ReLU | (256, 2, 2) → 펼침 1024 | 128·256·16 + 256 = 524,544 |
| μ, log σ² | 완전 연결 1024 → 32 (두 개) | (32), (32) | 2 × (1024·32 + 32) = 65,600 |
| 디코더 입력 | 완전 연결 32 → 1024 | (1024, 1, 1) | 32·1024 + 1024 = 33,792 |
| 전치 합성곱 1 | 128채널, 5×5, 보폭 2, ReLU | (128, 5, 5) | 1024·128·25 + 128 = 3,276,928 |
| 전치 합성곱 2 | 64채널, 5×5, 보폭 2, ReLU | (64, 13, 13) | 128·64·25 + 64 = 204,864 |
| 전치 합성곱 3 | 32채널, 6×6, 보폭 2, ReLU | (32, 30, 30) | 64·32·36 + 32 = 73,760 |
| 전치 합성곱 4 | 1채널, 6×6, 보폭 2 (로짓) | (1, 64, 64) | 32·1·36 + 1 = 1,153 |
합성곱 층의 매개변수 수는 “입력 채널 × 출력 채널 × 창 크기 + 출력 채널(편향)” 입니다. 모두 더하면 약 435만 개이고, 그중 75% 가 디코더의 첫 전치 합성곱에 몰려 있습니다.
모델 코드
enc: 위 표의 합성곱 네 층. 마지막에Flatten으로 (256, 2, 2) 를 1024개 숫자로 폅니다.fc_mu,fc_logvar: 같은 1024개 특징에서 두 개의 32차원 벡터를 냅니다. 이것이 $q_\phi(z \mid x) = \Normal(\mu, \diag\sigma^2)$ 의 $\mu$ 와 $\log\sigma^2$ 입니다.reparameterize: $\sigma = \exp(\tfrac{1}{2}\log\sigma^2)$ (왜냐하면 $\exp(\tfrac{1}{2}\log\sigma^2) = (\sigma^2)^{1/2}$), 그리고 $z = \mu + \sigma\odot\epsilon$.randn_like가 같은 모양의 $\epsilon$ 을 뽑습니다.decode_logits: 그림의 밝기 자체가 아니라 로짓 을 돌려줍니다. 시그모이드는 손실 함수 안에서 함께 계산합니다(아래).forward: 인코드 → 재매개변수화 → 디코드. 학습 때 쓰는 경로입니다. 10장에서 진짜 환경의 그림을 $z$ 로 바꿀 때는 뽑지 않고 평균 $\mu$ 를 씁니다(9장의 MDN-RNN 학습에서는 저장해 둔 $\mu, \log\sigma^2$ 에서 배치마다 $z$ 를 새로 뽑습니다).
손실 함수
| 수식 | 코드 |
|---|---|
| $-\log p_\theta(x \mid z) = \sum_i \text{BCE}(x_i, \text{sigmoid}(\ell_i))$ | binary_cross_entropy_with_logits(logits, x, reduction="sum") |
| $\tfrac{1}{2}\sum_j(\mu_j^2 + \sigma_j^2 - 1 - \log\sigma_j^2)$ | 0.5 * torch.sum(mu.pow(2) + logvar.exp() - 1.0 - logvar) |
| 배치 평균 (그림 한 장당) | / batch |
| $-\text{ELBO} = \text{재구성} + \beta\cdot\text{KL}$ | recon + beta * kl (기본 $\beta = 1$) |
시그모이드를 먼저 계산한 뒤 로그를 취하면, 로짓이 +20 처럼 클 때 $p$ 가 컴퓨터(float32)에서 정확히 1 이 되어 $\log(1-p) = \log 0 = -\infty$ 가 납니다(반대쪽도 로짓이 −100 안팎 아래로 내려가면 $p$ 가 정확히 0 이 되어 $\log p$ 가 터집니다).
binary_cross_entropy_with_logits 는 $\log\text{sigmoid}(\ell) = -\log(1 + e^{-\ell})$ 을 직접, 안정한 방법으로 계산하므로 이런 일이 없습니다.
“픽셀마다 합(sum)” 을 쓰는 점도 중요합니다. 픽셀에 대해 평균(mean)을 내면 재구성 항이 4096분의 1 로 작아져 KL 항이 상대적으로 4096배 강해지고, 그림이 흐려집니다.
학습 루프
4장의 학습 루프와 같은 모양입니다. 에폭마다 데이터 순서를 섞고(permutation), 128장씩 잘라 손실을 계산하고, backward() 로 기울기를 구하고, Adam 으로 한 스텝 갑니다.
uint8 그림을 255 로 나눠 [0, 1] 로 바꾸는 일은 to_float 가 합니다.
$ python ch08_vae.py장치: cuda 에피소드 200개, 그림 40200장 모음 (10.3초) epoch 1 | -ELBO 282.76 = 재구성 255.74 + KL 27.03 epoch 2 | -ELBO 112.65 = 재구성 94.57 + KL 18.08 epoch 3 | -ELBO 105.07 = 재구성 90.51 + KL 14.56 … epoch 9 | -ELBO 95.57 = 재구성 85.34 + KL 10.23 epoch 10 | -ELBO 95.95 = 재구성 85.72 + KL 10.23 VAE 학습 97.1초 차원별 평균 KL (큰 순서 5개): z[26]=2.55, z[2]=2.35, z[6]=2.23, z[14]=1.23, z[28]=0.76 KL > 0.05 인 '살아 있는' 차원: 7개 / 32개 재구성 항(BCE)의 이론적 바닥값: 그림당 79.9 내트 그림 저장: figures
이 튜토리얼을 쓴 환경(노트북 GPU)에서 VAE 학습 10 에폭은 다른 작업 없이 돌리면 약 30초, 다른 학습과 GPU 를 나눠 쓴 위 실행에서는 약 97초 걸렸고,
비교용 오토인코더까지 포함한 전체 실행은 2 – 4분이었습니다. CPU(4스레드)만 쓰면 한 스텝에 약 0.5초가 걸려 VAE 와 오토인코더를 합쳐 약 50분이 걸립니다.
기다리기 길면 --epochs 3 으로 줄여도 그림 모양은 거의 같습니다.
결과 읽기
학습 곡선
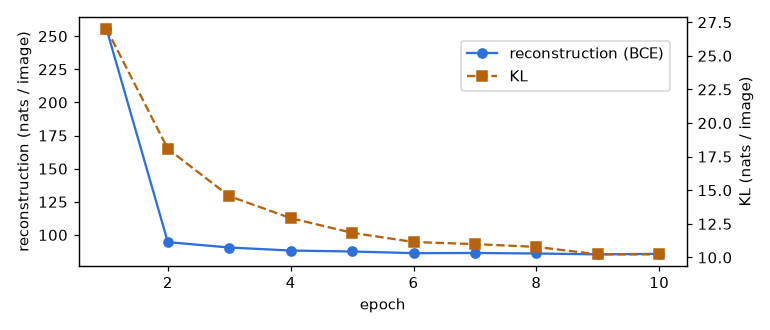
첫 에폭에 KL 이 27 내트까지 올랐다가 점점 10 근처로 내려갑니다. 처음에는 “일단 그림을 되살리자” 며 잠재 공간을 넉넉히 쓰고, 그 뒤 같은 재구성을 더 적은 정보로 하는 법을 찾는 것입니다. 재구성 항은 약 85 내트로, 앞에서 계산한 바닥값 약 80 내트에 가깝습니다. 남은 약 6 내트가 실제로 “덜 맞힌” 부분입니다.
KL 항은 “그림 한 장이 $z$ 에 담는 정보량” 의 위쪽 경계로 볼 수 있습니다. 10 내트는 $10/\ln 2 \approx 14.4$ 비트입니다. 각도를 $2^{14} \approx 16{,}000$ 단계로 구분할 만큼의 정보로, 막대 각도 하나를 표현하기에 충분하고도 남습니다. 4096개 픽셀이 실은 14비트 남짓의 정보만 담고 있었던 셈입니다.
재구성
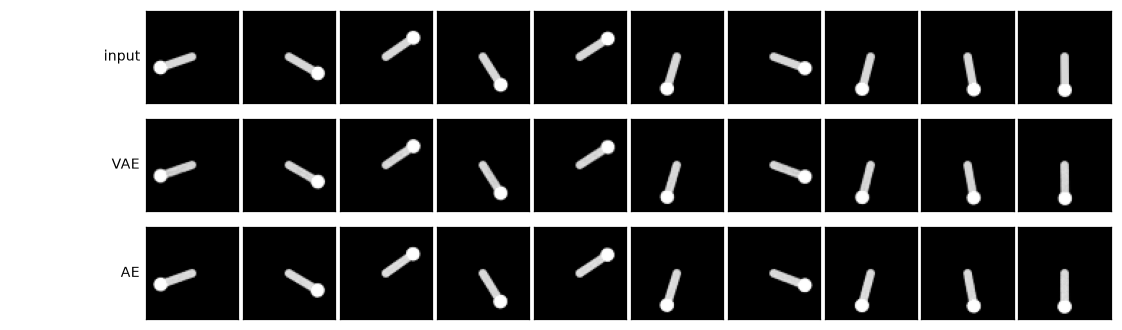
몇 개의 차원을 쓰는가
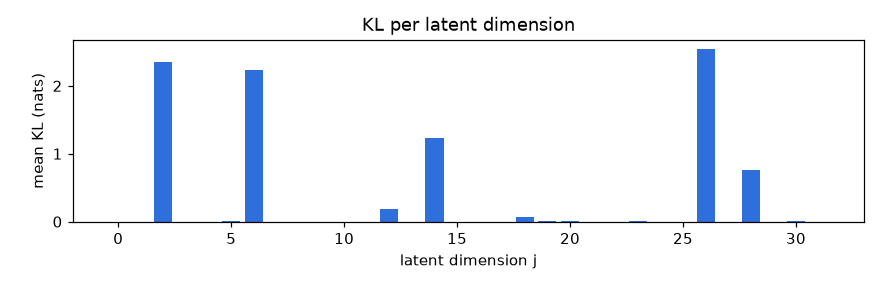
차원별 KL 이 0 이라는 것은 그 차원에 대해 모든 그림의 $q_\phi(z_j \mid x)$ 가 사전 분포 $\Normal(0, 1)$ 과 똑같다는 뜻입니다. 즉 그 차원은 그림에 대해 아무 정보도 담지 않습니다. VAE 는 KL 벌점 때문에 “꼭 필요한 차원만 쓰고 나머지는 꺼 두는” 쪽을 택합니다. 32개 중 7개만 쓰였습니다(실행마다 6 – 8개 정도로 조금씩 다릅니다).
진자 그림의 자유도는 각도 하나인데 왜 1개가 아닐까요? 각도는 한 바퀴 돌면 제자리로 오는 원 위의 값이라, 끊김 없이 표현하려면 최소 2차원(원)이 필요합니다. 또 인코더 · 디코더가 유한한 신경망이라 원을 깔끔한 원 모양으로 펴지 못하고 몇 차원에 걸쳐 구부러진 고리로 표현합니다. VAE 가 찾는 표현은 “깔끔한” 표현이 아니라 ELBO 를 높이는 표현입니다.
잠재 공간의 모양: VAE vs 오토인코더
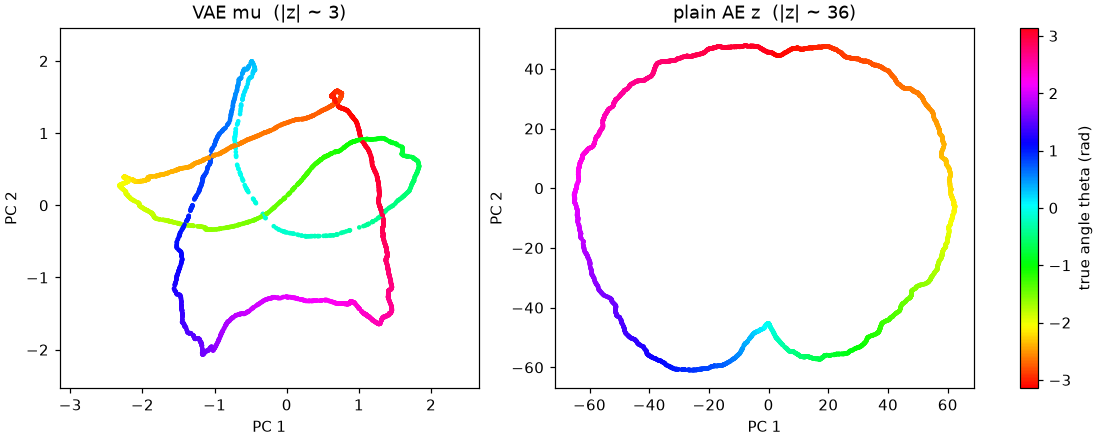
두 모델 모두 각도를 따라 색이 연속으로 바뀌는 닫힌 고리 를 만들었습니다. 아무도 각도를 알려 주지 않았는데, 그림만 보고 “이 데이터는 원 위에 있다” 는 것을 찾아낸 것입니다. 차이는 크기 입니다. VAE 의 좌표는 ±3 안쪽, 곧 $\Normal(0, I)$ 가 주로 놓이는 범위에 있고, 오토인코더의 좌표는 주성분 축으로 ±60 까지(성분 하나로는 최대 36) 아무렇게나 퍼져 있습니다. (VAE 쪽 고리가 꼬여 보이는 것은 7차원 남짓한 공간의 고리를 2차원에 비춘 그림자이기 때문입니다.)
잠재 공간 순회
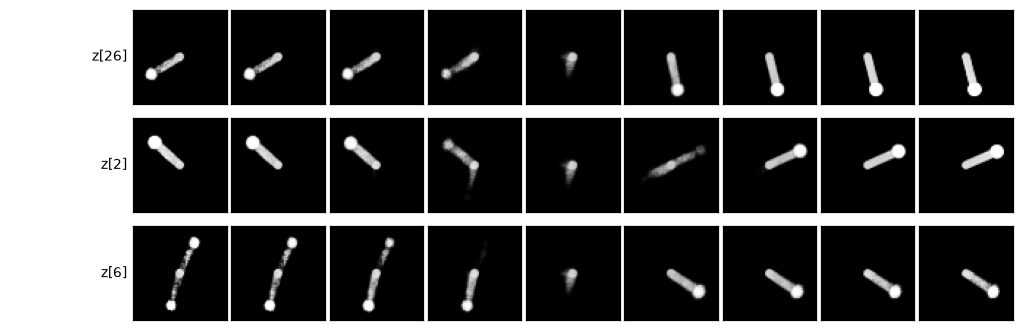
한 차원을 움직이면 막대가 돌아갑니다. 다만 한 차원이 “각도” 하나에 깔끔하게 대응하지는 않습니다. 중간에서 막대가 흐려지거나 두 각도가 겹쳐 보이기도 합니다. 고리 모양의 데이터를 여러 축에 나눠 담았으므로, 축 하나만 움직이면 고리에서 벗어난 곳을 지나기 때문입니다. 각 차원이 사람이 이해할 수 있는 한 가지 성질만 맡도록 하는 것을 분리 표현disentanglement 이라고 하는데, 보통의 VAE 는 이것을 보장하지 않습니다.
새 그림 만들기: 사전 분포에서 뽑기
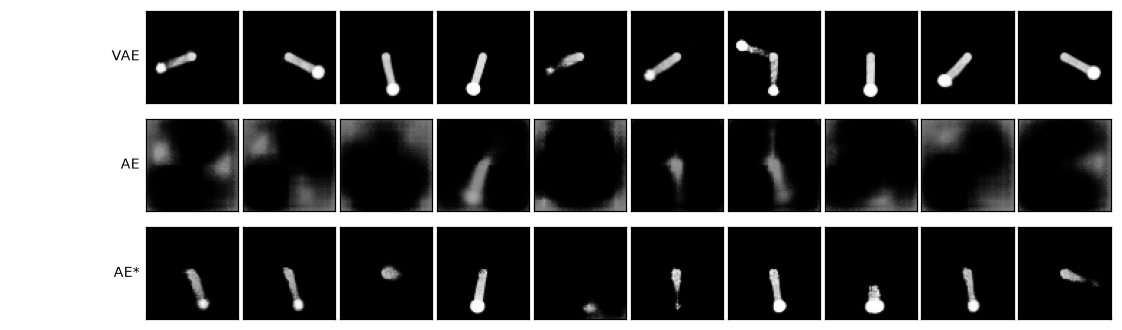
이 그림이 VAE 를 쓰는 이유를 가장 잘 보여 줍니다. VAE 의 디코더는 $\Normal(0, I)$ 에서 뽑은 거의 모든 $z$ 에서 진자 그림을 만듭니다(가끔 흐리거나 두 막대가 겹친 그림도 나옵니다). 오토인코더는 크기가 맞지 않는 $z$ 를 받아 엉뚱한 얼룩을 만들고, 크기를 맞춰 줘도(AE*) 여전히 이상한 그림이 많습니다. 오토인코더의 데이터는 넓은 공간 속 가느다란 고리 위에만 있는데, 차원마다 따로 뽑은 점은 대부분 그 고리에서 벗어나기 때문입니다. 9장의 M 모델은 잠재 공간에서 계속 새 $z$ 를 뽑으며 미래를 상상하므로, 이 차이가 곧 “상상이 되는 눈” 과 “안 되는 눈” 의 차이입니다.
β-VAE 와 KL 가중치
손실에 KL 항의 가중치 $\beta$ 를 붙인 것을 β-VAEbeta-VAE 라고 합니다(Higgins 외, 2017).
$$ \mathcal{L}_\beta = \E_{q_\phi}\big[-\log p_\theta(x \mid z)\big] + \beta\,\KL\big(q_\phi(z \mid x)\,\|\,p(z)\big) $$- $\beta \gt 1$: 정보를 더 적게 쓰도록 강하게 압박합니다. 잠재 공간이 더 매끄럽고 분리 표현이 나오는 경향이 있지만(보장되지는 않습니다) 재구성이 흐려집니다.
- $\beta \lt 1$: 재구성이 선명해지지만 잠재 공간이 오토인코더처럼 듬성해집니다. $\beta = 0$ 이면 (σ 가 있는) 오토인코더와 거의 같습니다.
$\beta$ 가 임의로 붙인 숫자처럼 보이지만, 가우시안 디코더의 분산 $s^2$ 과 정확히 같은 역할을 합니다.
그래서 MSE 를 “픽셀 평균” 으로 쓰느냐 “픽셀 합” 으로 쓰느냐만 바꿔도 사실상 $\beta$ 가 4096배 바뀝니다. 손실을 고칠 때는 이 점을 늘 의식해야 합니다.
사후 붕괴와 대처법
KL 항이 너무 강하거나 디코더가 너무 강하면, 인코더가 모든 그림에 대해 $q_\phi(z \mid x) = \Normal(0, I)$ 를 내고(KL = 0) 디코더는 $z$ 를 무시한 채 “평균적인 그림” 만 내는 상태에 빠질 수 있습니다. 이것을 사후 붕괴posterior collapse 라고 합니다. 그림 8-6 에서 꺼진 25개 차원은 “차원 단위의 부분적인 붕괴” 이고, 정보가 필요 없어서 꺼진 것이므로 괜찮습니다. 문제는 모든 차원이 꺼질 때입니다.
- KL 가중치 서서히 올리기(KL annealing): 처음 몇 천 스텝은 $\beta$ 를 0 에서 1 로 천천히 올려, 먼저 재구성을 배우게 합니다.
-
자유 비트(free bits) · KL 허용치: KL 이 정해진 값 $c$ 보다 작으면 벌점을 주지 않습니다. 손실에 $\max(\KL, c)$ 를 씁니다(11장에서 “자유 내트(free nats)” 라고 부르는 것과 같은 기법입니다).
$\KL \lt c$ 인 구간에서는 이 항의 기울기가 0 이므로, KL 을 0 까지 짜내려는 압력이 사라집니다. Ha & Schmidhuber 의 공개 코드는 차원당 0.5 내트, 곧 32차원 합계 16 내트의 허용치를 KL 합계에 걸었고(
kl_tolerance. 논문 본문에는 나오지 않습니다), 12장의 DreamerV3 는 1 내트의 자유 비트를 씁니다. - 차원별 KL 지켜보기: 그림 8-6 같은 막대그래프를 학습 중에 찍어 보면, 정보를 담은 차원 수가 0 으로 무너지는지 바로 알 수 있습니다.
9장을 위한 준비물
코드는 실행이 끝나면 두 파일을 남깁니다. 9 · 10장은 이 두 파일에서 출발합니다.
| 파일 | 내용 | 쓰는 곳 |
|---|---|---|
ch08_vae.pt | 학습한 VAE (load_vae() 로 불러온다) | 9장: 에피소드를 $z$ 시퀀스로 바꾸기, 꿈 그림 그리기. 10장: 진짜 환경의 그림을 $z$ 로 |
ch08_episodes.npz | 200 에피소드의 그림 · 행동 · 보상 · (확인용) 정답 상태 | 9장: MDN-RNN 학습 데이터 |
- 그림(4096차원)은 실제로는 훨씬 낮은 차원에 놓여 있다. World Model 은 그림을 작은 잠재 벡터 $z$ 로 압축해, 그 공간에서 미래를 예측한다.
- 오토인코더는 재구성은 잘하지만, 잠재 공간이 어디에 어떤 모양으로 있는지 몰라 새 $z$ 를 뽑아 쓸 수 없다.
- VAE 는 생성 이야기 $z \sim \Normal(0, I),\ x \sim p_\theta(x \mid z)$ 를 가정하고, 계산할 수 없는 $\log p_\theta(x)$ 대신 ELBO 를 최대화한다.
- $\log p_\theta(x) = \text{ELBO} + \KL(q_\phi(z\mid x)\,\|\,p_\theta(z\mid x))$. ELBO = 재구성 항 − $\KL(q_\phi(z\mid x)\,\|\,\Normal(0,I))$.
- KL 항의 닫힌 꼴: $\tfrac{1}{2}\sum_j(\mu_j^2 + \sigma_j^2 - 1 - \log\sigma_j^2)$. 베르누이 디코더는 BCE, 고정 분산 가우시안 디코더는 MSE.
- 재매개변수화 $z = \mu + \sigma\odot\epsilon$ 으로 무작위 표본을 거쳐서도 기울기를 흘린다.
- 진자 VAE 는 각도를 닫힌 고리로 찾아냈고, 32차원 중 7개 안팎만 썼으며, $\Normal(0, I)$ 에서 뽑은 $z$ 로 그럴듯한 그림을 만든다.
확인 문제
$q = \Normal(1, 0.25)$ (즉 $\mu = 1$, $\sigma = 0.5$)일 때 $\KL(q\,\|\,\Normal(0,1))$ 을 계산하세요. ($\log 0.25 \approx -1.386$)
답 보기
$\tfrac{1}{2}(\mu^2 + \sigma^2 - 1 - \log\sigma^2) = \tfrac{1}{2}(1 + 0.25 - 1 + 1.386) = \tfrac{1}{2}(1.636) \approx 0.818$ 내트.
어떤 그림에 대해 $\log p_\theta(x) = -90$ 이고 ELBO 가 $-95$ 라면, $\KL(q_\phi(z\mid x)\,\|\,p_\theta(z\mid x))$ 는 얼마입니까? 인코더만 학습해서 ELBO 를 $-92$ 로 올리면 무엇이 바뀝니까?
답 보기
$\log p = \text{ELBO} + \KL$ 이므로 KL = $-90 - (-95) = 5$. 인코더($\phi$)만 바꾸면 $\log p_\theta(x)$ 는 그대로 $-90$ 이므로 KL 이 $5 \to 2$ 로 줄어듭니다. 근사 사후 분포가 진짜 사후 분포에 가까워진 것입니다.
$z = \mu + \sigma\epsilon$ 일 때 $f(z) = 3z + 1$ 의 기댓값을 $\mu$, $\sigma$ 로 미분하세요. 재매개변수화 공식 $\E_\epsilon[f'(z)]$, $\E_\epsilon[f'(z)\,\epsilon]$ 로도 같은 답이 나오는지 확인하세요.
답 보기
$\E[f(z)] = 3\mu + 1$ 이므로 $\partial/\partial\mu = 3$, $\partial/\partial\sigma = 0$. 공식으로는 $f'(z) = 3$ 이므로 $\E[3] = 3$, $\E[3\epsilon] = 3\E[\epsilon] = 0$. 같습니다. (선형 함수의 기댓값은 분산과 상관없습니다.)
입력이 96×96 이면 이 장의 인코더(크기 4, 보폭 2, 여백 0 합성곱 네 번)를 거친 뒤의 크기는 얼마입니까? 펼친 벡터의 길이는?
답 보기
$96 \to \lfloor 92/2\rfloor + 1 = 47 \to \lfloor 43/2\rfloor + 1 = 22 \to \lfloor 18/2\rfloor + 1 = 10 \to \lfloor 6/2\rfloor + 1 = 4$. 256채널 × 4 × 4 = 4096. 그래서 fc_mu 와 fc_logvar 의 입력 크기를 1024 에서 4096 으로 바꿔야 합니다. (디코더는 그대로 두면 여전히 64×64 를 내므로, 96×96 을 되살리려면 디코더의 전치 합성곱도 고쳐야 합니다.)
재구성 손실을 픽셀에 대한 합(reduction="sum") 대신 픽셀에 대한 평균으로 바꾸면(그림 한 장당 4096 으로 나눔, KL 은 그대로) 결과가 어떻게 달라질까요? 이것은 어떤 β 를 쓴 것과 같습니까?
답 보기
재구성 항이 픽셀 수 4096 으로 나눠지므로, 손실 전체에 4096 을 곱해 보면 “재구성(합) + 4096 × KL” 과 같습니다. 즉 $\beta = 4096$ 인 β-VAE 가 되어, 대부분의 차원이 꺼지고 그림이 크게 흐려집니다. (이 장의 vae_loss 에서 글자 그대로 reduction="mean" 으로만 바꾸면 배치 크기로도 한 번 더 나뉩니다. 뒤의 / batch 를 함께 지워야 위 계산과 같아집니다.)
python ch08_vae.py --beta 4 와 --beta 0.25 로 돌려 그림 8-6(차원별 KL)과 그림 8-9(표본)이 어떻게 바뀌는지 보세요.
$\beta$ 가 클수록 살아 있는 차원 수가 줄고 표본이 흐려지며, 작을수록 차원이 늘고 표본 중 이상한 그림이 많아질 것입니다.
이제 에이전트에게 눈 이 생겼습니다. 그림 한 장을 32개의 숫자로 요약할 수 있습니다. 하지만 그림 한 장으로는 진자가 얼마나 빨리 도는지 알 수 없습니다. 다음 장에서는 지나간 장면들을 기억하며 다음 $z$ 를 예측하는 기억(MDN-RNN) 을 만듭니다.