World Models (Ha & Schmidhuber)
8장에서 눈(V), 9장에서 기억(M)을 만들었습니다. 이 장에서는 그 위에 아주 작은 컨트롤러(C) 를 얹어 2018년 David Ha 와 Jürgen Schmidhuber 의 World Models 를 완성합니다. 컨트롤러는 미분 대신 진화 전략(CMA-ES) 으로 배우고, 마지막에는 진짜 환경을 한 번도 겪지 않고 모델이 꾸는 꿈속에서만 행동을 배워 진짜 진자에 옮겨 봅니다.
- World Models 논문의 V · M · C 구조와 원 논문의 수치들
- 왜 컨트롤러를 작게 만들고 진화 전략으로 학습하는지
- 진화 전략의 기울기 추정 $\nabla_\theta\E[F(\theta+\sigma\epsilon)] = \tfrac{1}{\sigma}\E[F(\theta+\sigma\epsilon)\,\epsilon]$ 를 한 줄씩 유도하기
- CMA-ES 의 평균 · 공분산 · 스텝 크기 갱신 식의 뜻과 numpy 구현
- 진짜 환경에서의 학습과 꿈속 학습의 비교, 온도 τ 와 “꿈속 속임수(모델 착취)”
- 반복 학습 절차와 이 방식의 한계 — 11 · 12장으로 넘어가는 이유
2018년의 World Models
“World Models”(Ha & Schmidhuber, 2018)는 웹에서 직접 움직여 볼 수 있는 대화형 글로 발표되어 World Model 이라는 말을 널리 알린 논문입니다. 같은 내용이 NeurIPS 2018 에 “Recurrent World Models Facilitate Policy Evolution” 이라는 제목으로 실렸습니다. 이 논문이 보여 준 것은 두 가지입니다.
- CarRacing(위에서 내려다본 자동차 경주, 64×64 그림 입력): V · M 이 만든 특징 위에 선형 컨트롤러 하나만 얹어 100번 시험 평균 906 ± 21 점을 얻었습니다. 이 과제를 “풀었다” 고 보는 기준(900점)을 처음으로 넘긴 결과였습니다.
- VizDoom: Take Cover(날아오는 불덩이를 피하는 게임): 진짜 게임에서는 무작위 행동으로 데이터만 모으고, 컨트롤러는 M 이 꾸는 꿈속에서만 학습했습니다. 그 컨트롤러를 진짜 게임에 옮겼더니 100번 평균 1092 ± 556 스텝을 살아남았습니다(과제 기준 750). 이때 꿈의 온도는 $\tau = 1.15$ 였습니다.
두 번째 실험이 특히 중요합니다. “세상의 모델을 배우면, 그 모델 안에서 상상만으로 행동을 배울 수 있다” 는 생각을 실제로 보여 준 것이기 때문입니다. 이 생각은 11장의 PlaNet, 12장의 Dreamer 로 이어집니다.
V · M · C 구조
매 스텝 일어나는 일은 세 줄입니다.
$$ \begin{aligned} z_t &= \mu_\phi(o_t) && \text{V: 그림을 잠재 벡터로 (평균만 쓴다)} \\ a_t &= C\big([z_t;\ h_t]\big) && \text{C: 지금 장면 + 기억으로 행동 결정} \\ h_{t+1} &= \text{LSTM}\big([z_t;\ a_t],\ h_t\big) && \text{M: 기억 갱신} \end{aligned} $$$z_t$ 는 “지금 무엇이 보이는가”, $h_t$ 는 “지금까지 어떻게 움직여 왔고 다음에 무엇이 올 것 같은가” 를 담습니다. 9장에서 본 대로 $h_t$ 에는 진자의 속도가 들어 있으므로, C 는 그림 한 장으로는 알 수 없던 정보까지 얻습니다. 원 논문은 $h_t$ 가 “미래에 대한 예측” 을 담고 있다는 점을 강조합니다. M 은 다음 $z$ 를 맞히도록 학습되었으므로 그 은닉 상태는 미래를 예측하는 데 필요한 정보를 요약하고 있습니다.
학습 순서
세 부분은 따로따로, 차례로 학습합니다.
- 무작위 정책으로 진짜 환경에서 에피소드를 모은다. (8장: 200 에피소드)
- 모은 그림으로 V 를 학습한다. (8장: ELBO)
- V 로 바꾼 $z$ 시퀀스로 M 을 학습한다. (9장: 혼합 NLL + 보상 MSE)
- V · M 을 고정하고, 리턴이 최대가 되도록 C 를 진화 전략으로 학습한다. (이 장)
- (필요하면) C 로 새 에피소드를 모아 1 – 4 를 되풀이한다.
원 논문의 크기와 우리 진자 판
원 논문(CarRacing)의 V 는 64×64 컬러 그림을 $z \in \R^{32}$ 로, M 은 은닉 256 의 LSTM 과 5 성분 혼합으로 되어 있습니다. 이 튜토리얼의 8 · 9장과 같습니다. (다만 원 논문의 M 은 보상을 예측하지 않습니다. CarRacing 에서는 다음 $z$ 만, VizDoom 에서는 다음 $z$ 와 “죽었는지(done)” 를 예측했습니다. 진자는 보상이 매 스텝 달라지므로 이 튜토리얼은 9장에서 보상 머리를 덧붙였습니다.) C 는 선형 함수 하나입니다.
$$ a_t = W_c\,[z_t;\ h_t] + b_c $$V(약 435만) · M(약 42만)에 비하면 C 의 289개는 아주 작습니다. 이것이 World Models 의 설계 철학입니다. 세상을 이해하는 어려운 일은 큰 V · M 이 자기 지도 학습으로 (보상 없이도, 데이터만 있으면) 맡고, 무엇을 할지 정하는 일은 작은 C 가 맡습니다. 보상이라는 귀하고 드문 신호로 배워야 하는 매개변수의 수를 최소로 줄인 것입니다.
왜 진화 전략인가
C 를 배우는 목표는 “에피소드 리턴의 기댓값을 최대로” 입니다. 매개변수를 하나의 벡터 $\theta \in \R^{289}$ 로 보고, 그 컨트롤러로 에피소드를 돌려 얻은 리턴을 $F(\theta)$ 라고 합시다.
$$ \max_\theta\; F(\theta),\qquad F(\theta) = \E\Big[\sum_{t=0}^{T-1} r_t \;\Big|\; \text{컨트롤러 } \theta\Big] $$4장의 경사 하강법을 쓰려면 $\nabla_\theta F$ 가 필요합니다. 그런데 $F$ 는 진짜 환경의 물리, 그림 그리기, 시작 상태의 무작위성을 모두 거쳐 나온 숫자라서 미분할 수 없는 상자 입니다. 우리가 할 수 있는 것은 “$\theta$ 를 넣고 돌려서 숫자 하나를 받는 것” 뿐입니다. 이런 문제를 블랙박스 최적화black-box optimization 라고 합니다.
진화 전략evolution strategies, ES 은 생물의 진화처럼 문제를 풉니다. 지금 매개변수 근처에서 여러 “자식” 을 무작위로 만들어 보고, 성적이 좋은 자식 쪽으로 옮겨 가기를 되풀이합니다. 기울기 공식이 없어도 되고, 자식들의 평가는 서로 독립이라 동시에 돌릴 수 있습니다. 대신 매개변수가 많아지면(수백만 개) 무작위 탐색이 비효율적이 됩니다. 그래서 World Models 는 C 를 작게 만들었습니다.
5장의 정책 경사(REINFORCE)로도 C 를 학습할 수 있습니다. 그것도 미분할 수 없는 환경에서 쓰는 방법입니다. 사실 아래에서 유도할 ES 의 기울기 공식은 정책 경사와 같은 “로그 미분 트릭” 에서 나옵니다. 차이는 무작위성을 어디에 넣느냐입니다. 정책 경사는 행동 에 잡음을 넣고, ES 는 매개변수 에 잡음을 넣습니다.
진화 전략의 기울기 유도
가우시안 평활화
$F$ 를 직접 미분할 수 없으니, 대신 “$\theta$ 근처를 가우시안으로 흐리게 한 평균” 을 목표로 삼습니다. 이것을 가우시안 평활화Gaussian smoothing 라고 합니다.
$$ J(\theta) = \E_{\epsilon \sim \Normal(0, I)}\big[F(\theta + \sigma\epsilon)\big] $$$\sigma$ 가 작으면 $J(\theta) \approx F(\theta)$ 이고, $J$ 는 $F$ 가 울퉁불퉁하거나 미분할 수 없어도 매끄러운 함수가 됩니다. 놀랍게도 $J$ 의 기울기는 $F$ 의 값만으로 계산할 수 있습니다.
숫자로 확인하기
1차원에서 $F(x) = -(x - 3)^2$ (최댓값은 $x = 3$), $\theta = 0$, $\sigma = 1$ 이라고 합시다. 직접 계산하면 $J(\theta) = \E[-(\theta + \epsilon - 3)^2] = -\big((\theta - 3)^2 + \E[\epsilon^2]\big) = -(\theta-3)^2 - 1$ 이므로 $J'(0) = -2(0 - 3) = 6$ 입니다. ($(\theta - 3 + \epsilon)^2$ 을 펼친 뒤 $\E[\epsilon] = 0$, $\E[\epsilon^2] = 1$ 을 썼습니다.)
흔들림 줄이기
표본이 적으면 이 추정은 많이 흔들립니다. 실무에서는 몇 가지 기법을 함께 씁니다.
- 기준선 빼기: $\E[\epsilon] = 0$ 이므로 어떤 상수 $b$ 에 대해 $\E[(F - b)\,\epsilon] = \E[F\epsilon] - b\,\E[\epsilon] = \E[F\epsilon]$ 입니다. 기댓값은 그대로인데, $b$ 를 평균 점수로 잡으면 “평균보다 잘했나 못했나” 만 남아 흔들림이 크게 줄어듭니다(5장의 기준선과 같은 아이디어).
- 쌍으로 뽑기(antithetic sampling): $\epsilon$ 과 $-\epsilon$ 을 짝으로 평가해 대칭으로 비교합니다.
- 순위 쓰기(fitness shaping): 점수 값 대신 순위를 씁니다. 점수가 한 번 크게 튀어도 흔들리지 않습니다. 아래 CMA-ES 가 바로 순위만 씁니다.
CMA-ES
한 문단 요약
CMA-EScovariance matrix adaptation evolution strategy(Hansen & Ostermeier, 2001)는 가장 널리 쓰이는 진화 전략입니다. 탐색 분포를 $\Normal(m,\ \sigma^2 C)$ 로 두고 세 가지를 배웁니다. 평균 $m$(어디를 탐색할지), 공분산 $C$(어느 방향으로 길쭉하게 탐색할지), 스텝 크기 $\sigma$(얼마나 넓게 탐색할지). 매 세대 $\lambda$ 개의 후보를 뽑아 평가하고, 상위 $\mu$ 개만 써서 셋을 갱신합니다. 점수의 크기는 쓰지 않고 순위만 씁니다. (CMA-ES 문헌의 관례를 따르느라 기호가 겹칩니다. 이 절에서 $C$ 는 컨트롤러가 아니라 공분산 행렬, $\mu$ 는 평균이 아니라 부모 수, $\lambda$ 는 후보 수, $\sigma$ 는 표준편차가 아니라 전체 스텝 크기입니다.)
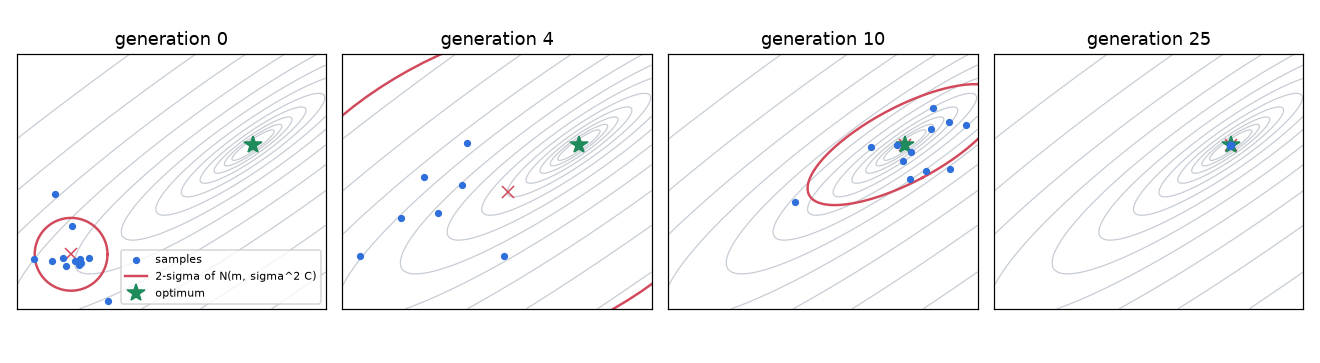
1단계: 뽑기
$$ x_k = m + \sigma\,y_k,\qquad y_k \sim \Normal(0, C),\qquad k = 1, \dots, \lambda $$$y_k \sim \Normal(0, C)$ 는 $C = B D^2 B^\top$ 로 고윳값 분해해 두고 $y_k = B D\,\epsilon_k$ ($\epsilon_k \sim \Normal(0, I)$)로 만듭니다. $\Cov(BD\epsilon) = BD\,\Cov(\epsilon)\,(BD)^\top = BD\,I\,DB^\top = BD^2B^\top = C$ 이므로 맞습니다. ($B$ 는 고유벡터를 열로 모은 직교 행렬, $D$ 는 고윳값의 제곱근을 대각에 둔 행렬)
2단계: 평균 옮기기 (가중 재조합)
후보를 점수 순으로 정렬해 $i$ 번째로 좋은 후보의 스텝을 $y_{i:\lambda}$ 라고 씁니다. 상위 $\mu = \lambda/2$ 개에 가중치를 주어 평균을 옮깁니다.
$$ m \leftarrow \sum_{i=1}^{\mu} w_i\,x_{i:\lambda} = m + \sigma\,y_w,\qquad y_w = \sum_{i=1}^{\mu} w_i\,y_{i:\lambda},\qquad w_i = \frac{\ln(\mu + \tfrac12) - \ln i}{\sum_{j=1}^{\mu}\big(\ln(\mu+\tfrac12) - \ln j\big)} $$$x_{i:\lambda} = m + \sigma y_{i:\lambda}$ 이고 $\sum_i w_i = 1$ 이므로 $\sum_i w_i x_{i:\lambda} = m\sum_i w_i + \sigma\sum_i w_i y_{i:\lambda} = m + \sigma y_w$ 입니다. 가중치는 1등이 가장 크고 $\mu$ 등으로 갈수록 작아집니다. 이 장의 설정($\lambda = 32$, $\mu = 16$)에서 1 – 5등의 가중치는 0.198, 0.149, 0.120, 0.100, 0.084 입니다. 평균은 결국 “좋은 후보들의 가중 평균 위치” 로 옮겨 갑니다. 7장의 CEM 이 상위 후보들의 (같은 가중치) 평균으로 옮긴 것과 같은 생각입니다.
가중치가 고르지 않으면 실제로 평균에 기여하는 후보 수는 $\mu$ 보다 적습니다. 그 “유효 개수” 를 $\mu_{\text{eff}} = 1/\sum_i w_i^2$ 로 셉니다. 가중치가 모두 $1/\mu$ 이면 $\mu_{\text{eff}} = 1/(\mu\cdot\frac{1}{\mu^2}) = \mu$ 이고, 한 후보에 몰리면 1 입니다. 이 장의 설정에서는 $\mu_{\text{eff}} \approx 9.18$ 입니다.
3단계: 공분산 배우기 (rank-μ 갱신)
“잘된 스텝들이 어떤 모양으로 퍼져 있었나” 를 보고 탐색 분포의 모양을 그쪽으로 바꿉니다. 그 모양은 2장의 최대우도로 구할 수 있습니다. 1차원으로 먼저 유도합니다.
CMA-ES 는 이 $C_\mu$ 로 공분산을 단번에 바꾸지 않고, 지난 공분산과 조금씩 섞습니다. 학습률 $c_\mu$ 로 지수 이동 평균을 냅니다.
$$ C \leftarrow (1 - c_1 - c_\mu)\,C + c_1\,p_c\,p_c^\top + c_\mu\sum_{i=1}^{\mu} w_i\,y_{i:\lambda}\,y_{i:\lambda}^\top $$셋째 항이 방금 유도한 rank-μ 갱신 이고, 둘째 항은 아래의 진화 경로 $p_c$ 로 만드는 rank-1 갱신 입니다. $c_1 = 0$, $c_\mu = 1$, 가중치를 모두 같게 하면 7장의 CEM 과 거의 같은 꼴이 됩니다(CEM 은 분산을 옛 평균이 아니라 새 평균 기준으로 재고, 7장에서는 성분마다 따로 쟀으며, 스텝 크기 $\sigma$ 를 따로 두지 않는다는 점이 다릅니다). CEM 은 매 세대 공분산을 상위 표본에 맞춰 통째로 바꾸므로 빨리 좁아지고, CMA-ES 는 천천히 바꾸므로 안정적입니다.
4단계: 진화 경로와 스텝 크기
세대마다 평균이 움직인 스텝 $y_w$ 를 누적해 진화 경로evolution path 를 만듭니다.
$$ p \leftarrow (1 - c)\,p + \sqrt{c\,(2 - c)\,\mu_{\text{eff}}}\;y_w $$$(1-c)$ 로 옛 경로를 조금씩 잊으며 새 스텝을 더합니다. 이상해 보이는 계수 $\sqrt{c(2-c)\mu_{\text{eff}}}$ 는 “선택이 아무 의미 없을 때(점수가 무작위일 때) 경로의 분포가 변하지 않도록” 맞춘 값입니다.
스텝 크기 $\sigma$ 는 이 원리로 조절합니다(누적 스텝 크기 조절, CSA). $C$ 의 모양을 걷어 낸 경로 $p_\sigma$ (스텝에 $C^{-1/2}$ 을 곱해 누적)를 만들면, 우연일 때 $p_\sigma \sim \Normal(0, I)$ 이므로 길이의 기댓값이 $\E\lVert\Normal(0,I)\rVert \approx \sqrt{n}\big(1 - \frac{1}{4n} + \frac{1}{21n^2}\big)$ 입니다(이 장의 $n = 289$ 에서 약 16.99). 아래 식의 $c_\sigma$ 는 경로를 누적하는 학습률(다음 표)이고, $d_\sigma$ 는 $\sigma$ 가 한 세대에 너무 크게 바뀌지 않게 나누는 감쇠(damping) 상수로 기본값은 $1 + 2\max\!\big(0,\ \sqrt{(\mu_{\text{eff}}-1)/(n+1)} - 1\big) + c_\sigma$ 입니다(이 장에서는 약 1.04).
$$ \sigma \leftarrow \sigma\cdot\exp\!\left(\frac{c_\sigma}{d_\sigma}\left(\frac{\lVert p_\sigma\rVert}{\E\lVert\Normal(0,I)\rVert} - 1\right)\right) $$- 경로가 기대보다 길다 = 여러 세대가 계속 같은 방향으로 걸었다 = 스텝이 너무 작다 → 괄호가 양수 → $\sigma$ 를 키운다.
- 경로가 기대보다 짧다 = 이번에 앞으로, 다음에 뒤로, 스텝이 서로 상쇄됐다 = 최적점을 넘나든다 = 스텝이 너무 크다 → $\sigma$ 를 줄인다.
공분산용 경로 $p_c$ 는 같은 방식으로 누적하되 $C$ 를 걷어 내지 않으며($C^{-1/2}$ 을 곱하지 않습니다), rank-1 갱신 $p_c p_c^\top$ 으로 “최근 여러 세대가 일관되게 움직인 방향” 을 공분산에 새깁니다.
기본 학습률과 차원의 저주
| 값 | 식 (Hansen 의 기본값) | 2차원, λ = 12 | 289차원, λ = 32 |
|---|---|---|---|
| $\mu_{\text{eff}}$ | $1/\sum w_i^2$ | 3.73 | 9.18 |
| $c_\sigma$ | $\frac{\mu_{\text{eff}}+2}{n+\mu_{\text{eff}}+5}$ | 0.534 | 0.0369 |
| $c_c$ | $\frac{4+\mu_{\text{eff}}/n}{n+4+2\mu_{\text{eff}}/n}$ | 0.603 | 0.0138 |
| $c_1$ | $\frac{2}{(n+1.3)^2+\mu_{\text{eff}}}$ | 0.137 | 0.0000237 |
| $c_\mu$ | $\min\!\big(1-c_1,\ \frac{2(\mu_{\text{eff}}-2+1/\mu_{\text{eff}})}{(n+2)^2+\mu_{\text{eff}}}\big)$ | 0.202 | 0.000172 |
공분산 학습률 $c_1, c_\mu$ 는 차원 $n$ 의 제곱에 반비례합니다. 2차원에서는 한 세대에 공분산의 약 34%($c_1 + c_\mu$)가 새로 바뀌지만(그림 10-2 에서 몇 세대 만에 타원이 기울어진 이유), 289차원에서는 한 세대에 0.02% 도 바뀌지 않습니다. 공분산 행렬에 원소가 약 $n^2/2 \approx 42{,}000$ 개나 있으니 그것을 믿을 만하게 배우려면 그만큼 많은 세대가 필요한 것입니다. 그래서 이 장처럼 수십 세대만 돌리면 CMA-ES 는 사실상 “순위 가중 평균으로 평균을 옮기고 스텝 크기만 조절하는” 진화 전략으로 동작합니다. 그래도 충분히 잘 됩니다.
numpy 구현
| 수식 | 코드 |
|---|---|
| $y_k = BD\epsilon_k,\ x_k = m + \sigma y_k$ | self.y = (eps * self.D) @ self.B.T, self.mean + self.sigma * self.y |
| 점수 순 정렬, 상위 $\mu$ 개 | order = np.argsort(-fitness), y_best = self.y[order[:mu]] |
| $y_w = \sum_i w_i y_{i:\lambda}$, $m \leftarrow m + \sigma y_w$ | y_w = self.weights @ y_best, self.mean + self.sigma * y_w |
| $p_\sigma \leftarrow (1-c_\sigma)p_\sigma + \sqrt{c_\sigma(2-c_\sigma)\mu_{\text{eff}}}\,C^{-1/2}y_w$ | C_inv_sqrt = B diag(1/D) Bᵀ 와 그 다음 줄 |
| $\sum_i w_i\,y_{i:\lambda}y_{i:\lambda}^\top$ | rank_mu = (y_best.T * self.weights) @ y_best |
| $\sigma \leftarrow \sigma\exp(\frac{c_\sigma}{d_\sigma}(\frac{\lVert p_\sigma\rVert}{\E\lVert N\rVert} - 1))$ | self.sigma *= np.exp(...) |
| $C = BD^2B^\top$ | np.linalg.eigh(self.C) |
h_sigma 는 $p_\sigma$ 가 유난히 길 때(스텝 크기가 너무 작아 $\sigma$ 가 급히 커지는 동안) $p_c$ 에 새 스텝을 더하지 않아 $C$ 가 한 방향으로 과하게 늘어나는 것을 막는 작은 안전장치이고, delta 는 그때 빠진 분산을 보충하는 항입니다.
처음 읽을 때는 건너뛰어도 됩니다. 이 구현은 Hansen 의 튜토리얼 “The CMA Evolution Strategy: A Tutorial” 의 기본 알고리즘을 옮긴 것으로(최근 판의 기본값인 “하위 후보에 음의 가중치 주기” 만 빼고 양의 가중치 $\mu$ 개만 썼습니다), 실무에서는 cma 패키지를 쓰면 됩니다.
컨트롤러와 진짜 환경 롤아웃
CMA-ES 의 후보 하나는 289개의 숫자입니다. 이것을 $W_c$ (288개)와 $b_c$ (1개)로 나눠 컨트롤러로 씁니다. 후보 $P$ 개를 한꺼번에 계산하도록 묶음 행렬 곱(bmm)을 씁니다.
진짜 환경 롤아웃은 후보 $P$ 개 × 시작 상태 $K$ 개, 모두 $P\cdot K$ 개의 진자를 동시에 돌립니다. 매 스텝 그림을 VAE 에 한꺼번에 넣고, 컨트롤러로 행동을 정하고, 각 진자를 한 스텝 움직인 뒤, MDN-RNN 으로 기억을 갱신합니다. 진짜 환경을 쓸 때 M 은 미래를 예측하는 데가 아니라 기억 $h_t$ 를 만드는 데 만 쓰입니다.
vae.encode(...)의 평균 $\mu$ 를 $z$ 로 씁니다. 행동을 정할 때는 잡음 없는 값이 낫습니다.h = state[0][0]: LSTM 상태 $(h, c)$ 중 $h$ 를, 층 축을 떼고 꺼냅니다. 행동 전의 기억 $h_t$ 입니다.-
한 세대 안의 모든 후보는 같은 시작 상태(같은
seeds)로 평가합니다. 후보 A 가 B 보다 나은 것이 “운 좋은 시작 상태” 때문이 아니라 매개변수 때문이도록 하는 것으로, 공통 난수common random numbers 라는 분산 줄이기 기법입니다. 세대마다는 새 시작 상태를 뽑아, 특정 시작 상태에만 맞춰지는 것을 막습니다.
꿈속 롤아웃
이제 진짜 환경을 빼 버립니다. M 이 다음 $z$ 를 뽑고, 보상도 M 의 보상 머리가 냅니다. 그림을 그리지도, VAE 를 돌리지도 않으므로 아주 빠르고, 수천 개를 GPU 에서 한 번에 돌릴 수 있습니다.
꿈의 첫 장면은 진짜 에피소드들의 첫 그림을 VAE 로 바꾼 $z$ 에서 고릅니다(z_starts). 그 뒤로는 모든 것이 상상입니다. 진짜 롤아웃과 비교하면 단 두 줄이 다릅니다.
보상이 환경 대신 r_hat 에서 오고, 다음 $z$ 가 VAE 대신 mdn_sample(..., tau) 에서 옵니다.
학습 루프
세대마다 후보 32개 × 시작 상태 $K$ 개(진짜 환경 4개, 꿈속 16개)를 돌려 평균 리턴을 적합도로 씁니다(원 논문은 후보 64개, 후보 하나당 롤아웃 16번을 썼습니다). 학습이 꿈속에서 이루어지더라도, 몇 세대마다(진짜 환경 학습은 5, 꿈속 학습은 10) 현재 평균 $m$ 을 진짜 환경 의 고정된 시작 상태 20개로 평가해 기록합니다. 이 평가값은 학습에 쓰지 않고, “꿈속 학습이 실제로 통하는가” 를 지켜보는 데만 씁니다.
결과: 진짜 환경 학습과 꿈속 학습
코드는 같은 V · M 위에서 컨트롤러를 네 번 학습합니다. (A) 진짜 환경에서 60세대(후보 하나당 에피소드 4개), (B) 꿈속에서 온도 τ = 0.1, 1.0, 1.5 로 각각 150세대(후보 하나당 꿈 16개). 코드는 세대 0 부터 세므로 실제 갱신은 61번 · 151번입니다(그래서 (A)의 에피소드 수는 61 × 32 × 4 = 7,808). 꿈은 그림을 그리지 않고 GPU 에서 한꺼번에 돌기 때문에 훨씬 싸서, 세대도 평가 횟수도 넉넉히 줄 수 있습니다.
$ python ch10_world_models.py장치: cuda 컨트롤러 매개변수 수: (32 + 256) × 1 + 1 = 289 기준선 | 무작위 행동 -1226.9 | 토크 0 -1251.6 [real] 세대 0 | 적합도 평균 -1328.2 최고 -1147.2 | σ 0.097 | 진짜 환경 평가(평균 m) -1210.7 [real] 세대 10 | 적합도 평균 -1086.7 최고 -820.0 | σ 0.085 | 진짜 환경 평가(평균 m) -776.0 … [real] 세대 60 | 적합도 평균 -580.4 최고 -321.1 | σ 0.086 | 진짜 환경 평가(평균 m) -301.7 (A) 진짜 환경 학습 356초 | 학습에 쓴 진짜 에피소드 7808개 (1,561,600 스텝) [dream τ=0.1] 세대 0 | 적합도 평균 -1258.8 최고 -1061.9 | σ 0.097 | 진짜 환경 평가(평균 m) -1184.1 … [dream τ=0.1] 세대 150 | 적합도 평균 -383.7 최고 -244.4 | σ 0.104 | 진짜 환경 평가(평균 m) -315.6 (B) 꿈속 학습 τ=0.1 174초 … [dream τ=1] 세대 150 | 적합도 평균 -334.8 최고 -204.7 | σ 0.104 | 진짜 환경 평가(평균 m) -278.6 (B) 꿈속 학습 τ=1 177초 … [dream τ=1.5] 세대 150 | 적합도 평균 -419.9 최고 -230.6 | σ 0.097 | 진짜 환경 평가(평균 m) -306.1 (B) 꿈속 학습 τ=1.5 176초 최종 평가 (진짜 환경: 고정 시작 상태 20개 평균 ± 표준편차, 꿈속: 학습 때와 같은 τ, 시작 상태 64개) real | 꿈속 리턴 -488.1 | 진짜 리턴 -301.7 ± 181.1 dream 0.1 | 꿈속 리턴 -268.0 | 진짜 리턴 -315.6 ± 197.2 dream 1 | 꿈속 리턴 -238.9 | 진짜 리턴 -278.6 ± 144.4 dream 1.5 | 꿈속 리턴 -289.6 | 진짜 리턴 -306.1 ± 203.7 그림 저장: figures
이 튜토리얼을 쓴 환경(노트북 GPU, 다른 학습과 GPU 를 나눠 씀)에서 전체 약 15분 걸렸습니다. 진짜 환경 학습이 356초, 꿈속 학습이 온도마다 약 175초입니다. 꿈속 학습은 세대가 2.5배, 후보당 평가가 4배 많은데도 절반의 시간에 끝났습니다. 진짜 환경 쪽은 GPU 가 있어도 진자 128개(후보 32 × 시작 상태 4)를 한 스텝씩 움직이고 그림을 그리는 파이썬 반복이 시간의 대부분을 차지하기 때문입니다. CPU(4스레드)만 쓰면 진짜 환경 한 세대에 약 26초, 꿈속 한 세대에 몇 초씩 걸려 전체 약 1시간이 걸립니다. 더 중요한 차이는 진짜 경험의 양 입니다. (A) 는 학습에 진짜 에피소드 7,808개(약 156만 스텝)를 썼고, (B) 는 8장에서 무작위로 모은 200 에피소드(4만 스텝) 말고는 진짜 환경을 학습에 전혀 쓰지 않았습니다(5 · 10세대마다의 평가는 지켜보기만 할 뿐 학습에 쓰지 않습니다).
학습 곡선
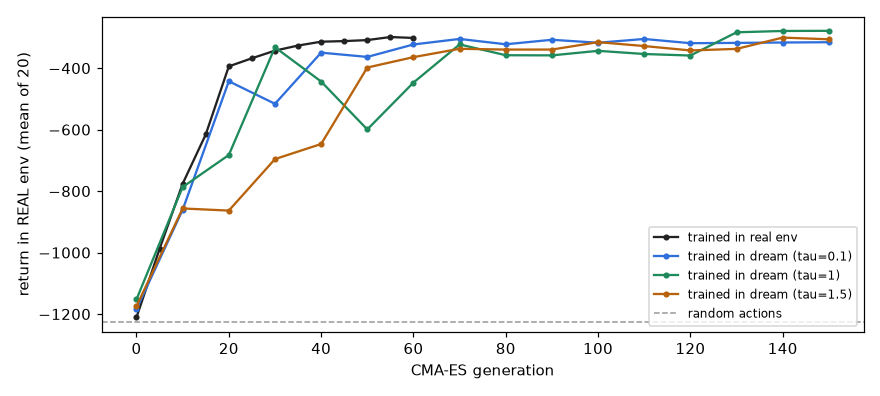
- 진짜 환경 학습(검정) 은 무작위 행동 수준(약 −1210)에서 출발해 60세대 만에 −302 까지 올라갑니다. 진짜 세상에서 직접 점수를 받으니 세대당 진도는 가장 빠릅니다. 선형 컨트롤러 289개 숫자만으로 그림을 보고 진자를 세우는 법을 배웠다는 뜻입니다.
- 꿈속 학습(색) 도 세 온도 모두 무작위 수준에서 출발해 150세대 뒤 −279 ~ −316 에 이릅니다. 진짜 환경에서 학습한 컨트롤러와 같은 수준입니다. 이 컨트롤러들은 학습하는 동안 진짜 진자를 한 번도 겪지 않았습니다. M 이 지어낸 세상에서만 연습했는데 그 실력이 진짜 세상에서도 통한 것입니다.
- τ = 1 곡선(초록)은 중간(50세대)에 크게 떨어졌다가 다시 오릅니다. 꿈속 점수 자체가 잡음이 많아 CMA-ES 의 평균이 한동안 엉뚱한 쪽으로 갔던 것입니다. 꿈이 무작위할수록 같은 후보도 평가할 때마다 점수가 달라지므로, 후보당 꿈을 넉넉히(여기서는 16개) 보고 평균을 내는 것이 중요합니다.
꿈속 리턴과 진짜 리턴
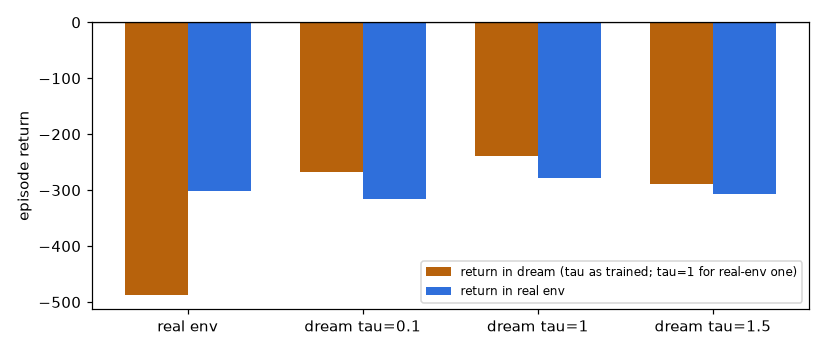
꿈속에서 학습한 세 컨트롤러는 모두 꿈속 리턴이 진짜 리턴보다 조금 좋습니다(τ = 0.1: −268 vs −316, τ = 1: −239 vs −279, τ = 1.5: −290 vs −306). 꿈이 실제보다 약간 낙관적이라는 뜻이고, 컨트롤러가 꿈의 작은 허점을 조금씩 이용하고 있다는 신호입니다. 이 실행에서는 그 차이가 τ 가 높을수록 줄었습니다(48 → 40 → 16).
거꾸로, 진짜 환경에서 학습한 컨트롤러는 꿈속(τ = 1)에서 −488 로 진짜(−302)보다 훨씬 못합니다. 꿈과 진짜는 같은 세상이 아니며, 한쪽에 맞춘 컨트롤러가 다른 쪽에서 그대로 통하지는 않습니다. 가능한 이유 하나는 9장에서 본 꺼진 차원 입니다. 진짜 롤아웃에서는 그림을 평균 $\mu$ 로 바꾸므로 꺼진 25개 차원이 늘 0 근처인데, τ = 1 의 꿈에서는 그 차원들이 $\Normal(0,1)$ 잡음으로 뽑힙니다. 진짜 환경에서만 학습한 컨트롤러는 그 차원들의 가중치를 정리할 이유가 없었으므로 꿈속에서는 잡음에 흔들리고, 꿈속에서 학습한 컨트롤러는 그 잡음을 무시하는 법을 배웠을 것입니다.
| 설정 (꿈속 학습) | 꿈속 리턴 | 진짜 리턴 |
|---|---|---|
| 위 실행: τ = 0.1 / 1 / 1.5, 150세대, 후보당 꿈 16개 | −268 / −239 / −290 | −316 / −279 / −306 |
| 난수만 바꿔 다시: τ = 0.1 / 1 / 1 / 1.5, 150세대, 꿈 16개 | −257 / −286 / −270 / −305 | −263 / −338 / −312 / −329 |
| 처음 시도: τ = 0.1 / 1 / 1.5, 60세대, 꿈 4개 | −507 / −338 / −892 | −568 / −381 / −854 |
결과를 정직하게 읽으려면 한 번의 실행만 믿어서는 안 됩니다. 위 표는 꿈속 학습 부분만 난수를 바꿔 몇 번 더 돌린 결과입니다. 150세대 · 꿈 16개 설정에서는 매번 진짜 리턴 −260 ~ −340 의 쓸 만한 컨트롤러가 나왔고, 꿈은 늘 6 ~ 52 만큼 낙관적이었습니다. 하지만 온도 사이의 차이는 실행마다 뒤바뀔 만큼 작아서, 이 진자에서 “어느 τ 가 가장 좋다” 고 말할 수는 없습니다. 마지막 줄은 이 튜토리얼을 준비하며 처음 돌린 설정(세대 60, 후보당 꿈 4개)으로, 세대도 평가도 모자라면 꿈속 학습이 훨씬 불안정하다는 것을 보여 줍니다. 그래서 기본 설정을 늘렸습니다.
꿈에서 배운 컨트롤러가 진짜 진자를 세우다
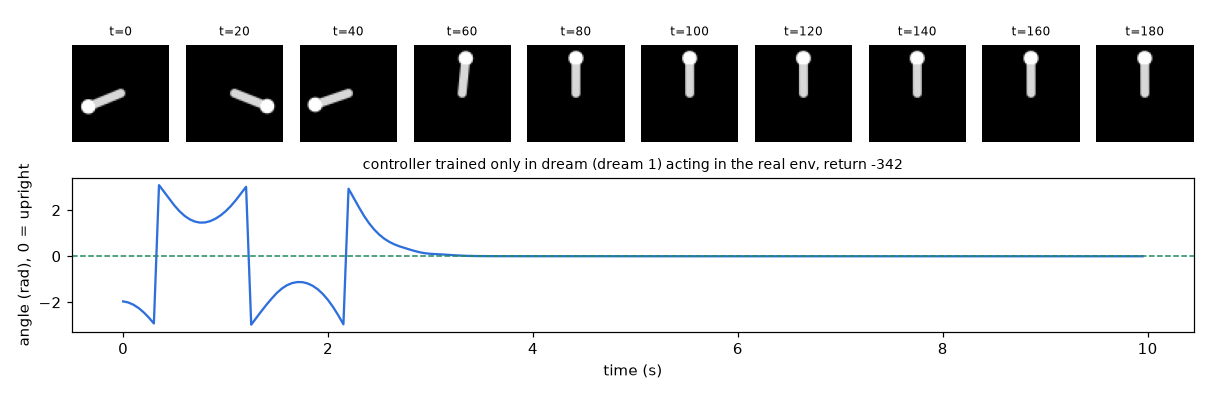
가장 좋은 꿈속 컨트롤러(τ = 1)가 진짜 진자를 다루는 모습입니다. 각도 그래프에서 값이 $+\pi$ 와 $-\pi$ 사이를 건너뛰는 곳은 진자가 맨 아래(매달린 자세)를 지나는 순간입니다. 컨트롤러는 처음 2초 남짓 동안 진자를 왼쪽 · 오른쪽으로 두 번 크게 흔들어 에너지를 모은 뒤(그네 타기), 세 번째에 꼭대기까지 올려 약 3초부터 끝(10초)까지 똑바로 세워 둡니다. 토크가 약해 한 번에 올릴 수 없다는 진자 문제의 핵심을, 그림만 보고 꿈속에서 스스로 찾아낸 것입니다. 이 시작 상태에서의 리턴은 −342 입니다. 리턴이 0 에 가깝지 않은 것은 흔들어 올리는 처음 3초 동안 각도 벌점을 크게 받기 때문이고, 세운 뒤의 벌점은 거의 0 입니다.
온도와 꿈속 속임수
꿈속 학습에는 근본적인 위험이 있습니다. 컨트롤러는 리턴을 높이는 일이라면 무엇이든 찾아냅니다. M 이 어떤 상황에서 틀린 예측을 한다면, 예를 들어 “이렇게 토크를 주면 진자가 마법처럼 위에 멈춘다” 고 잘못 믿는다면, 컨트롤러는 진짜 물리를 배우는 대신 그 오류를 노리는 법 을 배웁니다. 이것을 모델 착취model exploitation, 원 논문의 표현으로는 꿈속에서의 “속임수(cheating)” 라고 합니다. 꿈속 점수는 높은데 진짜 점수는 낮은 컨트롤러가 그 증상입니다.
Ha & Schmidhuber 는 VizDoom 실험에서 이것을 직접 보였습니다. 온도를 낮게(예: 0.1) 두고 꿈속에서 학습하면 꿈속 점수는 아주 높았지만(2086 ± 140, 만점 2100) 진짜 게임에서는 거의 버티지 못했습니다(193 ± 58). 거의 결정적인 꿈에서는 M 이 혼합 분포 가운데 “불덩이가 만들어져 날아오는” 성분으로 넘어가지 못해(모드 붕괴), 꿈속 괴물이 아예 불덩이를 쏘지 않았기 때문입니다. 위험이 없는 꿈에서는 어떤 컨트롤러든 거의 만점을 받지만 배운 것은 없습니다. 온도를 1.15 로 높여 꿈을 진짜보다 더 불확실하고 어렵게 만들자, M 의 허점을 노리는 속임수도 매번 통하지는 않게 되어 컨트롤러는 어떤 미래가 와도 버티는 행동을 배웠고, 그것이 진짜 게임에서도 통했습니다(1092 ± 556).
우리 진자에서는 온도가 그만큼 극적인 차이를 만들지 않았습니다. 꿈은 모든 온도에서 조금 낙관적이었지만, 낮은 온도에서도 꿈속 학습이 진짜에서 통했습니다. 이유를 짐작해 볼 수 있습니다.
- 세상이 단순하다. 진자의 물리는 결정적이고 매끄러워서 M 이 거의 정확히 배웁니다(9장: 25 스텝 뒤 오차 8° 안쪽). 허점 자체가 적습니다.
- 데이터가 상태 공간을 고르게 덮는다. 에피소드가 무작위 각도에서 시작하므로, 꼭대기 근처의 그림도 데이터에 꽤 들어 있습니다.
- 컨트롤러가 작다. 선형 컨트롤러는 M 의 미묘한 허점을 정밀하게 노릴 만큼 표현력이 크지 않습니다.
VizDoom 은 그 반대였습니다. 장면이 복잡하고, 불덩이가 날아오는 방식이 무작위이며, 무작위 행동으로는 겪지 못하는 상황이 많습니다. 온도의 효과는 “모델이 틀리기 쉬운 세상” 일수록 커집니다. 직접 확인하고 싶다면 아래 “직접 바꿔 보기” 처럼 M 을 적은 데이터로 학습해 일부러 허점을 늘린 뒤 같은 실험을 해 보세요.
꿈속 학습의 품질은 “꿈이 진짜와 얼마나 비슷한가” 만이 아니라 “컨트롤러가 꿈의 허점을 이용할 수 있는가” 에 달려 있습니다. 온도를 높여 꿈을 불확실하게 하는 것은 “모델이 모르는 곳을 믿지 마라” 는 신호를 주는 가장 간단한 방법이고, 7장의 앙상블(PETS)이 불확실성을 다루는 것과 같은 목적입니다. 모델이 틀리는 곳 자체를 줄이는 방법은 다음 절의 반복 학습입니다.
반복 학습
이 장의 V · M 은 무작위 행동 으로 모은 데이터로만 학습했습니다. 그런데 좋은 컨트롤러는 무작위 행동이 거의 가지 않는 곳으로 갑니다. 진자라면 “꼭대기에서 몇 초 동안(백 스텝 넘게) 거의 멈춘 채 버티기” 가 그렇습니다. 그런 상태가 학습 데이터에 드물면 M 은 거기서 틀리기 쉽고, 위에서 본 모델 착취가 바로 그런 곳에서 일어납니다. CarRacing 처럼 무작위 행동으로는 트랙 끝까지 가 보지도 못하는 과제에서는 더 심각합니다.
Ha & Schmidhuber 는 그래서 다음과 같은 반복 학습 절차를 제안했습니다. (원문은 M 과 C 만 말합니다. 아래는 이 튜토리얼의 V · M · C 에 맞춰 조금 풀어 쓴 것이고, 탐험 잡음과 V 의 재학습은 덧붙인 것입니다.)
- M 과 C 를 무작위로 초기화한다.
- 지금의 C (와 약간의 탐험 잡음)로 진짜 환경에서 에피소드를 모아 데이터에 더한다.
- 쌓인 데이터로 V · M 을 다시 학습한다.
- 새 M 의 꿈속에서 C 를 다시 학습한다.
- 과제가 풀릴 때까지 2 로 돌아간다.
이렇게 하면 “컨트롤러가 가는 곳” 의 데이터가 점점 늘어나 M 이 그곳을 정확히 배우고, 속임수가 통하던 허점이 메워집니다. 7장에서 모델 기반 강화학습이 데이터 모으기와 모델 학습을
번갈아 한 것과 같은 구조입니다. 이 장의 코드로 직접 해 보려면 8장의 collect_pixel_episodes(n, policy=...) 에 컨트롤러를 정책으로 넘겨 에피소드를 모으고(정책은 에피소드마다 LSTM 기억을 0 으로 되돌려야 합니다),
그 데이터를 8장의 데이터와 합쳐 train_vae · train_mdnrnn 을 다시 돌린 뒤, 이 장의 train_controller("dream", ...) 를 다시 부르면 됩니다.
11 · 12장의 PlaNet · Dreamer 는 이 반복을 아예 학습 루프의 기본 구조로 삼습니다.
World Models 의 한계
- V 는 과제를 모른다. VAE 는 그림을 되살리는 데 필요한 것을 배울 뿐, 보상과 관련 있는 것을 배우지 않습니다. 작은 공처럼 중요하지만 픽셀 수가 적은 물체는 무시하고, 배경처럼 중요하지 않지만 픽셀이 많은 것에 용량을 씁니다.
- V · M · C 를 따로 학습한다. M 의 오차가 V 로, C 의 필요가 M 으로 전달되지 않습니다. 셋을 함께 학습하면 서로에게 맞춰질 수 있습니다.
- C 가 작아야만 한다. CMA-ES 는 매개변수가 수천 개를 넘으면 급격히 느려집니다(공분산 학습률이 $1/n^2$ 로 줄어드는 것을 보았습니다. 공분산을 배우지 않는 단순한 진화 전략은 더 큰 신경망에도 쓰이지만, 표본이 많이 듭니다). 복잡한 행동에는 큰 정책이 필요합니다.
- 꿈속에서 기울기를 쓰지 않는다. M 은 미분 가능한 신경망인데도, C 는 점수만 보고 배웁니다. 꿈 전체를 미분해 정책을 직접 개선할 수 있다면 훨씬 효율적일 것입니다.
11장의 RSSM 은 V 와 M 을 하나의 확률 모델로 합쳐 함께 학습하고, 12장의 Dreamer 는 그 모델의 꿈을 통째로 미분해 큰 신경망 정책을 학습합니다. 이 두 장에서 위의 한계들이 하나씩 풀립니다.
- World Models = V(VAE) + M(MDN-RNN) + C(작은 컨트롤러). 큰 V · M 은 보상 없이 자기 지도 학습으로, 작은 C 는 리턴만 보고 진화 전략으로 배운다.
- 진화 전략의 기울기: $\nabla_\theta\E[F(\theta+\sigma\epsilon)] = \frac{1}{\sigma}\E[F(\theta+\sigma\epsilon)\epsilon]$. $F$ 의 값만으로 계산되며, 로그 미분 트릭에서 나온다.
- CMA-ES 는 $\Normal(m, \sigma^2C)$ 에서 뽑고, 상위 후보의 가중 평균으로 $m$ 을, 잘된 스텝들의 가중 공분산(최대우도)과 진화 경로로 $C$ 를, 경로 길이로 $\sigma$ 를 갱신한다.
- 꿈속 롤아웃은 진짜 환경 없이 M 이 다음 $z$ 와 보상을 지어낸다. 빠르고 병렬로 돌릴 수 있지만, 모델의 오류를 컨트롤러가 이용할 수 있다(모델 착취).
- 온도 τ 를 높여 꿈을 불확실하게 만들면 착취가 어려워진다. 데이터가 부족한 곳은 반복 학습으로 메운다.
확인 문제
$z$ 가 64차원, LSTM 은닉이 512, 행동이 2차원이라면 선형 컨트롤러의 매개변수는 몇 개입니까?
답 보기
$(64 + 512) \times 2 + 2 = 1154$ 개.
$F(x) = -x^2$, $\theta = 1$, $\sigma = 0.5$ 일 때 $\frac{1}{\sigma}\E[F(\theta + \sigma\epsilon)\epsilon]$ 을 계산하고, $J(\theta) = \E[F(\theta+\sigma\epsilon)]$ 를 직접 미분한 값과 비교하세요.
답 보기
$-(1 + 0.5\epsilon)^2\epsilon = -(\epsilon + \epsilon^2 + 0.25\epsilon^3)$ 이므로 기댓값은 $-(0 + 1 + 0) = -1$, $\frac{1}{0.5}\times(-1) = -2$. 직접: $J(\theta) = -(\theta^2 + \sigma^2)$, $J'(1) = -2$. 같습니다.
가중치가 $(0.5,\ 0.3,\ 0.2)$ 이면 $\mu_{\text{eff}}$ 는?
답 보기
$1/(0.25 + 0.09 + 0.04) = 1/0.38 \approx 2.63$. 부모는 셋이지만 실제로는 2.6개 정도의 몫을 합니다.
여러 세대 동안 평균이 앞으로 갔다 뒤로 갔다를 되풀이했다면 진화 경로 $p_\sigma$ 의 길이와 $\sigma$ 는 어떻게 될까요?
답 보기
반대 방향 스텝들이 서로 상쇄되어 $\lVert p_\sigma\rVert$ 가 기대 길이보다 짧아집니다. 괄호 안이 음수가 되어 $\sigma$ 가 줄어듭니다. 최적점을 넘나들 만큼 스텝이 컸다는 신호이기 때문입니다.
꿈속 리턴은 매우 높은데 진짜 리턴은 낮은 컨트롤러를 얻었습니다. 원인으로 의심할 것 두 가지와 대처법을 말해 보세요.
답 보기
(1) 학습 데이터에 없던 상태(예: 꼭대기에서 오래 버티는 상태)에서 M 의 예측이 틀렸고, 컨트롤러가 그 틀린 곳으로 가는 법을 배웠다 → 그 컨트롤러로 새 데이터를 모아 M 을 다시 학습(반복 학습). (2) 꿈이 너무 결정적이라(τ 가 낮음) 모델의 작은 오류가 늘 똑같이 재현되어 이용당했다 → τ 를 높여 꿈을 불확실하게 만든다.
(1) --dream-rollouts 4 --dream-generations 60 으로 줄여 꿈속 학습이 얼마나 불안정해지는지, (2) --taus 0.1,1.0,2.0 이나 --popsize 64 로 바꾸면
그림 10-3 · 10-4 가 어떻게 달라지는지 비교해 보세요. (3) 모델 착취를 일부러 일으켜 보려면 8장을 --episodes 20 으로, 9장을 그 데이터로 다시 학습해 M 의 허점을 늘린 뒤
이 장을 돌려 보세요. 꿈속 리턴과 진짜 리턴의 차이가 τ 에 따라 어떻게 변하는지가 관전 포인트입니다.
(4) 컨트롤러를 은닉 16개짜리 작은 MLP 로 바꾸면(매개변수 수가 늘어남) CMA-ES 가 얼마나 느려지는지도 재 볼 만합니다.
World Models 는 “모델 안에서 상상으로 배운다” 는 것을 보여 주었지만, V · M · C 를 따로 학습하고, 컨트롤러는 작아야만 하며, 꿈의 품질은 M 의 예측력에 전적으로 달려 있었습니다. 다음 장의 RSSM 은 눈과 기억을 하나의 확률 모델로 합쳐 함께 학습하고, PlaNet 은 그 모델 안에서 매 스텝 계획을 세웁니다.