RSSM 과 PlaNet
10장의 World Models 는 “눈(VAE)” 과 “기억(MDN-RNN)” 을 따로따로 학습했습니다. 이 장에서는 둘을 하나의 모델 로 합쳐 처음부터 끝까지 함께 학습하는 RSSM(Recurrent State-Space Model, 순환 상태 공간 모델) 을 만들고, 그 모델의 상상 속에서 행동을 계획 하는 PlaNet 으로 64×64 그림만 보고 진자를 세워 봅니다. 이 장의 중심에는 RSSM 의 학습 목표인 순차 ELBO 가 있습니다. 8장의 ELBO 를 시간축으로 늘린 것으로, 처음부터 한 줄씩 유도합니다.
- 그림 한 장으로는 속도를 알 수 없는 문제(부분 관측)와, 그것을 푸는 잠재 상태 공간 모델
- 결정적 RNN 만 쓸 때와 확률적 상태만 쓸 때의 한계, 그리고 둘을 합친 RSSM 의 다섯 부품
- RSSM 의 학습 목표 순차 ELBO 를 결합 분포의 인수분해부터 젠센 부등식까지 한 줄씩 유도하기
- 각 항(재구성 · 보상 · KL)의 뜻과 자유 내트(free nats), 잠재 과대 예측(overshooting)의 개념
- 잠재 공간에서 CEM 으로 계획 하기(PlaNet), 전체 학습 고리, PyTorch 구현과 실제 결과
지금까지 온 길과 남은 문제
잠깐 지도를 펼쳐 봅시다. 6 · 7장에서는 진자의 상태를 숫자 3개 $[\cos\theta, \sin\theta, \dot\theta]$ 로 정확히 받았습니다. 그래서 World Model 은 “이 숫자 3개와 토크가 주어지면 다음 숫자 3개는?” 만 배우면 되었고, 7장의 CEM 계획으로 진자를 세울 수 있었습니다.
8장부터는 진자를 64×64 그림으로만 봅니다. 10장의 World Models 는 이를 세 부품으로 풀었습니다.
- V (VAE): 그림 한 장을 작은 잠재 벡터 $z_t$ 로 압축. 그림마다 따로 학습.
- M (MDN-RNN): $z_t$ 들의 시간 흐름을 예측. V 를 다 학습한 뒤에 따로 학습.
- C (컨트롤러): $[z_t, h_t]$ 를 보고 행동을 고르는 작은 정책. CMA-ES 로 학습.
이 방식에는 아쉬운 점이 세 가지 있습니다.
- V 는 무엇이 중요한지 모릅니다. VAE 는 “그림을 잘 복원하라” 는 목표만 받으므로, 미래를 예측하거나 보상을 판단하는 데 필요한 정보를 골라 담는다는 보장이 없습니다. 압축은 압축대로, 예측은 예측대로 따로 놉니다.
- 학습이 두 단계로 나뉩니다. M 이 아무리 애써도 V 가 이미 정해 둔 $z$ 를 바꿀 수 없습니다. “예측하기 좋은 표현” 을 찾도록 둘이 함께 조정될 길이 막혀 있습니다.
- 계획이 없습니다. C 는 매 순간 반사적으로 행동을 고릅니다. 7장에서 보았듯 모델이 있다면 앞을 내다보며 계획할 수도 있습니다.
2019년 Hafner 외는 논문 Learning Latent Dynamics for Planning from Pixels(ICML 2019)에서 이 문제들을 한꺼번에 푸는 PlaNetDeep Planning Network 을 발표했습니다. 핵심 부품이 이 장의 주인공인 RSSM 이고, RSSM 은 이후 Dreamer(12장) 계열 전체의 뼈대가 됩니다.
그림 한 장으로는 속도를 알 수 없다
아래 그림을 보세요. 위 줄과 아래 줄의 첫 그림은 완전히 같은 그림 입니다. 하지만 위 진자는 시계 방향으로, 아래 진자는 반시계 방향으로 돌고 있었기 때문에 다음 순간의 그림이 다릅니다.
5장에서 배운 말로 하면, 그림을 보는 진자는 부분 관측 마르코프 결정 과정POMDP 입니다. 관측 $o_t$ 만으로는 마르코프 성질(“지금만 알면 미래 예측에 충분하다”)이 성립하지 않습니다. 해결책은 지금까지 본 것을 모두 요약한 믿음 상태(belief state) 를 들고 다니는 것입니다. 진자라면 “최근 두세 장면의 각도 변화” 만 기억해도 속도를 추정할 수 있습니다. RSSM 은 이 믿음 상태를 신경망으로 학습합니다.
잠재 상태 공간 모델
상태 공간 모델state-space model, SSM 은 오래된 아이디어입니다. 세상에는 우리가 직접 볼 수 없는 숨은 상태 $s_t$ 가 있고, 그 상태가 시간에 따라 바뀌며(전이), 우리는 그 상태가 만들어 낸 관측 $o_t$ 만 본다고 가정합니다. 로켓 궤도 추정에 쓰인 칼만 필터(Kalman filter)가 대표적인 예입니다. 수식으로는 세 가지 분포로 적습니다.
$$ \begin{aligned} \text{전이(transition)}&:\quad s_t \sim p(s_t \mid s_{t-1}, a_{t-1}) \\ \text{관측(observation)}&:\quad o_t \sim p(o_t \mid s_t) \\ \text{보상(reward)}&:\quad r_t \sim p(r_t \mid s_t) \end{aligned} $$“$\sim$” 는 “이 분포에서 뽑힌다” 는 뜻입니다(0장 표). 칼만 필터에서는 이 분포들이 사람이 적어 준 선형 식이었지만, 잠재 상태 공간 모델 에서는 상태 $s_t$ 가 무엇을 뜻하는지조차 정하지 않고 신경망이 스스로 만들게 합니다. “잠재(latent)” 는 이렇게 데이터에 직접 나타나지 않고 모델 안에서만 존재하는 변수를 부르는 말입니다(8장).
5장에서는 상태 $s_t$ 에서 행동 $a_t$ 를 했을 때 받는 보상을 $r_t$ 라고 적었습니다. 이 장에서는 PlaNet · Dreamer 논문을 따라 상태 $s_t$ 에 도착하며 받은 보상(즉 직전 행동 $a_{t-1}$ 의 결과)을 $r_t$ 라고 적고, 상태 $s_t$ 에서 예측합니다. 5장의 표기로는 $r_{t-1}$ 에 해당합니다. 같은 보상인데 첨자가 하나 밀렸을 뿐입니다. 행동도 마찬가지로 $a_{t-1}$ 이 $s_{t-1}$ 에서 $s_t$ 로 가는 행동입니다.
| 시각 | 그림 | 그 그림에 오기 직전 행동 | 그 그림에 도착하며 받은 보상 |
|---|---|---|---|
| $t = 0$ | $o_0$ (첫 그림) | 없음 (0 으로 채움) | 없음 (학습에서 뺌) |
| $t = 1$ | $o_1$ | $a_0$ | $r_1$ |
| $t = 2$ | $o_2$ | $a_1$ | $r_2$ |
| ⋮ | ⋮ | ⋮ | ⋮ |
코드의 리플레이 버퍼도 이 표대로 저장합니다(obs[t], prev_action[t], reward[t], first[t]).
이렇게 맞춰 두면 “시각 $t$ 의 칸 하나에 그 시각에 필요한 모든 것” 이 들어 있어 코드가 단순해집니다.
필터링: 지금까지 본 것으로 지금 상태 추측하기
잠재 상태를 쓰려면 반대 방향의 계산도 필요합니다. 지금까지 본 그림 $o_{1:t}$ 와 한 행동 $a_{0:t-1}$ 이 주어졌을 때 지금 상태 $s_t$ 가 무엇일지 추측하는 일, 즉 $p(s_t \mid o_{1:t}, a_{0:t-1})$ 를 구하는 일을 필터링filtering 이라고 합니다. 진짜 분포는 베이즈 정리(2장)로 정의되지만, 신경망 모델에서는 적분이 불가능해 직접 계산할 수 없습니다. 그래서 8장의 VAE 처럼 추론 신경망 $q$ 로 근사 합니다. 이것이 뒤에 나올 “사후 모델” 입니다.
두 가지 단순한 시도와 그 한계
잠재 상태 $s_t$ 를 신경망으로 어떻게 만들까요? 먼저 떠오르는 두 가지 방법을 보고, 왜 둘 다 부족한지 살펴봅니다.
시도 1: 결정적 RNN 만 쓰기
9장의 RNN 처럼 은닉 상태를 $h_t = f(h_{t-1}, a_{t-1}, o_{t-1})$ 로 계산하고, $h_t$ 에서 다음 그림을 예측합니다(그림 11-2 가). 학습할 때는 진짜 그림을 계속 넣어 주므로 잘 동작합니다. 문제는 계획할 때 입니다. 계획은 “아직 보지 못한 미래” 를 상상해야 하므로 그림 입력 없이 $h$ 만 굴려야 하는데,
- 결정적 모델은 같은 입력에 대해 미래를 딱 하나만 내놓습니다. 미래가 여러 갈래일 수 있을 때(예: 막대가 꼭대기에서 왼쪽으로 넘어갈지 오른쪽으로 넘어갈지) 제곱 오차를 줄이려고 그 갈래들의 평균 을 예측하게 되고, 평균은 실제로는 일어나지 않는 흐릿한 미래입니다.
- 학습 때는 늘 진짜 그림이 들어오다가 계획 때만 그림 없이 굴리니, 학습과 사용 상황이 어긋납니다.
시도 2: 확률적 상태만 쓰기
반대로 상태를 모두 확률 변수로 두고 $s_t \sim p(s_t \mid s_{t-1}, a_{t-1})$ 처럼 매 스텝 분포에서 뽑는 모델입니다(그림 11-2 나). 여러 갈래의 미래를 표현할 수 있고, 8장의 VAE 처럼 ELBO 로 학습할 수 있습니다. 그런데 PlaNet 논문은 이 방식의 약점을 지적합니다. 모든 정보가 매 스텝 뽑기를 거쳐야 다음 스텝으로 넘어가므로, 여러 스텝 전의 정보를 정확히 전달하기가 어렵습니다. 전화기 게임(귓속말 전달)처럼 매번 잡음이 조금씩 섞이는 셈입니다.
해결: 둘을 합친 RSSM
RSSM 은 상태를 두 부분으로 나눕니다(그림 11-2 다).
- 결정 상태 $h_t$: GRU(9장)로 계산하는 결정적 벡터. 잡음 없이 정보를 오래 전달하는 기억 담당.
- 확률 상태 $z_t$: 매 스텝 가우시안에서 뽑는 벡터. 아직 모르는 것, 여러 갈래의 미래를 표현하는 불확실성 담당.
모델의 상태는 이 둘을 붙인 $s_t = (h_t, z_t)$ 입니다. 세 방식을 표로 비교하면 다음과 같습니다.
| 방식 | 오래 기억하기 | 여러 갈래 미래 | ELBO 로 학습 |
|---|---|---|---|
| (가) 결정적 RNN | 잘함 | 못함 (평균을 예측) | 불가 (잠재 변수가 없음) |
| (나) 확률적 SSM | 약함 (매 스텝 잡음) | 잘함 | 가능 |
| (다) RSSM | 잘함 ($h$) | 잘함 ($z$) | 가능 |
RSSM 의 다섯 부품
RSSM 을 시간축으로 펼친 그림부터 보겠습니다. 실선은 생성 모델 $p_\theta$ (상상만으로도 계산할 수 있는 길), 점선은 추론 모델 $q_\phi$ (그림을 보고 상태를 고쳐 잡는 길)입니다.
부품을 하나씩 식으로 적으면 다음 다섯 가지입니다.
| 부품 | 식 | 하는 일 | 코드 |
|---|---|---|---|
| ① 결정 상태 모델 | $h_t = f_\theta(h_{t-1}, z_{t-1}, a_{t-1})$ | 기억을 한 스텝 앞으로 (GRU) | RSSM.img_step 앞부분 |
| ② 사전(전이) 모델 | $p_\theta(z_t \mid h_t)$ | 그림을 보기 전 에 $z_t$ 를 예측 | prior_net |
| ③ 사후(표현) 모델 | $q_\phi(z_t \mid h_t, o_t)$ | 그림을 본 뒤 $z_t$ 를 고쳐 잡음 | Encoder + post_net |
| ④ 관측 모델(디코더) | $p_\theta(o_t \mid h_t, z_t)$ | 상태에서 그림을 다시 그림 | Decoder |
| ⑤ 보상 모델 | $p_\theta(r_t \mid h_t, z_t)$ | 상태에서 보상을 예측 | WorldModel.reward |
①, ②, ④, ⑤ 는 그림 없이도 계산할 수 있는 생성 모델 이고, ③ 만 그림을 봅니다. 그래서 학습이 끝나면 ① → ② 만 반복해서 그림 없이 미래를 상상할 수 있습니다. 이것이 World Model 의 “꿈” 입니다.
분포의 모양: 대각 가우시안
사전과 사후는 모두 차원마다 독립인 대각 가우시안(2장)입니다. 신경망이 평균 $\mu$ 와 표준편차 $\sigma$ 를 내놓습니다.
$$ p_\theta(z_t \mid h_t) = \Normal\!\big(z_t;\ \mu_\theta(h_t),\ \diag(\sigma_\theta(h_t)^2)\big),\qquad q_\phi(z_t \mid h_t, o_t) = \Normal\!\big(z_t;\ \mu_\phi(h_t, e_t),\ \diag(\sigma_\phi(h_t, e_t)^2)\big) $$여기서 $e_t = \mathrm{enc}_\phi(o_t)$ 는 합성곱 인코더가 그림에서 뽑은 특징 벡터(1024개 숫자)입니다. 표준편차는 늘 양수여야 하므로, 신경망 출력 $x$ 를 그대로 쓰지 않고 softplussoftplus 를 거친 뒤 최솟값을 더합니다.
F.softplus(std) + self.min_std 입니다. $\sigma_{\min} = 0.1$ 은 분포가 한 점으로 쪼그라들지 않게 하는 바닥값입니다.결정 상태 모델: GRU 다시 보기
① 은 9장에서 본 GRU 셀을 씁니다. 먼저 $[z_{t-1}, a_{t-1}]$ 을 작은 선형층과 ELU 활성화(ELU: $x \gt 0$ 이면 $x$, $x \le 0$ 이면 $e^{x} - 1$. ReLU 와 비슷하지만 음수 쪽이 매끄럽게 $-1$ 로 다가가고, 그 기울기 $e^{x}$ 는 작아질 뿐 ReLU 처럼 정확히 0 이 되지는 않습니다)로 200차원 입력 $x_t$ 로 바꾸고, GRU 가 이전 기억 $h_{t-1}$ 과 섞습니다.
PyTorch 의 nn.GRUCell 이 계산하는 식은 다음과 같습니다($\odot$ 는 원소별 곱).
9장의 식과 같은 구조이고 표기만 조금 다릅니다. $r$ 은 보상에 쓰므로 리셋 게이트를 $\rho_t$ 로, 후보 $\tilde h_t$ 를 PyTorch 의 이름대로 $n_t$ 로 적었고, 리셋 게이트는 $h_{t-1}$ 에 먼저 곱하지 않고 $U_n h_{t-1} + b'_n$ 을 계산한 뒤에 곱합니다(9장 괄호 설명의 ②). 갱신 게이트 $u_t$ 의 방향은 9장과 같습니다. 마지막 줄이 핵심입니다. $u_t$ 가 1 에 가까운 칸은 옛 기억을 거의 그대로 넘기므로, 정보가 잡음 없이 여러 스텝을 건너갈 수 있습니다. “시도 2” 의 약점(매 스텝 잡음)을 RSSM 이 피하는 이유가 바로 이 길입니다.
코드: RSSM
코드에 나오는 mlp(입력, 너비, 출력, layers=n) 은 (선형층 → ELU) 를 n 번 쌓고 마지막에 선형층을 하나 더 붙인 작은 신경망을 만드는 도우미 함수입니다(파일 앞쪽에 정의되어 있습니다).
img_step: “눈을 감고” 한 스텝. ① GRU 로 $h_t$ 를 만들고 ② 사전 $p(z_t \mid h_t)$ 에서 $z_t$ 를 뽑습니다.mean + std * torch.randn_like(std)는 8장의 재매개변수화 입니다. 뽑는 과정을 “고정된 잡음 $\epsilon \sim \Normal(0, I)$ 에 표준편차를 곱하고 평균을 더하는 계산” 으로 바꿔, $\mu$ 와 $\sigma$ 로 기울기가 흐르게 합니다. 12장에서 이 성질이 결정적으로 중요해집니다.obs_step: “눈을 뜨고” 한 스텝. 먼저img_step으로 $h_t$ 와 사전을 만든 뒤, 같은 $h_t$ 에 그림 특징 $e_t$ 를 붙여 사후 $q(z_t \mid h_t, o_t)$ 를 만들고 거기서 $z_t$ 를 뽑습니다. 다음 스텝으로 넘기는 것은 사후에서 뽑은 $z_t$ 입니다(그림을 봤으니 더 정확한 쪽을 씁니다).observe: 시퀀스 전체에obs_step을 시간 순서대로 적용합니다. $h_t$ 가 $h_{t-1}$ 에 의존하므로 시간축은 반드시 차례로 돌아야 합니다(뒤의 “시간축 펼치기” 참고).
학습 목표: 순차 ELBO 유도하기
이제 이 장의 중심입니다. RSSM 의 모든 부품은 하나의 목표 로 함께 학습됩니다. 8장에서 그림 한 장 $x$ 에 대해 $\log p(x) \ge \text{ELBO}$ 를 유도했던 것을 기억하나요? 여기서는 그림 한 장 대신 그림과 보상의 시퀀스 전체 의 로그 확률을 키우고 싶습니다.
$$ \max_{\theta,\phi}\ \log p_\theta(o_{1:T},\ r_{1:T} \mid a_{0:T-1}) $$즉 “이 행동들을 했을 때 실제로 본 그림과 받은 보상이 나올 확률” 이 높은 모델을 찾는 최대우도(2장)입니다. 이 확률을 직접 계산할 수 없어서 하한(아래 경계, ELBO)을 대신 키우는데, 그 하한을 처음부터 유도해 봅시다. 단계는 다음과 같습니다.
- 결합 분포를 시간별 부품의 곱으로 인수분해 합니다.
- 잠재 변수를 적분해 없애는 주변화 로 로그 확률을 적습니다.
- 추론 분포 $q$ 를 곱하고 나눠 기댓값 꼴로 만들고 젠센 부등식 을 씁니다.
- 로그를 합으로 풀고, 기댓값을 시간별로 분리 해 재구성 · 보상 · KL 항을 얻습니다.
아래에서는 식이 너무 길어지지 않도록, 행동 $a_{0:T-1}$ 은 늘 주어진 값이라 조건에서 생략하고 $p(\cdot)$ 처럼 적겠습니다. 또 $h_t$ 는 $z_{1:t-1}$ 과 행동으로부터 GRU 가 계산 하는 값(확률 변수가 아님)이라는 점을 기억하세요. 확률 변수는 $z_{1:T}$ 뿐입니다. 맨 처음의 $h_0$, $z_0$ 은 0 벡터로 둡니다. 식을 간단히 하려고 합을 $t = 1$ 부터 적지만, 코드는 첫 그림 $o_0$ 도 “직전 행동 0, $h = z = 0$ 에서 출발한 한 칸” 으로 똑같이 다뤄 재구성 · KL 항에 넣습니다(보상 항만 $t = 0$ 을 뺍니다). 합이 한 칸 더 길어질 뿐 유도는 그대로입니다.
1단계: 결합 분포의 인수분해
prior_net, Decoder, reward 입니다.추론 모델 $q$ 도 같은 방식으로 시간별 곱으로 정의합니다. 이것은 유도가 아니라 우리가 고른 설계 입니다. 시각 $t$ 의 $z_t$ 를 추측할 때 지금까지의 요약 $h_t$ 와 지금 그림 $o_t$ 를 봅니다(미래 그림은 보지 않는 “필터링” 형태).
$$ q(z_{1:T} \mid o_{1:T}) = \prod_{t=1}^{T} q(z_t \mid h_t, o_t) $$
여기서 $h_t$ 는 사후에서 뽑은 $z_{1:t-1}$ 로 계산한 값입니다. 코드의 observe 가 바로 이 분포에서 $z_1, z_2, \dots$ 를 차례로 뽑는 과정입니다.
2 · 3단계: 주변화, 그리고 젠센 부등식
4단계: 기댓값을 시간별로 쪼개 KL 만들기
마지막 줄의 기댓값 $\E_q$ 는 $z_{1:T}$ 전체에 대한 것입니다. 그런데 시각 $t$ 의 항들은 $z_{1:t}$ 에만 의존합니다($h_t$ 는 $z_{1:t-1}$ 로, 나머지는 $z_t$ 로 정해지니까요). 필요 없는 변수는 기댓값에서 빠집니다.
세 조각을 모으면 RSSM 의 학습 목표가 완성됩니다.
학습은 이 하한을 키우는 것, 즉 코드에서는 그 음수인 손실 = 재구성 손실 + 보상 손실 + KL 을 줄이는 것입니다.
8장 VAE 의 ELBO 와 나란히 놓아 보세요. VAE 는 “재구성 − KL(사후 ‖ 고정된 표준 정규 분포)” 였습니다. 순차 ELBO 는 그것을 시각마다 더한 것인데, KL 의 상대가 고정된 $\Normal(0, I)$ 가 아니라 과거로부터 예측한 사전 $p(z_t \mid h_t)$ 입니다. 이 차이가 결정적입니다. VAE 의 KL 은 그저 잠재 공간을 정돈하는 역할이었지만, 순차 ELBO 의 KL 은 “과거만 보고도 지금의 잠재 상태를 맞혀라”, 즉 동역학을 배워라 는 학습 신호입니다. 사전 모델(②)이 학습되는 유일한 통로가 이 KL 항입니다.
하한과 진짜 값의 차이
젠센 부등식에서 잃어버린 차이는 정확히 얼마일까요? 8장과 같은 계산으로 확인할 수 있습니다.
기댓값은 표본 하나로 어림한다
순차 ELBO 의 기댓값 $\E_q$ 는 여전히 적분입니다. 실제로는 2장의 몬테카를로 추정 으로, 시퀀스마다 사후에서 $z_1, \dots, z_T$ 를 한 번 뽑아 그 값으로 계산합니다. 배치에 시퀀스가 50개 있으니 평균을 내면 잡음이 줄어듭니다. 그리고 뽑기를 재매개변수화로 했으므로 이 어림값을 $\theta$, $\phi$ 로 미분할 수 있습니다.
KL 항은 표본으로 어림할 필요조차 없습니다. 두 대각 가우시안 사이의 KL 은 3장에서 유도한 닫힌 꼴 이 있기 때문입니다(차원마다 계산해 더합니다).
$$ \KL\big(\Normal(\mu_q, \sigma_q^2)\ \|\ \Normal(\mu_p, \sigma_p^2)\big) = \log\frac{\sigma_p}{\sigma_q} + \frac{\sigma_q^2 + (\mu_q - \mu_p)^2}{2\sigma_p^2} - \frac{1}{2} $$1차원 $z$ 에서 사후가 $q = \Normal(0.5,\ 0.2^2)$, 사전이 $p = \Normal(0,\ 1^2)$ 일 때 KL 을 계산해 보세요.
답 보기
약 1.25 내트입니다. PyTorch 의 kl_divergence 도 1.2544, 표본 200만 개로 어림한 몬테카를로 값도 1.254 로 같습니다.
사후가 사전보다 훨씬 좁고(0.2 vs 1) 평균도 0.5 만큼 벗어나 있어서, “그림을 보고 새로 알게 된 정보” 가 1.25 내트라는 뜻입니다.
각 항의 뜻과 자유 내트
① 재구성 항: 분산 1 가우시안은 제곱 오차
관측 모델 $p(o_t \mid h_t, z_t)$ 는 픽셀마다 평균이 $\hat{o}_t$(디코더 출력)이고 분산이 1 인 가우시안으로 둡니다. 그러면 로그 가능도는 익숙한 제곱 오차가 됩니다.
0.5 * ((recon - obs) ** 2).sum(dim=(-2, -1)) 가 이것입니다. 픽셀에 대해 평균이 아니라 합 이라는 점에 주의하세요(아래 “각 항의 크기” 참고).
예를 들어 픽셀 3개짜리 그림 $o = (0.5, -0.5, -0.5)$ 를 $\hat{o} = (0.3, -0.4, -0.5)$ 로 복원했다면 손실은
$\frac{1}{2}\big(0.2^2 + 0.1^2 + 0^2\big) = \frac{1}{2}(0.04 + 0.01) = 0.025$ 입니다.
(그림은 preprocess 로 0 ~ 255 를 $-0.5$ ~ $0.5$ 로 옮겨 씁니다. 검은 바탕이 $-0.5$, 가장 밝은 끝의 추가 $0.5$ 입니다(막대는 조금 어두운 약 $0.35$).)
② 보상 항
보상 모델도 분산 1 가우시안이라, 같은 계산으로 손실은 $\frac{1}{2}(r_t - \hat{r}_t)^2$ 입니다. 다만 두 가지를 손봤습니다.
- 보상 크기 맞추기: 행동 반복 2 의 진자 보상은 한 결정에 $-33$ 에서 $0$ 사이로 큽니다. 학습할 때는 보상에
reward_scale = 0.1을 곱해 $-3.3$ 에서 $0$ 정도로 줄입니다. 계획은 보상의 순위 만 보므로 결과에 영향을 주지 않고, 12장의 가치 함수 학습은 크기가 작을수록 수월합니다. - 첫 시각 빼기: 에피소드의 첫 그림 $o_0$ 에는 “도착하며 받은 보상” 이 없으므로
first표시로 손실에서 뺍니다.
③ KL 항: 동역학을 가르치는 선생님
KL 항은 두 방향으로 동시에 힘을 줍니다. 기울기가 $\phi$(사후)와 $\theta$(사전) 양쪽으로 흐르기 때문입니다.
- 사전 쪽: “그림을 보지 않고도 사후가 할 추측을 미리 맞혀라.” → 사전 $p(z_t \mid h_t)$ 와 GRU 가 미래를 예측하는 능력, 즉 동역학을 배웁니다.
- 사후 쪽: “예측할 수 있는 것 이상의 정보는 되도록 담지 마라.” → 사후가 그림에서 꼭 필요한 정보만 꺼내도록 정보량을 제한 합니다.
재구성 항은 반대로 “그림을 설명할 정보는 충분히 담아라” 고 당깁니다. 둘의 줄다리기 끝에, 사후는 그림을 설명하는 데 필요한 정보 중에서도 과거로부터 예측하기 어려운 새 정보만 $z_t$ 에 담게 됩니다. 진자라면 대부분의 정보(각도, 속도)는 과거로부터 예측되므로 KL 은 작아집니다.
자유 내트
학습 초반에는 문제가 생길 수 있습니다. KL 항이 너무 세게 작용하면 사후가 그림을 무시하고 사전과 똑같아지는 쪽(KL = 0)으로 무너지기 쉽습니다. 그러면 $z$ 에 정보가 없으니 재구성도 동역학도 배울 수 없습니다(8장의 사후 붕괴, posterior collapse). PlaNet 은 이를 막으려고 자유 내트free nats 를 씁니다.
$$ \mathcal{L}_{\text{KL}} = \max\big(\KL,\ 3\big) $$“내트(nat)” 는 자연로그로 잰 정보량의 단위입니다(3장). 1 내트 $= 1/\ln 2 \approx 1.443$ 비트입니다. 위 식은 “KL 이 3 내트보다 작으면 KL 로는 벌하지 않는다”, 즉 한 스텝에 3 내트까지는 공짜로 쓰게 해 준다 는 뜻입니다.
우리 구현은 Dreamer 공개 코드처럼 배치 · 시간 평균 KL 에 이 규칙을 적용합니다(torch.clamp(kl, min=cfg.free_nats)). 실제 학습에서 KL 이 금방 3 근처에 머무는 것을 결과 절에서 보게 됩니다.
한 가지 짚어 둘 점이 있습니다. KL 항은 사전을 가르치는 유일한 통로인데, 평균 KL 이 3 아래인 학습 스텝에서는 그 기울기가 꺼지므로 사전도 그 스텝에는 배우지 않습니다. 사전은 재구성 손실이 사후를 움직여 KL 이 3 을 넘는 스텝마다 사후를 다시 따라잡는 식으로 배웁니다. KL 이 3 바로 아래에서 맴도는 것이 그 흔적입니다.
각 항의 크기
재구성 손실은 픽셀 4096개에 대한 합 이라 처음에는 수백이고, KL 은 몇 내트, 보상 손실은 1 보다 작습니다. 크기가 이렇게 달라도 괜찮을까요? 순차 ELBO 를 정직하게 따르면 이 크기 비율 자체가 “정답” 입니다. 그림 한 장은 보상 숫자 하나보다 훨씬 많은 정보를 담고 있으니까요. 다만 실전에서는 이 비율 때문에 모델이 그림의 세부만 신경 쓰고 보상을 소홀히 할 수 있어서, Dreamer 계열은 나중에 각 항에 가중치를 따로 주기도 합니다(12장의 DreamerV3).
코드: 손실 함수
순차 ELBO 와 코드를 짝지으면 다음과 같습니다.
| 순차 ELBO 의 항 | 코드 |
|---|---|
| 사후에서 $z_{1:T}$ 를 한 번 뽑기 | states = self.rssm.observe(embed, batch["prev_action"]) |
| ① $-\E_q[\log p(o_t \mid h_t, z_t)]$ | recon_loss = 0.5 * ((recon - obs) ** 2).sum(dim=(-2, -1)).mean() |
| ② $-\E_q[\log p(r_t \mid h_t, z_t)]$ | reward_loss = (0.5 * (pred_r - target_r) ** 2 * mask).sum() / mask.sum() |
| ③ $\E_q[\KL(q \,\|\, p)]$ + 자유 내트 | kl = gaussian_kl(...).sum(-1).mean(), torch.clamp(kl, min=cfg.free_nats) |
| 시각 $t = 1..T$ 에 대한 합 | .mean() (배치 · 시간 평균. 합을 $B \cdot T$ 로 나눈 것이라 최적점은 같습니다) |
잠재 과대 예측
순차 ELBO 를 다시 보면, KL 항은 사후 $q(z_t \mid h_t, o_t)$ 와 “바로 앞 스텝까지는 진짜 그림을 본” 사전을 비교합니다. $h_t$ 가 사후에서 뽑은 $z_{t-1}$ 로 계산되기 때문입니다. 즉 사전은 한 스텝 예측 만 훈련받습니다.
그런데 계획할 때는 그림 없이 사전을 여러 스텝 연달아 굴립니다(CEM 은 12 스텝). 한 스텝 예측만 연습한 모델이 12 스텝을 잘 상상한다는 보장은 없습니다. 6장에서 본 오차 누적 문제가 잠재 공간에서도 생길 수 있는 것입니다.
PlaNet 논문은 이를 위해 잠재 과대 예측latent overshooting 을 제안했습니다. $d$ 스텝 전의 사후에서 출발해 사전만으로 $d-1$ 스텝 굴려 $s_{t-1}$ 을 뽑고, 거기서 낸 한 스텝 사전을 지금의 사후와 비교하는 KL 항을 $d = 1, \dots, D$ 에 대해 더하는 것입니다.
$$ \sum_{t=1}^{T} \Big( \E_q[\log p(o_t \mid s_t)] - \frac{1}{D}\sum_{d=1}^{D} \beta_d\, \E_{p(s_{t-1} \mid s_{t-d})\, q(s_{t-d} \mid o_{\le t-d})}\big[\KL\big(q(s_t \mid o_{\le t})\ \|\ p(s_t \mid s_{t-1})\big)\big] \Big) $$여기서 $p(s_{t-1} \mid s_{t-d})$ 는 사전 $p(s_\tau \mid s_{\tau-1}, a_{\tau-1})$ 를 $d-1$ 번 이어 붙인 여러 스텝 예측 분포이고(행동은 줄여 썼습니다), $\beta_d$ 는 스텝 수별 가중치입니다. KL 안에 들어가는 것은 늘 한 스텝 사전이라 가우시안끼리의 닫힌 꼴로 계산할 수 있습니다. $D = 1$, $\beta_1 = 1$ 이면 원래의 순차 ELBO 로 돌아갑니다. 개념은 단순하지만 계산량이 많아지고 효과는 모델 종류에 따라 달라서, 후속 연구인 Dreamer 계열은 잠재 과대 예측을 쓰지 않았습니다. 우리 구현도 쓰지 않고, 대신 실제로 여러 스텝 상상이 얼마나 맞는지를 결과 절에서 눈으로 확인합니다.
잠재 공간에서 계획하기: CEM
이제 학습된 RSSM 으로 행동을 고릅시다. 7장의 교차 엔트로피 방법(CEM) 을 그대로 쓰되, 숫자 3개짜리 상태 대신 잠재 상태 $(h_t, z_t)$ 위에서 굴립니다. 매 결정 순간 에이전트는 다음 일을 합니다.
- 필터링: 방금 받은 그림 $o_t$ 로 믿음 상태를 갱신합니다. $h_t = f(h_{t-1}, z_{t-1}, a_{t-1})$, $z_t \sim q(z_t \mid h_t, o_t)$. (코드의
LatentAgent.act) - 계획: $(h_t, z_t)$ 에서 출발해 앞으로 $H$ 스텝의 행동열 $a_{t:t+H-1}$ 을 CEM 으로 최적화합니다. 목표는 상상 속 보상의 합입니다. $$ a^*_{t:t+H-1} = \argmax_{a_{t:t+H-1}}\ \E_{p}\!\left[\sum_{\tau=t+1}^{t+H} \hat{r}_\tau\right],\qquad \hat{r}_\tau = \text{보상 모델}(h_\tau, z_\tau) $$ 상상 속 상태는 사전에서 뽑습니다: $h_\tau = f(h_{\tau-1}, z_{\tau-1}, a_{\tau-1})$, $z_\tau \sim p(z_\tau \mid h_\tau)$.
- 실행: 계획의 첫 행동 $a^*_t$ 만 실제로 하고, 다음 그림이 오면 1 로 돌아가 처음부터 다시 계획합니다(7장의 MPC).
CEM 의 한 반복
계획 2단계의 CEM 은 다음을 $I$ 번 되풀이합니다. 행동은 $[-1, 1]$ 로 정규화한 값이고, 환경에 줄 때 2 를 곱해 토크로 바꿉니다.
- 평균 $\mu \in \R^{H}$, 표준편차 $\sigma \in \R^{H}$ 인 가우시안에서 행동열 후보 $J$ 개를 뽑습니다(처음엔 $\mu = 0$, $\sigma = 1$).
- 후보 $J$ 개를 한꺼번에(배치로) 모델 안에서 $H$ 스텝 굴려 보상 합을 잽니다.
- 보상 합이 가장 큰 $K$ 개(정예, elite)를 골라, 그 평균과 표준편차로 $\mu$, $\sigma$ 를 바꿉니다.
elite.std(0) 는 기본값으로 $K-1$ 로 나누는 불편 분산의 제곱근이지만, $K = 100$ 이라 차이는 1% 미만입니다.)PlaNet 의 계획 설정과 비용
PlaNet 논문의 설정을 그대로 씁니다.
| 기호 | 뜻 | 값 |
|---|---|---|
| $H$ | 계획 길이(몇 스텝 앞까지 상상할지) | 12 |
| $I$ | CEM 반복 횟수 | 10 |
| $J$ | 반복마다 뽑는 후보 수 | 1000 |
| $K$ | 정예 수 | 100 |
비용을 계산해 봅시다. 결정 한 번에 RSSM 을 $I \times H \times J = 10 \times 12 \times 1000 = 120{,}000$ 스텝 굴립니다(1000개는 배치로 동시에 굴리므로 순차 계산은 $10 \times 12 = 120$ 번). 한 에피소드는 결정 100번이니 1200만 스텝입니다. 이 비용이 12장에서 Dreamer 가 계획 대신 정책을 배우는 이유가 됩니다. 매 결정마다 $\mu, \sigma$ 를 0 과 1 로 되돌려 새로 계획하고, 데이터를 모을 때는 탐험을 위해 고른 행동에 $\Normal(0, 0.3^2)$ 잡음을 더합니다.
h.expand(J, -1): 지금의 믿음 상태 하나를 후보 $J$ 개가 함께 쓰도록 복사 없이 늘립니다.- 상상 속에서는
img_step만 씁니다. 미래 그림은 없으니 사후를 쓸 수 없습니다. 이것이 사전이 “여러 스텝” 을 잘 예측해야 하는 이유입니다. @torch.no_grad(): 계획에는 미분이 필요 없으므로 기울기 기록을 꺼서 메모리와 시간을 아낍니다.
LatentAgent 는 그림을 받을 때마다 obs_step 으로 믿음 상태를 갱신하고, 행동을 고르는 방법은 바깥에서 받습니다(choose).
PlaNet 은 choose = cem_plan 이고, 12장의 Dreamer 는 같은 클래스에 정책 신경망을 넣어 씁니다.
전체 학습 고리
모델 학습과 데이터 수집은 번갈아 일어납니다. 처음엔 모델이 엉망이니 무작위 행동으로 시작하고, 모델이 나아질수록 계획이 좋아져 더 좋은 상태(진자가 위에 있는 상태)의 데이터 가 모이고, 그 데이터로 모델이 다시 나아집니다.
데이터 D ← 무작위 행동 에피소드 S 개
되풀이 (iterations 번):
    C 번 되풀이:                                  # 모델 학습
        D 에서 길이 L 인 조각 B 개를 뽑는다
        순차 ELBO 손실 = 재구성 + 보상 + max(KL, 자유 내트)
        Adam 으로 θ, φ 를 한 스텝 고친다
    에피소드 하나를 모은다:                        # 데이터 수집
        매 결정마다: 그림으로 (h, z) 갱신 → CEM 계획 → 첫 행동 + 잡음 N(0, 0.3²) 실행
    그 에피소드를 D 에 넣는다
행동 반복 2 를 고른 이유
행동 반복action repeat 은 같은 행동을 환경에서 여러 스텝 되풀이하는 것입니다(PixelPendulum(action_repeat=2)).
PlaNet 은 과제마다 2 ~ 8 을 썼습니다. 우리는 2 를 골랐습니다.
- 좋은 점: 결정 횟수가 200 → 100 으로 줄어, 같은 계획 길이 $H = 12$ 가 실제 시간 $12 \times 2 \times 0.05 = 1.2$ 초를 내다봅니다. 진자가 한 번 흔들리는 시간(약 2초)의 절반 이상이라, 지금의 토크가 흔들림에 주는 효과를 계획이 볼 수 있습니다. 계산도 절반입니다.
- 나쁜 점: 반복이 길수록 행동이 거칠어집니다. 진자를 꼭대기에서 세우는 마지막 단계는 섬세한 조정이 필요해서, 4 이상은 균형 잡기를 어렵게 만듭니다.
행동 반복을 쓰면 보상은 반복한 스텝들의 합으로 받으므로, 한 결정의 보상 범위가 $[-33, 0]$ 정도가 됩니다. 에피소드 리턴(200 스텝 보상 합)은 행동 반복과 관계없이 같은 척도로 비교할 수 있습니다.
하이퍼파라미터
| 이름 | 뜻 | 우리 값 | PlaNet 논문 |
|---|---|---|---|
| $S$ | 무작위 시드 에피소드 | 5 | 5 |
| $C$ | 수집 사이의 학습 횟수 | 100 | 100 |
| $B \times L$ | 배치 (시퀀스 수 × 길이) | 50 × 50 | 50 × 50 |
| $h$ / $z$ 크기 | 결정 · 확률 상태 | 200 / 30 | 200 / 30 |
| 자유 내트 | KL 바닥값 | 3 | 3 |
| 학습률 / Adam ε | $6\times10^{-4}$ / $10^{-4}$ | $10^{-3}$ / $10^{-4}$ | |
| 기울기 자르기 | 노름 상한 | 100 | 1000 |
| $H, I, J, K$ | CEM | 12, 10, 1000, 100 | 12, 10, 1000, 100 |
| 탐험 잡음 | 수집할 때 행동에 더함 | 0.3 | 0.3 |
| 행동 반복 | 2 | 과제마다 2 ~ 8 | |
| 보상 배율 | 학습용 보상 크기 | 0.1 | — (보상이 이미 0 ~ 1) |
| 반복 횟수 | (학습 C 번 + 수집 1번) | 100 (에피소드 105개, 21,000 스텝) | 과제마다 다름 (수백 에피소드 이상) |
학습률 · 기울기 자르기는 12장 Dreamer 와 같은 값을 쓰려고 Dreamer 논문 값으로 맞췄습니다.
구현 자세히 보기
그림 다듬기와 리플레이 버퍼
- 에피소드를 통째로 저장하고, 뽑을 때는 무작위 에피소드의 무작위 시작점 에서 길이 $L$ 조각을 자릅니다. 에피소드 하나는 관측 101개(시작 + 결정 100번)이고 $L = 50$ 이므로 시작점은 0 ~ 51 중 하나입니다.
- 조각이 에피소드 중간에서 시작해도 RSSM 은 $h = 0$, $z = 0$ 에서 출발합니다. 처음 몇 스텝은 상태가 부정확하지만 그림을 보며 금방 따라잡습니다. 이것도 모델이 배워야 할 일의 일부입니다.
- 그림은 메모리를 아끼려고
uint8로 저장하고, 배치를 만들 때만 실수로 바꿉니다. 에피소드 105개 × 101장 × 4096바이트 ≈ 43MB 입니다.
합성곱 인코더와 디코더의 크기 계산
시간축 펼치기
배치 $B = 50$, 길이 $L = 50$ 의 그림 묶음은 모양이 (50, 50, 64, 64) 입니다. 인코더와 디코더는 시간과 상관없는 계산이라
앞의 두 축을 하나로 합쳐 2500장을 한꺼번에 처리합니다(obs.reshape(-1, 1, 64, 64)). GPU 가 가장 잘하는 일입니다.
반면 RSSM 은 $h_t$ 가 $h_{t-1}$ 에 의존하므로 시간 순서대로 50번 돌아야 합니다(observe 의 for t in range(L)).
대신 배치 축 50개는 동시에 계산합니다. 학습 한 스텝에서 시간이 가장 많이 드는 곳은 합성곱(인코더 · 디코더와 그 역전파)이고, 순차 루프는 그다음입니다.
초급자가 가장 많이 막히는 곳은 텐서 모양입니다. 코드의 주석 # (B, L, 64, 64) 처럼 모양을 적어 두고, 막히면 print(x.shape) 를 찍어 보세요.
RSSM 의 observe 는 시각별 결과를 리스트에 모은 뒤 torch.stack(v, dim=1) 로 시간 축(1번 축)에 쌓아 (B, L, ·) 로 돌려줍니다.
학습 · 수집 고리
실행 결과
본문 설정 그대로(python ch11_rssm_planet.py) 노트북 GPU(8GB)에서 돌린 결과입니다. 같은 GPU 에서 12장의 Dreamer 학습을 함께 돌렸기 때문에
혼자 돌리면 이보다 빠릅니다. 출력의 return 은 탐험 잡음을 넣고 모은 에피소드의 리턴, eval 은 잡음 없이 계획만으로 행동한 에피소드 3개의 평균입니다. 맨 처음 찍히는 device=… 설정 줄은 출력 상자에서 생략했습니다.
$ python ch11_rssm_planet.pyrandom policy return: -1194.5 it 1 | env steps 1200 | recon 118.81 reward 0.3792 kl 0.34 | return -1151.9 | plan 99.1 ms/action | 46s it 2 | env steps 1400 | recon 47.34 reward 0.1691 kl 2.73 | return -1388.7 | plan 89.8 ms/action | 79s it 3 | env steps 1600 | recon 8.92 reward 0.0168 kl 3.85 | return -1027.6 | plan 74.9 ms/action | 110s it 4 | env steps 1800 | recon 5.70 reward 0.0086 kl 3.02 | return -894.7 | plan 87.6 ms/action | 139s it 5 | env steps 2000 | recon 4.17 reward 0.0070 kl 2.95 | return -628.2 | plan 114.5 ms/action | 182s … it 10 | env steps 3000 | recon 3.41 reward 0.0040 kl 2.88 | return -375.8 | plan 144.9 ms/action | 477s | eval -165.8 … it 20 | env steps 5000 | recon 1.24 reward 0.0022 kl 2.77 | return -383.5 | plan 101.9 ms/action | 962s | eval -257.3 … it 30 | env steps 7000 | recon 0.93 reward 0.0017 kl 2.65 | return -123.5 | plan 149.7 ms/action | 1423s | eval -127.0 … it 60 | env steps 13000 | recon 0.51 reward 0.0012 kl 2.59 | return -239.6 | plan 97.7 ms/action | 2810s | eval -126.4 … it 100 | env steps 21000 | recon 0.35 reward 0.0010 kl 2.56 | return -245.8 | plan 94.1 ms/action | 4496s | eval -82.4 done in 4535s, final test return -125.8
학습 곡선
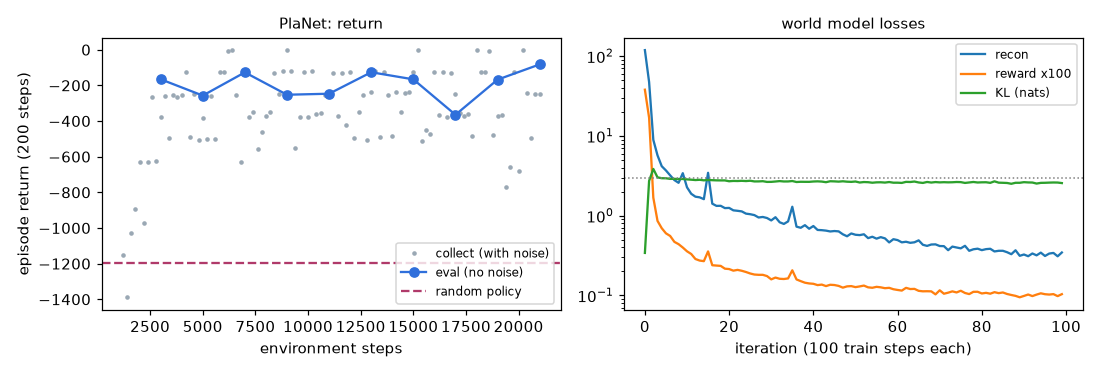
그래프에서 읽을 수 있는 것을 정리하면 다음과 같습니다.
- 아주 적은 데이터로 배웁니다. 환경 스텝 3,000(에피소드 15개, 약 2분 반 분량의 경험)만에 평가 리턴이 −166 이 되었습니다. 무작위 행동은 −1194 입니다. 그림만 보고, 물리 법칙도 보상 공식도 모른 채 시작했다는 것을 생각하면 놀라운 효율입니다.
- 재구성 손실 은 119 에서 0.35 로 줄었습니다(픽셀 4096개의 제곱 오차 합의 절반). 처음 몇 회 만에 바탕을 배우고, 그 뒤로 막대의 세부를 천천히 다듬습니다.
- KL 은 처음 0.3 에서 곧바로 3 근처로 올라가 그 아래(2.6 안팎)에 머뭅니다. 처음에 0 근처인 것은 사후가 아직 그림을 거의 쓰지 않아서이고, 재구성이 사후를 그림 쪽으로 당기면서 KL 이 커집니다. 3 아래에서는 자유 내트 때문에 KL 의 기울기가 꺼지므로, KL 은 “공짜 한도” 근처에서 맴돕니다. 앞의 자유 내트 절에서 예상한 그대로입니다.
- 탐험 잡음을 넣은 에피소드(회색) 는 0 에 가까운 값부터 −800 근처까지 넓게 흩어집니다. 잡음 $\Normal(0, 0.3^2)$ 은 토크로 ±0.6 정도라, 꼭대기에서 균형을 잡다가 떨어뜨리기도 합니다. 덕분에 “떨어지는 상황” 의 데이터도 모여 모델이 더 튼튼해집니다.
상상 vs 진짜
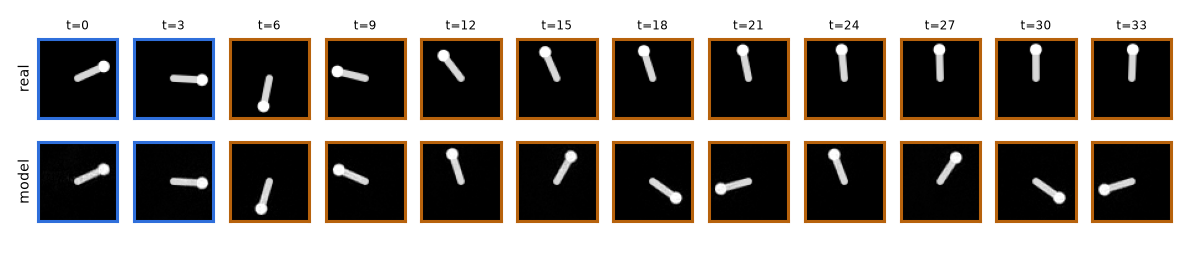
다섯 장을 본 뒤 모델은 진자가 아래로 떨어졌다가 반동으로 올라오는 과정(t = 6 ~ 12)을 진짜와 거의 같게 상상합니다. 그림 한 장에는 없는 속도 를 다섯 장면에서 읽어 내 $h_t$ 에 기억해 두었기 때문입니다. 그러나 t = 15 무렵부터 상상이 어긋납니다. 진짜 진자는 계획 덕분에 꼭대기에 섰는데, 모델의 상상 속 진자는 꼭대기를 지나쳐 넘어갑니다. 이유는 두 가지입니다.
- 오차 누적(6장): 한 스텝의 작은 오차가 10 스텝 넘게 쌓였습니다. 학습 중 사전은 한 스텝 예측만 연습했습니다(잠재 과대 예측 절).
- 꼭대기는 불안정한 평형점 입니다. 꼭대기 근처에서는 아주 작은 차이가 “왼쪽으로 넘어짐 / 오른쪽으로 넘어짐 / 선다” 를 가릅니다.
다행히 계획에 필요한 것은 12 스텝 앞까지입니다. 그 범위 안에서는 상상이 충분히 정확하고, MPC 는 매 순간 새 그림으로 믿음 상태를 고쳐 잡은 뒤 다시 계획하므로 먼 미래의 상상 오차가 쌓이지 않습니다. 6장에서 본 “오차 누적” 문제를 MPC 가 어떻게 피해 가는지가 여기서 잘 보입니다.
계획으로 진자 세우기
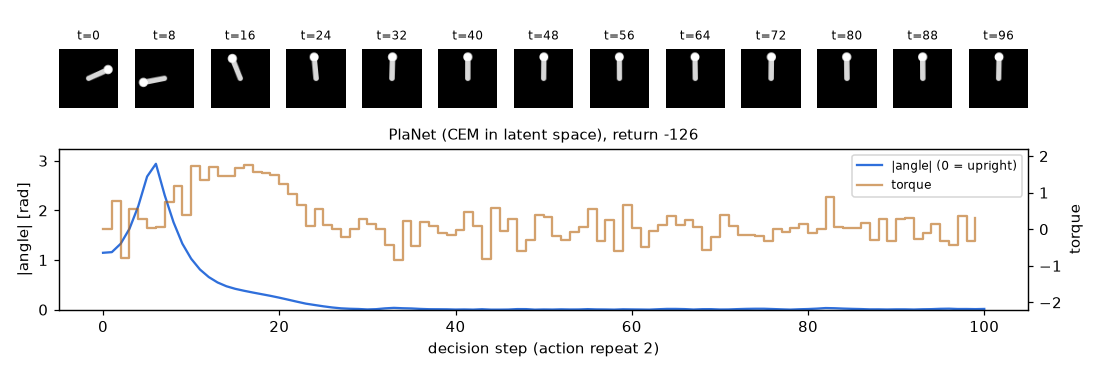
꼭대기에서 1.15 rad 쯤 기운 채 시작했는데, PlaNet 은 곧장 밀어 올리지 않고 먼저 진자를 아래로 떨어뜨립니다(결정 0 ~ 6 에서 $|\theta|$ 가 3 rad 가까이 커짐). 토크가 약해 곧장 올릴 수 없으니 아래로 내려가 반동을 모으는 것입니다. 그다음 최대에 가까운 토크로 밀어 올리고(결정 8 ~ 18), 꼭대기에서는 작은 토크로 균형을 잡습니다(결정 25 이후 $|\theta| \approx 0$). “그네 타기” 전략을 아무도 가르쳐 주지 않았는데, 상상 속 12 스텝 계획만으로 찾아냈습니다.
성능과 시간
학습을 마친 모델로 처음 보는 시작 상태 10개를 평가했습니다. 아래 표의 값은 main 의 ④ 단계가 찍는 final eval over 10 episodes 줄의 값이고, 위 출력 상자에서는 그 줄을 생략했습니다.
출력 마지막 줄의 final test return 과 그림 11-5 · 11-6 은 같은 시드의 평가 환경을 새로 만들어 얻은 첫 에피소드(위 10개 중 첫 번째와 같은 시작 상태)입니다.
| 정책 | 평균 리턴 (10 에피소드) | 표준편차 | 최저 / 최고 |
|---|---|---|---|
| 무작위 행동 | −1194.5 | — | — |
| PlaNet (환경 스텝 21,000) | −196.8 | 113.7 | −376.2 / −0.5 |
리턴이 에피소드마다 크게 다른 것은 시작 위치 때문입니다. 꼭대기 근처에서 시작하면 거의 0 이고(−0.5), 맨 아래에서 시작하면 그네를 타고 올라가는 동안 각도 벌점을 많이 받아 −250 ~ −380 이 됩니다. 아무리 잘해도 아래에서 시작하면 그만큼은 잃으므로, 평균 −150 ~ −200 이면 이 과제를 사실상 풀었다고 볼 수 있습니다.
| 항목 | 값 |
|---|---|
| 전체 학습 시간 (노트북 GPU, 다른 학습과 함께) | 4,535초 ≈ 76분 |
| 계획 시간 (결정 한 번, GPU) | 평균 약 100 ms → 에피소드 하나(결정 100번)에 약 10초 |
| World Model 학습 한 스텝 (CPU 4스레드, $B = 50$) | 약 17초 → 본문 설정(1만 스텝)은 CPU 로 사실상 불가능 |
같은 것, --batch-size 16 | 약 5초 → 1만 스텝에 반나절 이상 |
--quick (CPU) | 약 1분 (동작 확인용, 학습은 되지 않음) |
CPU 시간은 다른 학습들과 CPU 를 나눠 쓰며 잰 값이라 혼자 쓰면 조금 더 빠르지만, 그래도 그림을 보는 World Model 은 CPU 로 학습하기에 무겁습니다.
먼저 --quick 으로 코드가 끝까지 도는지 확인하고, 실제 학습은 무료 클라우드 GPU(예: Google Colab)에서 돌리기를 권합니다.
파일 세 개(wm_envs.py, ch11_rssm_planet.py, ch12_dreamer.py)만 올리면 됩니다. 원리를 익히는 데는 7장의 숫자 상태 실험(CPU 몇 분)으로도 충분합니다.
자주 겪는 문제
| 증상 | 흔한 원인 | 해 볼 것 |
|---|---|---|
| 재구성 그림에 막대가 없고 검은 바탕만 나온다 | 막대가 그림의 일부라 초반에는 바탕만 맞춰도 손실이 크게 준다 | 더 오래 학습. 수천 스텝 뒤 막대가 나타난다. 그래도 안 되면 학습률을 낮춘다 |
| KL 이 0 근처로 떨어지고 상상이 엉망 | 사후 붕괴: 사후가 그림을 무시 | 자유 내트가 켜져 있는지 확인(free_nats=3) |
| 상상(열린 고리)이 몇 스텝 만에 흐려진다 | 사전이 한 스텝 예측만 연습함, 데이터 부족 | 데이터를 더 모은다. 잠재 과대 예측, 더 긴 $L$ |
| 계획한 행동이 실제로는 엉뚱하다 | 보상 모델이 아직 부정확하거나, 계획이 모델의 오류를 “이용” 함 | 보상 손실을 확인. 탐험 잡음 유지. 데이터가 쌓이면 자연히 줄어든다 |
| CPU 에서 너무 느리다 | 합성곱 2500장 × 역전파 | --batch-size 16, 또는 GPU. 7장의 상태 기반 실험으로 먼저 감을 익힌다 |
- 그림만 보면 속도를 알 수 없어(부분 관측) 과거를 요약한 믿음 상태 가 필요합니다. 잠재 상태 공간 모델이 그것을 학습합니다.
- RSSM 은 상태를 결정 상태 $h_t$(GRU, 기억)와 확률 상태 $z_t$(가우시안, 불확실성)로 나눕니다. 부품은 GRU · 사전 · 사후 · 관측 디코더 · 보상 디코더 다섯 개입니다.
- 학습 목표는 순차 ELBO = $\sum_t$ (재구성 + 보상 − KL(사후 ‖ 사전)). 결합 분포의 인수분해, 젠센 부등식, 기댓값의 시간별 분리로 유도됩니다.
- KL 항은 사전(동역학)을 가르치는 유일한 통로입니다. 자유 내트 는 KL 이 3 내트 아래면 기울기를 꺼서 사후 붕괴를 막습니다.
- PlaNet 은 잠재 공간에서 CEM($H=12$, $I=10$, $J=1000$, $K=100$)으로 계획하고 첫 행동만 실행합니다(MPC). 결정 한 번에 RSSM 을 12만 스텝 굴리는 비싼 방법입니다.
확인 문제
RSSM 에서 결정 상태 $h_t$ 를 빼고 확률 상태만 남기면 어떤 문제가 생기나요? 반대로 $z_t$ 를 빼면요?
답 보기
$h_t$ 를 빼면(순수 확률 SSM) 모든 정보가 매 스텝 뽑기를 거쳐야 해서 여러 스텝 전의 정보를 정확히 전달하기 어렵습니다. $z_t$ 를 빼면(결정적 RNN) 미래를 하나밖에 표현할 수 없어 여러 갈래의 미래를 평균 내 흐릿하게 예측하고, 잠재 변수가 없으니 ELBO 와 KL 로 학습할 수도 없습니다.
순차 ELBO 유도에서 부등호($\ge$)가 처음 나타나는 줄은 어디이고, 등호가 성립하려면 무엇이 필요한가요?
답 보기
젠센 부등식 $\log \E[X] \ge \E[\log X]$ 를 쓴 줄입니다. 차이는 $\KL(q(z_{1:T} \mid o_{1:T}) \,\|\, p(z_{1:T} \mid o_{1:T}, r_{1:T}))$ 이므로, 추론 모델 $q$ 가 진짜 사후 분포와 똑같을 때 등호가 성립합니다.
사전이 $p = \Normal(0.2,\ 0.5^2)$, 사후가 $q = \Normal(0.2,\ 0.5^2)$ 로 같다면 KL 은 얼마이고, 자유 내트 3 을 적용한 손실과 그 기울기는?
답 보기
$\log(0.5/0.5) + (0.25 + 0)/(2 \cdot 0.25) - 0.5 = 0 + 0.5 - 0.5 = 0$. 자유 내트 손실은 $\max(0, 3) = 3$ 이고, 이 영역에서 기울기는 0 입니다. 즉 KL 이 작을 때는 KL 이 모델을 더 누르지 않습니다.
CEM 의 후보 수를 $J = 1000$ 에서 $J = 100$ 으로, 정예를 $K = 10$ 으로 줄이면 결정 한 번에 RSSM 을 몇 스텝 굴리나요? 무엇을 잃을까요?
답 보기
$I \times H \times J = 10 \times 12 \times 100 = 12{,}000$ 스텝으로 10배 줄어듭니다. 대신 한 반복에서 살펴보는 행동열이 적어,
특히 처음 몇 반복에서 좋은 행동열을 찾을 확률이 낮아지고 계획의 질이 떨어질 수 있습니다(--quick 설정이 이 $J$, $K$ 값을 쓰고, 반복도 $I = 3$ 으로 줄입니다).
보상 배율(reward_scale)을 0.1 에서 1 로 바꾸면 CEM 이 고르는 행동은 달라질까요?
답 보기
보상 모델이 완벽하다면 달라지지 않습니다. CEM 은 보상 합이 큰 순서(순위)로 정예를 고르는데, 모든 보상에 같은 양수를 곱해도 순위는 바뀌지 않기 때문입니다. 다만 학습 중에는 보상 손실의 크기가 100배 커져 다른 손실과의 균형이 달라지므로, 모델이 실제로 배우는 내용은 조금 달라질 수 있습니다.
PlaNet 은 그림만 보고 행동할 수 있게 해 주었지만, 결정할 때마다 상상을 12만 스텝씩 돌려야 했습니다. 이 상상을 결정할 때마다 버리지 말고 한 번 배워 두면 어떨까요? 다음 장에서는 같은 RSSM 의 상상 속에서 정책 자체를 학습하는 Dreamer 를 만듭니다.