Dreamer: 상상 속에서 배우는 행동
11장의 PlaNet 은 결정할 때마다 World Model 안에서 12만 스텝을 상상하고, 그 상상을 곧바로 버렸습니다. Dreamer 는 같은 상상을 버리지 않고 행동하는 법 자체를 배우는 데 씁니다. RSSM 이 만든 꿈속에서 액터(정책)와 크리틱(가치 함수)을 학습하고, 실제 세상에서는 액터 신경망을 한 번 계산해 곧바로 행동합니다. 이 장은 튜토리얼의 절정입니다. 지금까지 배운 거의 모든 것, 가우시안 · KL · 재매개변수화(2 · 3 · 8장), 역전파(4장), 벨만 방정식(5장), RSSM(11장)이 한자리에 모입니다.
- 계획(PlaNet)의 비용과 한계, 그리고 “상상 속에서 정책을 배운다” 는 Dreamer 의 발상
- 사후 상태에서 출발하는 상상 궤적 만들기
- n-스텝 리턴 과 λ-리턴 의 정의, 그리고 정의에서 재귀식까지의 한 줄씩 유도
- 크리틱 손실과 기울기 차단(sg), 그리고 World Model 을 거슬러 미분하는 액터 학습(5장 REINFORCE 와의 비교)
- tanh-가우시안 정책과 엔트로피 보너스(변수 바꾸기 공식으로 유도)
- PyTorch 로 Dreamer 를 구현해 그림만 보고 진자 세우기, 그리고 실제 결과
- DreamerV2(범주형 잠재 · 직선 통과 추정기 · KL 균형)와 DreamerV3(symlog · two-hot · 자유 비트(free bits) · unimix · 리턴 정규화)의 원리
계획의 비용, 그리고 다른 길
PlaNet 의 계획은 강력하지만 두 가지 약점이 있습니다.
- 비쌉니다. 결정 한 번에 RSSM 을 $I \times H \times J = 10 \times 12 \times 1000 = 120{,}000$ 스텝 굴립니다. 실제로 이 튜토리얼을 쓴 노트북 GPU 에서도 결정 한 번에 0.1초 안팎이 걸렸습니다(결과 절의 표). 로봇처럼 빠르게 반응해야 하는 곳에서는 부담이 됩니다. 게다가 그렇게 공들인 상상은 행동 하나를 고른 뒤 버려집니다. 다음 순간에는 처음부터 다시 상상합니다.
- 근시안입니다. 계획은 $H = 12$ 스텝 안의 보상 합만 봅니다. 12 스텝 뒤에 무슨 일이 생기든 계획에는 보이지 않습니다. 진자처럼 “지금은 손해(아래로 내려가 반동을 모음)지만 나중에 큰 이득(위에 서기)” 인 문제에서 이것은 치명적일 수 있습니다.
5장에서 본 강화학습의 두 도구가 바로 이 두 문제의 해결책입니다.
- 정책(액터) $\pi_\psi(a \mid s)$: 상태를 넣으면 행동을 내놓는 신경망. 한 번 배워 두면 결정할 때 신경망을 한 번 계산하면 끝입니다. → 비용 문제 해결
- 가치 함수(크리틱) $v_\xi(s)$: 상태에서 앞으로 받을 보상의 합을 예측. 상상이 끝나는 지점의 가치를 더하면 지평선 너머까지 내다봅니다. → 근시안 문제 해결
문제는 정책과 가치 함수를 배우려면 보통 엄청난 양의 경험 이 필요하다는 것입니다(모델 없는 강화학습, 5장). Dreamer 의 발상은 단순합니다. 그 경험을 World Model 의 상상으로 만들자. 상상은 공짜에 가깝고(GPU 에서 수천 개를 동시에), 실제 세상은 건드리지 않으니 안전합니다.
Dreamer 는 Hafner, Lillicrap, Ba, Norouzi 의 논문 Dream to Control: Learning Behaviors by Latent Imagination(ICLR 2020)에서 발표되었습니다. World Model 은 11장의 RSSM 을 그대로 쓰고, 그 위에 “상상 속 행동 학습” 을 얹은 것입니다.
상상 궤적 만들기
② 의 첫 단계는 상상 궤적을 만드는 것입니다. 출발점은 어디로 할까요? Dreamer 는 방금 ① 에서 World Model 을 학습하며 계산한 사후 상태들 을 그대로 씁니다. 배치가 $B = 50$ 개 시퀀스 × 길이 $L = 50$ 이니 출발점이 2500개 생깁니다.
- 이 상태들은 실제로 겪었던 장면을 그림까지 보고 추측한 상태라, 상상의 출발점으로 가장 믿을 만합니다.
- 버퍼 곳곳에서 뽑았으니 진자가 아래에 있을 때, 돌고 있을 때, 위에 있을 때 등 다양한 출발점이 고루 섞입니다.
- 이미 계산해 둔 값이라 추가 비용이 없습니다.
출발점 $s_0 = (h_0, z_0)$ 에서 $H = 15$ 스텝을 상상합니다. 이 장에서 상상 속 시각은 $t = 0, 1, \dots, H$ 로 셉니다.
$$ \begin{aligned} a_t &\sim \pi_\psi(a_t \mid s_t) &&\text{액터가 행동을 고르고}\\ h_{t+1} &= f_\theta(h_t, z_t, a_t),\quad z_{t+1} \sim p_\theta(z_{t+1} \mid h_{t+1}) &&\text{RSSM 의 사전으로 한 스텝 (그림 없이)}\\ \hat{r}_t &= R_\theta(h_{t+1}, z_{t+1}) &&\text{도착한 상태에서 보상을 예측} \end{aligned} $$11장의 보상 모델은 “상태 $s_{t+1}$ 에 도착하며 받은 보상” 을 $s_{t+1}$ 에서 예측합니다. 이 장의 상상에서는 그 값을 $\hat{r}_t$ 라고 부릅니다. 즉 $\hat{r}_t$ 는 “$s_t$ 에서 $a_t$ 를 했을 때 받는 보상” 으로, 5장의 $r_t$ 와 같은 첨자 입니다. 이렇게 하면 5장의 리턴 공식을 그대로 쓸 수 있습니다. (논문마다 이 첨자 맞춤이 조금씩 다르니, 논문을 읽을 때는 보상이 어느 상태에서 예측되는지 먼저 확인하세요.)
self.actor.sample(feats[-1].detach()): 액터에 넣는 상태에서는 기울기를 끊습니다(detach= $\sg$). 그 까닭은 “액터 학습” 절에서 설명합니다.self.wm.rssm.img_step(h, z, a): 11장의 그 함수입니다. 사전에서 $z$ 를 뽑을 때도 재매개변수화를 쓰므로, 상상 궤적 전체가 미분 가능한 계산 입니다.- 결과
feats는 모양이(H+1, N, 230)입니다. $N = 2500$ 개 궤적의 $s_0, \dots, s_H$ 입니다.
가치 추정: n-스텝 리턴에서 λ-리턴까지
상상 궤적이 생겼으니, 각 상태가 “얼마나 좋은지” 를 숫자로 매겨야 합니다. 5장의 할인된 리턴 을 떠올려 봅시다.
$$ G_t = \hat{r}_t + \gamma\,\hat{r}_{t+1} + \gamma^2\,\hat{r}_{t+2} + \cdots = \sum_{k=0}^{\infty} \gamma^k\,\hat{r}_{t+k} $$그런데 상상은 $H = 15$ 스텝에서 끝납니다. 무한한 합을 구할 수 없으니, 끝나는 지점 이후는 크리틱의 예측으로 대신 합니다. 5장의 가치 함수 정의 $v(s) = \E[G \mid s]$ 를 생각하면 자연스러운 일입니다.
n-스텝 리턴
보상을 실제로(상상 속에서) $n$ 스텝 더하고, 그 뒤는 크리틱으로 마무리한 값을 n-스텝 리턴n-step return 이라고 합니다.
$$ V^{(n)}_t = \sum_{k=0}^{n-1} \gamma^k\,\hat{r}_{t+k} \;+\; \gamma^n\, v(s_{t+n}) $$예를 들어 $n = 1, 2, 3$ 이면 다음과 같습니다.
$$ \begin{aligned} V^{(1)}_t &= \hat{r}_t + \gamma\, v(s_{t+1}) \\ V^{(2)}_t &= \hat{r}_t + \gamma\,\hat{r}_{t+1} + \gamma^2\, v(s_{t+2}) \\ V^{(3)}_t &= \hat{r}_t + \gamma\,\hat{r}_{t+1} + \gamma^2\,\hat{r}_{t+2} + \gamma^3\, v(s_{t+3}) \end{aligned} $$$n = 1$ 은 5장 벨만 방정식의 오른쪽 그대로입니다(TD 목표라고도 부릅니다). $n$ 을 어떻게 고를까요? 둘 사이에는 줄다리기가 있습니다.
| 작은 $n$ (예: 1) | 큰 $n$ (예: 15) | |
|---|---|---|
| 크리틱에 기대는 정도 | 크다. 크리틱이 틀리면 그대로 틀림(편향) | 작다. 크리틱의 비중이 $\gamma^{n}$ 으로 줄어듦 |
| 상상(모델)에 기대는 정도 | 작다. 한 스텝만 상상 | 크다. 긴 상상의 오차 · 무작위성이 쌓임(분산) |
| 학습 초반 | 크리틱이 엉망이라 나쁨 | 보상 신호를 빨리 전달해 좋음 |
λ-리턴의 정의
하나를 고르는 대신 모두 섞으면 어떨까요? λ-리턴λ-return 은 $n = 1, 2, \dots$ 의 n-스텝 리턴을 $\lambda$ 의 거듭제곱 가중치로 섞은 평균입니다. 상상이 끝나는 시각 $H$ 까지 남은 스텝 수를 $N = H - t$ 라고 하면(앞에서는 궤적 개수를 $N$ 이라 했지만, 이 절에서는 남은 스텝 수를 뜻합니다),
$$ V^\lambda_t = (1 - \lambda)\sum_{n=1}^{N-1} \lambda^{n-1}\, V^{(n)}_t \;+\; \lambda^{N-1}\, V^{(N)}_t $$$\lambda \in [0, 1]$ 입니다. 앞의 n-스텝 리턴들은 $(1-\lambda), (1-\lambda)\lambda, (1-\lambda)\lambda^2, \dots$ 의 가중치를 받고, 가장 긴 $N$-스텝 리턴이 남은 가중치 $\lambda^{N-1}$ 을 모두 받습니다. 이 가중치들이 정말 “평균” 의 가중치인지(합이 1 인지) 확인해 봅시다.
두 끝을 보면 뜻이 분명해집니다. $\lambda = 0$ 이면 첫 항($n = 1$)만 가중치 1 을 받아 $V^\lambda_t = V^{(1)}_t$ (크리틱에 가장 많이 기댐), $\lambda = 1$ 이면 마지막 항만 가중치 1 을 받아 $V^\lambda_t = V^{(N)}_t$ (상상을 끝까지 씀)입니다. Dreamer 는 $\lambda = 0.95$ 를 씁니다. 이때 $N = 15$ 이면 가장 긴 리턴의 가중치가 $0.95^{14} \approx 0.488$ 로, 거의 절반이 “15 스텝 상상 + 끝의 가치” 에 실립니다.
정의에서 재귀식으로
정의대로 계산하면 시각마다 n-스텝 리턴을 $N$ 개씩 만들어야 해서 번거롭습니다. 다행히 λ-리턴은 5장의 리턴 $G_t = r_t + \gamma G_{t+1}$ 처럼 뒤에서부터 한 번에 계산하는 재귀식이 있습니다. 한 줄씩 유도해 봅시다. 먼저 n-스텝 리턴의 재귀 성질이 필요합니다.
마지막으로 끝 조건입니다. 상상의 마지막 시각 $H$ 에서는 더 상상할 것이 없으니 크리틱의 값을 그대로 씁니다: $V^\lambda_H := v(s_H)$. 이 정의가 재귀식과 맞는지 확인해 봅시다. $t = H - 1$ 이면 $N = 1$ 이고 정의에 따라 $V^\lambda_{H-1} = \lambda^0 V^{(1)}_{H-1} = \hat{r}_{H-1} + \gamma v(s_H)$ 입니다. 재귀식에 $V^\lambda_H = v(s_H)$ 를 넣으면 $\hat{r}_{H-1} + \gamma[(1-\lambda)v(s_H) + \lambda v(s_H)] = \hat{r}_{H-1} + \gamma v(s_H)$. 같습니다.
읽는 법: “지금 보상 + 할인된 [다음 상태의 크리틱 값과 다음 상태의 λ-리턴을 $(1-\lambda) : \lambda$ 로 섞은 값]”. $\lambda = 0$ 이면 벨만 방정식의 한 스텝 목표 $\hat{r}_t + \gamma v(s_{t+1})$, $\lambda = 1$ 이면 5장의 리턴 재귀식 $\hat{r}_t + \gamma V_{t+1}$ 이 됩니다.
숫자로 확인하기
$H = 3$, $\gamma = 0.9$, $\lambda = 0.5$ 이고, 상상 속 보상이 $\hat{r}_0 = 1,\ \hat{r}_1 = 0,\ \hat{r}_2 = 2$, 크리틱 값이 $v(s_1) = 4,\ v(s_2) = 3,\ v(s_3) = 5$ 라고 합시다. $V^\lambda_0$ 을 두 방법으로 계산합니다.
코드에서는 재귀식으로 계산하고, 정의대로 계산하는 함수도 함께 두어 둘이 같은지 실행할 때마다 확인합니다.
lambda-return check: recursion vs definition max |diff| = 2.38e-07
무작위 숫자로 만든 보상 · 가치에서 두 계산의 차이가 $10^{-7}$ 수준(32비트 실수의 반올림 오차)입니다. 유도가 맞았다는 뜻입니다.
크리틱 학습
크리틱 $v_\xi(s)$ 는 상상 속 상태 $s_t$ 의 λ-리턴을 예측하도록 배웁니다. λ-리턴은 크리틱 자신의 값으로 만든 목표이므로(“자기 자신을 보고 배우는” 부트스트랩), 목표 쪽으로는 기울기가 흐르지 않게 차단합니다.
$$ \mathcal{L}(\xi) = \E\left[\sum_{t=0}^{H-1} \frac{1}{2}\Big(v_\xi(s_t) - \sg\big(V^\lambda_t\big)\Big)^2\right] $$
$\sg(\cdot)$ 는 기울기 차단stop-gradient 입니다(0장 표). 값은 그대로 쓰되 미분할 때는 상수로 봅니다. PyTorch 의 .detach() 입니다.
여기에 두 가지 안정 장치를 더 씁니다.
- 느린 크리틱(목표 크리틱): λ-리턴을 계산할 때 쓰는 $v$ 는 지금 학습 중인 크리틱이 아니라, 100번 학습마다 한 번씩 복사해 두는 느린 사본 입니다. 목표가 매 스텝 흔들리지 않게 하는 장치로, DreamerV2 부터 쓰였습니다(DreamerV1 원본에는 없습니다). 5장의 DQN 목표 신경망과 같은 생각입니다.
- 입력 차단: 크리틱에 넣는 상태도
feats[:-1].detach()로 끊어, 크리틱 손실이 World Model 이나 액터를 건드리지 않게 합니다.
액터 학습: World Model 을 거슬러 미분하기
이제 Dreamer 의 가장 독특한 부분입니다. 액터의 목표는 상상 속 λ-리턴을 키우는 것입니다.
$$ \max_\psi\ \E\left[\sum_{t=0}^{H-1} V^\lambda_t\right] \quad\Longrightarrow\quad \mathcal{L}(\psi) = -\,\E\left[\sum_{t=0}^{H-1} V^\lambda_t\right] - \eta\,\E\left[\sum_{t=0}^{H-1}\mathcal{H}\big[\pi_\psi(\cdot \mid s_t)\big]\right] $$오른쪽은 부호를 뒤집어 손실로 바꾸고, 탐험을 위한 엔트로피 보너스를 더한 것입니다. 두 번째 항 $\mathcal{H}$ 는 정책의 엔트로피(3장)이고 $\eta$ 는 작은 계수입니다(뒤에서 설명. 0장 표에서는 $\eta$ 가 학습률이었지만, 이 장에서는 Dreamer 논문을 따라 학습률이 아니라 엔트로피 계수 를 뜻합니다). 이 손실을 $\psi$ 로 어떻게 미분할까요?
방법 1: REINFORCE (5장)
5장의 정책 경사 정리는 로그 미분 트릭 으로 다음을 보였습니다.
$$ \nabla_\psi\, \E_{a \sim \pi_\psi}[R(a)] = \E_{a \sim \pi_\psi}\big[R(a)\,\nabla_\psi \log \pi_\psi(a \mid s)\big] $$이 식은 리턴 $R$ 의 값 만 쓰고, $R$ 이 행동에 따라 어떻게 변하는지(미분)는 쓰지 않습니다. 실제 환경처럼 미분할 수 없는 세상에서도 쓸 수 있는 대신, “이 행동을 했더니 리턴이 높았다/낮았다” 는 점수만으로 배우므로 추정의 분산이 크고, 많은 표본이 필요합니다.
방법 2: 재매개변수화 경사 (Dreamer)
그런데 우리의 상상 세계는 신경망 입니다. GRU, 사전 MLP, 보상 모델, 크리틱 모두 미분할 수 있고, 뽑기도 재매개변수화로 했습니다. 행동도 재매개변수화로 뽑습니다.
$$ a_t = \tanh\big(\mu_\psi(s_t) + \sigma_\psi(s_t)\,\epsilon_t\big),\qquad \epsilon_t \sim \Normal(0, 1) $$그러면 λ-리턴은 $\psi$ 의 보통의 미분 가능한 함수 가 됩니다. $\psi$ → 행동 $a_t$ → 다음 상태 $s_{t+1}$ → 보상 $\hat{r}_t$ · 가치 $v(s_{t+1})$ → λ-리턴으로 이어지는 계산 그래프를 역전파(4장)로 거슬러 올라가면 기울기가 나옵니다. 이것이 “World Model 을 거슬러 미분한다(backpropagate through the dynamics)” 는 말의 뜻입니다.
실제 세상(진자의 물리)은 미분할 수 없는 “블랙박스” 이지만, World Model 은 처음부터 끝까지 미분 가능한 신경망입니다. 그래서 Dreamer 는 “행동을 이만큼 바꾸면 미래 리턴이 이만큼 바뀐다” 는 해석적 기울기를 얻습니다. 이것이 학습된 World Model 이 주는 가장 큰 선물 중 하나입니다. 대가도 있습니다. 모델이 틀린 곳에서는 기울기도 틀리므로, 액터가 모델의 오류를 “이용” 할 수 있습니다. 실제 데이터를 계속 모아 모델을 고치는 것이 그래서 중요합니다.
무엇이 고쳐지고 무엇이 멈추는가
액터 손실의 기울기는 상상 궤적 전체를 거슬러 흐르지만, 고쳐지는 것은 액터의 매개변수 $\psi$ 뿐 이어야 합니다. 정리하면 다음과 같습니다.
| 위치 | 처리 | 이유 |
|---|---|---|
| 상상의 출발점 $s_0$ | states["h"].detach() | 출발점은 데이터로 정해진 상수. 액터 손실이 World Model 학습(사후)을 건드리지 않게 |
| World Model 매개변수 $\theta$ | self.wm.requires_grad_(False) (기울기는 통과) | 모델은 데이터로만 배운다는 원칙. 액터 옵티마이저에는 액터 매개변수만 들어 있어 얼리지 않아도 모델이 바뀌지는 않지만, 얼려 두면 모델 매개변수 쪽 기울기를 아예 계산하지 않아 빠르고, 액터 손실의 기울기가 모델의 .grad 에 섞일 여지도 없다 |
| 느린 크리틱 매개변수 | requires_grad_(False) (기울기는 통과) | $v(s_{t+1})$ 을 거쳐 상태 쪽으로는 기울기가 흘러야 하지만, 크리틱 자체는 바뀌면 안 된다 |
| 액터의 입력 상태 | actor.sample(feats[-1].detach()) | DreamerV1 공개 코드와 같은 처리(논문 식에는 드러나지 않는 구현상의 선택). “행동 $a_t$ → 다음 상태들 → 보상 · 가치” 길의 기울기만 남고, “$a_t$ 가 $s_{t+1}$ 을 바꿔 다음 행동 $a_{t+1} = \pi_\psi(s_{t+1})$ 까지 바꾸는” 길($\partial a_{t+1}/\partial s_{t+1}$)은 무시된다. 엄밀한 전미분에서 이 항을 뺀 근사 |
| 크리틱의 목표 $V^\lambda_t$ | returns.detach() | 부트스트랩 목표는 상수 (위 절) |
| 크리틱의 입력 상태 | feats[:-1].detach() | 크리틱 손실이 상상 궤적(액터 · 모델)을 건드리지 않게 |
requires_grad_(False) 는 그 매개변수로 가는 기울기를 계산하지 않을 뿐, 그 층을 지나 앞쪽(입력)으로 흐르는 기울기는 막지 않습니다.
반면 .detach() 는 그 텐서에서 계산 그래프를 잘라, 그 너머로는 기울기가 전혀 흐르지 않습니다. 액터 학습에는 World Model 을 “얼려야” 지 “끊으면” 안 됩니다.
끊으면 행동이 미래에 주는 영향이 보이지 않으니까요.
tanh-가우시안 정책
진자의 행동(토크)은 $[-2, 2]$ 범위입니다. 우리는 $[-1, 1]$ 로 정규화해 다루고 환경에 줄 때 2 를 곱합니다. 가우시안은 범위가 무한하므로, 가우시안에서 뽑은 값 $u$ 를 $\tanh$ 로 눌러 $(-1, 1)$ 안에 넣습니다.
mean = 5 * torch.tanh(mean / 5): 평균을 $[-5, 5]$ 로 부드럽게 묶습니다. $\tanh(5) \approx 0.9999$ 라 그 이상은 의미가 없고, 너무 크면 $\tanh$ 가 포화되어 기울기가 사라지기 때문입니다(DreamerV1 의 방법).F.softplus(std + self.raw_init_std): 처음 출력이 0 근처일 때 표준편차가init_std(=1)가 되도록 softplus 의 역함수 값을 더해 둡니다. $\operatorname{softplus}^{-1}(1) = \log(e^1 - 1) \approx 0.541$.u = mean + std * eps: 재매개변수화.mode()는 평가할 때 쓰는 결정적 행동 $\tanh(\mu)$ 입니다.
엔트로피 보너스와 변수 바꾸기
액터가 너무 일찍 한 가지 행동만 고집하면 새로운 것을 시도하지 않습니다. 엔트로피 $\mathcal{H}[\pi]$(3장)는 분포가 얼마나 퍼져 있는지를 재므로, 손실에서 $\eta\,\mathcal{H}$ 를 빼면(= 엔트로피를 키우면) 탐험이 유지됩니다. 그런데 $a = \tanh(u)$ 로 바꾼 분포의 엔트로피는 어떻게 계산할까요?
gauss_ent + log_det 입니다($10^{-6}$ 은 $\log 0$ 을 막는 작은 수).
예: $\sigma = 1$ 이면 첫 부분은 $\frac{1}{2}\log(2\pi e) \approx 1.419$. 연속 분포의 엔트로피(미분 엔트로피)는 음수가 될 수 있다 는 점에 주의하세요. 학습 로그의 ent 가 음수인 것은 정상입니다.
계수 $\eta$ 는 작게($10^{-4}$) 둡니다. DreamerV1 원본은 엔트로피 보너스 없이 데이터를 모을 때 행동에 잡음 $\Normal(0, 0.3^2)$ 을 더하는 것으로 탐험했고, 이후 버전들은 엔트로피 보너스를 씁니다. 우리 구현은 둘 다 씁니다.
전체 알고리즘
데이터 D ← 무작위 행동 에피소드 S 개
되풀이:
    C 번 되풀이:
        # ① 모델 학습 (11장)
        D 에서 B×L 조각 → 순차 ELBO 로 θ, φ 한 스텝 → 사후 상태 {(h, z)} B·L 개
        # ② 상상 속 행동 학습
        출발점 s_0 ← 사후 상태들 (기울기 차단)
        t = 0..H-1:  a_t ~ π_ψ(·|sg(s_t)),  s_{t+1} ← RSSM 사전(s_t, a_t),  r̂_t ← R(s_{t+1})
        V^λ_t ← 뒤에서부터 재귀식 (느린 크리틱 v 사용)
        액터:   ψ ← ψ − α_ψ ∇_ψ [ −mean(V^λ) − η·mean(H[π]) ]   (World Model 을 거슬러 역전파)
        크리틱: ξ ← ξ − α_ξ ∇_ξ mean( ½ (v_ξ(sg(s_t)) − sg(V^λ_t))² )
        100 번마다 느린 크리틱 ← 크리틱
    # ③ 환경과 상호작용
    에피소드 하나: 매 결정마다 그림으로 (h, z) 갱신 → a ~ π_ψ + 잡음 N(0, 0.3²) → 실행
    D 에 추가
코드의 ① 은 의사코드의 ① 이고, ② ~ ⑤ 는 의사코드 ② 안의 네 줄(상상 · 액터 · 크리틱 · 느린 크리틱 복사)에 해당합니다. 한 번의 train_step 안에서 세 개의 옵티마이저(World Model · 액터 · 크리틱)가 각자의 손실로 한 스텝씩 움직입니다.
self.wm.requires_grad_(False) 와 (True) 사이가 “World Model 을 얼린 채 상상하는” 구간입니다.
하이퍼파라미터
| 이름 | 뜻 | 우리 값 | DreamerV1 논문 |
|---|---|---|---|
| World Model | RSSM · 인코더 · 디코더 · 보상 | 11장과 같음 (h 200, z 30, 자유 내트 3) | 같음 |
| $H$ | 상상 길이 | 15 | 15 |
| $\gamma$ / $\lambda$ | 할인율 / λ-리턴 | 0.99 / 0.95 | 0.99 / 0.95 |
| 학습률 | 모델 / 액터 / 크리틱 | $6\times10^{-4}$ / $8\times10^{-5}$ / $8\times10^{-5}$ | 같음 |
| $B \times L$ | 배치 | 50 × 50 | 50 × 50 |
| 액터 · 크리틱 | MLP | 너비 300, 은닉층 3개, ELU | 비슷한 크기의 ELU MLP |
| 기울기 자르기 | 노름 상한 | 100 | 100 |
| 탐험 잡음 | 수집할 때 | 0.3 | 0.3 |
| 엔트로피 $\eta$ | 보너스 계수 | $10^{-4}$ | — (잡음으로 탐험) |
| 느린 크리틱 | 복사 주기 | 100 스텝 | — (V2 부터) |
| $S$, $C$, 행동 반복 | 시드 · 학습 횟수 · 반복 | 5, 100, 2 | 5, 100, 2 |
| 보상 배율 | 학습용 보상 크기 | 0.1 | — (DMC 보상은 이미 0 ~ 1) |
진자의 보상은 한 결정에 최저 $-33$ 까지 내려가고 $\gamma = 0.99$ 면 가치가 수백 ~ 천 단위가 됩니다. 크리틱의 출력은 처음 0 근처에서 시작해 학습률 $8\times10^{-5}$ 로 천천히 움직이므로, 그런 큰 값에 도달하는 데만 아주 오래 걸립니다. 보상에 0.1 을 곱하면 가치가 DMC(DreamerV1 이 실험한 과제들)와 비슷한 크기가 됩니다. DreamerV3 는 이 문제를 symlog 와 리턴 정규화로 근본적으로 풉니다(뒤 절).
실행 결과
본문 설정 그대로(python ch12_dreamer.py --planet-log ch11_out/log.json) 노트북 GPU(8GB)에서 11장의 PlaNet 과 같은 시드 · 같은 환경 스텝 수(21,000) 로 돌렸습니다.
두 학습이 GPU 를 나눠 썼으므로 혼자 돌리면 더 빠릅니다. imag G 는 상상 궤적의 평균 λ-리턴(보상 배율 0.1 이 곱해진 값),
ent 는 액터의 엔트로피 추정값, act 는 실제 환경에서 결정 한 번에 걸린 시간입니다. 맨 처음 찍히는 device=… 설정 줄은 출력 상자에서 생략했습니다.
$ python ch12_dreamer.py --planet-log ch11_out/log.jsonlambda-return check: recursion vs definition max |diff| = 2.38e-07 random policy return: -1194.5 it 1 | env steps 1200 | recon 78.5 kl 1.15 | imag G -6.12 critic 11.788 ent -1.21 | return -1445.7 | act 8.5 ms | 66s it 2 | env steps 1400 | recon 23.8 kl 4.60 | imag G -14.08 critic 12.012 ent -2.91 | return -1257.8 | act 4.7 ms | 119s it 3 | env steps 1600 | recon 5.9 kl 3.14 | imag G -19.05 critic 9.342 ent -3.36 | return -1513.0 | act 12.8 ms | 180s … it 10 | env steps 3000 | recon 1.9 kl 2.78 | imag G -30.42 critic 5.457 ent -5.15 | return -759.9 | act 2.7 ms | 598s | eval -167.8 it 20 | env steps 5000 | recon 1.1 kl 2.74 | imag G -27.44 critic 4.196 ent -5.70 | return -385.2 | act 2.3 ms | 1075s | eval -257.7 it 30 | env steps 7000 | recon 0.8 kl 2.72 | imag G -29.70 critic 9.621 ent -6.60 | return -901.4 | act 3.9 ms | 1562s | eval -307.9 it 40 | env steps 9000 | recon 0.6 kl 2.66 | imag G -30.65 critic 4.616 ent -6.57 | return -6.2 | act 7.3 ms | 2060s | eval -224.8 it 50 | env steps 11000 | recon 0.7 kl 2.67 | imag G -26.70 critic 7.834 ent -6.87 | return -520.6 | act 5.0 ms | 2529s | eval -805.8 it 60 | env steps 13000 | recon 0.5 kl 2.58 | imag G -25.05 critic 8.616 ent -7.04 | return -271.0 | act 4.4 ms | 3002s | eval -133.4 it 70 | env steps 15000 | recon 0.4 kl 2.70 | imag G -22.37 critic 7.844 ent -7.20 | return -626.1 | act 4.2 ms | 3450s | eval -219.4 it 80 | env steps 17000 | recon 0.4 kl 2.66 | imag G -16.64 critic 8.453 ent -7.29 | return -640.9 | act 4.2 ms | 3888s | eval -419.3 it 90 | env steps 19000 | recon 0.4 kl 2.59 | imag G -13.25 critic 5.376 ent -7.50 | return -392.9 | act 4.5 ms | 4325s | eval -138.4 it 100 | env steps 21000 | recon 0.4 kl 2.62 | imag G -8.73 critic 4.260 ent -6.90 | return -129.7 | act 4.3 ms | 4799s | eval -134.5 final eval over 10 episodes: mean -196.4, std 120.9, min -393.3, max -3.3 done in 4806s
학습 곡선: PlaNet 과 비교
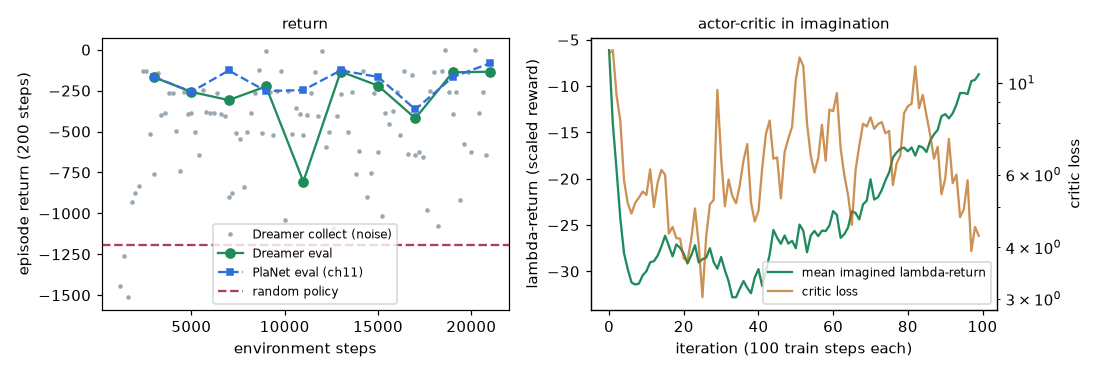
- 같은 출발. Dreamer 도 환경 스텝 3,000 에서 평가 리턴 −168 로, PlaNet(−166)과 거의 같은 속도로 진자를 세우기 시작합니다. 이 시점까지 액터는 실제 환경에서 겨우 10 에피소드를 겪었지만, 상상 속에서는 $100 \times 10 \times 2500 \times 15 \approx 3{,}750$만 스텝을 경험했습니다.
- 더 흔들립니다. 평가 리턴이 11,000 스텝에서 −806 까지 떨어졌다가 회복합니다. 계획(PlaNet)은 매 순간 새로 최적화하므로 모델이 조금 바뀌어도 결과가 크게 흔들리지 않지만, 액터는 모델 · 크리틱의 오차까지 함께 “배워” 버릴 수 있습니다(모델 착취). 탐험 잡음을 넣은 수집 리턴(회색)도 PlaNet 보다 넓게 흩어집니다.
- 상상 속 리턴은 후반에 오릅니다. 오른쪽 그래프의 λ-리턴은 처음 40회 남짓 −30 근처(−26 ~ −33)에 머물다가 −9 까지 올라갑니다. 2500개 출발점 전체에서 “빨리 세우고 오래 버티는” 행동을 배워 가고 있다는 뜻입니다. 처음 몇 회에 λ-리턴이 −6 에서 −30 으로 내려가는 것은, 학습 초반의 보상 모델과 크리틱이 0 근처의 엉터리 값을 내다가 진짜 보상(음수)을 배우면서 생기는 일입니다.
그림만 보고 세우기
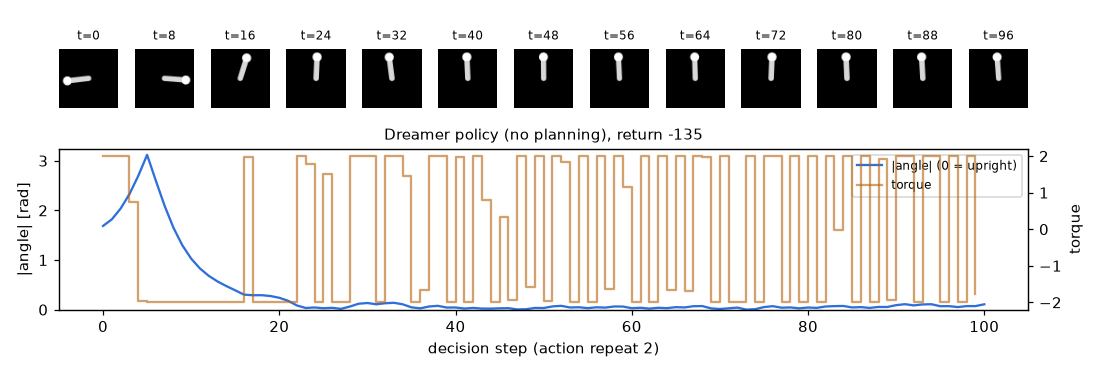
전략은 PlaNet 과 같습니다. 먼저 아래로 떨어뜨려 반동을 모으고(결정 0 ~ 5), 반대 방향 최대 토크로 끌어올린 뒤(결정 5 ~ 16), 꼭대기에서 균형을 잡습니다. 눈에 띄는 차이는 토크 모양 입니다. Dreamer 는 거의 늘 $+2$ 아니면 $-2$ 만 냅니다(“뱅뱅 제어”). 로그의 엔트로피가 $-7$ 근처까지 내려간 것과 같은 현상으로, tanh 앞의 값이 커져 행동이 $\pm 1$ 에 붙은 것입니다. 진자처럼 토크가 약한 과제에서는 뱅뱅 제어도 꽤 좋은 정책이라 균형은 잘 잡지만, 꼭대기에서 막대가 미세하게 떨립니다. PlaNet 은 정예 100개의 평균을 쓰므로 꼭대기에서 작은 토크를 내는 부드러운 행동이 나옵니다(그림 11-6).
상상 vs 진짜
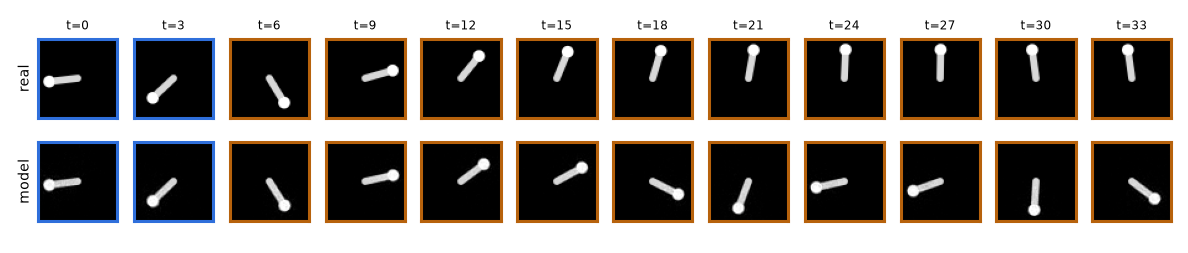
Dreamer 의 World Model 도 처음 몇 스텝(t = 5 ~ 9)은 진짜와 거의 같게 상상하지만, t = 12 무렵부터 뒤처지기 시작해, 진짜 진자가 꼭대기에 서는 동안 상상 속 진자는 꼭대기에 닿지 못하고 도로 떨어져 아래에서 흔들립니다. 상상 길이 $H = 15$ 를 넘는 먼 미래는 크리틱이 맡고, 실제로 행동할 때는 매 순간 새 그림으로 믿음 상태를 고쳐 잡으므로 이 오차가 정책을 망치지는 않습니다. 하지만 꼭대기 근처의 상상이 부정확하다는 것은 액터가 “꼭대기에서의 미세한 균형” 을 배우기 어렵다는 뜻이기도 해서, 앞에서 본 뱅뱅 제어 · 떨림과 무관하지 않습니다.
PlaNet 과 Dreamer 비교
두 에이전트 모두 학습을 마친 뒤, 처음 보는 같은 시작 상태 10개로 평가했습니다.
| 정책 | 평균 리턴 (10 에피소드) | 표준편차 | 최저 / 최고 | 결정 한 번에 걸린 시간 |
|---|---|---|---|---|
| 무작위 행동 | −1194.5 | — | — | — |
| PlaNet (11장, CEM 계획) | −196.8 | 113.7 | −376.2 / −0.5 | 약 100 ms |
| Dreamer (액터) | −196.4 | 120.9 | −393.3 / −3.3 | 약 5 ms |
결정 시간은 환경 한 스텝 · 그림 그리기 · 인코더까지 포함한 값이라, 계획 자체만 비교하면 차이가 더 큽니다. 정리하면, 이 작은 실험(환경 스텝 21,000)에서 Dreamer 는 PlaNet 과 같은 성능을 약 20배 빠른 결정 으로 냈고, 대신 학습 과정은 더 출렁였습니다. Dreamer 논문은 DMC 의 20개 과제에서 Dreamer 가 기존 방법(PlaNet 포함)보다 데이터 효율 · 계산 시간 · 최종 성능 모두 앞섰다고 보고합니다. 우리 과제는 계획 길이 12 스텝으로도 충분히 내다볼 수 있을 만큼 짧은 과제라, 가치 함수로 지평선 너머를 보는 Dreamer 의 장점이 드러나기 어렵습니다.
| 항목 | 값 |
|---|---|
| 전체 학습 시간 (노트북 GPU, PlaNet 과 함께) | 4,806초 ≈ 80분 |
같은 GPU 를 혼자 쓸 때 (아래 --return-norm 실행) | 2,575초 ≈ 43분, 결정 한 번 약 1.5 ms |
| 학습 한 스텝 (CPU 4스레드, $B = 50$) | 약 23초 → 본문 설정(1만 스텝)은 CPU 로 사실상 불가능 |
같은 것, --batch-size 16 | 약 5초 → 1만 스텝에 반나절 이상 |
--quick (CPU) | 약 15초 (동작 확인용) |
학습 시간은 PlaNet 과 비슷합니다. 학습 한 스텝은 상상 · 액터 · 크리틱이 더해져 더 무겁지만, 데이터를 모을 때 계획이 없어 그만큼 빠르기 때문입니다. CPU 로는 11장과 마찬가지로 무거우므로 GPU(예: Google Colab)를 권합니다.
덤: DreamerV3 식 리턴 정규화를 켜 보면
뒤에서 설명할 DreamerV3 의 리턴 정규화를 --return-norm 으로 켜고, 다른 것은 모두 같게(같은 시드) 한 번 더 돌려 보았습니다.
이번에는 GPU 를 혼자 써서 학습 전체가 2,575초(약 43분) 걸렸습니다.
$ python ch12_dreamer.py --return-normit 10 | env steps 3000 | … | eval -204.7 it 20 | env steps 5000 | … | eval -603.9 it 30 | env steps 7000 | … | eval -448.6 it 40 | env steps 9000 | … | eval -331.1 it 50 | env steps 11000 | … | eval -252.2 it 60 | env steps 13000 | … | eval -140.0 it 70 | env steps 15000 | … | eval -486.4 it 80 | env steps 17000 | … | eval -447.7 it 90 | env steps 19000 | … | eval -179.9 it 100 | env steps 21000 | recon 0.4 kl 2.64 | imag G -16.20 critic 7.012 ent -7.95 | return -134.8 | act 1.5 ms | 2571s | eval -267.8 final eval over 10 episodes: mean -248.5, std 117.5, min -392.6, max -132.3 done in 2575s
| 설정 | 최종 평균 리턴 (10 에피소드) | 학습 중 평가 리턴의 범위 |
|---|---|---|
| Dreamer (기본) | −196.4 ± 120.9 | −806 ~ −133 |
| Dreamer + 리턴 정규화 | −248.5 ± 117.5 | −604 ~ −140 |
결과는 나아지지 않았습니다. 정직하게 해석하면 이렇습니다.
- 시드 하나의 비교는 결론이 되지 못합니다. 두 설정 모두 학습 중 평가 리턴이 수백씩 출렁이므로, 평균 50 정도의 차이는 운(시드)으로도 충분히 생깁니다. 제대로 비교하려면 시드를 5개 이상 돌려 평균과 신뢰 구간을 봐야 합니다.
- V3 의 기법은 한 묶음입니다. 리턴 정규화는 엔트로피 계수 $3\times10^{-4}$, symlog · two-hot 크리틱, 느린 크리틱의 정규화 등과 함께 맞춰진 것이라, 하나만 떼어 V1 에 붙이면 효과가 그대로 나오지 않을 수 있습니다.
- 이 과제는 이미 보상 배율로 크기를 맞췄습니다. 리턴 정규화의 장점은 “과제마다 손으로 맞추지 않아도 된다” 는 데 있는데, 우리는 이미 보상 배율 0.1 로 손질을 해 두었으니 더 얻을 것이 적습니다.
실험이 기대와 다르게 나오는 것은 흔한 일입니다. 중요한 것은 “왜 그럴 수 있는지” 를 따져 보고, 결론을 내리기 전에 실험을 충분히(여러 시드로) 반복하는 습관입니다.
DreamerV2: 범주형 잠재와 KL 균형
DreamerV1 은 연속 제어 과제(DMC)에서 뛰어났지만, Atari 게임처럼 장면이 갑자기 바뀌는 과제에서는 약했습니다. Hafner, Lillicrap, Norouzi, Ba 의 Mastering Atari with Discrete World Models(ICLR 2021), 즉 DreamerV2 는 World Model 만으로 학습한 에이전트로는 처음으로 Atari 55개 게임에서 사람 수준의 성능을 냈습니다. 핵심 변화 세 가지를 원리부터 봅시다.
범주형 잠재 변수
V1 의 $z_t$ 는 30차원 가우시안이었습니다. V2 는 대신 32개의 범주형 변수 를 쓰고, 각 변수가 32개 범주 중 하나를 원-핫 벡터로 가집니다. 32 × 32 = 1024 칸 중 32칸만 1 인 성긴 벡터입니다. 논문은 범주형이 왜 더 나은지 확실히는 모른다고 밝히면서 다음 가설들을 듭니다.
- 가우시안 하나는 봉우리가 하나지만, 범주형은 “적이 왼쪽에서 나온다 / 오른쪽에서 나온다” 처럼 여러 봉우리 의 미래를 자연스럽게 표현합니다.
- 게임 화면의 갑작스러운 전환(장면 바뀜, 아이템 획득)처럼 불연속적인 변화 에 어울립니다.
- 최적화가 더 잘 될 수 있습니다(직선 통과 기울기가 재매개변수화 기울기보다 다루기 쉬울 수 있다는 추측).
직선 통과 추정기
범주형 표본(원-핫)은 확률 $p$ 의 계단 함수 라 미분이 0 이거나 정의되지 않습니다. 재매개변수화를 쓸 수 없는 것입니다. V2 는 직선 통과 추정기straight-through estimator 를 씁니다.
$$ z = \operatorname{onehot} + p - \sg(p) $$예: 범주 3개짜리 변수의 확률이 $p = (0.2,\ 0.7,\ 0.1)$ 이고 두 번째 범주가 뽑혔다면, 순전파 값은 $z = (0, 1, 0)$ 이지만 역전파에서는 $\partial\mathcal{L}/\partial z = (g_1, g_2, g_3)$ 가 그대로 $\partial\mathcal{L}/\partial p$ 가 되어 세 확률 모두로 흘러갑니다. PyTorch 로는 한 줄입니다.
probs = logits.softmax(-1)                                   # (..., 32, 32)
idx = torch.distributions.Categorical(probs=probs).sample()  # (..., 32)
onehot = F.one_hot(idx, 32).float()
z = onehot + probs - probs.detach()                          # 값은 원-핫, 기울기는 probs 로
KL 균형
순차 ELBO 의 KL 항 $\KL(q \,\|\, p)$ 는 사후 $q$ 와 사전 $p$ 를 서로에게 끌어당깁니다(11장). 그런데 둘이 같은 속도로 끌려가면 문제가 생깁니다. 학습 초반 사전은 아직 엉망인데, 사후가 그 엉망인 사전 쪽으로 끌려가 그림의 정보를 덜 담게 되는 것입니다. 바람직한 것은 사전이 사후를 따라가는 것(동역학을 배우는 것)입니다. V2 의 KL 균형KL balancing 은 기울기 차단으로 이 비율을 조절합니다.
$$ \mathcal{L}_{\text{KL}} = \alpha\,\KL\big(\sg(q)\ \|\ p\big) + (1 - \alpha)\,\KL\big(q\ \|\ \sg(p)\big),\qquad \alpha = 0.8 $$이산 행동과 REINFORCE
Atari 의 행동은 “위 · 아래 · 발사” 같은 이산 행동이라, 행동에 대해 재매개변수화 경사를 쓸 수 없습니다. 그래서 V2 는 Atari 에서 5장의 REINFORCE 를 상상 궤적에 적용합니다.
$$ \mathcal{L}(\psi) = -\sum_{t}\Big[\rho\,\log\pi_\psi(a_t \mid s_t)\,\sg\big(V^\lambda_t - v_\xi(s_t)\big) + (1-\rho)\,V^\lambda_t + \eta\,\mathcal{H}[\pi_\psi(\cdot \mid s_t)]\Big] $$$\rho$ 는 두 추정기를 섞는 비율로, 논문은 Atari 에서 $\rho = 1$(REINFORCE 만), 연속 제어에서 $\rho = 0$(동역학 역전파만)을 썼습니다. $V^\lambda_t - v_\xi(s_t)$ 는 이점(advantage) 입니다. 크리틱 값(기준선, baseline)을 빼도 기울기의 기댓값이 변하지 않는 이유를 확인해 봅시다.
이 밖에 V2 는 느린 목표 크리틱(우리 구현이 쓴 것), 층 정규화 등 여러 실전 기법을 더했습니다.
DreamerV3: 하나의 설정으로 여러 영역
강화학습 알고리즘의 고질병은 과제마다 하이퍼파라미터를 새로 맞춰야 한다는 것입니다. 우리도 진자를 위해 “보상 배율 0.1” 을 손으로 골랐지요. Hafner, Pasukonis, Ba, Lillicrap 의 DreamerV3(2023년 arXiv 공개, 2025년 Nature 게재, Mastering diverse control tasks through world models)는 하나의 고정된 설정 으로 Atari, DMC, Minecraft 등 150개가 넘는 과제에서 좋은 성능을 냈고, 사람의 데이터나 교과 과정 없이 처음부터 Minecraft 에서 다이아몬드를 캐낸 첫 알고리즘이 되었습니다. 비결은 “신호의 크기에 흔들리지 않게 만드는” 일련의 기법입니다.
symlog 와 symexp
과제마다 보상과 관측 숫자의 크기는 천차만별입니다(진자는 $-16$ ~ $0$, 어떤 게임은 수천). 제곱 오차로 큰 숫자를 맞추려 하면 기울기가 폭발하고, 작은 숫자는 묻힙니다. V3 는 예측 대상을 symlogsymmetric logarithm 로 눌러서 학습하고, 쓸 때 symexp 로 되돌립니다.
$$ \operatorname{symlog}(x) = \operatorname{sign}(x)\,\log\big(|x| + 1\big),\qquad \operatorname{symexp}(x) = \operatorname{sign}(x)\big(\exp(|x|) - 1\big) $$일반 로그와 달리 0 과 음수에서도 정의되고(부호를 지킴), 원점 근처에서는 기울기가 1 이라 작은 값을 망가뜨리지 않는다는 점이 핵심입니다. V3 는 벡터 관측의 입력 · 복원 대상, 보상 · 가치 예측에 이 변환을 씁니다.
two-hot 인코딩
보상과 가치는 symlog 로 눌러도 여전히 “숫자 하나를 맞히는” 회귀 문제입니다. V3 는 이것을 분류 문제 로 바꿉니다. symlog 공간에 일정 간격의 칸(bin) $b_1 \lt b_2 \lt \cdots \lt b_K$ 를 깔아 두고(arXiv 초판은 $-20$ 에서 $20$ 까지 255칸), 신경망은 칸들에 대한 소프트맥스 확률 $p_1, \dots, p_K$ 를 내놓습니다. 목표값 $y$ 는 그것을 끼고 있는 두 이웃 칸에 나눠 담은 벡터로 바꿉니다. 이것이 two-hot 인코딩two-hot encoding 입니다.
예: 보상 $r = 10$ 이면 $y = \operatorname{symlog}(10) \approx 2.398$. 칸 간격이 1 이고 $b_k = 2$, $b_{k+1} = 3$ 이라면 $w_k = (3 - 2.398)/1 = 0.602$, $w_{k+1} = 0.398$. 확인: $0.602 \times 2 + 0.398 \times 3 = 1.204 + 1.194 = 2.398$.
손실은 목표 가중치와 예측 확률 사이의 교차 엔트로피 $-\sum_i w_i \log p_i$ (3장)이고, 예측값은 $\hat{y} = \operatorname{symexp}\big(\sum_i p_i\, b_i\big)$ 입니다. 교차 엔트로피의 기울기는 $p - w$ 꼴(4장)로 크기가 늘 1 이하라서, 목표값이 1 이든 10000 이든 기울기의 크기가 목표의 크기와 무관 해집니다. 이것이 분류로 바꾸는 이유입니다. (여기까지는 arXiv 초판의 서술입니다. 2024년 개정판은 같은 생각을 조금 다르게 적습니다. 칸 자체를 $b = \operatorname{symexp}(-20, \dots, 20)$ 으로 지수 간격 으로 깔고, 목표값을 그대로 two-hot 으로 바꾸며, 예측값은 $\hat{y} = \sum_i p_i\, b_i$ 로 읽습니다. symexp 가 평균의 바깥에서 안으로 들어간 것입니다.)
자유 비트(free bits)와 KL 나누기
V3 는 11장의 자유 내트(free nats)를 1 내트로 쓰고(논문은 “free bits” 라고 부릅니다), V2 의 KL 균형을 두 개의 손실로 나눠 각각에 적용합니다.
$$ \mathcal{L}_{\text{dyn}} = \max\Big(1,\ \KL\big(\sg(q)\ \|\ p\big)\Big),\qquad \mathcal{L}_{\text{rep}} = \max\Big(1,\ \KL\big(q\ \|\ \sg(p)\big)\Big),\qquad \mathcal{L} = \mathcal{L}_{\text{pred}} + \beta_{\text{dyn}}\,\mathcal{L}_{\text{dyn}} + \beta_{\text{rep}}\,\mathcal{L}_{\text{rep}} $$$\mathcal{L}_{\text{dyn}}$ 은 사전(동역학)을, $\mathcal{L}_{\text{rep}}$ 은 사후(표현)를 학습시킵니다. 가중치는 논문의 판에 따라 다릅니다. arXiv 초판(2023년 1월)은 $\beta_{\text{dyn}} = 0.5$, $\beta_{\text{rep}} = 0.1$ 이고, arXiv 개정판(2024년)은 $\beta_{\text{dyn}} = 1$, $\beta_{\text{rep}} = 0.1$ 입니다. 어느 쪽이든 사전 쪽 가중치가 훨씬 커서 V2 의 $\alpha = 0.8$ 과 같은 역할을 합니다(초판 $0.5/0.6 \approx 0.83$, 개정판 $1/1.1 \approx 0.91$). $\mathcal{L}_{\text{pred}}$ 는 재구성 · 보상 · 계속 여부(에피소드가 끝나는지) 예측 손실입니다. KL 이 1 내트 아래로 내려가면 그 항의 기울기가 꺼지는 것은 11장에서 유도한 그대로입니다.
unimix: 1% 의 균등 분포 섞기
범주형 분포의 어떤 범주 확률이 0 에 가까워지면 KL 의 $\log(q/p)$ 가 폭발할 수 있습니다. V3 는 신경망이 낸 확률에 균등 분포를 1% 섞습니다.
$$ p_i = 0.99\cdot\operatorname{softmax}(\ell)_i + 0.01\cdot\frac{1}{K} $$그러면 모든 범주의 확률이 적어도 $0.01/K$ 이므로, 어떤 $q_i \le 1$ 에 대해서도 $\log(q_i/p_i) \le \log\big(1/(0.01/K)\big) = \log(100K)$ 로 위가 막힙니다. $K = 32$ 면 $\log 3200 \approx 8.07$ 입니다. 같은 기법을 이산 행동의 정책에도 씁니다.
리턴 정규화
액터의 기울기 크기는 리턴의 크기에 비례합니다. 보상이 큰 과제에서는 액터 기울기가 엔트로피 보너스를 압도하고(탐험 부족), 보상이 작은 과제에서는 반대가 됩니다. V3 는 리턴을 그 퍼진 폭 으로 나눠 크기를 맞춥니다.
$$ S = \operatorname{EMA}\Big(\operatorname{Per}(V^\lambda, 95) - \operatorname{Per}(V^\lambda, 5),\ 0.99\Big),\qquad \text{액터가 쓰는 값} = \frac{V^\lambda_t - v_\xi(s_t)}{\max(1,\ S)} $$- $\operatorname{Per}(\cdot, 95)$ 는 배치 안 리턴들의 95 백분위수입니다. 최댓값 · 최솟값 대신 백분위수를 써서 튀는 값에 흔들리지 않습니다.
- EMA(지수 이동 평균, 계수 0.99)로 배치마다 출렁이지 않게 부드럽게 따라갑니다: $S \leftarrow 0.99\,S + 0.01\,(\text{이번 폭})$.
- $\max(1, S)$ 인 까닭: 보상이 거의 없는(희소한) 과제에서 작은 리턴 차이(잡음)를 크게 부풀리지 않기 위해서입니다. 폭이 1 보다 클 때만 줄입니다.
- 엔트로피 계수는 모든 과제에서 $\eta = 3 \times 10^{-4}$ 로 고정됩니다. 리턴의 크기가 맞춰졌기 때문에 가능한 일입니다.
위 식처럼 크리틱 값을 뺀 이점에 REINFORCE 를 쓰는 것은 2024년 개정판의 꼴입니다(이산 · 연속 행동 모두). arXiv 초판은 $\sg(V^\lambda_t)/\max(1, S)$ 를 쓰고, V2 처럼 연속 행동에는 동역학 역전파를, 이산 행동에는 REINFORCE 를 썼습니다.
우리 코드에는 이 정규화를 --return-norm 옵션으로 넣었습니다(train_step 의 if cfg.return_norm:). 동역학 역전파를 쓰므로 초판처럼 $v_\xi(s_t)$ 를 빼지 않고 리턴을 그대로 나눕니다.
세 버전 한눈에
| DreamerV1 (2020) | DreamerV2 (2021) | DreamerV3 (2023 · 2025) | |
|---|---|---|---|
| 잠재 $z$ | 가우시안 30차원 | 범주형 32 × 32 (직선 통과) | 범주형 + unimix 1% |
| KL | 자유 내트 3 | KL 균형 $\alpha = 0.8$ | dyn 0.5(개정판 1) / rep 0.1, 자유 비트(free bits) 1 |
| 보상 · 가치 | 가우시안 회귀 | 가우시안 회귀 | symlog + two-hot 분류 |
| 액터 기울기 | 동역학 역전파 | Atari: REINFORCE / 연속: 역전파 | 정규화한 리턴(초판) · 이점 + REINFORCE(개정판) |
| 크리틱 목표 | λ-리턴 | λ-리턴 + 느린 크리틱 | λ-리턴 + 느린 크리틱(EMA) |
| 대표 성과 | DMC 20개 과제 | Atari 55개, 사람 수준 | 150여 과제 고정 설정, Minecraft 다이아몬드 |
자주 겪는 문제
| 증상 | 흔한 원인 | 해 볼 것 |
|---|---|---|
상상 리턴(imag G)은 오르는데 실제 리턴은 그대로 | 액터가 World Model 의 오류를 이용 (모델 착취) | 데이터를 더 모은다. 탐험 잡음 · 엔트로피 유지. 상상 vs 진짜 그림으로 모델 확인 |
| 크리틱 손실이 계속 커진다 | 가치의 크기가 너무 큼, 목표가 흔들림 | 보상 배율, 느린 크리틱, (V3) 리턴 정규화 · two-hot |
| 액터가 늘 $\pm 1$ 만 낸다 | $\tanh$ 포화. 진자에서는 사실 이 “뱅뱅 제어” 가 꽤 좋은 정책이다 | 문제가 될 때만 엔트로피 계수를 키운다 |
| 학습 초반 리턴이 무작위보다 나쁘다 | 모델이 아직 엉망이라 상상 속 최적 행동이 실제로는 나쁨 | 정상. 데이터가 쌓이면 나아진다. 시드 에피소드 수를 늘려도 된다 |
| NaN | $\log(1 - a^2)$ 에서 $a = \pm 1$, 표준편차 0 | 작은 수 더하기($10^{-6}$), 최소 표준편차, 기울기 자르기 |
- PlaNet 의 계획은 비싸고(결정마다 12만 스텝) 근시안적입니다. Dreamer 는 상상 속에서 액터 · 크리틱을 학습 해 결정할 때 신경망 한 번으로 행동합니다.
- 상상은 World Model 학습에서 얻은 사후 상태 2500개 에서 출발해 액터와 RSSM 사전으로 $H = 15$ 스텝 굴립니다.
- λ-리턴 은 n-스텝 리턴들의 가중 평균이고(가중치 합 1), 재귀식 $V^\lambda_t = \hat{r}_t + \gamma[(1-\lambda)v(s_{t+1}) + \lambda V^\lambda_{t+1}]$, $V^\lambda_H = v(s_H)$ 로 계산합니다.
- 크리틱은 $\sg(V^\lambda_t)$ 에 회귀하고, 액터는 World Model 을 거슬러 미분 해 λ-리턴을 키웁니다(재매개변수화 경사). 모델은 얼리고(
requires_grad_(False)) 끊지는 않습니다. - tanh-가우시안 정책의 엔트로피는 변수 바꾸기 공식으로 $\mathcal{H}[u] + \E[\log(1 - a^2)]$ 입니다.
- V2: 범주형 잠재 + 직선 통과 추정기($z = \text{onehot} + p - \sg(p)$), KL 균형($\alpha = 0.8$), 이산 행동에는 REINFORCE. V3: symlog · two-hot · 자유 비트(free bits) 1 · unimix 1% · 리턴 정규화로 하나의 설정 이 여러 영역에서 동작.
확인 문제
$\gamma = 1$, $\lambda = 0$ 일 때 $H = 2$ 상상 궤적의 $V^\lambda_0$ 을 $\hat{r}_0, \hat{r}_1, v(s_1), v(s_2)$ 로 쓰세요. $\lambda = 1$ 이면요?
답 보기
$\lambda = 0$: $V^\lambda_0 = \hat{r}_0 + v(s_1)$ (한 스텝 TD 목표, $v(s_2)$ 와 $\hat{r}_1$ 은 쓰이지 않음). $\lambda = 1$: $V^\lambda_1 = \hat{r}_1 + v(s_2)$ 이고 $V^\lambda_0 = \hat{r}_0 + V^\lambda_1 = \hat{r}_0 + \hat{r}_1 + v(s_2)$ (상상을 끝까지 쓴 2-스텝 리턴).
액터 학습에서 World Model 을 requires_grad_(False) 로 얼리는 대신 상상한 상태를 .detach() 로 끊으면 어떤 일이 생기나요?
답 보기
행동 $a_t$ 에서 다음 상태 $s_{t+1}$ 로 가는 길이 끊겨, λ-리턴이 행동에 어떻게 의존하는지가 기울기에 나타나지 않습니다. 그러면 엔트로피 항 말고는 액터로 가는 기울기가 없어서 액터가 리턴을 키우는 법을 배우지 못합니다. 얼리기는 “고치지 않되 통과시키기”, 끊기는 “통과시키지 않기” 입니다.
$\sigma = 0.5$ 인 1차원 가우시안 $u$ 의 엔트로피는? 이 $u$ 의 평균이 0 이라면 $a = \tanh(u)$ 의 엔트로피는 대략 얼마인가요?
답 보기
$\frac{1}{2}\log(2\pi e) + \log 0.5 \approx 1.419 - 0.693 = 0.726$. $u$ 가 0 근처면 $a \approx u$ 이고 $\log(1 - a^2) \approx -u^2$ 이므로, 보정항은 대략 $-\E[u^2] = -\sigma^2 = -0.25$ 입니다(표본 200만 개로 직접 어림하면 $-0.23$). 그래서 $\mathcal{H}[a] \approx 0.726 - 0.23 \approx 0.50$ 으로 조금 줄어듭니다. $\sigma$ 가 더 작으면(예: 0.1) $\tanh$ 가 거의 항등 함수라 보정이 $-0.01$ 정도로 사라집니다. $u$ 가 $\pm 3$ 근처에 몰려 있다면 $1 - \tanh^2(3) \approx 0.0099$ 라 $\log$ 가 약 $-4.6$, 엔트로피가 크게 줄어듭니다.
칸이 $b = (-1, 0, 1, 2)$ 일 때 $y = 1.25$ 의 two-hot 벡터를 구하고, 그 벡터로 $y$ 가 되살아나는지 확인하세요.
답 보기
$1 \le 1.25 \lt 2$ 이므로 $b_k = 1$, $b_{k+1} = 2$. $w_{k+1} = (1.25 - 1)/1 = 0.25$, $w_k = 0.75$. 벡터는 $(0, 0, 0.75, 0.25)$. 확인: $0.75 \times 1 + 0.25 \times 2 = 1.25$.
KL 균형에서 $\alpha = 0.5$ 로 두면 어떤 손실과 같아지나요? $\alpha = 1$ 이면 사후는 KL 에서 기울기를 받나요?
답 보기
$\alpha = 0.5$ 면 사전과 사후가 같은 비율의 기울기를 받습니다. 손실의 값은 $\KL(q \,\|\, p)$ 그대로이고, 기울기는 사전 · 사후 양쪽 모두 원래의 0.5 배라서 $0.5\,\KL(q \,\|\, p)$ 로 학습하는 것과 같습니다(0.5 는 학습률에 흡수됨). $\alpha = 1$ 이면 두 번째 항이 사라져 사후는 KL 에서 기울기를 전혀 받지 않고, 재구성 손실로만 학습됩니다.
여기까지 오셨다면 PlaNet 과 Dreamer 라는 현대 World Model 의 뼈대를 수식부터 코드까지 직접 만들어 본 것입니다. 다음 장에서는 이 뼈대가 그 뒤로 어떻게 뻗어 나갔는지, MuZero · TD-MPC · Transformer · 확산 모델 · JEPA · 대규모 비디오 World Model 의 지형도를 그려 봅니다.