현대 World Model 지형도
12장까지 우리는 “그림을 다시 그려 내는(재구성하는)” World Model, 즉 VAE · MDN-RNN · RSSM · Dreamer 를 직접 만들었습니다. 이 장에서는 그 모델을 기준점 으로 삼아, 2019년 이후 등장한 다른 계열들 — 보상과 가치만 예측하는 MuZero, 디코더 없이 계획하는 TD-MPC, 세상을 토큰으로 바꾸는 Transformer World Model, 잡음을 걷어 내며 미래를 그리는 확산 World Model, 픽셀 대신 표현을 예측하는 JEPA, 그리고 Genie · Sora · Cosmos 같은 대규모 비디오 World Model — 을 한 장의 지도 위에 올려놓습니다.
계열마다 “무엇을 바꿨고, 왜 바꿨으며, 그 대가는 무엇인지” 를 설명하고, 핵심 수식은 앞 장들과 똑같이 한 줄씩 유도합니다. 특히 확산 모델은 정방향 · 역방향 · 학습 목표를 처음부터 끝까지 유도한 뒤, 진자의 미래를 예측하는 작은 확산 World Model 을 직접 만들어 봅니다.
- 현대 World Model 을 나누는 다섯 가지 질문: 무엇을 예측하나, 잠재는 어떤 모양인가, 시간을 무엇으로 잇나, 어떻게 쓰나, 얼마나 큰가
- MuZero 의 “가치 등가” 아이디어, n-스텝 가치 목표와 MCTS 의 pUCT 점수 계산
- TD-MPC 가 디코더를 버린 이유와, MPPI 가중치 $\exp(J/\tau)$ 를 최적화 문제에서 유도하기
- VQ-VAE 의 양자화 · 직선 통과 추정기, 자기회귀 분해, 어텐션에서 $\sqrt{d}$ 로 나누는 이유 유도
- 확산 모델의 정방향 닫힌 꼴, 역방향 평균, ELBO 에서 잡음 예측 손실까지 전부 유도하고 직접 구현하기
- JEPA 가 픽셀 대신 표현을 예측하는 이유와 “붕괴” 를 막는 방법
- Genie · Sora · Cosmos · GAIA · Genie 3 · Dreamer 4 같은 대규모 World Model 의 위치와 한계
이 장은 넓은 지형을 훑는 장이라, 앞 장들처럼 하나의 모델을 끝까지 구현하지는 않습니다. 대신 계열마다 핵심 식 한두 개 를 골라 끝까지 유도합니다. 처음 읽을 때는 1절(지도)과 8절(비교표)을 먼저 보고, 관심 가는 계열의 절로 들어가도 좋습니다. 필요한 배경은 2 · 3장(확률 · KL), 5장(벨만 방정식), 7장(CEM), 8장(VAE · ELBO), 12장(Dreamer)입니다.
이 장은 여러 논문의 기호를 그대로 빌려 오기 때문에, 같은 글자가 절에 따라 다른 것을 가리킵니다. 헷갈리면 이 목록으로 돌아오세요.
- $\tau$: 3절에서는 MPPI · SimNorm 의 온도, 6절에서는 EMA 의 섞는 비율 입니다(5장의 궤적 $\tau$, 6장의 토크와도 다릅니다).
- $z_t$: 2절 MuZero 에서는 가치의 목표값(n-스텝 리턴), 3절부터는 다시 잠재 상태 입니다. 다만 5절 샘플링 식의 첨자 없는 $z$ 는 새로 뽑는 잡음입니다.
- $c_1, c_2$: 2절에서는 pUCT 의 탐험 상수, 3절에서는 TD-MPC 손실 항들의 가중치($c_1, c_2, c_3$)입니다.
- $\lambda$: 3절에서는 먼 스텝의 손실을 줄이는 가중치 $\lambda^{i-t}$ 이고, 12장 λ-리턴의 $\lambda$ 와는 다른 값입니다.
- $\alpha$: 4절에서는 어텐션 가중치 $\alpha_j$, 5절에서는 확산의 $\alpha_t = 1 - \beta_t$ 입니다(12장 KL 균형의 $\alpha$ 와도 다릅니다). 5절의 $\beta_t$ 도 8장 β-VAE · 4절 VQ-VAE 의 $\beta$ 와 다른, 잡음의 양입니다.
- $k$: 2절에서는 상상으로 나아간 스텝 수, 4절에서는 고른 코드의 번호와 열쇠(key) 벡터, 5절 끝에서는 잡음 단계입니다.
1. 지도를 펼치기 전에: 기준점과 다섯 가지 질문
기준점: 우리가 만든 재구성형 World Model
12장의 Dreamer 를 다시 떠올려 봅시다. Dreamer 의 World Model 은 다음 네 부분으로 되어 있었습니다.
- 인코더: 그림 $o_t$ 를 보고 잠재 상태 $z_t$ 를 추측합니다.
- RSSM: 은닉 상태 $h_t$ 와 행동 $a_t$ 로 다음 잠재 상태를 예측합니다. 이것이 “머릿속 시뮬레이터” 의 본체입니다.
- 디코더: 잠재 상태에서 그림을 다시 그려 냅니다(재구성). 이 재구성 손실이 잠재 상태가 그림의 정보를 담도록 강제합니다.
- 보상 · 가치 · 정책: 잠재 상태에서 보상을 예측하고, 상상 속에서 액터-크리틱으로 행동을 배웁니다.
이 설계는 잘 동작하지만, 한 가지 질문을 남깁니다. “진자를 세우는 데 정말 64×64 픽셀을 전부 다시 그려 낼 필요가 있을까?” 그림에는 막대의 각도처럼 중요한 정보도 있지만, 배경의 얼룩이나 조명처럼 행동과 상관없는 정보도 많습니다. 재구성 손실은 이 둘을 구별하지 않고 모두 맞히라고 요구합니다. 현대 World Model 의 여러 계열은 바로 이 질문에 서로 다른 답을 내놓은 결과입니다.
World Model 을 나누는 다섯 가지 질문
| 질문 | 가능한 답 | 예 |
|---|---|---|
| ① 무엇을 예측하나 | 픽셀 전체 / 학습한 표현 / 보상 · 가치만 | Dreamer · 확산 = 픽셀, JEPA · TD-MPC = 표현, MuZero = 보상 · 가치 |
| ② 잠재는 어떤 모양인가 | 연속 가우시안 / 이산 범주 / 토큰 여러 개 | PlaNet = 가우시안, DreamerV2 = 범주, IRIS = 그림 한 장당 토큰 16개 |
| ③ 시간을 무엇으로 잇나 | RNN(GRU · LSTM) / Transformer / 확산 모델 | Dreamer = GRU, IRIS · STORM = Transformer, DIAMOND = 확산 |
| ④ 어떻게 쓰나 | 계획(MPC · MCTS) / 상상 속 정책 학습 / 사람 · 에이전트가 쓰는 시뮬레이터 | PlaNet · TD-MPC = 계획, Dreamer = 상상 학습, Genie 3 = 시뮬레이터 |
| ⑤ 얼마나 큰가 | 게임 2시간 분량 ~ 영상 수백만 시간 | Atari 100k(약 2시간) ~ Cosmos(약 2천만 시간) |
모든 World Model 은 “행동이 주어지면 미래가 어떻게 될지” 를 예측한다는 점에서 같습니다. 계열을 가르는 것은 미래의 무엇을(픽셀 · 표현 · 가치), 어떤 도구로(RNN · Transformer · 확산), 어디에 쓰려고(계획 · 상상 학습 · 시뮬레이터) 예측하느냐입니다.
2. 가치 등가 모델: MuZero
아이디어: 계획에 필요한 것만 예측한다
MuZeroSchrittwieser et al., Nature 2020 는 이 생각을 그대로 옮긴 World Model 입니다. MuZero 는 그림을 다시 그리지 않습니다. 대신 잠재 상태에서 세 가지만 맞히도록 학습합니다.
- 보상 $r$: 이 행동을 하면 받는 보상
- 가치 $v$: 이 상태에서 앞으로 받을 할인된 보상의 합(5장의 가치 함수)
- 정책 $p$: 이 상태에서 각 행동을 고를 확률
이렇게 “계획에 쓰이는 값들만 진짜 환경과 같으면 된다” 는 생각을 가치 등가value equivalence 라고 부릅니다 (MuZero 논문이 쓴 말은 아니고, 뒤이은 연구 Grimm et al., 2020 “The Value Equivalence Principle for Model-Based Reinforcement Learning” 이 붙인 이름입니다). 잠재 상태가 진짜 상태와 닮았는지는 상관하지 않습니다. 보상 · 가치 · 정책을 맞히는 데 쓸모 있기만 하면 됩니다. 그래서 MuZero 는 바둑 · 체스 · 쇼기 같은 보드게임과 Atari 게임을, 어느 쪽도 규칙(시뮬레이터)을 미리 알려 주지 않은 채 같은 알고리즘 으로 다룰 수 있었습니다 (앞선 AlphaZero 는 탐색할 때 게임의 규칙을 그대로 썼습니다).
세 개의 함수
MuZero 의 모델은 세 개의 신경망으로 되어 있습니다(논문의 기호를 그대로 씁니다).
$$ \begin{aligned} \text{표현(representation)}: &\quad s^0 = h_\theta(o_1, \dots, o_t) \\ \text{동역학(dynamics)}: &\quad r^k,\ s^k = g_\theta(s^{k-1}, a^k) \\ \text{예측(prediction)}: &\quad p^k,\ v^k = f_\theta(s^k) \end{aligned} $$여기서 $s^k$ 는 진짜 환경 상태가 아니라 모델 안의 은닉 상태 이고, 위 첨자 $k$ 는 “현재 시각 $t$ 에서 상상으로 $k$ 스텝 나아갔다” 는 뜻입니다. $h_\theta$ 는 지금까지의 관측을 보고 출발점 $s^0$ 을 만들고, $g_\theta$ 는 행동 $a^k$ 를 받아 다음 은닉 상태와 보상을 내놓고, $f_\theta$ 는 은닉 상태마다 정책과 가치를 내놓습니다. Dreamer 의 RSSM 과 비교하면 $g_\theta$ 가 RSSM 의 전이 부분에 해당하고, 디코더가 없습니다. (여기서 $h_\theta$ 는 MuZero 논문의 이름일 뿐, 우리 표기의 RNN 은닉 상태 $h_t$ 와는 다릅니다.)
학습 목표: K 스텝 펼친 손실
리플레이 버퍼에서 시각 $t$ 를 하나 고르고, 그때 실제로 했던 행동 $a_{t+1}, \dots, a_{t+K}$ 를 동역학 함수에 차례로 넣어 $K$ 스텝 펼칩니다(MuZero 는 $K = 5$). 이 절의 손실 식은 MuZero 논문의 첨자를 따릅니다. 논문은 관측 $o_t$ 다음에 하는 행동을 $a_{t+1}$, 그 결과 받는 보상을 $u_{t+1}$ 로 써서 5장 표기보다 번호가 하나씩 큽니다. 그리고 스텝 $k$ 마다 모델의 예측과 목표를 비교합니다.
$$ \ell_t(\theta) = \sum_{k=0}^{K} \Big[\, \ell^{r}\big(u_{t+k},\ r^k_t\big) + \ell^{v}\big(z_{t+k},\ v^k_t\big) + \ell^{p}\big(\pi_{t+k},\ p^k_t\big) \Big] + c\,\lVert \theta \rVert^2 $$- $u_{t+k}$: 실제로 받은 보상. $\ell^r$ 은 보상 예측의 오차입니다($k = 0$ 에는 보상 예측이 없으므로 빼고 셉니다).
- $z_{t+k}$: 가치의 목표값. 바로 아래에서 유도하는 n-스텝 리턴 입니다.
- $\pi_{t+k}$: 그 시각에 MCTS(아래)가 내놓은 행동 분포. 정책 $p$ 는 “탐색 결과를 흉내 내도록” 배웁니다. $\ell^p$ 는 교차 엔트로피(3장)입니다.
- $c\lVert\theta\rVert^2$: 가중치가 너무 커지지 않게 하는 정규화 항입니다.
n-스텝 가치 목표 유도하기
가치의 목표로 에피소드 끝까지의 리턴을 쓰면 분산이 크고, 한 스텝짜리 TD 목표를 쓰면 아직 부정확한 가치 추정의 오차(편향)가 그대로 스며듭니다(12장의 n-스텝 리턴 표와 같은 줄다리기). MuZero 는 그 사이인 n 스텝만 실제 보상을 쓰고, 나머지는 가치 추정으로 메우는 목표를 씁니다. 이 튜토리얼의 표기(5장: $r_t$ 는 $s_t$ 에서 $a_t$ 를 했을 때 받는 보상)로 유도해 봅시다.
숫자로 확인해 봅시다. $\gamma = 0.9$, $n = 3$, 실제 보상이 $r_t = 1,\ r_{t+1} = 0,\ r_{t+2} = 2$ 이고, 세 스텝 뒤의 가치 추정이 $v(s_{t+3}) = 5$ 라면
$$ z_t = 1 + 0.9 \times 0 + 0.9^2 \times 2 + 0.9^3 \times 5 = 1 + 0 + 0.81 \times 2 + 0.729 \times 5 = 1 + 1.62 + 3.645 = 6.265 $$[n-스텝 목표] n=3, γ=0.9: z = 6.2650
“실제 보상 몇 스텝 + 끝에서 가치로 메우기” 는 이 장에서 계속 나옵니다. 아래 TD-MPC 의 계획 목표도, 12장 Dreamer 의 λ-리턴도 모두 이 식의 변형입니다. λ-리턴은 여러 $n$ 의 n-스텝 목표를 $\lambda$ 비율로 섞은 평균이었습니다.
MCTS: 상상 속 나무 탐색
MuZero 는 학습한 모델로 몬테카를로 나무 탐색Monte Carlo Tree Search, MCTS 을 합니다. 7장의 CEM 이 “행동열 여러 개를 통째로 뽑아 보고 좋은 것을 고르는” 방식이었다면, MCTS 는 “유망한 가지를 한 스텝씩 더 깊이 파 보는” 방식입니다. 한 번의 탐색은 다음 세 단계를 수십 ~ 수백 번 되풀이합니다.
- 선택: 뿌리(지금 상태 $s^0$)에서 출발해, 각 노드에서 아래 pUCT 점수가 가장 큰 행동을 따라 내려갑니다.
- 확장 · 평가: 아직 펼치지 않은 노드에 닿으면 $g_\theta$ 로 다음 은닉 상태와 보상을 만들고, $f_\theta$ 로 정책 $p$ 와 가치 $v$ 를 얻습니다.
- 되돌려 쓰기(backup): 지나온 길의 노드마다 방문 횟수 $N$ 을 1 늘리고, 받은 보상과 가치로 평균 가치 $Q$ 를 고칩니다.
선택 단계의 점수(MuZero 논문의 pUCT 식)는 다음과 같습니다.
$$ a^\ast = \argmax_a \left[\, Q(s,a) \;+\; P(s,a)\,\frac{\sqrt{\sum_b N(s,b)}}{1 + N(s,a)} \left( c_1 + \log \frac{\sum_b N(s,b) + c_2 + 1}{c_2} \right) \right] $$- $Q(s,a)$: 지금까지 이 행동을 해 봤을 때의 평균 가치. 클수록 “이미 좋다고 알려진” 행동입니다(이용, exploitation).
- $P(s,a)$: 정책 신경망이 준 사전 확률. 신경망이 유망하다고 보는 행동에 가산점을 줍니다.
- $\dfrac{\sqrt{\sum_b N}}{1 + N(s,a)}$: 이 행동을 적게 해 봤을수록 커집니다(탐험, exploration). 전체 방문이 늘면 분자가 천천히($\sqrt{\ }$) 커지고, 이 행동의 방문이 늘면 분모가 커져 가산점이 줄어듭니다.
- $c_1 = 1.25$, $c_2 = 19652$: 탐험의 세기를 정하는 상수입니다. $\log$ 항은 방문 수가 아주 클 때만 조금 커지므로, 보통은 거의 $c_1$ 입니다.
[pUCT] 행동 A = 0.6695, 행동 B = 0.8536 → 고르는 행동: B
탐색이 끝나면 뿌리에서 각 행동을 방문한 횟수의 비율 $\pi(a) = N(s^0, a) / \sum_b N(s^0, b)$ 를 행동 분포로 씁니다. 이 분포는 정책 신경망 $p$ 보다 “한 수 더 생각한” 결과이므로, 위 손실에서 $p$ 가 $\pi$ 를 따라가도록 학습시키면 정책이 점점 좋아집니다. 이것이 AlphaZero · MuZero 의 탐색으로 정책을 개선하고, 개선된 정책을 다시 신경망에 담는 순환입니다.
Atari 게임의 보상은 게임마다 크기가 수백 배 다릅니다. MuZero 는 가치와 보상을 $h(x) = \operatorname{sign}(x)\big(\sqrt{\lvert x\rvert + 1} - 1\big) + \epsilon x$ 로 눌러 담은 뒤 범주 분포로 예측했습니다. 12장 DreamerV3 의 symlog 와 two-hot 이 바로 같은 문제(크기가 제각각인 값을 안정적으로 회귀하기)에 대한 답입니다.
EfficientZero: 적은 데이터로
MuZero 는 강력하지만 데이터를 많이 씁니다. EfficientZeroYe et al., NeurIPS 2021 는 MuZero 에 세 가지를 더해 Atari 100k 벤치마크(게임마다 에이전트 10만 스텝, 사람으로 치면 약 2시간 분량)에서 사람 점수를 넘는 평균 성능(NeurIPS 게재본 · arXiv v2 기준 평균 194.3%, arXiv v1 은 190.4%)을 처음으로 냈습니다.
- 자기 지도 일관성 손실: 디코더가 없으니 은닉 상태를 가르치는 신호가 보상 · 가치 · 정책뿐이라, 보상이 드문 초반에는 학습이 느립니다. 그래서 “동역학이 예측한 다음 은닉 상태” 와 “다음 관측을 인코더에 넣어 얻은 은닉 상태” 가 비슷해지도록 하는 손실을 더했습니다(목표 쪽은 기울기 차단(stop-gradient)). 아래 TD-MPC 의 잠재 일관성 손실, 6절 JEPA 의 표현 예측과 같은 생각입니다.
- 가치 접두사(value prefix): 보상을 한 스텝씩 따로 맞히는 대신, 몇 스텝의 보상 합을 LSTM 으로 한꺼번에 예측해 “언제 보상이 들어오는지” 의 모호함을 줄였습니다.
- 오래된 데이터 보정: 리플레이 버퍼의 오래된 궤적일수록 n-스텝 목표의 $n$ 을 줄이고, 최신 모델로 가치를 다시 계산합니다.
| 장점 | 단점 |
|---|---|
| 그림을 그리지 않으므로 계획에 필요 없는 세부에 용량을 쓰지 않는다. MCTS 와 결합해 바둑 · Atari 모두에서 최고 수준. | 보상이 드물면 은닉 상태를 가르칠 신호가 부족하다. 모델이 무엇을 상상하는지 눈으로 볼 수 없다. MCTS 는 이산 행동에 자연스럽고 연속 행동(진자 토크)에는 샘플링 등 추가 기법이 필요하다. |
3. 디코더 없는 잠재 계획: TD-MPC 와 TD-MPC2
구성 요소
TD-MPCHansen, Wang, Su, ICML 2022 와 그 후속 TD-MPC2Hansen, Su, Wang, ICLR 2024 는 7장의 MPC(모델 예측 제어)를 잠재 공간에서 하되, MuZero 처럼 디코더를 두지 않는 연속 제어용 World Model 입니다. 다섯 부분으로 되어 있습니다.
$$ \begin{aligned} \text{인코더}: &\quad z_t = e_\theta(s_t) \\ \text{잠재 동역학}: &\quad z_{t+1} = d_\theta(z_t, a_t) \\ \text{보상}: &\quad \hat r_t = R_\theta(z_t, a_t) \\ \text{행동 가치}: &\quad \hat q_t = Q_\theta(z_t, a_t) \\ \text{정책(사전)}: &\quad \hat a_t = \pi_\theta(z_t) \end{aligned} $$$Q_\theta(z, a)$ 는 5장의 행동 가치 함수, 즉 “상태 $z$ 에서 행동 $a$ 를 하고 그 뒤로 정책을 따를 때의 리턴의 기댓값” 입니다. (논문은 인코더를 $h_\theta$ 라고 쓰지만, 이 튜토리얼에서 $h$ 는 RNN 은닉 상태이므로 $e_\theta$ 로 바꿔 썼습니다.)
학습 목표: 보상 · TD · 잠재 일관성
리플레이 버퍼에서 길이 $H$ 의 구간 $(s_t, a_t, r_t, s_{t+1}), \dots$ 를 꺼내, 첫 상태만 인코딩한 뒤 잠재 동역학으로 펼치며 다음 손실을 더합니다.
$$ \mathcal{L}(\theta) = \sum_{i=t}^{t+H} \lambda^{\,i-t} \Big[\, c_1 \big\lVert R_\theta(z_i, a_i) - r_i \big\rVert^2 + c_2 \big\lVert Q_\theta(z_i, a_i) - y_i \big\rVert^2 + c_3 \big\lVert d_\theta(z_i, a_i) - \sg\!\big(e_{\bar\theta}(s_{i+1})\big) \big\rVert^2 \Big] $$- 보상 항: 잠재 상태에서 보상을 맞힙니다.
- TD 항: 목표 $y_i = r_i + \gamma\, Q_{\bar\theta}\big(z_{i+1}, \pi_\theta(z_{i+1})\big)$ 를 맞힙니다. 이 목표는 5장의 벨만 기대 방정식 $Q(s, a) = \E\big[r + \gamma\, Q(s', a') \big]$ 에서, 기댓값을 실제로 겪은 한 번의 전이로 바꾸고 다음 행동 $a'$ 을 정책이 고른 것으로 놓은 것입니다. $\bar\theta$ 는 $\theta$ 를 천천히 따라오는 목표 신경망 의 매개변수입니다(아래 6절의 EMA).
- 잠재 일관성 항: 동역학이 예측한 다음 잠재 $d_\theta(z_i, a_i)$ 가, 실제 다음 상태를 (목표) 인코더에 넣은 값과 같아지게 합니다. $\sg$ 는 기울기 차단(stop-gradient, 00장 표)으로, 목표 쪽으로는 기울기를 흘리지 않습니다.
- $\lambda^{i-t}$ ($\lambda \lt 1$): 먼 미래의 오차일수록 덜 중요하게 봅니다. 펼친 스텝이 길수록 오차가 쌓이기 때문입니다(6장의 오차 누적).
디코더를 버려도 될까: 붕괴 문제
디코더가 없으면 잠재 상태가 그림의 정보를 담도록 강제하는 손실이 없습니다. 그러면 잠재 일관성 항만으로는 이상한 해가 생깁니다.
계획: 짧게 상상하고 끝은 Q 로 메우기
TD-MPC 는 매 스텝 잠재 공간에서 행동열 $a_{t:t+H}$ 를 최적화합니다($H$ 는 5 정도로 짧습니다). 행동열의 점수는
$$ J(a_{t:t+H}) = \sum_{i=0}^{H-1} \gamma^{i}\, R_\theta(z_{t+i}, a_{t+i}) \;+\; \gamma^{H}\, Q_\theta\big(z_{t+H}, a_{t+H}\big) $$입니다(TD-MPC 원 논문의 식입니다. 끝항의 $a_{t+H}$ 는 뽑은 행동열의 마지막 행동인데, TD-MPC · TD-MPC2 의 공식 구현은 모두 그 자리에 정책이 고른 행동 $\pi_\theta(z_{t+H})$ 를 넣습니다). 위에서 유도한 n-스텝 목표와 꼴이 같습니다. 짧은 구간만 모델로 상상하고, 그 뒤의 긴 미래는 가치 함수 $Q$ 로 한 번에 메웁니다. 7장의 MPC 처럼 끝에 가치 함수가 없으면 상상 길이를 길게 잡아야 하지만(7장은 25 스텝), 끝에 가치 함수가 있으면 짧게 상상해도 먼 미래를 고려할 수 있습니다. 이름의 “TD” 가 이 가치 함수를 TD 학습으로 배운다는 뜻입니다.
행동열을 찾는 방법은 7장의 CEM 과 비슷한 MPPIModel Predictive Path Integral 입니다. CEM 은 상위 $K$ 개(정예, elite)를 똑같은 가중치 로 평균 냈습니다. MPPI 는 모든 후보를 점수에 따라 부드러운 가중치 $w_i \propto \exp(J_i / \tau)$ 로 평균 냅니다. 이 가중치가 어디서 나오는지 유도해 봅시다.
MPPI 가중치 유도하기
행동열 $A$ 를 뽑는 분포 $q(A)$ 를 고르는 문제로 생각합니다. 지금까지 쓰던 분포(예: 지난 스텝의 가우시안)를 $p(A)$ 라고 할 때, “점수의 기댓값은 크게, 그러나 $p$ 에서 너무 멀리 벗어나지는 않게” 를 식으로 쓰면 다음과 같습니다.
$$ \max_{q}\ \; \E_{A \sim q}\big[ J(A) \big] \;-\; \tau\, \KL\big(q \,\|\, p\big) $$$\tau \gt 0$ 은 “얼마나 멀리 벗어나도 되는지” 를 정하는 온도입니다. 계산을 쉽게 하려고 행동열이 유한한 개수 $A_1, \dots, A_M$ 중 하나라고 하고, $q_i = q(A_i)$, $p_i = p(A_i)$, $J_i = J(A_i)$ 로 씁니다.
실제로는 행동열이 연속이고 $q^\ast$ 를 바로 계산할 수 없으므로, $p$ 에서 후보 $A_1, \dots, A_M$ 을 뽑아서 근사합니다. 후보가 이미 $p$ 에서 뽑혔기 때문에 $p_i$ 는 “뽑힌 횟수” 로 이미 반영되어 있고, 남는 가중치는 $\exp(J_i / \tau)$ 뿐입니다.
$$ w_i = \frac{\exp(J_i / \tau)}{\sum_{j=1}^{M} \exp(J_j / \tau)}, \qquad \mu_{\text{새}} = \sum_{i=1}^{M} w_i\, A_i $$이 새 평균은 “가중치 $w_i$ 를 준 가우시안 최대우도 추정” 의 답이기도 합니다. 2장에서 가우시안의 최대우도 평균이 표본 평균이라는 것을 유도했는데, 가중치가 있으면 다음과 같습니다.
숫자로 보겠습니다. 후보 세 개의 점수가 $J = (10, 8, 2)$ 일 때, $\tau = 1$ 이면
$$ \big(e^{10}, e^{8}, e^{2}\big) \propto \big(e^{0}, e^{-2}, e^{-8}\big) = (1,\ 0.1353,\ 0.000335), \qquad \text{합} = 1.13567 $$ $$ w = \Big( \tfrac{1}{1.13567},\ \tfrac{0.1353}{1.13567},\ \tfrac{0.000335}{1.13567} \Big) = (0.8805,\ 0.1192,\ 0.0003) $$첫 줄에서 분자 · 분모를 똑같이 $e^{10}$ 으로 나눴습니다(가장 큰 점수를 빼는 것). 가중치는 변하지 않지만 $e^{10}$ 같은 큰 수를 직접 다루지 않아도 되어 컴퓨터에서 넘침(overflow)이 생기지 않습니다. 9장 MDN 의 log-sum-exp 와 같은 요령입니다.
[MPPI] τ =    1.0: 가중치 = [0.8805 0.1192 0.0003]
[MPPI] τ =    5.0: 가중치 = [0.5341 0.358  0.1078]
[MPPI] τ =    0.1: 가중치 = [1. 0. 0.]
[MPPI] τ =  100.0: 가중치 = [0.3444 0.3376 0.318 ]
[CEM ] 상위 2개   : 가중치 = [0.5 0.5 0. ]
$\tau$ 가 0 에 가까우면 가장 좋은 후보 하나만 남고(argmax), $\tau$ 가 아주 크면 모든 후보를 똑같이 평균 냅니다. 온도 $\tau$ 하나로 “욕심”과 “신중함” 사이를 연속적으로 조절할 수 있는 것이 MPPI 의 장점입니다. TD-MPC 는 실제로 둘을 섞어, 먼저 상위 $K$ 개 정예를 고른 뒤 정예 안에서 $\exp(\tau' J)$ 가중치로 평균 냅니다.
후보 다섯 개의 점수 $J = (10, 9, 8, 5, 2)$ 에 대한 가중치 $w_i$. 회색 막대는 상위 2개를 고르는 CEM 의 가중치입니다.
TD-MPC2: 하나의 설정으로 많은 과제를
TD-MPC2 는 같은 틀을 “크게, 그리고 튼튼하게” 만들었습니다. 논문은 한 가지 하이퍼파라미터 설정으로 DMControl · Meta-World · ManiSkill2 · MyoSuite 의 104개 과제를 풀었고, 80개 과제를 한 모델로 배우는 다중 과제 에이전트를 3억 1천7백만(317M) 개 매개변수까지 키웠습니다 (arXiv 2310.16828). 주요 변경은 다음과 같습니다.
- SimNorm: 잠재 벡터를 길이 $L$ 의 묶음 여러 개로 나누고, 묶음마다 softmax 를 씌웁니다. 각 묶음은 합이 1 인 양수(확률 단체, simplex) 위에 놓이므로 잠재 값이 끝없이 커지는 일을 막아 학습을 안정시킵니다. 묶음 $(x_1, \dots, x_L)$ 에 대해 $\operatorname{SimNorm}(x)_j = e^{x_j / \tau} \big/ \sum_{l=1}^{L} e^{x_l/\tau}$ 입니다.
- 이산 회귀: 보상과 가치를 숫자 하나로 회귀하지 않고, 12장 DreamerV3 처럼 구간(bin)에 대한 범주 분포로 예측해 교차 엔트로피로 학습합니다.
- Q 앙상블: Q 함수를 여러 개 두고, 목표값에는 그중 일부의 최솟값을 써서 가치의 과대평가를 줄입니다(7장 앙상블의 생각과 같은 계열).
- LayerNorm(층 정규화) · Mish(ReLU 를 매끄럽게 만든 활성 함수) 등으로 학습을 안정화했습니다.
| 장점 | 단점 |
|---|---|
| 디코더가 없어 가볍고 빠르다. 짧은 계획 + 가치 함수로 긴 미래를 본다. 연속 제어 과제에서 강하고, 설정을 거의 바꾸지 않고 많은 과제에 쓸 수 있다. | 잠재 상태를 눈으로 확인할 방법이 없다. 보상 신호에 의존하므로 보상이 없는 사전 학습(비디오만 보고 배우기)에는 맞지 않는다. 매 스텝 계획하므로 행동을 고르는 데 시간이 든다. |
4. 세상을 토큰으로: Transformer World Model
왜 토큰인가
대규모 언어 모델(LLM)은 문장을 토큰token(낱말 조각)의 열로 보고, “다음 토큰” 을 맞히는 것만으로 놀라운 능력을 얻었습니다. 그렇다면 세상도 토큰의 열로 바꿀 수 있지 않을까요? 그림 한 장을 작은 정수 몇 개(토큰)로 바꿀 수 있다면, “그림 토큰, 행동 토큰, 그림 토큰, 행동 토큰, …” 으로 이어지는 열에서 다음 토큰을 맞히는 Transformer 가 곧 World Model 이 됩니다. 이 생각을 실현하려면 두 가지 도구가 필요합니다. 그림을 토큰으로 바꾸는 VQ-VAE, 그리고 토큰열을 예측하는 Transformer 입니다.
VQ-VAE: 그림을 정수로 바꾸기
VQ-VAEVector Quantized VAE, van den Oord et al., 2017 는 8장의 VAE 와 비슷하게 인코더 · 디코더로 되어 있지만, 잠재 변수가 연속 가우시안이 아니라 코드북(codebook) 이라는 유한한 벡터 목록 중 하나입니다.
- 인코더가 그림의 각 위치마다 벡터 $z_e \in \R^D$ 를 냅니다. 64×64 그림이면 예를 들어 4×4 = 16개 위치에서 16개의 벡터가 나옵니다.
- 코드북 $\{e_1, e_2, \dots, e_K\}$ ($e_j \in \R^D$) 에서 $z_e$ 에 가장 가까운 벡터를 고릅니다: $k = \argmin_j \lVert z_e - e_j \rVert^2$.
- 그 벡터 $z_q = e_k$ 를 디코더에 넣어 그림을 복원합니다. 그리고 정수 $k$ 가 그 위치의 토큰 입니다.
숫자 예를 보겠습니다. 2차원 코드북 $e_1 = (0,0)$, $e_2 = (1,1)$, $e_3 = (2,0)$ 이 있고 인코더 출력이 $z_e = (1.2,\ 0.7)$ 이라면
$$ \begin{aligned} \lVert z_e - e_1 \rVert^2 &= 1.2^2 + 0.7^2 = 1.44 + 0.49 = 1.93 \\ \lVert z_e - e_2 \rVert^2 &= 0.2^2 + (-0.3)^2 = 0.04 + 0.09 = 0.13 \\ \lVert z_e - e_3 \rVert^2 &= (-0.8)^2 + 0.7^2 = 0.64 + 0.49 = 1.13 \end{aligned} $$이므로 가장 가까운 $e_2$ 를 고르고, 이 위치의 토큰은 2 입니다.
직선 통과 추정기: 고르기를 지나 기울기 보내기
문제가 하나 있습니다. “가장 가까운 것 고르기($\argmin$)” 는 미분할 수 없습니다. $z_e$ 를 조금 움직여도 고른 코드가 바뀌지 않는 한 $z_q$ 는 그대로이므로, $\partial z_q / \partial z_e = 0$ 입니다(바뀌는 경계에서는 값이 뚝 끊기고요). 그러면 디코더의 손실에서 인코더로 기울기가 전혀 흐르지 않아 인코더를 학습시킬 수 없습니다. 12장 DreamerV2 의 범주형 잠재에서 본 것과 같은 문제이고, 답도 같은 직선 통과 추정기straight-through estimator 입니다.
.detach()).z_tilde = z_e + (z_q - z_e).detach() 한 줄입니다.그러면 코드북 벡터 자체는 어떻게 배울까요? VQ-VAE 의 손실은 세 항입니다.
$$ \mathcal{L} = \underbrace{-\log p(x \mid \tilde z)}_{\text{재구성}} \;+\; \underbrace{\big\lVert \sg(z_e) - e_k \big\rVert^2}_{\text{코드북 손실}} \;+\; \beta\, \underbrace{\big\lVert z_e - \sg(e_k) \big\rVert^2}_{\text{커밋 손실}} $$- 코드북 손실: $z_e$ 쪽 기울기를 막았으므로 이 항은 오직 $e_k$ 만 움직여 $z_e$ 쪽으로 당깁니다. 미분하면 $\partial / \partial e_k = -2(z_e - e_k)$ 이므로 경사 하강 한 스텝은 $e_k \leftarrow e_k + 2\eta(z_e - e_k)$ 입니다.
- 커밋 손실: 반대로 $e_k$ 를 고정하고 인코더 출력 $z_e$ 가 고른 코드 근처에 머물도록 합니다. 이 항이 없으면 인코더 출력이 코드북보다 빨리 멀리 달아나 버립니다. 논문은 $\beta = 0.25$ 를 썼습니다.
앞의 예에서 코드북 손실은 $0.13$, 커밋 손실은 $0.25 \times 0.13 = 0.0325$ 입니다. 학습률 $\eta = 0.1$ 로 코드북을 한 스텝 고치면 $e_2 \leftarrow (1, 1) + 0.2 \times (0.2, -0.3) = (1.04,\ 0.94)$ 로 $z_e = (1.2, 0.7)$ 쪽으로 조금 다가갑니다.
[VQ] 거리² = [1.93 0.13 1.13], 고른 코드 = e_2 = [1. 1.]
[VQ] 코드북 손실 = 0.1300, 커밋 손실(β=0.25) = 0.0325
자기회귀 분해: 다음 토큰 맞히기가 곧 확률 모델
토큰열 $x_1, x_2, \dots, x_N$ 전체의 확률을 어떻게 모델링할까요? 확률의 곱셈 규칙만으로 “앞의 것들을 보고 다음 하나를 맞히는” 문제로 정확히 바꿀 수 있습니다.
World Model 에서는 열이 “그림 $t$ 의 토큰 16개, 행동 $a_t$, 그림 $t{+}1$ 의 토큰 16개, 행동 $a_{t+1}$, …” 입니다. 다음 그림의 토큰을 하나씩 맞히다 보면 다음 그림 전체가 만들어지고, 이것을 디코더에 넣으면 상상한 다음 장면이 나옵니다.
어텐션과 √d 로 나누는 이유
Transformer 의 핵심은 어텐션attention 입니다. 토큰마다 세 벡터 — 질의(query) $q$, 열쇠(key) $k$, 값(value) $v$ — 를 만들고, 한 토큰의 질의가 다른 토큰들의 열쇠와 얼마나 맞는지에 따라 그 토큰들의 값을 섞습니다.
$d$ 는 질의 · 열쇠 벡터의 길이(차원)입니다. 왜 굳이 $\sqrt{d}$ 로 나눌까요? 내적의 크기가 $d$ 에 따라 어떻게 변하는지 계산해 보면 이유가 보입니다.
점수가 크면 왜 나쁠까요? softmax 가 거의 한 곳에만 1 을 주는 꼴로 “포화” 되어 기울기가 사라지기 때문입니다. 두 점수 $(s_1, s_2)$ 의 softmax 에서 $p_1 = e^{s_1}/(e^{s_1} + e^{s_2})$ 의 미분을 구해 봅시다.
$d = 64$ 면 점수의 표준편차가 $\sqrt{64} = 8$ 이므로, 나누지 않으면 $(8, 0)$ 같은 점수 차가 흔합니다. 이때 $p_1 = e^8/(e^8 + 1) = 0.99966$, 기울기는 $0.99966 \times 0.00034 = 0.00034$ 입니다. $\sqrt{d} = 8$ 로 나눈 $(1, 0)$ 이면 $p_1 = 0.731$, 기울기 $0.197$ 로 약 590배 큽니다($0.19661 / 0.000335 \approx 587$).
[어텐션] d =   4: Var(q·k) =     4.00, Var(q·k / sqrt(d)) = 0.999
[어텐션] d =  64: Var(q·k) =    63.82, Var(q·k / sqrt(d)) = 0.997
[어텐션] d = 512: Var(q·k) =   510.86, Var(q·k / sqrt(d)) = 0.998
[softmax] 점수 [8. 0.] → 확률 [0.9997 0.0003], 기울기 p(1-p) = 0.00034
[softmax] 점수 [1. 0.] → 확률 [0.7311 0.2689], 기울기 p(1-p) = 0.19661
마지막으로, 다음 토큰을 맞힐 때 미래 토큰을 엿보면 안 되므로 인과 마스크(causal mask)를 씁니다. 위치 $i$ 의 질의는 $j \gt i$ 인 열쇠와의 점수를 $-\infty$ 로 바꿉니다. $e^{-\infty} = 0$ 이므로 softmax 가중치가 정확히 0 이 되어 미래 정보가 섞이지 않습니다. 이 덕분에 길이 $N$ 의 열 전체를 한 번에 넣고 $N$ 개의 “다음 토큰 예측” 을 동시에 학습할 수 있습니다. RNN 이 한 스텝씩 차례로 계산해야 했던 것과 비교하면 학습이 훨씬 병렬적입니다.
대표 모델: IRIS · TWM · STORM
Atari 100k 의 성적은 보통 사람 기준 정규화 점수human-normalized score, HNS 로 비교합니다. 게임마다 점수 단위가 다르므로, 무작위 행동의 점수를 0, 사람의 점수를 1 로 맞춥니다.
$$ \text{HNS} = \frac{\text{에이전트 점수} - \text{무작위 점수}}{\text{사람 점수} - \text{무작위 점수}}, \qquad \text{예: } \frac{600 - 100}{1100 - 100} = 0.5\ (50\%) $$- IRIS (Micheli, Alonso, Fleuret, ICLR 2023 — arXiv 2209.00588): 64×64 그림을 512가지 코드북의 토큰 16개로 바꾸고, GPT 같은 Transformer 가 다음 그림의 토큰 · 보상 · 종료를 예측합니다. 정책은 상상한 그림으로 액터-크리틱 학습을 합니다. Atari 100k 에서 평균 HNS 1.046(104.6%)으로 26개 게임 중 10개에서 사람을 넘었습니다.
- TWM (Robine et al., ICLR 2023 — arXiv 2303.07109): DreamerV2 식의 이산 잠재 상태를 만들고, 시간 방향의 연결만 GRU 대신 Transformer-XL 로 바꿨습니다.
- STORM (Zhang et al., NeurIPS 2023 — arXiv 2310.09615): 그림 한 장을 토큰 16개가 아니라 범주형 잠재 벡터 하나(한 토큰)로 만들어 열을 짧게 하고, 그 위에 GPT 식 Transformer 를 얹었습니다. Atari 100k 평균 HNS 126.7% 를 보고했습니다.
| 장점 | 단점 |
|---|---|
| LLM 의 도구(학습 방법 · 하드웨어 최적화 · 규모 키우기)를 그대로 쓴다. 긴 과거를 직접 참조할 수 있어 기억이 좋다. 학습이 병렬적이다. | 토큰을 하나씩 만드는 생성은 느리다(그림 한 장에 토큰 16번). 어텐션 비용이 열 길이의 제곱으로 는다. VQ 토크나이저가 작은 세부를 잃을 수 있다. |
5. 잡음을 걷어 내며 미래 그리기: 확산 World Model
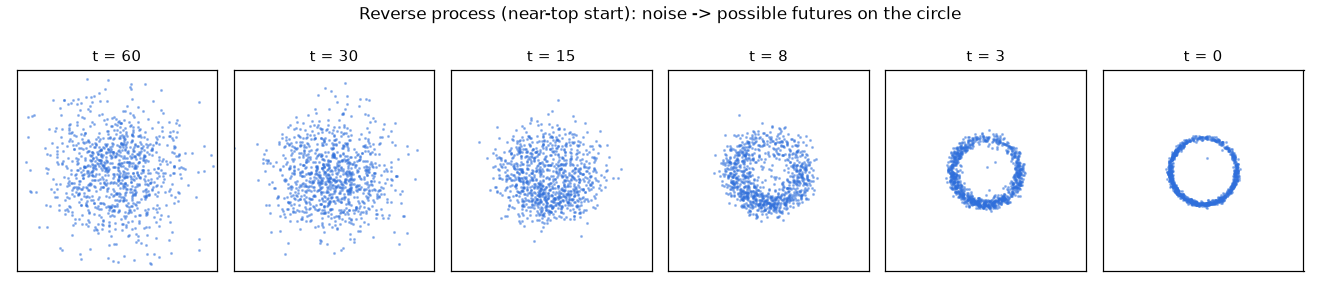
직관: 잉크를 거꾸로 돌리기
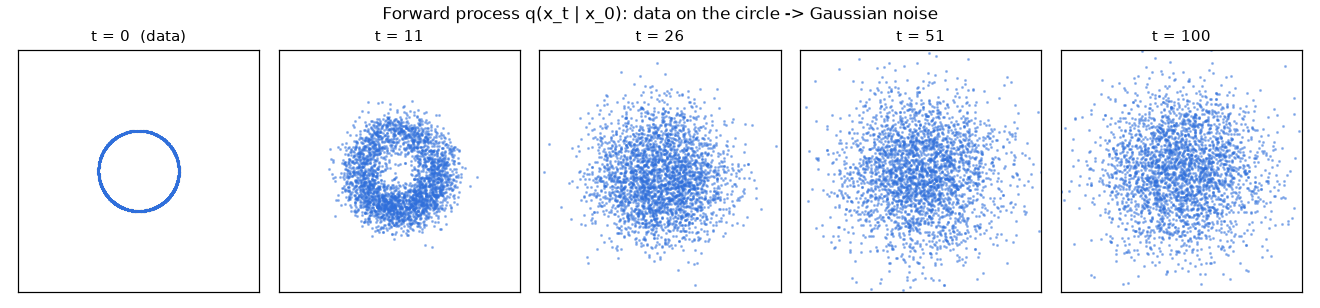
확산 모델diffusion model, DDPM: Ho et al., 2020 은 두 과정으로 되어 있습니다. 데이터에 잡음을 조금씩 섞어 결국 순수한 가우시안 잡음으로 만드는 정방향 과정(정해진 규칙, 학습할 것이 없음)과, 잡음에서 시작해 잡음을 조금씩 걷어 내 데이터를 만드는 역방향 과정(신경망이 배움)입니다. 지금부터 필요한 식을 모두 유도합니다. 쓰는 도구는 2장의 가우시안, 3장의 KL, 8장의 ELBO 뿐입니다. 표기를 간단히 하려고 1차원으로 유도하지만, 벡터에서도 성분마다 똑같이 성립합니다.
정방향 과정: 한 스텝
데이터 $x_0$ 에서 시작해 $t = 1, 2, \dots, T$ 스텝마다 다음 규칙으로 잡음을 섞습니다. $\beta_t$ 는 스텝마다 섞는 잡음의 양(0.0001 ~ 0.02 같은 작은 수)이고, $\alpha_t := 1 - \beta_t$ 입니다.
$$ q(x_t \mid x_{t-1}) = \Normal\big(x_t;\ \sqrt{\alpha_t}\, x_{t-1},\ \beta_t\big) \quad\Longleftrightarrow\quad x_t = \sqrt{\alpha_t}\, x_{t-1} + \sqrt{\beta_t}\, \epsilon_t,\quad \epsilon_t \sim \Normal(0, 1) $$왜 $x_{t-1}$ 에 $\sqrt{\alpha_t}$ 를 곱해 조금 줄일까요? 크기가 무한히 커지지 않게 하기 위해서입니다.
정방향 과정: 한 번에 t 스텝 (닫힌 꼴)
학습할 때마다 $x_0$ 에서 $t$ 스텝을 차례로 밟는 것은 낭비입니다. 다행히 가우시안을 여러 번 더한 결과는 다시 가우시안이므로, $x_0$ 에서 $x_t$ 로 한 번에 갈 수 있습니다. $\bar\alpha_t := \alpha_1 \alpha_2 \cdots \alpha_t$ 라고 정의합니다.
숫자로 확인합니다. $x_0 = 2$, $\beta_1 = \beta_2 = \beta_3 = 0.1$ 이면 $\alpha = 0.9$, $\bar\alpha_3 = 0.9^3 = 0.729$ 이므로 $q(x_3 \mid x_0) = \Normal\big(\sqrt{0.729} \times 2,\ 1 - 0.729\big) = \Normal(1.7076,\ 0.271)$ 입니다. 한 스텝씩 분산을 따라가도 $0.1 \to 0.9 \times 0.1 + 0.1 = 0.19 \to 0.9 \times 0.19 + 0.1 = 0.271$ 로 같습니다. 백만 개의 표본으로 한 스텝씩 되풀이한 결과와 비교해 봅시다.
[확산] 되풀이:  평균 1.7079, 분산 0.2706
[확산] 닫힌 꼴: 평균 1.7076, 분산 0.2710
역방향 과정의 정답: q(x_t−1 | x_t, x_0)
잡음에서 데이터로 돌아가려면 $q(x_{t-1} \mid x_t)$, 즉 “잡음이 조금 더 섞인 $x_t$ 를 보고 한 스텝 전 $x_{t-1}$ 을 맞히는 분포” 가 필요합니다. 이것은 데이터 전체의 분포를 알아야 계산되므로 직접 구할 수 없습니다. 그러나 원래 데이터 $x_0$ 까지 안다고 하면 정확히 계산할 수 있고, 그것이 가우시안이라는 사실이 학습 목표의 열쇠입니다. 먼저 도구 하나를 준비합니다.
다음으로, 정방향 한 스텝 $q(x_t \mid x_{t-1})$ 을 “$x_{t-1}$ 에 대한 가우시안 모양” 으로 바꿔 씁니다.
이제 베이즈 정리(2장)로 정답 분포를 구합니다.
숫자로 보면, $\beta = 0.1$ 이 일정할 때 $t = 2$ 에서 $\bar\alpha_1 = 0.9$, $\bar\alpha_2 = 0.81$ 이므로 $\tilde\beta_2 = \frac{1 - 0.9}{1 - 0.81} \times 0.1 = \frac{0.1}{0.19}\times 0.1 = 0.0526$ 입니다. 한 스텝에 섞은 잡음 $\beta_2 = 0.1$ 보다 작습니다. $x_0$ 이라는 추가 정보가 있으니 $x_1$ 을 더 확실하게 맞힐 수 있는 것입니다.
그런데 실제로 샘플을 만들 때는 $x_0$ 을 모릅니다(그걸 만들려는 것이니까요). 그래서 $x_0$ 을 “$x_t$ 에 섞인 잡음 $\epsilon$” 으로 바꿔 씁니다. 닫힌 꼴 $x_t = \sqrt{\bar\alpha_t}\, x_0 + \sqrt{1 - \bar\alpha_t}\, \epsilon$ 을 $x_0$ 에 대해 풀면 $x_0 = \big(x_t - \sqrt{1 - \bar\alpha_t}\,\epsilon\big)/\sqrt{\bar\alpha_t}$ 입니다.
학습 목표는 어디서 오는가: 확산의 ELBO
8장의 VAE 에서 잠재 변수 $z$ 를 두고 $\log p(x)$ 의 아래 경계(ELBO)를 유도했습니다. 확산 모델은 잠재 변수가 $x_1, \dots, x_T$ 여러 개인 VAE 로 볼 수 있습니다. 모델(역방향)은 $p_\theta(x_{0:T}) = p(x_T) \prod_{t=1}^{T} p_\theta(x_{t-1} \mid x_t)$, $p(x_T) = \Normal(0, 1)$ 이고, “인코더” 자리에 고정된 정방향 $q(x_{1:T} \mid x_0) = \prod_{t=1}^{T} q(x_t \mid x_{t-1})$ 이 들어갑니다.
모델의 역방향 한 스텝을 정답과 같은 꼴로 정합니다. 분산은 정해진 값 $\sigma_t^2$ (보통 $\beta_t$ 또는 $\tilde\beta_t$)로 두고, 평균은 정답 평균의 $\epsilon$ 자리를 신경망 $\epsilon_\theta$ 로 바꿉니다.
$$ p_\theta(x_{t-1} \mid x_t) = \Normal\big(x_{t-1};\ \mu_\theta(x_t, t),\ \sigma_t^2\big), \qquad \mu_\theta(x_t, t) = \frac{1}{\sqrt{\alpha_t}} \Big( x_t - \frac{\beta_t}{\sqrt{1 - \bar\alpha_t}}\, \epsilon_\theta(x_t, t) \Big) $$- 학습: 데이터 $x_0$, 단계 $t$, 잡음 $\epsilon$ 을 뽑아 $x_t = \sqrt{\bar\alpha_t}\, x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon$ 을 만들고, $\lVert \epsilon - \epsilon_\theta(x_t, t)\rVert^2$ 을 줄인다.
- 샘플링: $x_T \sim \Normal(0, 1)$ 에서 시작해 $t = T, \dots, 1$ 순서로 $x_{t-1} = \frac{1}{\sqrt{\alpha_t}}\big(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t, t)\big) + \sigma_t z$, $z \sim \Normal(0,1)$ (마지막 스텝은 $z = 0$).
- World Model 로 쓰려면 $\epsilon_\theta$ 에 조건(지금 상태 · 과거 그림 · 행동)을 함께 넣으면 된다.
실습: 진자의 미래를 그리는 작은 확산 World Model
이론을 손에 잡히게 해 봅시다. 다음 질문을 푸는 작은 World Model 을 만듭니다.
진자가 지금 각도 $\theta$, 각속도 $\dot\theta$ 에 있습니다. 앞으로 1초(20 스텝) 동안 어떤 토크 $u \in [-2, 2]$ 를 계속 걸지 모릅니다. 1초 뒤 막대 끝은 어디에 있을까요?
$u$ 를 모르므로 답은 한 점이 아니라 여러 가능성의 분포 입니다. 이 장난감은 그림 대신 막대 끝 위치 $(x, y)$ 두 숫자만 예측하지만, “미래가 여러 갈래일 때 무엇을 예측해야 하는가” 라는 질문은 그림을 예측하는 World Model 과 똑같습니다. 비교를 위해 6장처럼 평균 제곱 오차(MSE)로 한 점을 예측하는 보통의 회귀 모델도 함께 학습합니다.
먼저 데이터입니다. wm_envs.Pendulum 과 같은 물리를 numpy 벡터 연산으로 다시 써서 20만 개의 (지금 상태, 1초 뒤 막대 끝) 쌍을 한 번에 만듭니다.
simulate_batch 는 6장에서 유도한 물리 세 줄을 배열 전체에 한꺼번에 적용합니다. 스크립트는 시작할 때 이 함수의 결과가 Pendulum.step 과 정확히 같은지 확인합니다.
조건 cond 는 지금 상태 $[\cos\theta, \sin\theta, \dot\theta/3]$, 목표 target 은 1초 뒤 막대 끝 $(\sin\theta', \cos\theta')$ 입니다(위쪽이 $+y$).
다음은 잡음 일정과 닫힌 꼴입니다. 위에서 유도한 식이 그대로 코드가 됩니다.
betas: $\beta_1, \dots, \beta_{100}$ 을 0.0001 에서 0.15 까지 고르게 늘립니다. 단계가 100개뿐이라 이미지 모델(보통 1000단계, 0.02까지)보다 크게 잡았습니다.alpha_bars: $\bar\alpha_t$ 를 누적 곱(cumprod)으로 계산합니다. 실행하면 $\bar\alpha_{100} \approx 3.7 \times 10^{-4}$ 으로, 마지막에는 거의 순수한 잡음이 됩니다.q_sample: 닫힌 꼴 $x_t = \sqrt{\bar\alpha_t}\,x_0 + \sqrt{1 - \bar\alpha_t}\,\epsilon$ 한 줄입니다(코드의t는 0부터 세므로 수식의 $t$ 보다 1 작습니다).
신경망은 잡음 섞인 미래 $x_t$, 단계 $t$, 조건 $c$ 를 받아 잡음 $\epsilon$ 을 맞히는 MLP 입니다.
단계 $t$ 는 정수라 그대로 넣으면 신경망이 다루기 어렵습니다. time_embedding 은 $t$ 를 여러 주파수의 $\sin, \cos$ 값으로 바꿔
“지금 잡음이 얼마나 섞였는지” 를 부드러운 벡터로 알려 줍니다. Regressor 는 비교용으로, 조건만 보고 미래 위치를 바로 내놓습니다.
확산 모델의 학습 루프는 위의 $\mathcal{L}_{\text{simple}}$ 그대로입니다. 무작위 $t$ 와 $\epsilon$ 을 뽑고(torch.randint, torch.randn_like),
q_sample 로 $x_t$ 를 만들고, (denoiser(...) - eps) ** 2 의 평균을 줄입니다. 회귀 모델은 6장과 같은 MSE 학습입니다.
샘플링은 핵심 상자의 역방향 식 그대로입니다. b / math.sqrt(1 - ab) * eps_hat 이 $\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta$,
/ math.sqrt(a) 가 $\frac{1}{\sqrt{\alpha_t}}$, 마지막 줄이 $+\sigma_t z$ ($\sigma_t^2 = \beta_t$) 입니다.
$ python ch13_diffusion_toy.py물리 확인: simulate_batch 와 Pendulum.step 결과가 같습니다. 장치: cpu, ᾱ_T = 3.66e-04 (0 에 가까울수록 x_T 가 순수한 잡음) 데이터 200,000개 만들기: 0.2초 step 1000 확산 손실 0.2078 회귀 MSE 0.2710 step 2000 확산 손실 0.1627 회귀 MSE 0.2655 … step 8000 확산 손실 0.1417 회귀 MSE 0.2688 학습: 130.8초 [near top, still] 회귀 예측 = (-0.237, -0.276), 원점에서 거리 0.363 | 확산 샘플의 원점 거리 평균 0.998 [hanging, still] 회귀 예측 = (-0.004, -0.939), 원점에서 거리 0.939 | 확산 샘플의 원점 거리 평균 1.000 [horizontal, moving] 회귀 예측 = (-0.745, +0.025), 원점에서 거리 0.746 | 확산 샘플의 원점 거리 평균 0.999 그림 저장: ch13-forward.png, ch13-futures.png, ch13-reverse.png
이 튜토리얼을 쓴 환경(노트북 CPU 4스레드)에서 전체가 약 2분 걸렸습니다(--quick 은 약 10초).
막대 끝은 늘 반지름 1 인 원 위에 있어야 합니다. 확산 샘플은 원점에서의 거리가 평균 0.998 – 1.000 으로 원 위에 놓이지만,
회귀 예측은 거리 0.36 – 0.94 로 원 안쪽, 즉 물리적으로 불가능한 곳을 예측합니다.
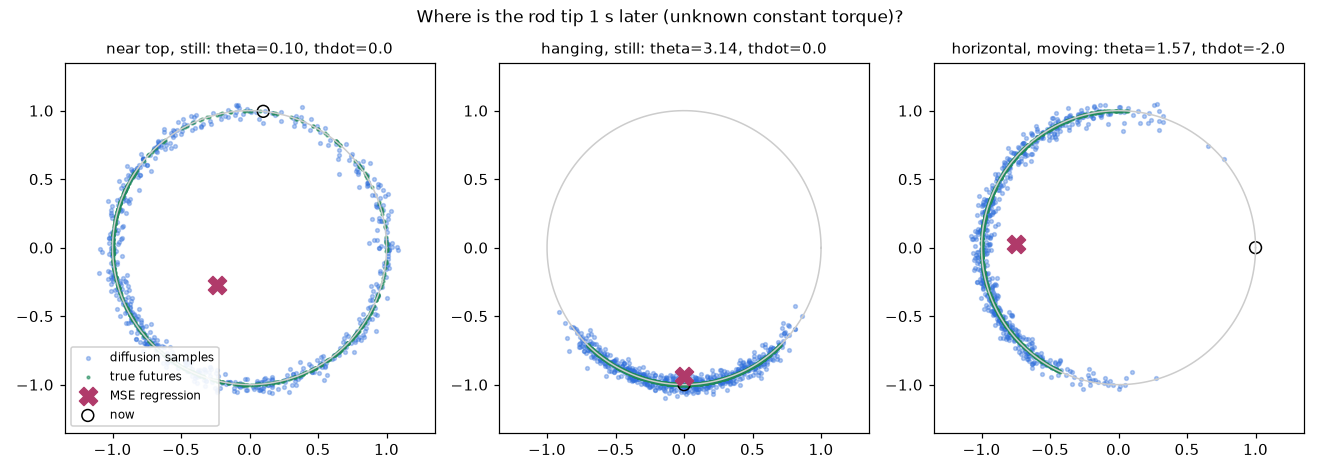
MSE 를 최소화하는 예측은 가능한 미래들의 평균 입니다(9장에서 유도했습니다. 상수 $c$ 에 대해 $\E[(X - c)^2]$ 를 미분하면 $-2\E[X - c]$, 이것을 0 으로 놓으면 $c = \E[X]$). 미래가 여러 갈래면 평균은 어느 갈래와도 닮지 않은 값입니다. 픽셀을 MSE 로 예측하는 World Model 에서는 이 평균이 여러 미래를 겹쳐 놓은 흐릿한 그림 으로 나타납니다. 확산 모델은 평균이 아니라 표본 을 뽑으므로, 미래가 불확실해도 또렷한 한 장면을 그립니다. (RSSM 이 잠재 변수를 확률적으로 둔 것도 같은 문제에 대한 다른 답입니다.)
확산 World Model: DIAMOND 와 GameNGen
실제 확산 World Model 은 위의 조건 $c$ 자리에 최근 그림 몇 장과 행동들 을 넣고, 다음 그림 전체(수천 개의 픽셀)를 잡음에서 그려 냅니다.
$$ \epsilon_\theta\big( x^{(k)}_{t+1},\ k,\ \underbrace{o_{t-L+1}, \dots, o_t}_{\text{최근 그림 } L \text{ 장}},\ \underbrace{a_{t-L+1}, \dots, a_t}_{\text{행동}} \big) $$(여기서 $k$ 는 잡음 단계이고, $t$ 는 환경의 시각입니다. 두 시간 축을 헷갈리지 않도록 잡음 단계에 $k$ 를 썼습니다.)
실제 논문들은 신경망이 맞히는 대상을 조금씩 달리합니다. GameNGen 은 잡음과 데이터를 섞은 “속도” $v$ 를 맞히고(v-예측), DIAMOND 는 DDPM 대신 EDM(Karras et al., 2022) 방식으로 깨끗한 그림 쪽을 맞힙니다. $x_t$ 를 알면 $\epsilon$, $x_0$, $v$ 는 서로 바꿔 쓸 수 있으므로 위 유도의 뼈대는 같습니다. DIAMOND 는 EDM 을 쓴 것이 적은 단계의 샘플링을 가능하게 했다고 보고합니다.
DDPM 이후에 나와 최근 대규모 World Model 에서 자주 보이는 이름 세 가지도 알아 두면 논문을 읽기 쉽습니다. 모두 “잡음에서 데이터로 가는 길을 신경망으로 배운다” 는 같은 뼈대 위에 있습니다.
- 흐름 맞추기(flow matching) (Lipman et al., 2022 — arXiv 2210.02747): 잡음과 데이터를 잇는 정해진 확률 경로를 따라 “어느 방향으로 얼마나 움직일지” 를 나타내는 벡터장(속도)을 회귀로 맞힙니다. 위의 v-예측과 가까운 생각입니다.
- 확산 강제(diffusion forcing) (Chen et al., 2024 — arXiv 2407.01392): 시퀀스의 토큰(프레임)마다 서로 다른 잡음 수준 을 독립적으로 주고 걷어 내도록 학습합니다. 과거 프레임은 깨끗하게, 미래 프레임은 잡음에서 시작하는 식으로 “다음 프레임 예측” 과 “시퀀스 전체 확산” 을 한 모델로 잇습니다.
- 지름길 모델(shortcut model) (Frans, Hafner, Levine, Abbeel, 2024 — arXiv 2410.12557): 신경망에 잡음 수준뿐 아니라 한 번에 건너뛸 스텝 크기 까지 조건으로 주어, 따로 증류하지 않고도 한 번 또는 몇 번의 샘플링으로 좋은 표본을 냅니다. 뒤에 나오는 Dreamer 4 의 shortcut forcing 은 이름 그대로 이 지름길 모델과 확산 강제를 이은 학습 목표입니다.
- DIAMOND (Alonso et al., NeurIPS 2024 Spotlight — arXiv 2405.12399): 확산 World Model 안에서 에이전트를 학습해 Atari 100k 평균 HNS 1.46(146%)을 보고했습니다(World Model 안에서만 학습한 에이전트로 당시 최고). 제목 “Visual Details Matter” 처럼, 이산 토큰이나 흐린 재구성에서 사라지는 작은 시각 세부(예: 작은 총알)가 행동에 중요할 때 확산이 유리하다고 주장합니다. 잡음 단계를 아주 적게(몇 단계) 쓰도록 설계를 다듬었고, 같은 방법을 게임 CS:GO 영상에도 키워 적용했습니다.
- GameNGen (Valevski et al., 2024, ICLR 2025 — arXiv 2408.14837): 강화학습 에이전트가 DOOM 을 하는 영상을 녹화하고, Stable Diffusion v1.4 를 고쳐 “지난 그림들 + 행동 → 다음 그림” 을 예측하게 했습니다. TPU(구글의 AI 가속 칩) 한 장에서 초당 약 20프레임으로 게임을 “신경망만으로” 돌렸고, 사람 평가자들은 짧은 진짜 영상과 생성 영상을 우연보다 조금 나은 정도로만 구별했습니다.
학습할 때는 조건으로 진짜 지난 그림을 넣지만, 실제로 상상을 굴릴 때는 모델이 스스로 만든 그림이 다음 조건이 됩니다. 작은 오차가 다음 입력으로 들어가 점점 커지는 것은 6장의 오차 누적과 같은 문제입니다. GameNGen 은 학습할 때 조건 그림에 일부러 가우시안 잡음을 섞어 “조금 틀린 과거를 보고도 바로잡는 법” 을 배우게 했고, 이것이 긴 시간 동안 화면을 안정시키는 데 결정적이었다고 보고합니다.
| 장점 | 단점 |
|---|---|
| 여러 갈래의 미래를 또렷하게 그린다(흐려지지 않음). 작은 시각 세부를 잘 보존한다. 이미지 · 비디오 생성에서 검증된 거대한 기술 기반을 쓸 수 있다. | 그림 한 장에 잡음 제거를 여러 번 해야 해서 느리다(단계 수 × 프레임 수). 긴 시간 일관성이 어렵다(드리프트). 보상 · 가치는 따로 예측해야 한다. |
6. 픽셀 대신 표현을 예측하기: JEPA
아이디어: 예측할 수 없는 것은 예측하지 않는다
바람에 흔들리는 나뭇잎 하나하나의 위치, 물결의 모양 같은 세부는 본질적으로 예측할 수 없습니다. 픽셀을 맞히라고 하면 모델은 이런 세부에 용량을 낭비하거나, 5절에서 본 것처럼 평균을 내 흐릿해집니다. Yann LeCun 은 2022년의 입장 논문 “A Path Towards Autonomous Machine Intelligence” 에서 JEPAJoint-Embedding Predictive Architecture 를 제안했습니다. 입력 $x$ 와 목표 $y$ 를 각각 인코더로 표현 $s_x, s_y$ 로 바꾸고, 예측은 표현 공간에서 한다 는 것입니다.
$$ s_x = \text{Enc}_\theta(x), \qquad s_y = \text{Enc}_{\bar\theta}(y), \qquad \hat s_y = \text{Pred}_\theta(s_x,\ \text{조건}), \qquad E(x, y) = D\big(s_y,\ \hat s_y\big) $$$D$ 는 거리(예: L1 · L2)이고, $E(x, y)$ 를 에너지energy 라고 부릅니다. 서로 잘 맞는(그럴듯한) $x, y$ 쌍은 에너지가 낮고, 맞지 않는 쌍은 높도록 학습합니다. World Model 로 쓸 때는 $x$ = 지금 영상, 조건 = 행동, $y$ = 미래 영상입니다. 인코더가 “예측할 수 없는 세부” 를 표현에서 빼 버릴 수 있으므로, 예측기는 예측 가능한 본질(물체의 위치 · 움직임)에 집중합니다.
붕괴: 모든 것을 같은 점으로 보내면 에너지는 0
표현 공간에서 비교하면 3절 TD-MPC 에서 본 것과 같은 함정이 생깁니다.
붕괴를 막는 대표적인 방법은 세 가지입니다.
- 대조 학습(contrastive): 맞지 않는 쌍(음성 표본)의 에너지를 일부러 올립니다. 음성 표본이 많이 필요하다는 단점이 있습니다.
- EMA 목표 인코더 + 기울기 차단: 목표 쪽 인코더 $\bar\theta$ 를 학습하지 않고, 학습하는 인코더 $\theta$ 의 지수 이동 평균exponential moving average, EMA 으로 천천히 따라오게 합니다(자기 지도 학습 방법 BYOL 에서 시작해 I-JEPA, V-JEPA 가 씁니다). $$ \bar\theta \leftarrow \tau\, \bar\theta + (1 - \tau)\, \theta, \qquad \tau \approx 0.99 \sim 0.999 $$
- 분산 · 공분산 정규화: 표현의 각 성분이 표본들 사이에서 충분히 퍼져 있도록(분산이 0 이 되지 않도록) 벌점을 줍니다(VICReg).
$\tau = 0.9$ 일 때 학습하는 쪽이 갑자기 1 에서 0 으로 바뀌면, 목표는 $0.9 \to 0.81 \to 0.729 \to \cdots$ 로 천천히 따라갑니다.
[EMA] 1 스텝 뒤 θ̄ = 0.9000
[EMA] 2 스텝 뒤 θ̄ = 0.8100
[EMA] 3 스텝 뒤 θ̄ = 0.7290
[EMA] 4 스텝 뒤 θ̄ = 0.6561
[EMA] 5 스텝 뒤 θ̄ = 0.5905
VICReg 의 분산 항은 표현의 $j$ 번째 성분의 (배치 안) 표준편차가 기준 $\gamma$(보통 1)보다 작으면 벌점을 줍니다. $v = \frac{1}{d}\sum_{j=1}^{d} \max\big(0,\ \gamma - \sqrt{\Var(s^{(j)}) + \varepsilon}\big)$. 붕괴하면 모든 성분의 분산이 0 이므로 벌점이 최대인 $\gamma - \sqrt{\varepsilon} \approx 1$ 이 되어, 붕괴 해가 더는 최적이 아니게 됩니다.
네 번째 길도 나왔습니다. LeJEPA (Balestriero & LeCun, 2025년 11월 — arXiv 2511.08544)는 JEPA 의 표현이 따라야 할 가장 좋은 분포가 등방성 가우시안(모든 방향으로 같은 분산을 가진 가우시안)이라는 이론을 내놓고, 표현을 그 분포 쪽으로 미는 정규화 항 SIGReg(sketched isotropic Gaussian regularization)를 제안했습니다. 표현이 한 점으로 뭉치면 가우시안에서 멀어져 벌점을 받으므로 붕괴가 막힙니다. 그래서 기울기 차단도, 교사-학생(EMA) 구조도 쓰지 않고, 조절할 하이퍼파라미터도 하나뿐이라고 보고합니다. 위에서 아직 이론적으로 완전히 설명되지 않았다고 한 부분을 이론으로 메우려는 시도입니다.
I-JEPA · V-JEPA · V-JEPA 2
- I-JEPA (Assran et al., CVPR 2023 — arXiv 2301.08243): 그림의 일부 블록을 가리고, 보이는 부분의 표현으로 가린 블록들의 표현 을 예측합니다. 픽셀을 복원하지 않고도 좋은 이미지 표현을 배웁니다.
- V-JEPA (Bardes et al., 2024 — arXiv 2404.08471): 같은 생각을 비디오로 넓혀, 시공간에서 가린 부분의 표현을 예측합니다.
- V-JEPA 2 (Meta, 2025년 6월 — arXiv 2506.09985): 100만 시간이 넘는 인터넷 비디오로 약 10억 매개변수 규모의 인코더를 사전 학습한 뒤, 62시간이 안 되는 로봇 영상(DROID 데이터셋)으로 행동을 조건으로 받는 예측기 V-JEPA 2-AC 를 덧붙여 학습했습니다. 그리고 다른 두 실험실의 Franka 로봇 팔에서, 그 환경의 데이터 없이(zero-shot) “목표 그림” 을 주고 물건을 집어 옮기는 계획에 성공했다고 보고했습니다.
V-JEPA 2-AC 의 계획은 7장의 CEM 과 같은 방식입니다. 행동열 후보를 뽑아 예측기로 미래 표현을 상상하고, 목표 그림의 표현과의 거리(에너지) 가 가장 작은 행동열을 고릅니다. 보상 함수가 따로 없어도 “이 그림처럼 되게 해” 라는 목표만으로 계획할 수 있다는 점이 특징입니다.
같은 “표현 공간에서 예측하고 목표 그림으로 계획한다” 는 생각의 작은 모델도 있습니다. DINO-WM (Zhou, Pan, LeCun, Pinto, 2024년 11월 — arXiv 2411.04983)은 인코더를 새로 배우지 않고 미리 학습된 DINOv2 의 패치 특징을 그대로 가져와, 오프라인 궤적에서 “다음 패치 특징” 만 예측하도록 배웁니다. 그림을 재구성하지 않고, 시험 때 행동열을 최적화해 목표 그림의 특징에 가까워지는 길을 찾습니다(보상 모델 없이 zero-shot 계획). LeWorldModel (Maes, Le Lidec, Scieur, LeCun, Balestriero, 2026년 3월 — arXiv 2603.19312)은 반대로 미리 학습된 인코더 없이 픽셀에서 끝까지 JEPA World Model 을 배웁니다. 손실은 “다음 임베딩 예측” 과 “잠재를 가우시안 분포로 미는 정규화” 두 항뿐이고, 매개변수 약 1,500만 개짜리 모델을 GPU 한 장에서 몇 시간에 학습하며, 미리 학습된 큰 모델에 기대는 World Model 보다 계획이 최대 48배 빠르다고 보고했습니다. 이 튜토리얼의 11장만 한 규모에서 JEPA 를 직접 실험해 볼 수 있다는 뜻이기도 합니다.
| 장점 | 단점 |
|---|---|
| 예측할 수 없는 세부를 무시하므로 효율적이다. 보상 없는 대량의 비디오로 사전 학습할 수 있다. 목표 그림만으로 계획할 수 있다. | 붕괴를 막는 장치가 필요하다. 상상한 미래를 그림으로 볼 수 없어(디코더를 따로 붙여야 함) 디버깅이 어렵다. 표현이 행동에 필요한 정보를 담았는지 확인하기 어렵다. |
7. 대규모 비디오 · 상호작용 World Model
2024년 무렵부터 “World Model” 이라는 말은 또 다른 뜻으로 널리 쓰이기 시작했습니다. 거대한 비디오 데이터로 학습해, 사람이나 에이전트가 키보드 · 글로 조작하면 그에 맞는 세상을 실시간으로 그려 내는 생성 모델입니다. 이 튜토리얼의 World Model(에이전트를 위한 학습된 시뮬레이터)과 뿌리는 같지만, 규모와 목적이 다릅니다.
이 튜토리얼의 정의(00장)에서 World Model 은 행동을 받아 다음을 예측합니다. 글 한 줄로 영상 한 편을 통째로 만드는 비디오 생성 모델은 행동 입력이 없으므로, 그 자체로는 “행동의 결과” 를 묻는 데 쓸 수 없습니다. 아래 모델들을 볼 때 “행동(또는 조작)을 프레임마다 받는가” 를 기준으로 보면 위치가 분명해집니다.
Genie: 행동 라벨 없이 행동을 배우기
Genie (Bruce et al., ICML 2024 — arXiv 2402.15391)는 인터넷의 2D 플랫폼 게임 영상(약 3만 시간 분량으로 거른 것)으로 학습한 110억(11B) 매개변수의 “생성형 상호작용 환경” 입니다. 문제는 인터넷 영상에 어떤 버튼을 눌렀는지(행동) 가 기록되어 있지 않다는 것입니다. Genie 는 행동 자체를 영상에서 배웁니다.
- 비디오 토크나이저: 영상을 VQ 토큰으로 바꿉니다(4절).
- 잠재 행동 모델(LAM, latent action model): 지난 프레임들과 다음 프레임 을 함께 보고, 둘 사이의 변화를 설명하는 “행동” $\tilde a_t$ 를 코드북 크기 8 인 VQ 로 뽑습니다. 그리고 지난 프레임들과 $\tilde a_t$ 만으로 다음 프레임을 복원하도록 학습합니다.
- 동역학 모델: 지난 토큰들과 잠재 행동으로 다음 프레임의 토큰을 예측하는 Transformer 입니다.
잠재 행동이 왜 “행동다워” 질까요? 다음 프레임을 복원하려면 $\tilde a_t$ 에 “무엇이 바뀌었는지” 가 담겨야 하는데, 고를 수 있는 값이 8개뿐이라 담을 수 있는 정보가 아주 적습니다.
동역학 모델은 계산을 줄이려고 시공간(ST) Transformer 를 씁니다. 프레임 $T$ 장, 프레임마다 토큰 $N$ 개가 있을 때 모든 토큰끼리 어텐션하면 쌍의 수가 $(TN)^2$ 이지만, “같은 프레임 안끼리(공간)” 와 “같은 위치의 다른 시각끼리(시간)” 로 나누면 $T N^2 + N T^2$ 입니다. 예를 들어 $T = 16$, $N = 400$ 이면 $(6400)^2 = 40{,}960{,}000$ 대 $16 \times 160{,}000 + 400 \times 256 = 2{,}662{,}400$ 으로 약 15배 적습니다.
Genie 2 · Genie 3 · Genie 4
- Genie 2 (Google DeepMind, 2024년 12월 — 블로그): 그림 한 장에서 키보드 · 마우스로 조작할 수 있는 3D 세계를 만듭니다. DeepMind 는 이를 자기회귀 잠재 확산 모델이라고 설명했고, 세계가 최대 1분 정도 일관되게 유지되며(대부분의 예시는 10 – 20초) 화면 밖으로 나갔던 부분을 기억했다가 다시 그린다고 소개했습니다.
- Genie 3 (2025년 8월 — 보도): 글로 묘사한 세계를 720p, 초당 24프레임으로 실시간 상호작용하며 몇 분 동안 일관되게 유지하고, 날씨 바꾸기 · 물체 넣기 같은 “세계 사건” 을 글로 일으킬 수 있다고 발표했습니다. 2026년 1월에는 이를 바탕으로 한 실험적 서비스 Project Genie 가 미국의 일부 유료 구독자에게 열렸습니다 (보도).
- Genie 4 (2026년 10월 — Google 블로그 · DeepMind 모델 페이지): 연구 미리보기로 공개되었으며, 세계에 맞는 소리를 실시간으로 함께 만들고 세션 중에 글로 장면을 바꿀 수 있다고 소개되었습니다. 해상도 · 프레임률 같은 세부 수치는 공개되지 않았고, 긴 세션에서는 세부가 흐트러질 수 있다는 한계도 함께 밝혔습니다.
Sora, Cosmos, 자율주행 World Model
- Sora (OpenAI, 2024년 2월 — 기술 보고서): 보고서 제목 “Video generation models as world simulators” 처럼, 비디오 생성 모델을 크게 키우면 물리 세계의 시뮬레이터가 될 수 있다고 주장했습니다. 시공간 패치(작은 영상 조각)를 토큰으로 쓰는 확산 Transformer 입니다. 동시에 보고서는 유리가 깨지는 것 같은 기본적인 물리 상호작용을 정확히 흉내 내지 못하는 한계를 밝혔고, “규모만 키우면 물리를 이해하게 되는가” 는 지금도 논쟁 중인 질문입니다.
- NVIDIA Cosmos (2025년 1월 — arXiv 2501.03575): 로봇 · 자율주행 같은 “물리 AI” 개발용 World Foundation Model 모음입니다. 확산 방식과 자기회귀(다음 토큰 예측) 방식의 모델, 비디오 토크나이저를 함께 공개했고, NVIDIA 는 약 2천만 시간 분량의 비디오를 학습 데이터로 다뤘다고 발표했습니다. 개발자가 자기 로봇 · 차량 데이터로 미세 조정해 합성 데이터를 만드는 용도를 내세웁니다.
- GAIA-1 · GAIA-2 (Wayve — GAIA-1, 2023 · GAIA-2, 2025): 자율주행용 생성 World Model 입니다. GAIA-1 은 영상 · 글 · 행동을 토큰으로 바꿔 다음 토큰을 예측했고, GAIA-2 는 잠재 확산 방식으로 바꿔 자기 차량의 움직임 · 주변 차량 · 날씨 · 도로 배치를 조건으로 여러 카메라 시점의 영상을 함께 생성합니다. 위험한 상황을 실제로 겪지 않고 만들어 시험하는 데 씁니다.
- UniSim (Yang et al., ICLR 2024 우수 논문상 — arXiv 2310.06114): “서랍을 열어” 같은 고수준 지시와 로봇의 저수준 조작 모두의 시각적 결과를 흉내 내는 실세계 시뮬레이터를 학습하고, 그 안에서만 학습한 정책이 실제 세계로 바로 옮겨 가는 것(zero-shot transfer)을 보였습니다.
에이전트 쪽의 최신 흐름: DayDreamer · Dreamer 4 · World Action Model
- DayDreamer (Wu et al., CoRL 2022 — arXiv 2206.14176): 12장의 Dreamer 를 시뮬레이터 없이 실제 로봇 에서 바로 학습시켰습니다. 4족 보행 로봇 A1 이 리셋도 없이 약 1시간 만에 등을 대고 누운 자세에서 뒤집어 일어나 걷는 법을 배웠고, 로봇 팔은 카메라 영상과 드문 보상으로 물건 집어 옮기기를, 바퀴 로봇은 카메라 영상만으로 목표 찾아가기를 배웠습니다. World Model 의 “표본 효율” 이 실제로 의미 있음을 보여 준 사례입니다.
- Dreamer 4 (Hafner, Yan, Lillicrap, 2025년 9월 — arXiv 2509.24527): 확장 가능한 Transformer World Model 과 새로운 학습 목표(shortcut forcing: 5절에서 본 지름길 모델과 확산 강제를 이어, 적은 샘플링 스텝으로 다음 프레임을 만들게 하는 목표)로 GPU 한 장에서 실시간으로 상상을 굴릴 수 있게 만들고, 환경과 전혀 상호작용하지 않은 채 오프라인 데이터만으로 Minecraft 에서 다이아몬드를 얻은 첫 에이전트라고 보고했습니다. 다이아몬드까지는 마우스 · 키보드 행동을 2만 번 넘게 이어야 합니다. 대규모 비디오 World Model 의 기술과 12장 Dreamer 의 “상상 속 학습” 이 만난 지점이라고 볼 수 있습니다.
- World Action Model: DreamZero (Ye et al., 2026년 2월 — arXiv 2602.15922): World Model 을 “정책을 기르는 시뮬레이터” 로 쓰는 대신, World Model 자체를 정책으로 쓰는 흐름입니다. 미리 학습된 비디오 확산 모델을 바탕으로 미래 영상과 로봇 행동을 함께 예측 하도록 학습합니다. 영상을 예측하려면 세상이 어떻게 움직이는지 알아야 하므로, 그 지식이 행동 예측으로 옮겨 간다는 생각입니다. 논문은 실제 로봇 실험에서 그림과 글을 받아 행동을 내는 기존 VLA(vision-language-action) 모델보다 새 과제 · 새 환경으로의 일반화가 2배 넘게 좋아졌고, 매개변수 140억 개의 자기회귀 비디오 확산 모델로 초당 7번의 닫힌 고리 제어를 했다고 보고했습니다. 7장의 “모델로 상상해서 고른다” 와 12장의 “정책을 따로 배운다” 사이의 경계가 흐려지는 지점입니다.
8. 한눈에 비교하기
| 계열 | 대표 | 무엇을 예측 | 잠재 · 표현 | 학습 목표 | 쓰는 법 | 데이터 규모(대략) |
|---|---|---|---|---|---|---|
| VAE + RNN | Ha & Schmidhuber (10장) | 픽셀 재구성 + 다음 잠재 | 가우시안 $z$ + LSTM | VAE ELBO, MDN 가능도 | 꿈속 진화 전략 | 약 1만 에피소드(무작위 롤아웃 10,000개) |
| RSSM | PlaNet · Dreamer (11 · 12장) | 픽셀 재구성 · 보상 | 결정 $h$ + 확률 $z$ | 순차 ELBO | CEM 계획 / 상상 속 액터-크리틱 | 수십만 ~ 수백만 스텝 |
| 가치 등가 | MuZero · EfficientZero | 보상 · 가치 · 정책 | 은닉 상태(디코더 없음) | K 스텝 펼친 손실 | MCTS | Atari 100k ~ 수십억 프레임 |
| 디코더 없는 잠재 | TD-MPC2 | 보상 · Q · 다음 잠재 | SimNorm 잠재 | 보상 + TD + 잠재 일관성 | MPPI + Q | 과제당 수십만 ~ 수백만 스텝 |
| 토큰 + Transformer | IRIS · TWM · STORM | 다음 토큰 · 보상 | VQ 토큰 / 범주 잠재 | 교차 엔트로피 | 상상 속 액터-크리틱 | Atari 100k(약 2시간) |
| 확산 | DIAMOND · GameNGen | 다음 그림(픽셀) | (픽셀 그대로 또는 잠재) | 잡음 제거(ε · v · x₀ 예측) | 상상 학습 / 게임 엔진 대체 | Atari 100k ~ 대규모 게임 녹화 |
| 표현 예측 | V-JEPA 2 | 미래의 표현 | 자기 지도 표현 | 표현 거리 + 붕괴 방지 | 목표 그림으로 CEM 계획 | 비디오 100만 시간+, 로봇 62시간 미만 |
| 대규모 비디오 | Genie · Sora · Cosmos · GAIA | 다음 프레임 · 영상 | 비디오 토큰 · 잠재 | 다음 토큰 / 확산 | 사람 · 에이전트의 시뮬레이터, 합성 데이터 | 수만 ~ 수천만 시간 |
| World Action Model | DreamZero | 미래 영상 + 행동 | 비디오 확산 모델의 잠재 | 영상 · 행동을 함께 잡음 제거 | 모델이 곧 정책(예측한 행동을 실행) | 사전 학습된 비디오 모델 + 로봇 데이터 |
9. 진자로 다시 보기
같은 진자 문제를 각 계열이 어떻게 다룰지 상상해 보면, 차이가 구체적으로 보입니다.
- Dreamer (12장): 64×64 그림을 RSSM 잠재로 바꾸고, 그림을 재구성하며 배웁니다. 배경이 없는 단순한 그림이라 재구성 손실이 큰 낭비는 아닙니다.
- MuZero: 그림을 보지만 다시 그리지 않고 보상 · 가치 · 정책만 맞힙니다. MCTS 는 이산 행동에 맞으므로 토크를 $\{-2, -1, 0, 1, 2\}$ 처럼 몇 개로 나눠야 합니다. 초반에는 거의 늘 큰 음의 보상을 받아 “어느 상태가 더 좋은지” 의 신호가 약하므로, 은닉 상태를 가르치기 어렵습니다(EfficientZero 의 일관성 손실이 여기서 도움이 됩니다).
- TD-MPC: 숫자 상태 $[\cos\theta, \sin\theta, \dot\theta]$ 이든 그림이든 잠재로 바꾸고, 5 스텝 정도만 상상한 뒤 나머지는 Q 로 메웁니다. 7장의 MPC 가 25 스텝을 상상했던 것과 대조적입니다.
- IRIS: 64×64 그림을 토큰 16개로 바꿉니다. 막대는 몇 개의 토큰에만 걸치므로, 각도의 작은 차이가 토큰으로 잘 구별되는지가 성패를 가릅니다.
- 확산: 이 장의 실습이 바로 그 모습입니다. 서 있는 진자가 어느 쪽으로 쓰러질지 모를 때도, 흐린 평균 대신 또렷한 한 갈래의 미래를 그립니다.
- JEPA: “막대가 똑바로 선 그림” 을 목표로 주고, 표현 공간에서 그 목표와의 거리를 줄이는 토크열을 CEM 으로 찾습니다. 보상 함수를 따로 정의할 필요가 없습니다.
- Genie 식 학습: 토크 기록이 없는 진자 영상만 있어도, 잠재 행동 모델이 “왼쪽으로 밀기 · 오른쪽으로 밀기 · 가만히” 같은 몇 가지 코드를 스스로 찾아낼 것입니다.
10. 아직 풀리지 않은 문제들
- 긴 시간 일관성: 6장의 오차 누적은 거대한 모델에서도 사라지지 않습니다. Genie 2 · 3 · 4 가 일관성 유지 시간을 “분” 단위로 늘린 것 자체가 큰 성과로 발표될 만큼 어려운 문제입니다.
- 인과 · 물리의 이해: 그럴듯해 보이는 영상과 물리적으로 맞는 영상은 다릅니다(Sora 의 유리 예). 보기에는 자연스러워도 행동의 결과를 틀리게 예측하면 계획에 쓸 수 없습니다.
- 평가: 생성 품질 지표(픽셀 오차로 재는 PSNR, 영상 분포 사이의 거리로 재는 FVD 등)가 높다고 그 안에서 학습한 정책이 실제로 잘 움직인다는 보장은 없습니다. “보기 좋은가” 와 “쓸모 있는가” 를 함께 재는 방법이 아직 부족합니다.
- 모델 착취: 10장에서 본 것처럼, 정책은 World Model 의 틈(실제와 다른 곳)을 찾아 “꿈속에서만 통하는 꼼수” 를 배웁니다. 모델이 클수록 틈은 줄지만 사라지지 않습니다.
- 계산 비용: 확산 모델의 여러 잡음 제거 단계, Transformer 의 긴 문맥은 실시간 상호작용과 상상 학습을 비싸게 만듭니다. 적은 단계로 생성하는 기법(Dreamer 4 의 shortcut 등)이 활발히 연구되고 있습니다.
- 안전과 실제 세계로의 이전: 로봇 · 자율주행에서는 World Model 이 틀린 곳에서의 실패가 실제 사고가 됩니다. 불확실성 추정(7장의 앙상블)과 보수적인 계획이 여전히 중요합니다.
- 현대 World Model 은 무엇을 예측하나 · 잠재의 모양 · 시간 연결 도구 · 쓰는 법 · 규모 로 나눠 보면 정리된다.
- MuZero: 보상 · 가치 · 정책만 맞히는 가치 등가 모델 + MCTS. 가치 목표는 n-스텝 리턴 $\sum_{i \lt n}\gamma^i r_{t+i} + \gamma^n v(s_{t+n})$.
- TD-MPC: 디코더 없이 보상 + TD + 잠재 일관성으로 학습하고, 짧은 상상 + Q 로 계획. MPPI 가중치 $\exp(J/\tau)$ 는 “기대 점수 − τ·KL” 최대화의 해.
- Transformer World Model: VQ 로 그림을 토큰으로(직선 통과 추정기), 연쇄 규칙으로 다음 토큰 예측, 어텐션 점수는 분산을 1 로 맞추려 $\sqrt{d}$ 로 나눈다.
- 확산 World Model: $x_t = \sqrt{\bar\alpha_t}x_0 + \sqrt{1-\bar\alpha_t}\epsilon$, 역방향 평균 $\frac{1}{\sqrt{\alpha_t}}(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon)$, 학습은 잡음 예측 MSE. 평균이 아니라 표본을 내므로 흐려지지 않는다.
- JEPA: 표현 공간에서 예측해 예측할 수 없는 세부를 버린다. 붕괴를 EMA 목표 · 분산 정규화로 막는다.
- 대규모 모델(Genie · Sora · Cosmos · GAIA)은 행동 · 조작을 프레임마다 받을 때 비로소 이 튜토리얼의 의미의 World Model 이 되고, 긴 일관성 · 물리 · 평가가 남은 과제다.
확인 문제
$\gamma = 0.5$, $n = 2$, 보상 $r_t = 4$, $r_{t+1} = 2$, 두 스텝 뒤 가치 $v(s_{t+2}) = 8$ 일 때 n-스텝 목표 $z_t$ 는?
답 보기
$z_t = 4 + 0.5 \times 2 + 0.5^2 \times 8 = 4 + 1 + 2 = 7$.
점수가 $J = (3, 1)$ 인 두 후보에 대해 (가) $\tau = 1$ 일 때 가중치를 구하고, (나) $\tau \to 0$, (다) $\tau \to \infty$ 일 때 가중치가 어떻게 되는지 설명하세요.
답 보기
(가) $\exp(3), \exp(1) \propto 1, e^{-2} = 1, 0.1353$. 합 $1.1353$ 으로 나누면 $w = (0.881, 0.119)$.
(나) $\exp((J_i - J_{\max})/\tau)$ 에서 최고 점수가 아닌 후보는 지수가 $-\infty$ 로 가므로 $w = (1, 0)$, 즉 가장 좋은 후보만 고르는 argmax.
(다) 지수가 모두 0 으로 가므로 $w = (0.5, 0.5)$, 즉 점수를 무시한 단순 평균.
z_tilde = z_e + (z_q - z_e).detach() 에서 순전파 값과 z_e 에 대한 기울기가 각각 무엇인지 설명하세요. .detach() 를 빼면 어떻게 될까요?
답 보기
값은 $z_e + z_q - z_e = z_q$ 이고, 기울기는 $\partial \tilde z/\partial z_e = I$ 라서 디코더 쪽 기울기가 그대로 인코더로 갑니다.
.detach() 를 빼면 $\tilde z = z_q$ 가 되어 기울기가 $\partial z_q / \partial z_e = 0$ (argmin 은 미분이 0) 이므로 인코더가 학습되지 않습니다.
질의 · 열쇠의 성분이 평균 0, 분산 $\sigma^2$ (1 이 아님)인 독립 확률 변수라면, 점수 $q \cdot k$ 의 분산을 1 로 만들려면 무엇으로 나눠야 할까요?
답 보기
$\Var(q_i k_i) = \E[q_i^2]\E[k_i^2] = \sigma^2 \cdot \sigma^2 = \sigma^4$, 합의 분산은 $d\sigma^4$. 따라서 $\sqrt{d\sigma^4} = \sigma^2\sqrt{d}$ 로 나누면 분산이 1 이 됩니다.
$\beta_1 = 0.2$, $\beta_2 = 0.5$, $x_0 = 1$ 일 때 $q(x_2 \mid x_0)$ 의 평균과 분산을 닫힌 꼴로 구하고, 한 스텝씩 분산을 따라가 같은지 확인하세요.
답 보기
$\alpha_1 = 0.8$, $\alpha_2 = 0.5$, $\bar\alpha_2 = 0.4$. 평균 $\sqrt{0.4} \times 1 = 0.632$, 분산 $1 - 0.4 = 0.6$.
한 스텝씩: $x_0$ 은 상수라 분산 0. $\Var(x_1) = 0.8 \times 0 + 0.2 = 0.2$, $\Var(x_2) = 0.5 \times 0.2 + 0.5 = 0.6$. 같습니다. 평균도 $\sqrt{0.8}\sqrt{0.5} = \sqrt{0.4}$ 배로 같습니다.
JEPA 에서 목표 인코더를 EMA 로 두지 않고, 학습하는 인코더와 같은 매개변수를 쓰며 양쪽 모두로 기울기를 흘리면 어떤 문제가 생기기 쉬울까요? 재구성형 World Model 에는 왜 이 문제가 없을까요?
답 보기
두 인코더가 함께 움직이며 모든 입력을 같은 벡터로 보내는 붕괴 해(에너지가 모든 쌍에서 0)로 쉽게 빠집니다.
재구성형은 잠재 상태에서 원래 그림을 복원해야 하므로, 모든 입력을 같은 잠재로 보내면 서로 다른 그림을 복원할 수 없어 재구성 손실이 커집니다. 디코더가 붕괴를 막는 역할을 합니다.
더 읽을거리
- MuZero — Schrittwieser et al., “Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model”, arXiv 1911.08265
- EfficientZero — Ye et al., “Mastering Atari Games with Limited Data”, arXiv 2111.00210
- TD-MPC — Hansen et al., arXiv 2203.04955 · TD-MPC2 — arXiv 2310.16828
- VQ-VAE — van den Oord et al., arXiv 1711.00937 · Transformer — Vaswani et al., arXiv 1706.03762
- DDPM — Ho et al., “Denoising Diffusion Probabilistic Models”, arXiv 2006.11239
- LeCun, “A Path Towards Autonomous Machine Intelligence”, OpenReview
- LeJEPA — arXiv 2511.08544 · LeWorldModel — arXiv 2603.19312 · DINO-WM — arXiv 2411.04983
- DreamZero — Ye et al., “World Action Models are Zero-shot Policies”, arXiv 2602.15922
- Genie — arXiv 2402.15391 · Dreamer 4 — arXiv 2509.24527
이것으로 World Model 의 지형도를 한 바퀴 돌았습니다. 마지막 14장에는 실습하다 막혔을 때 볼 디버깅 체크리스트, 원 논문의 하이퍼파라미터, 튜토리얼 전체의 핵심 식 모음, 용어집, 논문을 읽는 순서를 모아 두었습니다.