탐지기 채점: AP 와 mAP
RF-DETR 논문의 초록은 “RF-DETR (nano) 는 COCO 에서 48.0 AP 를 달성한다” 고 적습니다. 탐지 논문의 표는 처음부터 끝까지 이 AP 라는 숫자로 채워져 있습니다. 이 장의 목표는 그 한 문장을 남김없이 이해하는 것입니다. 예측 박스 하나가 “맞았다” 는 것이 무슨 뜻인지에서 출발해, 정밀도와 재현율, 둘을 이은 곡선, 그 곡선을 숫자 하나로 줄인 AP 까지 손으로 계산하고 코드로 확인합니다. 끝에서는 겹친 예측을 지우는 NMS 를 구현해 보고, DETR 계열이 왜 그것 없이도 되는지 이해할 바탕을 마련합니다.
- 분류에서 쓰던 “정확도” 가 왜 탐지에서는 쓸모가 없는지
- 예측 박스를 정답 박스에 짝지어 참 양성(TP) · 거짓 양성(FP) · 거짓 음성(FN) 을 가리는 규칙과, 중복 예측이 벌점을 받는 이유
- 정밀도와 재현율, 점수 문턱값을 움직일 때의 맞바꿈, 정밀도 – 재현율(PR) 곡선
- PR 곡선의 보간과 COCO 의 101점 방식으로 AP 를 손으로 계산하기
- mAP, 그리고 COCO 의 AP · AP50 · AP75 · APS · APM · APL 이 각각 무엇을 재는지
- 가짜 탐지기 실험으로 AP 가 박스의 정확도 · 점수의 순서 · 중복 예측 · 헛예측에 어떻게 반응하는지 확인하기
- NMS 의 알고리즘과 약점, DETR 계열이 NMS 를 쓰지 않는다는 말의 뜻
왜 “정확도” 로는 안 되나
모델을 채점한다고 하면 가장 먼저 떠오르는 것은 정확도accuracy 입니다. 그림을 보고 “고양이냐 개냐” 를 맞히는 분류 문제에서는 그림 100장 가운데 93장을 맞히면 정확도가 93% 입니다.
$$ \text{정확도} = \frac{\text{맞힌 문제 수}}{\text{전체 문제 수}} $$이 식이 성립하려면 “문제” 를 셀 수 있어야 합니다. 분류에서는 그림 한 장이 문제 하나이고, 답도 하나입니다. 그런데 1장에서 보았듯이 객체 탐지의 답은 하나가 아니라 집합 입니다. 탐지기는 그림 한 장을 보고 다음과 같은 것을 몇 개든 내놓습니다.
- 박스: 객체를 둘러싼 사각형 (2장의 $(c_x, c_y, w, h)$ 또는 $(x_0, y_0, x_1, y_1)$)
- 클래스: 그 객체가 무엇인지 (도형 세상에서는 원 · 사각형 · 삼각형)
- 점수: 탐지기가 그 예측을 얼마나 믿는지를 나타내는 0 – 1 의 수 (신뢰도, confidence 라고도 부릅니다)
정답도 그림마다 개수가 다릅니다. 객체가 하나인 그림도, 넷인 그림도 있습니다. 그러면 여기서 “문제 수” 는 무엇일까요? 분류의 정확도를 조금 풀어서 쓰면 왜 막히는지가 보입니다. “이 그림은 고양이인가?” 라는 예 · 아니오 문제에서 답은 네 가지 가운데 하나로 떨어집니다.
| 실제로 고양이 | 실제로 고양이 아님 | |
|---|---|---|
| “고양이” 라고 답함 | 참 양성 (TP) | 거짓 양성 (FP) |
| “아니다” 라고 답함 | 거짓 음성 (FN) | 참 음성 (TN) |
양성(positive)은 “있다” 고 답한 것, 음성(negative)은 “없다” 고 답한 것이고, 참(true) · 거짓(false)은 그 답이 맞았는지 틀렸는지입니다. 정확도는 이 네 칸으로 $(\mathrm{TP} + \mathrm{TN}) / (\mathrm{TP} + \mathrm{FP} + \mathrm{FN} + \mathrm{TN})$ 입니다. 탐지에서 문제가 되는 칸은 참 음성(TN) 입니다. 탐지에서 참 음성은 “객체가 없는 자리에 박스를 치지 않은 것” 입니다. 그런 자리는 몇 개일까요?
객체가 3개인 그림에서 아무것도 예측하지 않는 탐지기를 생각해 봅시다. 2천 1백만 개가 넘는 “객체 아닌 박스” 를 모두 옳게 안 쳤으므로 참 음성이 21,678,333개이고, 놓친 것은 3개뿐입니다. 정확도는 $21{,}678{,}333 / 21{,}678{,}336 \approx 99.99999\%$ 입니다. 아무 일도 하지 않는 탐지기가 만점에 가깝습니다. 참 음성의 수는 박스를 어떻게 세느냐에 따라 얼마든지 달라지고, 어떻게 세든 나머지 세 칸을 압도합니다.
탐지에서는 배경이 사실상 무한하므로 참 음성을 셀 수 없습니다. 그래서 탐지기 채점은 참 음성을 쓰지 않는 값, 곧 TP · FP · FN 세 가지만으로 만든 지표를 씁니다. 그것이 이 장의 정밀도 · 재현율 · AP 입니다.
채점 방식을 정하기 전에, 탐지기가 저지를 수 있는 잘못을 먼저 늘어놓아 봅시다. 좋은 지표는 이 다섯 가지를 모두 벌해야 합니다.
- 놓침: 있는 객체를 예측하지 않았다.
- 헛예측: 아무것도 없는 곳에 박스를 쳤다.
- 클래스 틀림: 위치는 맞는데 원을 사각형이라고 했다.
- 박스가 부정확함: 객체를 찾기는 했지만 박스가 반쯤 어긋났다.
- 중복 예측: 객체 하나에 박스를 둘, 셋 쳤다.
예측 하나를 채점하기
참 양성 · 거짓 양성 · 거짓 음성
시험 채점에 빗대면, 정답 박스는 “모범 답안” 이고 예측 박스는 “학생이 낸 답” 입니다. 채점자는 학생의 답 하나하나를 모범 답안과 맞춰 보고 맞음 · 틀림을 매깁니다. 탐지에서는 다음 세 가지 이름을 씁니다.
- 참 양성true positive, TP: 정답 객체를 제대로 가리킨 예측. “있다” 고 했고(양성) 그 말이 맞았습니다(참).
- 거짓 양성false positive, FP: 정답과 짝을 이루지 못한 예측. “있다” 고 했지만(양성) 틀렸습니다(거짓). 헛예측, 클래스가 틀린 예측, 박스가 너무 어긋난 예측, 그리고 뒤에서 볼 중복 예측이 모두 여기에 들어갑니다.
- 거짓 음성false negative, FN: 어떤 예측과도 짝을 이루지 못한 정답. 탐지기가 “없다” 고 한 셈인데(음성) 실제로는 있었습니다(거짓). 놓친 객체입니다.
TP 와 FP 는 예측 에 붙는 딱지이고, FN 은 정답 에 붙는 딱지라는 점을 눈여겨보세요. 그래서 늘 다음 두 식이 성립합니다.
$$ \mathrm{TP} + \mathrm{FP} = \text{예측의 수}, \qquad \mathrm{TP} + \mathrm{FN} = \text{정답의 수} $$여기서 $\mathrm{TP}$, $\mathrm{FP}$, $\mathrm{FN}$ 은 각각 참 양성 · 거짓 양성 · 거짓 음성의 개수 입니다. 두 번째 식은 “정답 하나는 예측 하나와 짝을 이루었거나(그 예측이 TP), 못 이루었거나(FN)” 라는 뜻입니다. 이 식이 성립하려면 TP 하나가 정답 하나에 꼭 하나씩 대응해야 합니다. 바로 다음에 볼 짝짓기 규칙이 그것을 보장합니다.
짝짓기 규칙
“제대로 가리켰다” 를 판정하려면 기준이 필요합니다. 박스가 정답과 한 픽셀도 다르지 않아야 한다고 하면 너무 가혹하고, 조금이라도 겹치면 된다고 하면 너무 후합니다. 그래서 2장의 IoU 에 문턱값을 겁니다. 이 문턱값을 IoU 문턱값IoU threshold 이라 부르고 이 장에서는 $\tau$ (타우)로 적습니다. 가장 널리 쓰는 값은 $\tau = 0.5$ 입니다. COCO 의 채점 프로그램이 쓰는 규칙은 다음과 같습니다. 그림 한 장, 클래스 하나 에 대해 적용합니다.
- 그 그림에서 그 클래스로 예측된 박스들을 점수가 높은 순서 로 늘어놓습니다.
- 맨 위의 예측부터 차례로, 아직 짝이 없는 같은 클래스의 정답 가운데 IoU 가 가장 큰 것을 찾습니다.
- 그 IoU 가 $\tau$ 이상이면 그 예측은 TP 이고, 그 정답에는 “짝 있음” 표시를 합니다. 이 정답은 다시 쓰이지 않습니다.
- $\tau$ 에 못 미치면(또는 남은 정답이 없으면) 그 예측은 FP 입니다.
- 모든 예측을 본 뒤에도 짝이 없는 정답은 FN 입니다.
각 예측이 그때그때 가장 좋아 보이는 정답을 집어 가고 뒤는 돌아보지 않으므로 이런 방식을 탐욕적(greedy) 짝짓기라고 부릅니다. 규칙에서 꼭 기억할 것은 두 가지입니다. ① 점수가 높은 예측이 먼저 고른다. ② 정답 하나는 한 번만 쓰인다.
손으로 채점해 보기
모눈 10×10 칸짜리 그림에 원이 둘 있고(정답 G1, G2), 탐지기가 “원” 이라고 예측한 박스가 넷(P1 – P4) 있다고 합시다. 좌표는 $(x_0, y_0, x_1, y_1)$ 이고 단위는 모눈 한 칸입니다. $x$ 는 오른쪽으로, $y$ 는 아래쪽으로 커집니다.
| 이름 | 박스 $(x_0, y_0, x_1, y_1)$ | 넓이 | 점수 |
|---|---|---|---|
| 정답 G1 | (1, 1, 5, 5) | 4 × 4 = 16 | — |
| 정답 G2 | (6, 5, 9, 9) | 3 × 4 = 12 | — |
| 예측 P1 | (1, 1, 5, 6) | 4 × 5 = 20 | 0.9 |
| 예측 P2 | (2, 1, 6, 5) | 4 × 4 = 16 | 0.8 |
| 예측 P3 | (6, 6, 10, 9) | 4 × 3 = 12 | 0.7 |
| 예측 P4 | (1, 7, 3, 9) | 2 × 2 = 4 | 0.6 |
먼저 필요한 IoU 를 계산합니다. IoU 는 “교집합 넓이 ÷ 합집합 넓이” 이고, 합집합 넓이는 “두 넓이의 합 − 교집합 넓이” 였습니다(2장).
이제 점수 순서대로 규칙을 적용합니다. 그림 3-1 의 오른쪽이 그 과정입니다.
- P1 (점수 0.9): 짝 없는 정답은 G1, G2. IoU 는 0.8 과 0 이므로 G1 을 고릅니다. $0.8 \ge 0.5$ 이므로 TP. G1 은 이제 쓰였습니다.
- P2 (점수 0.8): 짝 없는 정답은 G2 뿐입니다. P2 와 G2 의 IoU 는 0 이므로 FP.
- P3 (점수 0.7): 짝 없는 정답은 G2. IoU 0.6 은 0.5 이상이므로 TP. G2 도 쓰였습니다.
- P4 (점수 0.6): 짝 없는 정답이 남아 있지 않습니다. FP.
- 짝 없는 정답이 없으므로 FN 은 0개 입니다.
결과는 $\mathrm{TP} = 2$, $\mathrm{FP} = 2$, $\mathrm{FN} = 0$ 입니다. 앞의 두 식도 확인됩니다. $\mathrm{TP} + \mathrm{FP} = 4$ 는 예측의 수, $\mathrm{TP} + \mathrm{FN} = 2$ 는 정답의 수입니다.
중복 예측이 벌점을 받는 이유
P2 를 다시 봅시다. P2 는 G1 과 IoU 가 0.6 이나 됩니다. 혼자 있었다면 당당한 참 양성입니다. 그런데도 거짓 양성이 된 것은 G1 을 P1 이 먼저 가져갔기 때문 입니다. 같은 객체를 가리키는 예측이 둘 이상 있으면, 점수가 가장 높은 하나만 참 양성이 되고 나머지는 모두 거짓 양성이 됩니다. 이런 나머지를 중복 예측duplicate detection 이라고 부릅니다.
이 규칙이 없다면 어떻게 될까요? 객체 하나에 박스를 100개 겹쳐 쳐도 100개가 모두 참 양성이 됩니다. 탐지 결과를 받아 쓰는 쪽(예를 들어 “사람이 몇 명인지 세는” 프로그램)에게 그런 출력은 쓸모가 없습니다. 그래서 채점 규칙은 “객체 하나에는 예측도 하나” 를 요구합니다. 이 요구가 이 튜토리얼 전체를 꿰는 줄기 하나입니다. 뒤에서 볼 NMS 는 이 요구를 사후 처리 로 맞추는 방법이고, 7장의 DETR 은 이 요구를 학습 방법 으로 맞추는 방법입니다.
만약 P2 의 점수가 0.95 로 P1 보다 높았다면 P2 가 먼저 G1 을 가져가 TP 가 되고, 더 정확한 박스인 P1 이 FP 가 됩니다. TP 의 수는 그대로 2개이지만, 덜 정확한 박스가 참 양성 자리를 차지 합니다. 지금은 차이가 없어 보여도, 바로 아래처럼 IoU 문턱값을 올리면 차이가 드러납니다. 점수가 박스의 질을 얼마나 잘 반영하는가는 이 장의 실험 2 에서 다시 다룹니다.
IoU 문턱값을 올리면
같은 예측을 더 엄격한 기준 $\tau = 0.75$ 로 채점해 봅시다. 달라지는 것은 P3 입니다.
- P1: G1 과 IoU 0.8. $0.8 \ge 0.75$ 이므로 TP.
- P2: 남은 G2 와 IoU 0. FP.
- P3: G2 와 IoU 0.6. $0.6 \lt 0.75$ 이므로 이번에는 FP. G2 는 여전히 짝이 없습니다.
- P4: 남은 G2 와 IoU 0. FP.
- G2 는 끝까지 짝이 없으므로 FN 1개.
결과는 $\mathrm{TP} = 1$, $\mathrm{FP} = 3$, $\mathrm{FN} = 1$ 입니다. 여기서 한 가지를 배웁니다. 박스가 부정확한 예측은 이중으로 벌을 받습니다. P3 는 거짓 양성이 되었고(FP + 1), 동시에 그것이 가리키던 G2 는 놓친 객체가 되었습니다(FN + 1). 그리고 같은 탐지 결과라도 $\tau$ 를 무엇으로 잡느냐에 따라 점수가 달라집니다. COCO 가 $\tau$ 를 하나로 정하지 않고 여러 값을 쓰는 까닭이 여기에 있습니다(뒤의 “IoU 문턱값 열 개의 평균”).
짝짓기 코드
위의 규칙을 그대로 옮긴 함수가 match_detections 입니다. 그림 한 장 · 클래스 하나의 예측과 정답을 받아, 점수 순으로 늘어놓은 예측마다 TP 인지 아닌지를 돌려줍니다.
box_iou는 2장에서 만든 함수로, 예측 $n$ 개와 정답 $m$ 개의 모든 쌍의 IoU 를 모양(n, m)의 표로 돌려줍니다. 위 예에서는(4, 2)입니다.gt_used가 “짝 있음” 표시입니다. 이미 쓰인 정답의 IoU 를 −1 로 덮어써서 후보에서 뺍니다.- 남은 후보 가운데 가장 큰 IoU(
best_iou)가 문턱값 이상일 때만 TP 로 적고 그 정답을 쓴 것으로 표시합니다.
손으로 계산한 예를 이 함수에 넣어 봅니다. 실습 파일의 hand_examples 가 이 장의 손계산을 모두 다시 계산해 출력합니다.
$ python ch03_metrics.py[1] 손계산 예 확인 IoU 표 (행 P1–P4, 열 G1 G2): [[0.8, 0.0], [0.6, 0.0], [0.0, 0.6], [0.0, 0.0]] IoU 문턱값 0.50: TP 여부 [True, False, True, False] → TP 2, FP 2, FN 0 IoU 문턱값 0.75: TP 여부 [True, False, False, False] → TP 1, FP 3, FN 1
손계산과 같습니다. (출력의 나머지 줄은 뒤의 절에서 하나씩 봅니다.)
정밀도와 재현율
두 가지 물음
TP · FP · FN 을 셌으니 이제 점수를 만들 차례입니다. 탐지기에게 물을 수 있는 물음은 두 가지입니다.
- “네가 찾았다고 한 것 가운데 진짜는 얼마나 되느냐?” — 헛짚지 않는 능력
- “진짜 가운데 네가 찾은 것은 얼마나 되느냐?” — 빠뜨리지 않는 능력
첫째가 정밀도precision, 둘째가 재현율recall 입니다. 정밀도를 $P$, 재현율을 $R$ 로 적겠습니다.
$$ P = \frac{\mathrm{TP}}{\mathrm{TP} + \mathrm{FP}} = \frac{\text{맞은 예측의 수}}{\text{예측의 수}}, \qquad R = \frac{\mathrm{TP}}{\mathrm{TP} + \mathrm{FN}} = \frac{\text{맞은 예측의 수}}{\text{정답의 수}} $$분자는 같고 분모만 다릅니다. 정밀도는 예측 을 기준으로, 재현율은 정답 을 기준으로 나눕니다. 둘 다 0 과 1 사이이고 클수록 좋습니다. 두 식 어디에도 참 음성(TN)이 없다는 점이 중요합니다. 셀 수 없는 것을 쓰지 않고 탐지기를 채점할 수 있게 되었습니다.
그림 3-1 의 예로 계산합니다($\tau = 0.5$ 일 때 TP 2, FP 2, FN 0, $\tau = 0.75$ 일 때 TP 1, FP 3, FN 1).
둘 가운데 하나만 보면 속기 쉽습니다. 그림 전체를 박스로 뒤덮으면 재현율은 쉽게 1 이 되지만 정밀도는 바닥입니다. 가장 자신 있는 박스 하나만 내면 정밀도는 1 이 되기 쉽지만 재현율은 바닥입니다. 두 값을 함께 보아야 합니다.
점수 문턱값이라는 손잡이
탐지기는 예측마다 점수를 붙여 내놓습니다. 실제로 쓸 때는 보통 “점수가 얼마 이상인 예측만 인정한다” 는 기준을 둡니다. 이 기준이 점수 문턱값score threshold, confidence threshold 입니다. IoU 문턱값 $\tau$ 와는 전혀 다른 것이니 헷갈리지 마세요.
- IoU 문턱값 $\tau$: 예측 박스가 정답 박스와 얼마나 겹쳐야 “맞았다” 고 칠지. 채점하는 쪽 이 정합니다.
- 점수 문턱값: 점수가 얼마 이상인 예측을 내보낼지. 탐지기를 쓰는 쪽 이 정합니다.
그림 3-1 의 예측 넷(점수 0.9, 0.8, 0.7, 0.6)에서 점수 문턱값을 바꿔 봅시다. IoU 문턱값은 0.5 로 둡니다. 점수 순서대로 TP · FP · TP · FP 였습니다.
| 점수 문턱값 | 인정되는 예측 | TP | FP | FN | 정밀도 | 재현율 |
|---|---|---|---|---|---|---|
| 0.85 | P1 | 1 | 0 | 1 | 1/1 = 1.000 | 1/2 = 0.500 |
| 0.75 | P1, P2 | 1 | 1 | 1 | 1/2 = 0.500 | 1/2 = 0.500 |
| 0.65 | P1, P2, P3 | 2 | 1 | 0 | 2/3 = 0.667 | 2/2 = 1.000 |
| 0.55 | P1, P2, P3, P4 | 2 | 2 | 0 | 2/4 = 0.500 | 2/2 = 1.000 |
  점수 문턱값 0.85 (위에서 1개 인정): 정밀도 1.000, 재현율 0.500
  점수 문턱값 0.75 (위에서 2개 인정): 정밀도 0.500, 재현율 0.500
  점수 문턱값 0.65 (위에서 3개 인정): 정밀도 0.667, 재현율 1.000
  점수 문턱값 0.55 (위에서 4개 인정): 정밀도 0.500, 재현율 1.000
표에서 두 가지를 읽을 수 있습니다.
- 재현율은 문턱값을 내릴수록 늘거나 그대로입니다. 절대 줄지 않습니다. 예측을 더 인정한다고 해서 이미 찾은 객체를 잃지는 않기 때문입니다.
- 정밀도는 오르락내리락합니다. 새로 인정한 예측이 FP 이면 내려가고(1.000 → 0.500), TP 이면 올라갑니다(0.500 → 0.667). 다만 큰 흐름으로는, 점수가 낮은 예측일수록 틀릴 가능성이 높으므로 문턱값을 내릴수록 정밀도는 떨어지는 쪽으로 갑니다.
이것이 정밀도와 재현율의 맞바꿈(trade-off) 입니다. 문턱값을 올리면 정밀도를 얻고 재현율을 내주며, 내리면 그 반대입니다. 어디에 둘지는 쓰임새가 정합니다. 암 검진처럼 놓치면 큰일인 곳에서는 문턱값을 낮춰 재현율을 챙기고, 사람에게 경보를 울리는 장치처럼 헛경보가 성가신 곳에서는 문턱값을 올려 정밀도를 챙깁니다.
정밀도와 재현율을 한 숫자로 묶는 흔한 방법 하나가 F1 점수F1 score 입니다. 둘의 조화 평균입니다.
$$ F_1 = \frac{2PR}{P + R} $$조화 평균은 둘 가운데 작은 쪽에 끌려가므로, 한쪽만 높아서는 F1 이 높아지지 않습니다. 위 표에서 문턱값 0.65 일 때 $F_1 = 2 \times 0.667 \times 1 / (0.667 + 1) = 0.8$ 로 가장 큽니다. F1 은 “문턱값을 하나 정했을 때” 의 점수여서 실제 배치할 문턱값을 고를 때 쓸모가 있지만, 탐지 논문의 대표 지표는 아닙니다. 논문들이 쓰는 지표는 문턱값을 하나로 정하지 않고 모든 문턱값을 한꺼번에 보는 AP 입니다. 이제 그쪽으로 갑니다.
정밀도 – 재현율 곡선
점수 순으로 하나씩 인정하기
앞 절에서 점수 문턱값을 네 번 바꿔 정밀도 · 재현율 쌍을 네 개 얻었습니다. 문턱값을 가능한 모든 값으로 바꿔 가며 얻는 쌍을 모두 모아 가로축에 재현율, 세로축에 정밀도를 놓고 이은 것이 정밀도 – 재현율 곡선precision-recall curve, PR curve 입니다. 줄여서 PR 곡선이라고 부릅니다.
“가능한 모든 문턱값” 이라고 해도 실제로 달라지는 순간은 예측의 수만큼뿐입니다. 문턱값을 위에서부터 천천히 내리면 예측이 점수 순으로 하나씩 인정됩니다. 그래서 PR 곡선을 그리는 절차는 이렇습니다.
- 어떤 클래스 하나에 대해, 데이터셋의 모든 그림 에서 나온 그 클래스의 예측을 한데 모읍니다.
- 예측마다 TP 인지 FP 인지는 앞의 짝짓기 규칙으로 그림마다 따로 이미 정해 두었습니다.
- 모은 예측을 점수가 높은 순서 로 한 줄로 세웁니다.
- 위에서부터 $k$ 개까지만 인정했을 때의 정밀도 $P_k$ 와 재현율 $R_k$ 를 $k = 1, 2, \dots$ 에 대해 계산합니다.
위에서 $k$ 개 가운데 TP 의 수를 $\mathrm{TP}_k$, 그 클래스 정답의 총수를 $N_{\mathrm{gt}}$ 라 하면(gt 는 ground truth, 곧 정답),
$$ P_k = \frac{\mathrm{TP}_k}{k}, \qquad R_k = \frac{\mathrm{TP}_k}{N_{\mathrm{gt}}} $$입니다. 인정한 예측이 $k$ 개이므로 $\mathrm{TP}_k + \mathrm{FP}_k = k$ 이고, 정답의 수 $N_{\mathrm{gt}}$ 는 $k$ 와 상관없이 고정입니다.
이 장 끝까지 쓸 예를 하나 정합니다. 어떤 클래스의 정답이 3개 이고, 탐지기가 낸 예측이 5개 인데 점수 순으로 세웠더니 TP · FP · TP · FP · TP 였다고 합시다.
| 순위 $k$ | 점수 | 판정 | 누적 TP | 누적 FP | 정밀도 $P_k$ | 재현율 $R_k$ |
|---|---|---|---|---|---|---|
| 1 | 0.95 | TP | 1 | 0 | 1/1 = 1.000 | 1/3 = 0.333 |
| 2 | 0.90 | FP | 1 | 1 | 1/2 = 0.500 | 1/3 = 0.333 |
| 3 | 0.80 | TP | 2 | 1 | 2/3 = 0.667 | 2/3 = 0.667 |
| 4 | 0.70 | FP | 2 | 2 | 2/4 = 0.500 | 2/3 = 0.667 |
| 5 | 0.60 | TP | 3 | 2 | 3/5 = 0.600 | 3/3 = 1.000 |
점수 칸의 값은 보기일 뿐입니다. 곡선을 정하는 것은 점수의 크기가 아니라 순서 입니다. 0.95, 0.90, … 대신 0.5, 0.4, … 였어도 표의 나머지는 한 글자도 바뀌지 않습니다. 이 점은 뒤에서 여러 번 다시 쓰입니다.
톱니 모양
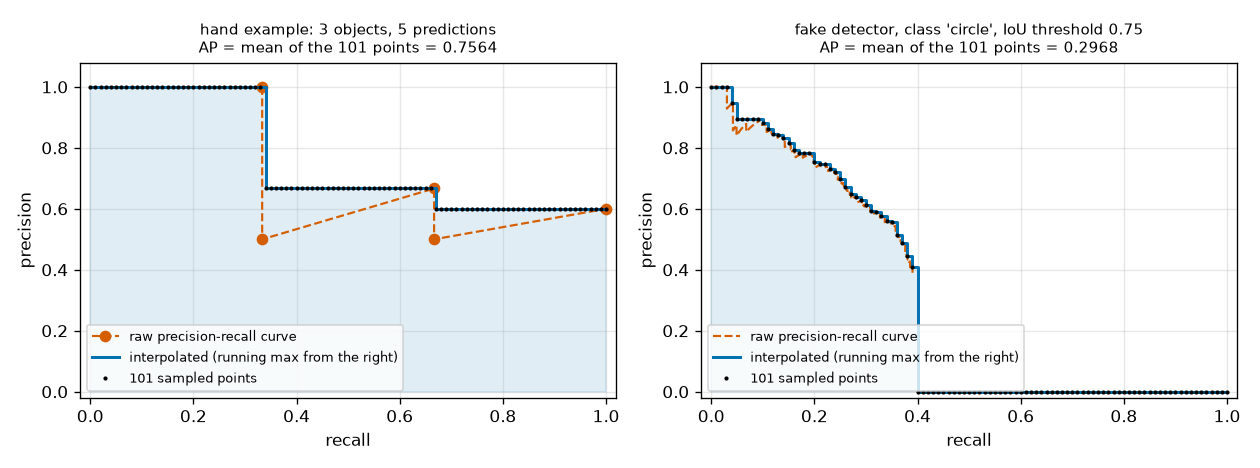
다섯 점 $(R_k, P_k)$ 을 차례로 이으면 그림 3-2 왼쪽의 주황색 점선이 됩니다. 곡선이 매끈하게 내려가지 않고 톱니 처럼 생겼습니다. 까닭은 표에서 바로 읽을 수 있습니다.
- FP 를 하나 인정하면 재현율은 그대로이고 정밀도만 떨어집니다. 곡선이 수직으로 아래로 내려갑니다($k = 1 \to 2$: 재현율 0.333 그대로, 정밀도 1.000 → 0.500).
- TP 를 하나 인정하면 재현율이 $1/N_{\mathrm{gt}}$ 만큼 늘고 정밀도도 오릅니다. 곡선이 오른쪽 위로 올라갑니다($k = 2 \to 3$: 재현율 0.333 → 0.667, 정밀도 0.500 → 0.667).
보간: 톱니를 깎아 내기
톱니의 파인 부분을 봅시다. $k = 2$ 의 점은 (재현율 0.333, 정밀도 0.500) 이고 $k = 3$ 의 점은 (재현율 0.667, 정밀도 0.667) 입니다. $k = 3$ 쪽이 재현율도 높고 정밀도도 높습니다. 문턱값을 고르는 사람이라면 $k = 2$ 에 해당하는 문턱값을 쓸 까닭이 없습니다. 예측을 하나 더 인정하기만 하면 두 값이 모두 좋아지니까요.
그래서 AP 를 계산할 때는 이런 파인 부분을 메웁니다. 각 자리의 정밀도를 “그 자리와 그 오른쪽(재현율이 같거나 더 높은 자리) 가운데 가장 높은 정밀도” 로 바꿉니다. 이것을 보간 정밀도interpolated precision 라고 부르고 $\tilde{P}_k$ (P 틸데)로 적겠습니다.
$$ \tilde{P}_k = \max_{j \ge k} P_j $$$\max_{j \ge k}$ 는 “$k$ 번째부터 끝까지 가운데 가장 큰 값” 이라는 뜻입니다. 계산은 오른쪽 끝에서 왼쪽으로 가면서 지금까지 본 최댓값을 적어 나가면 됩니다(누적 최댓값).
보간 정밀도를 순위 $k$ 가 아니라 재현율 $r$ 의 함수 로 쓰면 뒤의 계산이 편합니다. “재현율이 $r$ 이상인 자리들 가운데 가장 높은 정밀도” 를 $p_{\mathrm{interp}}(r)$ 로 적습니다(interp 는 interpolated, 보간했다는 뜻).
$$ p_{\mathrm{interp}}(r) = \max_{k \,:\, R_k \ge r} P_k \qquad (\text{그런 } k \text{ 가 없으면 } 0) $$말로 풀면 “재현율을 적어도 $r$ 만큼 얻으려 할 때 누릴 수 있는 가장 높은 정밀도” 입니다. 위 예에서는 다음과 같은 계단 모양이 됩니다(그림 3-2 왼쪽의 파란 선).
| 재현율 $r$ 의 범위 | $R_k \ge r$ 인 자리 | $p_{\mathrm{interp}}(r)$ |
|---|---|---|
| $0 \le r \le 1/3$ | $k = 1, 2, 3, 4, 5$ | $\max(1, 0.5, 0.667, 0.5, 0.6) = 1$ |
| $1/3 \lt r \le 2/3$ | $k = 3, 4, 5$ | $\max(0.667, 0.5, 0.6) = 0.667$ |
| $2/3 \lt r \le 1$ | $k = 5$ | $0.6$ |
탐지기가 정답을 다 찾지 못해 재현율이 끝까지 가지 못하는 경우도 있습니다. 예를 들어 가장 높은 재현율이 0.4 라면 $r \gt 0.4$ 에서는 조건을 채우는 자리가 없으므로 $p_{\mathrm{interp}}(r) = 0$ 입니다. 그림 3-2 의 오른쪽이 그런 경우입니다. 재현율 0.4 근처에서 곡선이 끝나고 그 뒤로는 0 입니다. 놓친 객체는 PR 곡선의 오른쪽을 0 으로 만드는 방식으로 벌을 받습니다.
AP: 곡선을 숫자 하나로
곡선 아래의 넓이
PR 곡선은 탐지기의 성격을 잘 보여 주지만, 탐지기 둘을 견주려면 숫자 하나가 필요합니다. 곡선이 오른쪽 위 에 붙어 있을수록(높은 재현율에서도 정밀도가 높을수록) 좋은 탐지기이므로, 자연스러운 요약은 곡선 아래의 넓이 입니다. 이것이 APaverage precision, 평균 정밀도 입니다.
$$ \AP \approx \int_0^1 p_{\mathrm{interp}}(r)\, dr $$적분 기호 $\int_0^1 \dots dr$ 는 “$r$ 을 0 에서 1 까지 움직이며 곡선 아래의 넓이를 잰다” 는 뜻입니다. 가로 길이가 1 이므로 넓이는 곧 재현율 전 구간에 걸친 정밀도의 평균 이고, “평균 정밀도” 라는 이름이 여기서 나왔습니다. 완벽한 탐지기는 모든 재현율에서 정밀도가 1 이므로 AP = 1 이고, 아무것도 못 찾는 탐지기는 AP = 0 입니다.
위 예는 계단이 셋이라 넓이를 바로 계산할 수 있습니다. 폭이 $1/3$ 씩이고 높이가 1, 0.667, 0.6 입니다.
$$ \frac{1}{3} \times 1 + \frac{1}{3} \times \frac{2}{3} + \frac{1}{3} \times 0.6 = \frac{1 + 0.6667 + 0.6}{3} = 0.7556 $$COCO 의 101점 보간
COCO 의 채점 프로그램은 넓이를 정확히 재는 대신, 재현율 축에 일정한 간격으로 101개의 지점 을 찍고 그 지점들의 보간 정밀도를 평균합니다. 지점은 $r_i = i/100$, 곧 0, 0.01, 0.02, …, 1.00 입니다.
$$ \AP = \frac{1}{101} \sum_{i=0}^{100} p_{\mathrm{interp}}\!\left(\frac{i}{100}\right) $$$\sum_{i=0}^{100}$ 은 “$i$ 를 0 부터 100 까지 바꿔 가며 더한다” 는 뜻입니다. 이 장에서 AP 라고 하면 이 식을 가리킵니다. 위 예로 한 줄씩 계산합니다.
코드는 두 함수로 나뉩니다. precision_recall_curve 가 표의 $P_k$, $R_k$ 를 만들고, average_precision 이 보간과 101점 평균을 합니다.
np.cumsum(is_tp)는 누적 합입니다.[True, False, True, False, True]를 넣으면[1, 1, 2, 2, 3], 곧 표의 “누적 TP” 칸이 됩니다.~is_tp는 참 · 거짓을 뒤집은 것이므로 그 누적 합이 “누적 FP” 입니다.np.maximum.accumulate(precision[::-1])[::-1]이 “오른쪽부터의 누적 최댓값” 입니다. 배열을 뒤집고([::-1]), 왼쪽부터 누적 최댓값을 구하고, 다시 뒤집습니다.np.searchsorted(recall, points, side="left")는 지점 $r$ 마다 “재현율이 처음으로 $r$ 이상이 되는 자리” 를 찾습니다. 재현율은 줄어들지 않는 배열이므로 이진 탐색으로 찾을 수 있습니다. 그 자리의 보간 정밀도가 바로 $p_{\mathrm{interp}}(r)$ 입니다.- 그런 자리가 없으면(
index가 배열 길이와 같으면) 0 을 씁니다. 탐지기가 닿지 못한 재현율 구간입니다.
  정밀도   [1.0, 0.5, 0.667, 0.5, 0.6]
  재현율   [0.333, 0.333, 0.667, 0.667, 1.0]
  보간 정밀도 [1.0, 0.667, 0.667, 0.6, 0.6]
  AP (101점) 0.7564 | 손계산 (34·1 + 33·(2/3) + 34·0.6)/101 = 0.7564
  참고: 11점 방식 0.7636, 보간 곡선 아래의 정확한 넓이 0.7556
손계산과 코드가 같은 값 0.7564 를 냅니다. 실습 파일은 여기에 더해, average_precision 을 “지점마다 재현율이 $r$ 이상인 자리의 정밀도 가운데 최댓값을 구해 평균한다” 는 정의 그대로의 느린 계산과 무작위 입력 300개로 대조합니다.
[2] 구현 대조
  average_precision 과 정의 그대로의 계산: 300번 가운데 가장 큰 차이 2.2e-15
  nms 와 느린 구현: 300번 가운데 300번 일치
차이 $2.2 \times 10^{-15}$ 는 컴퓨터가 실수를 유한한 자릿수로 다루어서 생기는 오차 수준이므로 두 계산은 같다고 보아도 됩니다. (둘째 줄의 NMS 는 이 장 뒤쪽에서 다룹니다.)
지점을 몇 개 찍을지는 약속입니다. COCO 이전의 대표 벤치마크였던 PASCAL VOC 는 한때 재현율 0, 0.1, …, 1.0 의 11개 지점 만 쓰는 방식을 썼습니다. 위 예를 11점으로 계산하면 0 – 0.3 의 4개 지점이 1, 0.4 – 0.6 의 3개 지점이 0.667, 0.7 – 1.0 의 4개 지점이 0.6 이므로 $(4 + 2 + 2.4)/11 = 0.7636$ 입니다. 같은 탐지 결과인데 방식에 따라 0.7636, 0.7564, 0.7556 으로 조금씩 다릅니다. 그래서 AP 를 견줄 때는 같은 방식으로 계산한 것끼리 견주어야 합니다. 요즘 논문이 COCO 의 AP 를 보고할 때는 모두 COCO 의 공식 채점 프로그램(pycocotools)이 쓰는 101점 방식입니다.
AP 가 가진 네 가지 성질
정의에서 바로 따라 나오는 성질을 정리해 둡니다. 뒤의 실험에서 하나씩 눈으로 확인합니다.
- 점수 문턱값을 정할 필요가 없습니다. AP 는 모든 문턱값에서의 정밀도 · 재현율을 한꺼번에 봅니다. 그래서 “문턱값을 어디에 두었느냐” 에 따라 탐지기의 우열이 바뀌는 일이 없습니다.
- 점수의 크기가 아니라 순서만 봅니다. 모든 점수를 절반으로 줄여도, 제곱해도, 순서가 그대로이면 AP 는 그대로입니다. 거꾸로 박스가 하나도 바뀌지 않아도 점수의 순서가 바뀌면 AP 가 바뀝니다.
- 앞쪽의 FP 는 비싸고, 맨 뒤의 FP 는 공짜입니다. 높은 점수의 FP 는 그 뒤의 모든 자리의 정밀도를 깎습니다. 반면 마지막 TP 보다 점수가 낮은 FP 는 AP 를 전혀 바꾸지 못합니다. 그 자리의 정밀도는 낮지만, 보간은 “오른쪽의 최댓값” 을 가져오므로 왼쪽 자리의 값을 건드리지 못하고, 101개 지점은 모두 그보다 앞자리에서 값을 읽기 때문입니다.
- 놓친 객체는 채울 수 없는 0 으로 남습니다. 가장 높은 재현율이 $R_{\max}$ 이면 그보다 오른쪽의 지점들은 모두 0 이므로, AP 는 대략 $R_{\max}$ 를 넘지 못합니다.
셋째 성질을 앞의 예로 확인해 봅시다. 다섯 예측 뒤에 점수 0.1 짜리 FP 를 100개 덧붙여도 $R_k \ge r$ 을 처음 만족하는 자리(1번, 3번, 5번)와 그 자리의 보간 정밀도는 그대로입니다. 덧붙인 자리들의 정밀도는 $3/6, 3/7, \dots$ 로 모두 $P_5 = 0.6$ 보다 작아서 누적 최댓값을 바꾸지 못합니다. AP 는 여전히 0.7564 입니다.
mAP 와 COCO 의 지표들
클래스 평균
지금까지의 AP 는 클래스 하나 에 대한 값이었습니다. 도형 세상이라면 “원의 AP”, “사각형의 AP”, “삼각형의 AP” 가 따로 나옵니다. 탐지기 전체의 점수는 이것을 클래스에 대해 평균 한 값이고, 이것을 mAPmean average precision 라고 부릅니다. 클래스의 수를 $C$, 클래스 $c$ 의 AP 를 $\AP_c$ 라 하면
$$ \mathrm{mAP} = \frac{1}{C} \sum_{c=1}^{C} \AP_c $$입니다. 클래스마다 따로 계산해 평균하므로 객체가 많은 클래스와 적은 클래스가 같은 무게 를 갖습니다. COCO 에서 사람은 2014년 공개분의 학습 · 검증 세트에만 27만 개 가까이 있지만(COCO 논문), 사람의 AP 도 훨씬 드문 클래스의 AP 도 mAP 에는 똑같이 $1/C$ 씩 들어갑니다. 흔한 클래스만 잘 찾는 탐지기가 높은 점수를 받지 못하게 하는 장치입니다.
IoU 문턱값 열 개의 평균
앞에서 IoU 문턱값 $\tau$ 를 0.5 에서 0.75 로 올리자 같은 예측의 TP 가 2개에서 1개로 줄었습니다. $\tau = 0.5$ 하나만 쓰면 “IoU 0.51 로 간신히 걸친 박스” 와 “IoU 0.95 로 꼭 맞는 박스” 가 똑같이 TP 입니다. 박스를 얼마나 정확히 치는지가 점수에 드러나지 않습니다.
COCO 는 이 문제를 문턱값 10개로 각각 AP 를 계산해 평균 하는 것으로 풉니다. 문턱값은 0.50 부터 0.05 간격으로 0.95 까지입니다. 클래스 $c$ 를 IoU 문턱값 $\tau$ 로 채점한 AP 를 $\AP_c^{\tau}$ 로 적으면, COCO 의 대표 지표는 다음과 같습니다.
$$ \AP = \frac{1}{10} \sum_{\tau \in \{0.50,\, 0.55,\, \dots,\, 0.95\}} \;\frac{1}{C} \sum_{c=1}^{C} \AP_c^{\tau} $$이 지표를 글로는 AP@[.50:.05:.95], AP@[.5:.95], AP50:95, mAP@50:95 처럼 여러 가지로 적습니다. 모두 같은 것입니다(RF-DETR 논문도 표에서는 AP, 본문에서는 mAP 50:95 라고 섞어 씁니다). COCO 공식 문서는 여러 문턱값을 평균하는 까닭을 “위치를 더 정확히 맞히는 탐지기에게 보상하기 위해서” 라고 적고 있습니다.
원래 뜻으로는 AP 가 클래스 하나의 값, mAP 가 그 평균입니다. 그런데 COCO 공식 문서는 “AP 는 모든 클래스에 대해 평균한 것이며, 전통적으로는 이것을 mAP 라 부르지만 우리는 AP 와 mAP 를 구별하지 않는다” 고 밝힙니다. 그래서 요즘 논문의 표에 적힌 “AP” 는 이미 클래스 평균이고 IoU 문턱값 평균입니다. 이 튜토리얼도 앞으로 “AP” 라고만 쓰면 위 식의 값(클래스 평균 · 문턱값 10개 평균)을 뜻합니다. 클래스 하나 · 문턱값 하나의 값을 말할 때는 $\AP_c^{\tau}$ 처럼 첨자를 달거나 말로 밝히겠습니다.
COCO 는 80개 클래스를 쓰므로, AP 한 숫자는 10 × 80 = 800개의 PR 곡선 에서 각각 101개 지점을 읽어 평균한 값입니다. 숫자 하나에 아주 많은 것이 눌려 들어가 있다는 뜻이고, 그래서 논문들은 이 숫자를 몇 가지로 쪼갠 값을 함께 보고합니다.
COCO 의 여섯 지표
COCO 공식 문서가 정한 탐지 지표 가운데 논문의 표에 거의 늘 나오는 것은 다음 여섯 가지입니다.
| 지표 | 뜻 | 무엇을 보나 |
|---|---|---|
| AP | IoU 문턱값 0.50, 0.55, …, 0.95 의 평균 | 대표 지표. 찾기와 정확한 박스를 함께 |
| AP50 | IoU 문턱값 0.50 하나만 | “대충이라도 찾았는가”. 옛 PASCAL VOC 의 기준 |
| AP75 | IoU 문턱값 0.75 하나만 | “박스가 꽤 정확한가”. 공식 문서의 표현은 엄격한 지표 |
| APS | 넓이가 32² 픽셀보다 작은 객체만 | 작은 객체 |
| APM | 넓이가 32² 와 96² 픽셀 사이인 객체만 | 중간 크기 객체 |
| APL | 넓이가 96² 픽셀보다 큰 객체만 | 큰 객체 |
- AP50AP at IoU = 0.50 과 AP75AP at IoU = 0.75 는 위 식에서 $\tau$ 하나만 남긴 것입니다. AP50 은 높은데 AP75 가 낮다면 “객체를 찾기는 하는데 박스가 헐겁다” 는 뜻입니다. 둘의 차이가 작을수록 박스가 정확합니다.
- 크기별 APAPS, APM, APL 는 정답 객체를 넓이로 세 무리로 나눠, 무리마다 따로 AP(문턱값 10개 평균)를 계산한 것입니다. $32^2 = 1024$ 픽셀, $96^2 = 9216$ 픽셀이 경계입니다. 넓이는 원본 그림의 픽셀 수로 재며, COCO 는 박스가 아니라 객체의 분할 마스크가 차지하는 픽셀 수를 씁니다. 공식 문서에 따르면 COCO 의 객체는 약 41% 가 작은 객체, 34% 가 중간, 24% 가 큰 객체입니다. 작은 객체가 가장 많고, 뒤에서 보겠지만 가장 어렵습니다.
- 모든 지표는 그림 한 장에서 점수가 높은 순으로 최대 100개의 예측만 인정하고 계산합니다. 박스를 수천 개 쏟아 내 재현율을 억지로 올리는 것을 막는 규칙입니다. 질의가 300개인 DETR 계열 탐지기가 예측을 300개 내보내더라도, 채점에는 그림마다 점수 상위 100개만 쓰입니다.
COCO(Common Objects in Context)는 Lin 외(2014)가 만든 데이터셋입니다. 논문은 이것을 91가지 객체 종류, 그림 32만 8천 장, 라벨된 객체 250만 개의 데이터셋으로 소개하고, 2014년 공개분은 그 가운데 80개 클래스 로 한정했다고 적습니다. 탐지 벤치마크가 쓰는 것이 이 80개 클래스입니다. 사람이 빽빽이 모인 군중처럼 객체를 하나하나 가르기 어려운 영역은 “crowd” 로 따로 표시해 두었고, 채점 때 이 영역은 무시합니다(그 안의 예측은 TP 도 FP 도 아닙니다). 데이터셋에 대한 더 넓은 소개는 1장에 있습니다.
숫자로 확인하는 두 번의 평균
“문턱값 평균” 과 “클래스 평균” 이 실제로 어떤 숫자들의 평균인지 한 번 눈으로 봅시다. 아래는 뒤의 실험 1 에서 만들 가짜 탐지기 하나(잡음 0.10)를 도형 세상 검증 세트로 채점한 출력입니다.
  sigma 0.10 의 IoU 문턱값별 AP(클래스 평균): 0.971 0.898 0.771 0.558 0.345 0.170 0.047 0.008 0.001 0.000
    → 열 개의 평균 0.377
IoU 0.50 에서의 클래스별 AP: circle 0.981, rectangle 0.970, triangle 0.960 → 평균 0.971논문은 이 값에 100 을 곱해 37.7 처럼 적습니다. “48.0 AP” 는 0.480 입니다.
채점 코드 따라 읽기
지금까지의 조각을 모두 이어 붙인 것이 evaluate_ap 입니다. 7장부터 이 튜토리얼의 모든 탐지기를 이 함수로 채점합니다.
입력은 그림마다의 예측 목록과 정답 목록입니다. 박스는 0 – 1 로 정규화한 $(c_x, c_y, w, h)$ 이고(2장), 함수 안에서 $(x_0, y_0, x_1, y_1)$ 로 바꿔 씁니다. 세 겹의 반복문을 바깥에서 안으로 읽으면 이 장의 내용이 순서대로 나옵니다.
-
클래스마다(
for cls): 그 클래스의 정답 수 $N_{\mathrm{gt}}$ 를 데이터셋 전체에서 셉니다. 정답이 하나도 없는 클래스는 재현율의 분모가 0 이라 AP 를 정할 수 없으므로 건너뜁니다(표에nan으로 남고 평균에서 빠집니다). -
IoU 문턱값마다(
for ti, threshold): 기본값은COCO_IOU_THRESHOLDS, 곧 0.50, 0.55, …, 0.95 의 열 개입니다. -
그림마다(
for pred, target): 먼저 그 그림의 예측 가운데 점수 상위max_dets(100)개만 남깁니다. 그 가운데 지금 클래스의 예측과, 지금 클래스의 정답만 골라match_detections로 짝짓습니다. 결과(TP 여부)와 점수를 목록에 모읍니다. 짝짓기는 그림 안에서만 일어납니다. 3번 그림의 예측이 7번 그림의 정답과 짝이 될 수는 없으니까요. -
한 줄로 세우기: 모든 그림에서 모은 점수와 TP 여부를 이어 붙이고(
torch.cat), 점수 내림차순으로 정렬합니다(np.argsort(-scores_all)). 순위는 데이터셋 전체에서 매깁니다. -
PR 곡선과 AP:
precision_recall_curve와average_precision을 차례로 불러 값 하나를 얻고, 표table[문턱값, 클래스]에 적습니다. 표의 모양은(10, 클래스 수)입니다. -
평균: 표를 클래스 방향으로 평균하면 문턱값별 AP 열 개(
per_threshold), 그것을 다시 평균하면"AP"입니다. 문턱값 0.5 와 0.75 의 값은"AP50","AP75"로 따로 꺼내 줍니다.
3번과 4번의 대비가 중요합니다. 맞았는지 틀렸는지는 그림 안에서 정하고, 순위는 그림을 가리지 않고 매깁니다. 그래서 탐지기의 점수는 그림끼리 견줄 수 있어야 합니다. 쉬운 그림에서의 0.9 와 어려운 그림에서의 0.9 가 같은 “믿을 만함” 을 뜻해야 AP 가 높게 나옵니다.
evaluate_ap 는 COCO 의 공식 채점 프로그램 pycocotools 의 핵심 계산(탐욕적 짝짓기, 101점 보간, 문턱값 10개 평균)을 그대로 따르지만, 도형 세상에 필요 없는 부분은 뺐습니다.
- crowd 영역이 없습니다. pycocotools 는 crowd 로 표시된 정답과 겹친 예측을 TP 로도 FP 로도 세지 않습니다. 도형 세상에는 그런 정답이 없습니다.
- 크기별 지표(APS · APM · APL)와 평균 재현율(AR)은 계산하지 않습니다. 도형 세상의 그림은 96×96 이고 도형의 한 변이 13 – 40 픽셀이라, COCO 의 32² · 96² 기준으로 나누는 것이 뜻이 없습니다.
- “그림마다 최대 100개” 를 세는 방식이 다릅니다. 이 함수는 공식 문서의 설명대로 그림 한 장의 모든 클래스를 합쳐 상위 100개를 남깁니다. pycocotools 의 코드는 그림 한 장 · 클래스 하나마다 상위 100개를 남깁니다. 그림 한 장의 예측이 100개를 넘지 않으면 두 방식은 같습니다.
- 점수가 정확히 같은 예측의 순서 는 정렬 방법에 따라 달라질 수 있습니다.
이 장을 쓰면서 가짜 탐지 결과 네 가지를 pycocotools 2.0.11 로도 채점해 견주어 보았습니다(실습 파일에는 넣지 않았습니다. pycocotools 는 이 튜토리얼의 필수 패키지가 아닙니다). 점수가 겹치지 않고 그림마다 예측이 100개 이하인 두 경우는 AP · AP50 · AP75 가 소수 15자리까지 같았습니다. 같은 점수가 섞여 있던 경우는 AP 가 $6 \times 10^{-5}$ 만큼, 그림마다 예측이 100개를 넘던 경우는 $1.2 \times 10^{-4}$ 만큼 달랐고, 각각 점수를 겹치지 않게 하거나 100개 제한을 없애면 다시 15자리까지 같아졌습니다. 곧 차이는 위의 셋째 · 넷째 항목에서만 나왔습니다. 그래도 논문에 실을 COCO 점수는 반드시 공식 프로그램으로 계산해야 합니다.
실험: AP 는 무엇에 반응하나
정의를 아는 것과 감을 잡는 것은 다릅니다. 이 절에서는 AP 를 직접 흔들어 봅니다. 아직 탐지기를 만들지 않았으므로(7장부터 만듭니다) 정답을 일부러 망가뜨려 만든 “가짜 탐지기” 를 씁니다. 가짜 탐지기의 좋은 점은 무엇이 얼마나 틀렸는지를 우리가 정확히 안다는 것입니다. 박스만 흔들거나, 점수만 바꾸거나, 중복만 넣어 보면서 AP 가 그 하나에 어떻게 반응하는지를 따로따로 볼 수 있습니다.
가짜 탐지기 만들기
무대는 도형 세상의 검증 세트(ShapesDataset(500, seed=1))입니다. 그림 500장에 객체가 1,265개(원 428, 사각형 445, 삼각형 392) 있습니다.
채점에는 그림 자체는 필요 없고 정답 박스와 클래스만 있으면 됩니다. 가짜 탐지기는 다음 세 가지를 조절할 수 있습니다.
-
박스 위치 잡음
sigma: 정답 박스마다 예측을 하나 만들되, 중심을 “박스 크기 × sigma” 를 표준편차로 하는 가우시안 난수만큼 옮기고, 너비와 높이에 $e^{\text{sigma} \times z}$ ($z$ 는 표준 정규 난수)를 곱합니다. sigma 가 0 이면 정답 그대로, 0.1 이면 박스가 제 크기의 10% 쯤 어긋나고 10% 쯤 늘거나 줍니다. 클래스는 늘 정답 그대로 둡니다. -
점수를 매기는 방식
score_mode: 박스와 정답의 IoU 를 그대로 점수로 쓰거나("iou"), 거기에 잡음을 더하거나("noisy_iou"), 박스와 무관한 난수를 쓰거나("random"), 거꾸로 $1 - \IoU$ 를 씁니다("inverse"). -
덧붙이는 예측: 같은 객체를 한 번 더 예측한
duplicates(중복 예측)와, 아무 데나 놓은junk(헛예측).
실습 파일 전체는 학습이 없으므로 CPU 로 1분 남짓이면 끝납니다(--quick 은 그림 60장으로 10 – 20초).
코드에서는 난수 생성기를 박스용 · 점수용 · 추가분용으로 셋 두었다는 점만 짚어 둡니다. 덕분에 score_mode 만 바꾸면 박스는 한 치도 다르지 않고 점수만 달라지고,
duplicates 나 junk 를 바꾸면 원래 예측은 그대로 둔 채 덧붙는 것만 달라집니다. 실험에서 한 번에 하나만 바꾸려면 이런 준비가 필요합니다.
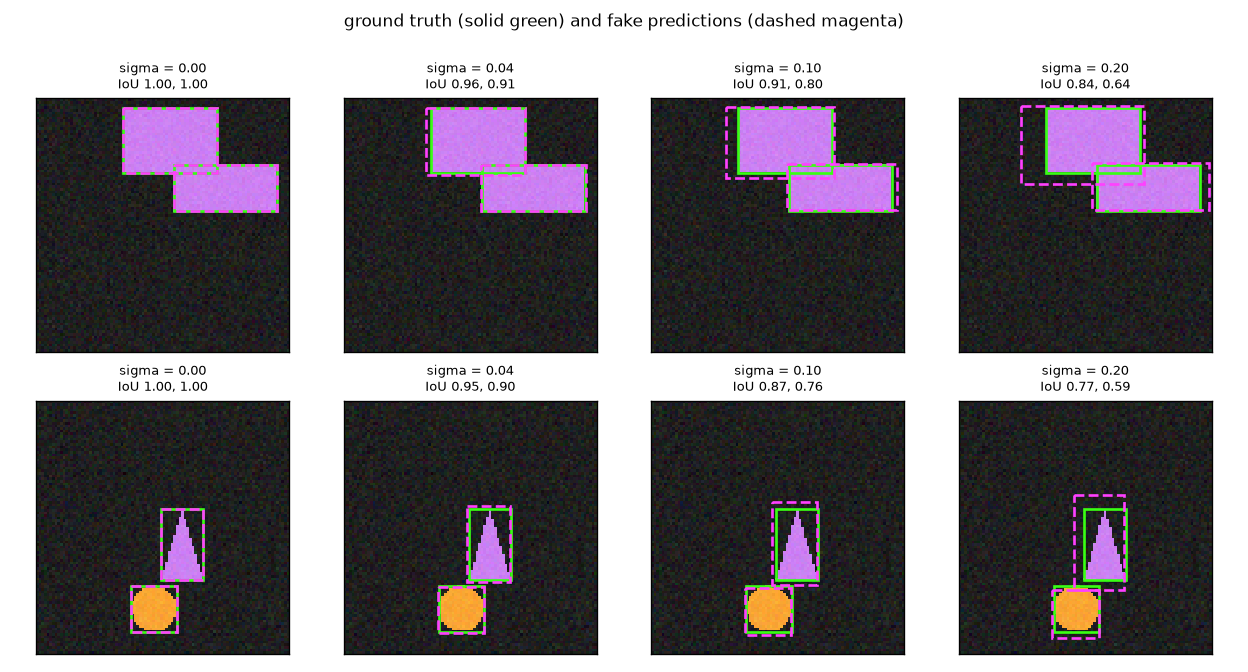
그림 3-3 에서 눈대중을 잡아 두세요. sigma = 0.04 는 거의 정답과 포개져 보이고(IoU 0.9 이상), sigma = 0.10 은 “조금 헐겁다” 싶은 정도(IoU 0.76 – 0.91)이며, sigma = 0.20 이면 눈에 띄게 어긋납니다(IoU 0.59 – 0.84). 사람 눈에는 0.10 도 “잘 찾았다” 로 보입니다. AP 는 이것을 어떻게 볼까요?
실험 1: 박스가 흔들리면
잡음을 0 에서 0.30 까지 키우며 채점합니다. 점수는 박스와 무관한 난수("random")로 두어, 달라지는 것이 박스뿐이게 했습니다.
검증 세트: 그림 500장, 객체 1265개 (circle 428, rectangle 445, triangle 392)
[3] 실험 1 · 박스 위치 잡음 (점수는 무작위)
  sigma | 평균 IoU | AP50  | AP75  | AP
   0.00 |    1.000 | 1.000 | 1.000 | 1.000
   0.02 |    0.932 | 1.000 | 1.000 | 0.885
   0.04 |    0.871 | 1.000 | 0.976 | 0.738
   0.06 |    0.814 | 1.000 | 0.676 | 0.604
   0.08 |    0.763 | 0.997 | 0.349 | 0.485
   0.10 |    0.715 | 0.971 | 0.170 | 0.377
   0.15 |    0.611 | 0.652 | 0.022 | 0.171
   0.20 |    0.523 | 0.327 | 0.003 | 0.069
   0.30 |    0.386 | 0.068 | 0.000 | 0.012
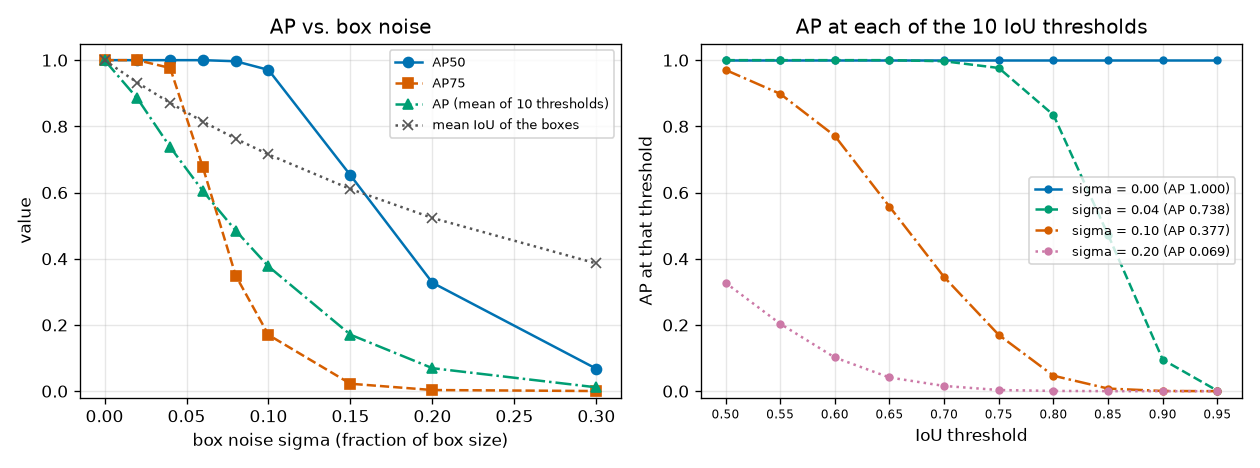
표와 그림 3-4 에서 읽을 것은 다음과 같습니다.
- 완벽한 예측은 AP = 1 입니다(sigma = 0). 코드가 기본은 하고 있다는 확인이기도 합니다.
- AP75 가 먼저 무너집니다. sigma 가 0.04 에서 0.10 으로 가는 동안 AP50 은 1.000 → 0.971 로 거의 그대로인데, AP75 는 0.976 → 0.170 으로 주저앉습니다. 평균 IoU 가 0.87 에서 0.72 로 내려오면서 예측의 대부분이 0.75 라는 문턱 아래로 떨어졌기 때문입니다. AP50 은 sigma 가 0.10 을 넘어 평균 IoU 가 0.6 근처로 내려와서야 무너집니다(sigma = 0.15 에서 0.652).
- AP 는 가장 먼저 반응합니다. sigma = 0.02 에서 AP50 과 AP75 는 아직 만점인데 AP 는 0.885 입니다. AP 에는 0.90, 0.95 같은 아주 엄격한 문턱값이 들어 있고, 평균 IoU 0.93 인 박스들도 그 문턱은 넘지 못하는 것이 많기 때문입니다. 그림 3-4 오른쪽의 초록 선(sigma = 0.04)이 이것을 보여 줍니다. 0.75 까지는 거의 1 이다가 그 뒤로 가파르게 떨어져 0.95 에서는 0 에 닿습니다.
- AP 는 평균 IoU 가 아닙니다. sigma = 0.10 에서 평균 IoU 는 0.715 인데 AP 는 0.377 입니다. AP 는 IoU 의 평균이 아니라 “문턱을 넘은 예측의 비율” 에서 나오는 값이라, 문턱 근처에서 계단처럼 변합니다. 그림 3-3 에서 “조금 헐겁다” 정도로 보였던 sigma = 0.10 이 COCO 의 채점으로는 37.7 점짜리입니다.
오른쪽 그림은 AP 라는 숫자를 읽는 좋은 방법 하나를 알려 줍니다. AP 는 이 곡선의 열 점의 평균 높이 입니다. 박스가 정확해지면 곡선 전체가 오른쪽으로 밀려나며 AP 가 오릅니다. AP50 은 곡선의 왼쪽 끝 한 점, AP75 는 가운데 한 점일 뿐입니다.
실험 2: 같은 박스, 다른 점수
이번에는 박스를 고정합니다. sigma = 0.10 으로 만든 박스 1,265개를 그대로 두고 점수만 네 가지 방식으로 매깁니다.
[4] 실험 2 · 점수의 질 (박스는 모두 같다: sigma = 0.1)
  예측 1265개 가운데 정답과 IoU ≥ 0.50 인 비율 0.984, IoU ≥ 0.75 인 비율 0.391
  iou       | AP50 0.980 | AP75 0.393 | AP 0.480
  noisy_iou | AP50 0.979 | AP75 0.301 | AP 0.443
  random    | AP50 0.971 | AP75 0.170 | AP 0.377
  inverse   | AP50 0.964 | AP75 0.153 | AP 0.369
  참고: 비율의 제곱 0.969 (IoU 0.50), 0.153 (IoU 0.75)
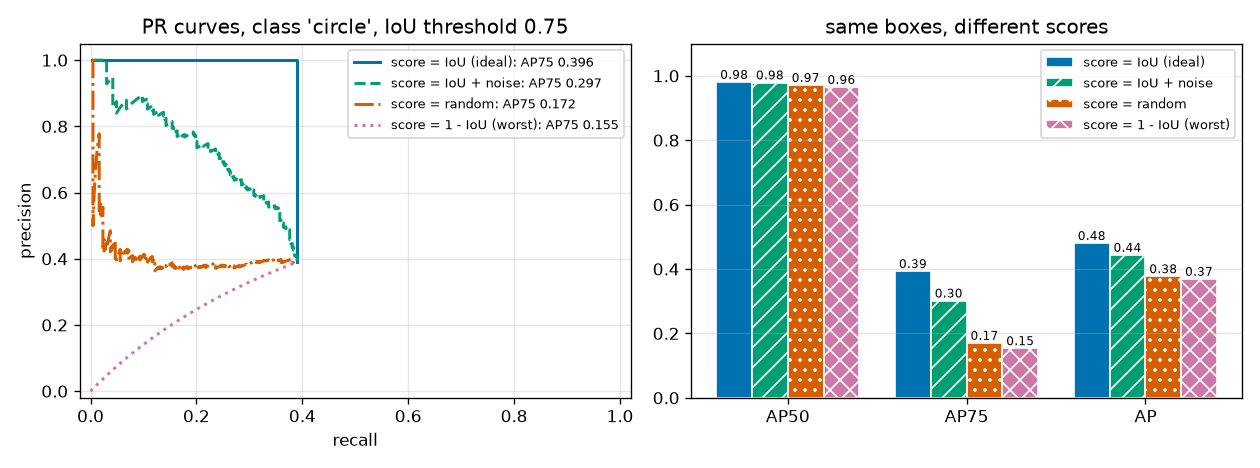
박스가 한 치도 다르지 않은데 AP 가 0.369 에서 0.480 까지 달라집니다. AP75 만 보면 0.153 과 0.393 으로 2.5배가 넘는 차이입니다. 그림 3-5 왼쪽의 PR 곡선이 까닭을 보여 줍니다.
- 점수 = IoU(파란 실선): IoU 가 0.75 이상인 예측, 곧 TP 가 모두 앞쪽에 섭니다. 정밀도는 내내 1 이다가, TP 가 다 떨어지는 재현율 0.39 에서 끝납니다.
- 점수 = 난수(주황 쇄선): TP 와 FP 가 뒤섞여 있어 어디서 끊어도 정밀도가 0.39 안팎입니다.
- 점수 = 1 − IoU(분홍 점선): FP 가 모두 앞쪽에 섭니다. 정밀도는 0 에서 시작해 끝에 가서야 0.39 에 닿습니다.
- 점수 = IoU + 잡음(초록 파선): 그 사이입니다. 대체로 좋은 박스가 앞에 서지만 가끔 순서가 뒤집힙니다.
세 경우의 AP 는 간단한 계산으로 미리 짐작할 수 있습니다. 예측의 수와 정답의 수가 같고, 그 가운데 TP 의 비율이 $q$ 라고 합시다(여기서는 IoU 문턱값 0.75 에서 $q = 0.391$).
AP50 에서는 네 방식이 거의 같습니다(0.964 – 0.980). 예측의 98.4% 가 이미 TP 여서 어떻게 줄을 세워도 섞일 FP 가 거의 없기 때문입니다. 점수의 순서는 TP 와 FP 가 섞여 있을 때 중요해집니다. 그리고 엄격한 문턱값에서는 늘 섞여 있습니다.
AP 를 높이려면 박스를 잘 치는 것만으로는 모자랍니다. 박스가 정확한 예측일수록 점수가 높아야 합니다. 탐지기의 점수는 보통 “이 박스 안에 원이 있다” 는 분류의 확신에서 나오는데, 분류에 확신이 있다고 해서 박스까지 정확하다는 보장은 없습니다. 이 어긋남을 줄이려고 분류 점수의 학습 목표에 예측 박스와 정답의 IoU 를 섞어 넣는 방법이 나왔고, LW-DETR 과 RF-DETR 이 쓰는 IoU 인지 BCE 손실(IA-BCE)이 그런 방법입니다. 9장에서 다룹니다.
실험 3: 중복 예측과 헛예측
마지막으로 예측을 덧붙여 봅니다. 기본은 sigma = 0.05, 점수 = IoU + 잡음인 꽤 괜찮은 탐지기입니다. 여기에 두 가지를 덧붙입니다.
- 중복 예측: 객체마다, 같은 방법으로 따로 흔든 박스를 1개 또는 3개 더 냅니다. 점수는 원래 예측과 같은 방식으로 매기거나(“비슷한 점수”), 거기에 0.3 을 곱합니다(“낮은 점수”).
- 헛예측: 그림마다 아무 데나 놓은 박스를 20개 또는 96개 더 냅니다. 클래스는 무작위이고, 점수는 0.01 – 0.2 의 난수(“낮은 점수”)이거나 0.5 – 1.0 의 난수(“높은 점수”)입니다.
[5] 실험 3 · 중복 예측, 헛예측, NMS (sigma = 0.05, 점수 = IoU + 잡음)
  기본 (객체마다 예측 1개)              | 그림당 예측   2.53개 | AP50 1.000 | AP75 0.911 | AP 0.700
  + 중복 1개씩, 낮은 점수(×0.3)        | 그림당 예측   5.06개 | AP50 1.000 | AP75 0.951 | AP 0.730
  + 중복 1개씩, 비슷한 점수             | 그림당 예측   5.06개 | AP50 0.846 | AP75 0.832 | AP 0.644
  + 중복 3개씩, 비슷한 점수             | 그림당 예측  10.12개 | AP50 0.763 | AP75 0.759 | AP 0.608
  + 헛예측 20개씩, 낮은 점수            | 그림당 예측  22.53개 | AP50 1.000 | AP75 0.911 | AP 0.700
  + 헛예측 96개씩, 낮은 점수            | 그림당 예측  98.53개 | AP50 1.000 | AP75 0.911 | AP 0.700
  + 헛예측 20개씩, 높은 점수            | 그림당 예측  22.53개 | AP50 0.266 | AP75 0.244 | AP 0.192
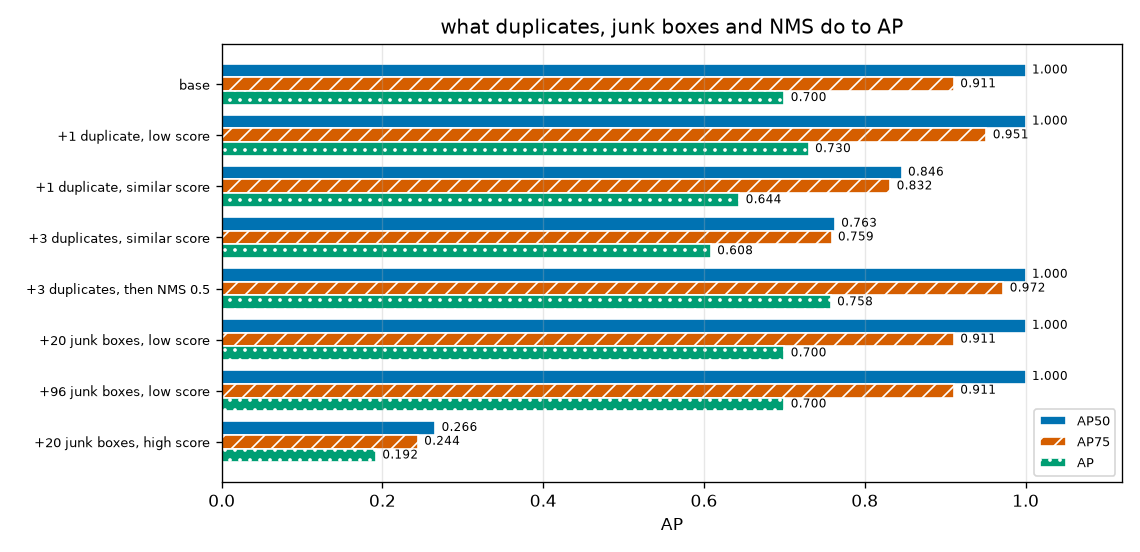
결과를 하나씩 읽습니다.
- 점수가 비슷한 중복 예측은 AP 를 크게 깎습니다. 객체마다 하나씩만 더 내도 AP50 이 1.000 에서 0.846 으로, 셋씩 더 내면 0.763 으로 떨어집니다. 박스 자체는 다 괜찮은데도 그렇습니다. 채점 규칙이 객체 하나에 TP 를 하나만 주므로 나머지는 FP 가 되고, 점수가 비슷하니 그 FP 가 순위의 앞쪽 곳곳에 끼어들어 정밀도를 깎습니다.
- 점수가 낮은 중복 예측은 해가 없고, 여기서는 오히려 도움이 되었습니다(AP 0.700 → 0.730). 점수가 낮으면 순위의 뒤쪽에 서므로 앞의 정밀도를 건드리지 못합니다. 게다가 덤이 있습니다. 원래 예측이 엄격한 문턱값을 넘지 못해 그 객체가 아직 짝이 없다면, 뒤따라온 중복 예측이 그 문턱을 넘을 때 두 번째 기회 로 TP 가 됩니다. AP75 가 0.911 에서 0.951 로 오른 것이 그 때문입니다. 다만 이것은 “낮은 점수” 가 원래 예측들보다 확실히 낮을 때의 이야기입니다.
- 점수가 낮은 헛예측은 아무리 많아도 AP 를 바꾸지 못합니다. 그림마다 20개를 넣어도, 96개를 넣어 예측을 100개 가까이로 불려도 세 지표가 소수 셋째 자리까지 그대로입니다. 앞에서 본 AP 의 셋째 성질, “맨 뒤의 FP 는 공짜” 그대로입니다. 헛예측의 점수(0.2 이하)가 진짜 예측들의 점수보다 낮아서 모두 순위의 맨 뒤에 섰기 때문입니다.
- 점수가 높은 헛예측은 치명적입니다. 같은 20개인데 점수만 0.5 – 1.0 으로 올리자 AP 가 0.700 에서 0.192 로 떨어졌습니다. 진짜 예측 2.5개 사이사이에 FP 20개가 끼어들었으니 당연합니다.
7장에서 볼 DETR 계열 탐지기는 그림에 객체가 몇 개 있든 정해진 수의 예측(RF-DETR 은 질의 300개)을 냅니다. 객체가 3개인 그림이라면 297개는 헛예측입니다. 그래도 괜찮은 까닭이 바로 위의 셋째 결과입니다. 남는 예측에 낮은 점수만 붙어 있으면 AP 는 전혀 깎이지 않습니다. 거꾸로 말하면 탐지기가 배워야 하는 것은 “객체가 없는 질의에는 낮은 점수를, 같은 객체를 가리키는 질의가 여럿이면 하나에만 높은 점수를” 주는 일입니다. 점수가 비슷한 중복 예측이 얼마나 비싼지는 위의 첫째 결과가 보여 줍니다.
AP 가 낮은 점수의 헛예측을 벌하지 않는다는 것은 AP 의 눈먼 곳이기도 합니다. 실제로 탐지기를 쓸 때는 점수 문턱값을 하나 정해 그 아래를 버려야 하고, 그때는 정밀도 · 재현율 · F1 같은 “문턱값 하나에서의” 지표를 다시 보아야 합니다. AP 가 같은 두 탐지기도 쓰기 좋은 문턱값에서의 성능은 다를 수 있습니다.
NMS: 겹친 예측 지우기
왜 필요한가
실험 3 에서 점수가 비슷한 중복 예측이 AP 를 크게 깎는 것을 보았습니다. 이것은 가짜 탐지기만의 걱정이 아닙니다. DETR 이전의 탐지기 대부분이 실제로 이런 출력을 냅니다.
1장에서 본 격자 · 앵커 기반 탐지기(YOLO 계열 등)는 그림을 촘촘한 격자로 나누고, 칸마다(칸마다 미리 정해 둔 기준 박스인 앵커가 여럿이면 앵커마다) 예측을 하나씩 냅니다. 객체 하나는 보통 여러 칸에 걸쳐 있으므로 이웃한 여러 칸이 같은 객체를 가리키는 박스를 저마다 내놓습니다. 그 칸들은 서로가 무엇을 예측했는지 모릅니다. DETR 논문(Carion 외, 2020)은 이런 탐지기들의 성능이 “거의 같은 예측들을 하나로 합치는 사후 처리 단계에 크게 좌우된다” 고 적었습니다. 그 사후 처리의 표준이 NMSnon-maximum suppression, 비최대 억제 입니다. 이름은 “최대가 아닌 것을 억누른다” 는 뜻입니다. 겹친 박스들 가운데 점수가 최대인 것만 남기고 나머지를 지웁니다.
알고리즘
클래스 하나의 예측 박스들과 점수, 그리고 문턱값(NMS 문턱값)이 주어집니다.
- 박스들을 점수가 높은 순서로 늘어놓습니다. 이것이 “후보 목록” 입니다.
- 후보 목록의 맨 위 박스를 꺼내 남길 목록 에 넣습니다.
- 후보 목록에 남은 박스 가운데, 방금 꺼낸 박스와 IoU 가 문턱값을 넘는 것을 모두 지웁니다(같은 객체를 가리키는 중복으로 봅니다).
- 후보 목록이 빌 때까지 2 – 3 을 되풀이합니다.
앞의 채점 규칙과 닮았지만 결정적으로 다른 점이 있습니다. 채점은 정답을 보고 중복을 가려냈지만, NMS 는 정답을 모릅니다(추론 때는 정답이 없습니다). 그래서 “서로 많이 겹치는 박스는 같은 객체일 것이다” 라는 짐작 으로 중복을 가려냅니다. 이 짐작이 틀릴 때가 NMS 의 약점이 됩니다.
손으로 NMS 해 보기
같은 클래스의 박스 다섯 개 A – E 가 있습니다. 좌표는 앞에서처럼 모눈 단위의 $(x_0, y_0, x_1, y_1)$ 입니다. (이 절의 C 는 박스의 이름입니다. 앞에서 클래스의 수로 쓴 $C$ 와는 상관없습니다.)
| 박스 | $(x_0, y_0, x_1, y_1)$ | 넓이 | 점수 |
|---|---|---|---|
| A | (1, 1, 5, 5) | 16 | 0.9 |
| B | (2, 1, 6, 5) | 16 | 0.8 |
| C | (1, 2, 5, 6) | 16 | 0.7 |
| D | (6, 6, 9, 9) | 9 | 0.6 |
| E | (6, 6, 9, 10) | 12 | 0.5 |
문턱값을 0.7 로 올리면 결과가 달라집니다. A 를 남길 때 B 와 C 의 IoU 0.6 은 0.7 을 넘지 않으므로 지워지지 않습니다. 다음으로 B 를 남기는데 C 와의 IoU 는 0.391 이라 C 도 살아남습니다. 그다음 C, 그다음 D 를 남기고, E(IoU 0.75)만 지워집니다. 남은 박스는 A, B, C, D 넷입니다. 문턱값이 높으면 중복이 남고, 낮으면 더 많이 지웁니다.
  NMS 예의 IoU: AB 0.600, AC 0.600, BC 0.391, DE 0.750
  NMS 문턱값 0.3: 남는 박스 ['A', 'D']
  NMS 문턱값 0.5: 남는 박스 ['A', 'D']
  NMS 문턱값 0.7: 남는 박스 ['A', 'B', 'C', 'D']
NMS 코드와 계산량
order가 후보 목록입니다(박스 번호를 점수 내림차순으로 담은 것). 맨 앞order[0]을 남기고,box_iou(boxes[best][None], boxes[order[1:]])로 그 박스 하나와 나머지 후보 전부의 IoU 를 한 번에 구합니다. 모양은(1, 남은 후보 수)입니다.[None]은 박스 하나(4,)를(1, 4)로 바꿉니다.order[1:][iou[0] <= iou_threshold]가 “IoU 가 문턱값 이하인 후보만 남긴다” 입니다. 문턱값을 넘는 것이 지워집니다.
계산량을 봅시다. 박스가 $n$ 개일 때 정렬에 $n \log n$ 에 비례하는 시간이 들고, 반복 한 번마다 남은 후보 전부와 IoU 를 계산합니다. 아무것도 지워지지 않는 가장 나쁜 경우에는 IoU 를 $(n-1) + (n-2) + \dots + 1 = n(n-1)/2$ 번 계산합니다. 곧 박스 수의 제곱 에 비례합니다. 박스가 300개면 최대 44,850번입니다. 게다가 반복 횟수가 데이터에 따라 달라지고 앞 단계의 결과가 다음 단계의 입력을 정하므로, 신경망의 나머지 부분처럼 GPU 에서 한꺼번에 병렬로 처리하기가 까다롭습니다.
실제 탐지기에서는 NMS 를 클래스별로 적용하는 것이 보통입니다. 원 위에 살짝 겹쳐 놓인 사각형은 다른 객체이므로, 클래스가 다른 박스끼리는 지우지 않습니다.
실습 파일은 nms 를, 같은 일을 다른 방식으로 짠 느린 구현(점수 순으로 보면서, 이미 남긴 박스 가운데 하나라도 IoU 가 문턱값을 넘으면 버린다)과 무작위 박스 300묶음으로 대조합니다.
앞에서 본 출력의 “nms 와 느린 구현: 300번 가운데 300번 일치” 가 그 결과입니다. 이 장을 쓰면서 따로 torchvision.ops.nms 와도 무작위 500묶음을 대조했고 500번 모두 같은 결과였습니다
(torchvision 은 이 튜토리얼의 실습 코드에서 쓰지 않으므로 파일에는 넣지 않았습니다).
중복 예측에 NMS 적용하기
실험 3 에서 가장 나빴던 “객체마다 중복 3개, 비슷한 점수”(AP 0.608)에 NMS 를 적용해 봅니다.
  중복 박스와 원래 예측의 IoU: 5% 지점 0.65, 가운데값 0.79, 95% 지점 0.90
  NMS 를 적용하면 (클래스별)
  중복 3개씩 → NMS 문턱값 0.3 | 그림당 예측   2.53개 | AP50 1.000 | AP75 0.972 | AP 0.758
  중복 3개씩 → NMS 문턱값 0.5 | 그림당 예측   2.54개 | AP50 1.000 | AP75 0.972 | AP 0.758
  중복 3개씩 → NMS 문턱값 0.7 | 그림당 예측   3.24개 | AP50 0.989 | AP75 0.978 | AP 0.756
  중복 3개씩 → NMS 문턱값 0.9 | 그림당 예측   9.24개 | AP50 0.790 | AP75 0.786 | AP 0.629
  기본 → NMS 문턱값 0.5       | 그림당 예측   2.53개 | AP50 1.000 | AP75 0.911 | AP 0.700
- NMS 가 중복을 걷어 내자 AP50 이 0.763 에서 1.000 으로 돌아왔습니다(문턱값 0.3, 0.5). 그림당 예측 수도 10.12개에서 객체 수와 같은 2.53 – 2.54개로 줄었습니다.
- AP 는 기본(0.700)보다도 높은 0.758 이 되었습니다. NMS 가 무언가를 더 잘해서가 아니라 이 가짜 탐지기의 성질 때문입니다. 객체마다 박스를 네 번 만들었고 점수는 IoU 에 잡음을 더한 값이므로, NMS 가 고른 “점수가 가장 높은 박스” 는 넷 가운데 대체로 가장 정확한 박스입니다. 네 번 쏘아 가장 잘 맞은 것을 고른 셈입니다. 점수가 박스의 질을 반영하지 않는 탐지기라면 이런 덤은 없습니다.
- 문턱값이 너무 높으면 중복이 남습니다. 0.7 에서는 그림당 3.24개가 남아 AP50 이 0.989 로 조금 깎이고, 0.9 에서는 9.24개가 남아 NMS 를 하지 않은 것과 별 차이가 없습니다(AP 0.629). 이 실험의 중복 박스는 원래 예측과의 IoU 가 대부분 0.65 – 0.90 사이(가운데값 0.79)라, 문턱값이 그보다 높으면 “겹쳤다” 고 보지 않기 때문입니다.
- 중복이 없는 기본 예측에 NMS 를 적용하면 아무 일도 일어나지 않습니다. 도형 세상의 객체들은 서로 IoU 가 0.2 를 넘지 않게 놓여 있어서, 진짜 객체의 박스끼리는 지워지지 않습니다.
여기까지만 보면 NMS 는 흠잡을 데가 없어 보입니다. 문턱값을 0.5 쯤으로 두면 됩니다. 하지만 마지막 항목의 “객체들이 서로 겹치지 않아서” 가 이 좋은 결과의 전제였습니다.
NMS 의 세 가지 약점
첫째, 진짜로 겹친 객체를 지웁니다. NMS 는 “많이 겹치면 같은 객체” 라고 짐작합니다. 그런데 나란히 선 두 사람, 줄지어 주차된 차, 쌓인 상자처럼 서로 다른 객체가 실제로 많이 겹치는 장면에서는 이 짐작이 틀립니다. 그림 3-7 의 A 와 B 가 사실은 서로 다른 두 객체였다고 해 봅시다(IoU 0.6). 탐지기가 둘 다 완벽하게 찾았더라도 문턱값 0.5 의 NMS 는 B 를 지웁니다.
이것을 실험으로 확인합니다. 도형 세상은 객체가 많이 겹치지 않게 만들어져 있으므로, 이 실험만을 위해 정답을 따로 지어냅니다. 그림 300장에, 같은 클래스 · 같은 크기의 객체 둘을 서로의 IoU 가 정확히 0.7 이 되도록 옆으로 어긋나게 놓습니다.
[6] 실험 4 · 진짜로 겹친 객체 (그림 300장, 그림마다 같은 클래스 객체 2개, 서로의 IoU 0.700)
  객체마다 예측 1개              | 그림당 예측  2.00개 | AP50 1.000 | AP75 0.902 | AP 0.701
  예측 1개 → NMS 문턱값 0.3 | 그림당 예측  1.00개 | AP50 0.505 | AP75 0.490 | AP 0.373
  예측 1개 → NMS 문턱값 0.5 | 그림당 예측  1.07개 | AP50 0.535 | AP75 0.510 | AP 0.391
  예측 1개 → NMS 문턱값 0.7 | 그림당 예측  1.72개 | AP50 0.851 | AP75 0.794 | AP 0.608
  예측 1개 → NMS 문턱값 0.9 | 그림당 예측  1.99개 | AP50 0.993 | AP75 0.902 | AP 0.698
  예측 2개(중복 1개) → NMS 없음       | 그림당 예측  4.00개 | AP50 0.905 | AP75 0.832 | AP 0.668
  예측 2개(중복 1개) → NMS 문턱값 0.3 | 그림당 예측  1.00개 | AP50 0.505 | AP75 0.490 | AP 0.388
  예측 2개(중복 1개) → NMS 문턱값 0.5 | 그림당 예측  1.10개 | AP50 0.551 | AP75 0.515 | AP 0.414
  예측 2개(중복 1개) → NMS 문턱값 0.7 | 그림당 예측  2.06개 | AP50 0.944 | AP75 0.902 | AP 0.699
  예측 2개(중복 1개) → NMS 문턱값 0.9 | 그림당 예측  3.89개 | AP50 0.911 | AP75 0.839 | AP 0.673
- 중복이 하나도 없는 좋은 탐지 결과(첫 줄, AP50 1.000)가 NMS 를 거치면 망가집니다. 문턱값 0.5 에서는 그림당 예측이 2.00개에서 1.07개로 줄고 AP50 이 0.535 가 됩니다. 두 객체 가운데 하나가 통째로 지워져 재현율이 절반이 된 것입니다. 실험 3 에서 가장 좋았던 바로 그 문턱값입니다.
- 문턱값을 0.9 로 올리면 진짜 객체는 살아남습니다(AP50 0.993). 하지만 실험 3 에서 보았듯이 그 문턱값으로는 중복을 거의 지우지 못합니다.
- 겹친 객체와 중복 예측이 함께 있으면 어느 문턱값도 둘 다 풀지 못합니다(아래 다섯 줄). 가장 나은 0.7 에서도 AP50 은 0.944 로, 중복이 없을 때의 1.000 에 못 미칩니다. 낮추면 진짜 객체가 지워지고(0.5 에서 0.551), 높이면 중복이 남습니다(0.9 에서 0.911). 진짜 이웃 객체끼리의 IoU(0.7)와 중복 박스끼리의 IoU(대부분 0.65 – 0.90)가 같은 범위에 걸쳐 있어서, IoU 하나로는 둘을 가를 수 없기 때문입니다.
이 실험은 약점이 가장 잘 드러나도록 지어낸 극단적인 장면이라는 점은 밝혀 둡니다. 실제 데이터에서 겹친 객체는 일부일 뿐입니다. 그래도 방향은 같습니다. NMS 는 빽빽한 장면에 약합니다.
둘째, 사람이 맞춰야 하는 손잡이가 생깁니다. NMS 문턱값, 그리고 NMS 에 넣기 전에 낮은 점수의 박스를 미리 버리는 점수 문턱값은 학습으로 정해지는 값이 아닙니다. 사람이 데이터에 맞게 골라야 하고, 위 실험들처럼 데이터가 바뀌면 좋은 값도 바뀝니다. RF-DETR 논문도 여러 데이터셋(RF100-VL)에서 YOLO 계열을 잰 표 4 의 설명에, 기본으로 맞춰 둔 NMS 문턱값이 RF100-VL 의 모든 데이터셋에 잘 맞지는 않을 수 있다고 적어 두었습니다.
셋째, 시간이 듭니다. 그리고 그 시간이 보고에서 빠지곤 합니다. NMS 는 신경망 바깥에서 도는 사후 처리이고, 걸리는 시간이 그림마다(박스가 얼마나 남느냐에 따라) 달라집니다. RF-DETR 논문은 지연 시간 측정의 표준화를 다루면서, YOLO 계열 모델이 지연 시간을 잴 때 NMS 를 빼는 일이 잦아 NMS 가 필요 없는 종단 간 탐지기와의 비교가 공정하지 않게 된다고 지적합니다. 탐지기의 빠르기를 견줄 때는 “그림을 넣고 최종 박스가 나오기까지” 를 모두 재야 합니다. 논문의 표 2 가 탐지기를 “NMS 를 쓰는 실시간 탐지기” 와 “종단 간 실시간 탐지기” 로 나눠 적는 것도 이 구별 때문입니다. 지연 시간은 12장과 14장에서 다시 다룹니다.
DETR 계열은 NMS 를 쓰지 않는다
중복 예측이라는 문제를 NMS 는 출력이 나온 뒤에 고칩니다. 다른 길이 있습니다. 처음부터 중복을 내지 않도록 학습시키는 것 입니다.
7장의 DETR 은 학습 때 예측과 정답을 1대1 로 짝짓습니다. 정답 하나에 예측 하나만 “네가 이 객체를 맡아라” 고 배정하고, 나머지 예측은 모두 “객체 없음” 을 배우게 합니다. 이 장의 채점 규칙(“정답 하나는 한 번만 쓰인다”)과 같은 요구를 학습의 규칙으로 옮긴 것입니다. 같은 객체를 두 예측이 함께 높은 점수로 가리키면 그 가운데 하나는 반드시 손실로 벌을 받으므로, 탐지기는 스스로 중복에 낮은 점수를 주는 법을 배웁니다. 실험 3 에서 보았듯이 점수가 낮은 중복과 헛예측은 AP 를 깎지 않으므로, 그것으로 충분합니다.
DETR 논문은 이것을 실험으로도 확인했습니다. 논문에 따르면 집합 기반 손실 덕분에 DETR 은 설계상 NMS 가 필요 없고, 디코더의 각 층 출력에 NMS 를 적용해 보니 첫 층의 예측에서만 성능이 올랐으며, 층이 깊어질수록 그 이득이 줄어 마지막 층들에서는 NMS 가 참 양성을 잘못 지워 AP 가 조금 떨어졌습니다. 실험 4 에서 본 바로 그 현상입니다. 어떻게 1대1 로 짝짓는지(헝가리안 매칭), 예측들이 어떻게 서로를 보고 중복을 피하는지(자기 어텐션)는 5장과 7장에서 다룹니다.
NMS 는 RF-DETR 의 추론 과정에 들어 있지 않습니다. 그래도 이 장에서 구현해 둔 까닭은 둘입니다. “NMS 가 필요 없다” 는 말이 무엇을 덜어 낸 것인지 알려면 NMS 가 무엇인지 알아야 하고,
7장에서 우리가 학습한 DETR 의 출력에 이 nms 를 적용해 보아 정말로 필요 없는지를 직접 확인하기 때문입니다.
숫자 읽는 법: 논문 표의 한 줄
이제 처음의 문장으로 돌아갑니다. RF-DETR 논문의 표 2(COCO 탐지 평가)에서 가장 작은 모델들의 줄을 옮기면 다음과 같습니다. 값은 모두 논문이 보고한 것입니다.
| 모델 (논문 표 2) | NMS | AP | AP50 | AP75 | APS | APM | APL |
|---|---|---|---|---|---|---|---|
| YOLOv11 (N) | 필요 | 37.1 | 51.6 | 40.4 | 17.3 | 40.7 | 55.6 |
| D-FINE (N) | 불필요 | 42.7 | 60.2 | 45.4 | 22.9 | 46.6 | 62.1 |
| RF-DETR (N) | 불필요 | 48.0 | 67.0 | 51.4 | 25.2 | 53.5 | 70.0 |
RF-DETR (N) 의 줄을 이 장의 말로 풀어 읽습니다.
- AP 48.0: 0.480 입니다. COCO 의 80개 클래스 각각에 대해, IoU 문턱값 0.50, 0.55, …, 0.95 각각으로 예측을 채점해 PR 곡선을 만들고(모두 800개), 곡선마다 재현율 101개 지점의 보간 정밀도를 평균해 AP 를 얻은 뒤, 그 800개를 평균한 값입니다. 그림마다 점수 상위 100개의 예측만 썼습니다.
- AP50 67.0: “IoU 0.5 이상이면 맞은 것으로 치는” 너그러운 기준으로는 0.670 입니다.
- AP75 51.4: “IoU 0.75 이상” 이라는 엄격한 기준으로는 0.514 입니다. AP50 과의 차이 15.6 은 “찾기는 했지만 박스가 IoU 0.5 – 0.75 사이로 헐거운” 예측이 그만큼의 몫을 차지한다는 뜻입니다. AP 48.0 은 열 문턱값의 평균이므로 AP50 보다 낮고, 0.75 보다 엄격한 문턱값이 넷(0.80 – 0.95)이나 들어 있으므로 AP75 보다도 낮습니다. 실험 1 의 그림 3-4 오른쪽에서 본 내려가는 곡선의 평균 높이입니다.
- APS 25.2 · APM 53.5 · APL 70.0: 넓이 32² 픽셀 미만의 작은 객체에서는 0.252, 중간 크기에서는 0.535, 96² 픽셀보다 큰 객체에서는 0.700 입니다. 작은 객체의 점수가 큰 객체의 절반에도 못 미칩니다. 표의 세 모델 모두 같은 순서(S < M < L)입니다. 작은 객체는 픽셀 몇 개의 어긋남에도 IoU 가 크게 떨어지고(2장), 그림에서 얻을 수 있는 정보도 적습니다.
- 전체 AP 는 세 크기별 AP 의 평균이 아닙니다($(25.2 + 53.5 + 70.0)/3 = 49.6 \ne 48.0$). 크기별 AP 는 정답을 크기로 나눠 따로 채점한 값이고, 전체 AP 는 나누지 않고 채점한 값입니다.
줄끼리 견주면 논문의 주장이 읽힙니다. RF-DETR (N) 은 D-FINE (N) 보다 AP 가 5.3 높고(48.0 − 42.7), 여섯 지표 모두에서 앞섭니다. 논문 초록의 “D-FINE (nano) 보다 5.3 AP 높다” 가 이 두 줄의 차이입니다. 다만 AP 만으로 탐지기의 우열을 말할 수는 없습니다. 표 2 에는 매개변수 수와 지연 시간 칸도 있고(RF-DETR N 은 3,050만 개 · 2.3 ms, D-FINE N 은 380만 개 · 2.1 ms), 논문의 주장은 “비슷한 지연 시간에서” 의 비교입니다. 정확도와 빠르기를 함께 보는 법은 1장과 12장에서 다룹니다.
이 튜토리얼의 실험에서 나오는 AP 는 도형 세상(클래스 3개, 깨끗한 배경, 그림마다 객체 1 – 4개)에서 잰 값입니다. 뒤의 장에서 우리 탐지기가 AP 0.9 를 넘기더라도 그것은 문제가 쉬워서이지, COCO 에서 48.0 을 받는 탐지기보다 낫다는 뜻이 아닙니다. AP 는 같은 데이터셋, 같은 채점 방식 안에서만 견줄 수 있습니다.
- 탐지에서는 배경이 무한해 참 음성을 셀 수 없으므로 정확도를 쓸 수 없습니다. TP · FP · FN 만으로 채점합니다.
- 예측은 점수가 높은 순서로, 아직 짝이 없는 같은 클래스의 정답 가운데 IoU 가 가장 큰 것과 짝짓습니다. IoU 가 문턱값 $\tau$ 이상이면 TP, 아니면 FP 이고, 짝 없는 정답은 FN 입니다. 정답 하나는 한 번만 쓰이므로 중복 예측은 FP 가 됩니다.
- 정밀도 $P = \mathrm{TP}/(\mathrm{TP} + \mathrm{FP})$ 는 헛짚지 않는 능력, 재현율 $R = \mathrm{TP}/(\mathrm{TP} + \mathrm{FN})$ 은 빠뜨리지 않는 능력입니다. 점수 문턱값을 움직이면 둘이 맞바뀝니다.
- 예측을 점수 순으로 하나씩 인정하며 그린 것이 PR 곡선이고, 톱니를 오른쪽부터의 누적 최댓값으로 메운 뒤 재현율 101개 지점에서 평균한 것이 AP 입니다.
- COCO 의 AP 는 클래스 평균이자 IoU 문턱값 0.50 – 0.95 의 열 개 평균입니다. AP50 · AP75 는 문턱값 하나만, APS · APM · APL 은 객체 크기별로 본 값입니다.
- AP 는 점수의 순서만 봅니다. 박스가 같아도 순서가 나쁘면 AP 가 떨어지고(실험 2), 낮은 점수의 헛예측은 아무리 많아도 AP 를 깎지 않으며, 점수가 비슷한 중복 예측은 크게 깎습니다(실험 3).
- NMS 는 겹친 박스 가운데 점수가 가장 높은 것만 남겨 중복을 지웁니다. 진짜로 겹친 객체를 지우고, 문턱값을 사람이 골라야 하며, 추가 시간이 듭니다. DETR 계열은 학습 때의 1대1 짝짓기로 중복을 처음부터 내지 않게 해 NMS 를 쓰지 않습니다.
확인 문제
그림 한 장에 삼각형 정답이 2개(G1, G2) 있고, 삼각형 예측이 3개 있습니다. 점수와 IoU 는 다음과 같습니다. P1(0.9): G1 과 0.55, G2 와 0.10. P2(0.7): G1 과 0.85, G2 와 0. P3(0.4): G1 과 0, G2 와 0.45. IoU 문턱값 0.5 로 채점해 TP · FP · FN 의 수와 정밀도 · 재현율을 구하세요.
답 보기
점수 순으로 봅니다. P1 은 G1(0.55 ≥ 0.5)과 짝이 되어 TP. P2 는 G1 과 IoU 가 0.85 로 더 높지만 G1 은 이미 쓰였고, 남은 G2 와는 0 이므로 FP(중복 예측). P3 는 G2 와 0.45 로 문턱값에 못 미쳐 FP. G2 는 짝이 없어 FN. TP 1, FP 2, FN 1. 정밀도 $1/3 = 0.333$, 재현율 $1/2 = 0.5$. 더 정확한 박스(P2)가 점수가 낮아서 FP 가 된 예입니다. IoU 문턱값을 0.6 으로 올리면 P1 이 탈락하고 그제야 P2 가 G1 과 짝이 됩니다.
어떤 클래스의 정답이 2개이고, 예측 4개가 점수 순으로 FP · TP · TP · FP 입니다. ① 정밀도와 재현율을 순위마다 구하고 ② 보간 정밀도를 구한 뒤 ③ 101점 방식으로 AP 를 계산하세요. ④ 같은 예측의 순서가 TP · TP · FP · FP 였다면, 그리고 TP · FP · FP · TP 였다면 AP 는 얼마입니까?
답 보기
① 누적 TP 는 0, 1, 2, 2 이므로 정밀도 $[0,\; 0.5,\; 0.667,\; 0.5]$, 재현율 $[0,\; 0.5,\; 1,\; 1]$. ② 오른쪽부터의 누적 최댓값: $[0.667,\; 0.667,\; 0.667,\; 0.5]$. ③ 지점 $r = 0$ 은 첫 자리(재현율 0)에서, $0 \lt r \le 0.5$ 는 둘째 자리에서, $0.5 \lt r \le 1$ 은 셋째 자리에서 값을 읽는데 세 자리의 보간 정밀도가 모두 0.667 입니다. 101개 지점이 모두 $2/3$ 이므로 AP = 0.6667.
④ TP · TP · FP · FP: 정밀도 $[1, 1, 0.667, 0.5]$, 재현율 $[0.5, 1, 1, 1]$. 모든 지점이 첫째 또는 둘째 자리에서 값 1 을 읽으므로 AP = 1. TP · FP · FP · TP: 정밀도 $[1, 0.5, 0.333, 0.5]$, 재현율 $[0.5, 0.5, 0.5, 1]$, 보간 $[1, 0.5, 0.5, 0.5]$. $r \le 0.5$ 인 51개 지점(0.00 – 0.50)은 1, 나머지 50개 지점은 넷째 자리의 0.5 이므로 AP $= (51 + 25)/101 = 0.7525$. 박스가 똑같아도 순서에 따라 AP 가 0.6667, 0.7525, 1 로 달라집니다. 실습 코드의 출력 “순서 FP · TP · TP · FP: AP 0.6667”, “순서 TP · TP · FP · FP: AP 1.0000”, “순서 TP · FP · FP · TP: AP 0.7525” 와 같습니다.
어떤 탐지기의 모든 예측 점수를 ① 절반으로 줄이면 ② $1 - \text{점수}$ 로 바꾸면 AP 는 각각 어떻게 됩니까? 점수 문턱값 0.5 에서의 정밀도 · 재현율은 어떻게 됩니까?
답 보기
① 순서가 그대로이므로 AP 는 변하지 않습니다. 하지만 점수 문턱값 0.5 를 넘는 예측이 하나도 없게 되므로(점수가 모두 0.5 이하) 그 문턱값에서의 재현율은 0 이 됩니다. AP 는 문턱값을 정하지 않는 지표이고, 정밀도 · 재현율은 문턱값에 매인 지표라는 차이입니다. ② 순서가 뒤집히므로 AP 가 달라집니다. 원래 점수가 박스의 질을 잘 반영했다면 크게 떨어집니다(실험 2 의 inverse).
탐지기 가는 AP50 70, AP75 35 이고, 탐지기 나는 AP50 62, AP75 55 입니다. 두 탐지기의 성격을 말해 보세요. 로봇 팔이 물건을 집을 위치를 정하는 데에는 어느 쪽이 낫겠습니까? “화면에 사람이 있는지” 만 알리는 경보 장치에는 어느 쪽이 낫겠습니까?
답 보기
가는 객체를 더 많이 찾지만 박스가 헐겁습니다(문턱값을 0.75 로 올리자 점수가 절반이 됨). 나는 찾는 수는 조금 적지만 찾은 것의 박스가 정확합니다(차이가 7 뿐). 박스의 정확한 위치가 중요한 로봇 팔에는 나가, 있고 없음만 중요한 경보 장치에는 가가 낫습니다. COCO 의 AP(문턱값 10개 평균)로는 나가 더 높을 가능성이 큽니다. 하나의 숫자로 줄이면 이런 성격의 차이가 가려지므로 표의 여러 칸을 함께 읽어야 합니다.
같은 클래스의 박스 넷이 있습니다. 점수는 차례로 0.9, 0.8, 0.7, 0.6 이고, IoU 는 (1, 2) 0.65, (1, 3) 0.10, (2, 3) 0.55, (3, 4) 0.72 이며 나머지 쌍은 0 입니다. NMS 문턱값이 0.5 일 때와 0.7 일 때 남는 박스를 구하세요.
답 보기
문턱값 0.5: 1번을 남기고 2번(0.65)을 지웁니다. 후보는 3, 4. 3번을 남기고 4번(0.72)을 지웁니다. 남는 것은 1, 3. 3번은 2번과 0.55 로 겹쳤지만, 2번이 이미 지워졌으므로 살아남습니다. NMS 는 남기기로 한 박스와의 IoU 만 봅니다.
문턱값 0.7: 1번을 남깁니다. 2번(0.65)은 0.7 을 넘지 않아 살아남습니다. 2번을 남깁니다. 3번(2번과 0.55)도 살아남습니다. 3번을 남기고 4번(0.72)을 지웁니다. 남는 것은 1, 2, 3.
탐지기 가는 그림마다 예측을 5개 안팎만 내고, 탐지기 나는 같은 5개에 더해 점수 0.05 이하의 박스 95개를 함께 냅니다. 가의 예측은 모두 점수가 0.3 이상입니다. 두 탐지기의 COCO AP 는 어떻게 다릅니까? 점수 문턱값 0.01 로 예측을 걸러 화면에 그린다면 무엇이 다릅니까? 나의 덧붙인 박스가 100개가 아니라 150개였다면 채점에서 어떤 일이 생깁니까?
답 보기
AP 는 거의 같습니다. 덧붙인 박스는 모두 순위의 맨 뒤에 서므로 그 앞의 정밀도와 재현율을 바꾸지 못합니다(실험 3 의 “헛예측 96개씩, 낮은 점수”). 덧붙인 박스 가운데 우연히 정답과 맞는 것이 있으면 재현율이 조금 늘어 AP 가 아주 조금 오를 수는 있습니다. 하지만 화면에는 나쪽이 박스 100개로 뒤덮입니다. AP 가 같아도 쓰는 사람이 정한 문턱값에서의 정밀도는 크게 다릅니다. 150개를 덧붙였다면 그림당 예측이 155개가 되어 COCO 의 “그림마다 최대 100개” 규칙에 걸립니다. 점수 상위 100개만 남으므로 원래의 5개는 그대로 살고 덧붙인 것 가운데 점수가 낮은 55개가 잘립니다. 결과는 여전히 같습니다.
“이 탐지기는 COCO 에서 AP 52.9, AP50 71.9, AP75 57.0 이다”(논문 표 2 의 RF-DETR S)를, 이 장을 읽지 않은 사람에게 설명한다고 생각하고 세 문장으로 풀어 쓰세요.
답 보기
보기: “예측 박스가 정답 박스와 절반 넘게(IoU 0.5 이상) 겹치면 맞은 것으로 치는 너그러운 기준에서, 이 탐지기는 헛짚지 않으면서 빠뜨리지 않는 능력을 0 – 100 으로 요약한 점수가 71.9 이다. 4분의 3 넘게(IoU 0.75 이상) 겹쳐야 맞은 것으로 치는 엄격한 기준에서는 57.0 이다. 기준을 0.5 부터 0.95 까지 열 단계로 바꿔 가며 잰 점수를 평균하면 52.9 이고, 이것이 탐지기끼리 견줄 때 쓰는 대표 점수이다. 모든 점수는 80가지 물체 종류에 대해 따로 잰 뒤 평균한 것이다.”
이 장에서 탐지기의 출력을 채점하는 법을 갖추었습니다. 2장의 박스 · IoU 와 합치면 “무엇을 맞혀야 하고, 얼마나 잘 맞혔는지를 어떻게 재는가” 가 정리된 셈입니다. 아직 다루지 않은 것은 그 출력을 내는 기계, 곧 신경망입니다. 4장에서는 신경망이 무엇이고 어떻게 학습하는지, 그리고 “이 박스 안에 원이 있다” 는 점수를 학습시키는 분류 손실(BCE 와 포컬 손실)이 어떻게 생겼는지를 손계산과 코드로 익힙니다. 이 장의 실험 2 에서 본 “좋은 점수” 를 탐지기에게 가르치는 일이 거기서 시작됩니다.