DETR: 탐지를 집합 예측으로
여기서부터 2단계, DETR 계보입니다. 지금까지 박스(2장), 채점(3장), 분류 손실(4장), 어텐션(5장), 백본(6장)이라는 부품을 따로 익혔습니다. 이 장에서는 그 부품을 모두 모아 첫 탐지기 를 만듭니다. DETR 의 발상은 한 줄입니다. “탐지기의 답은 집합이니, 집합을 직접 내놓게 학습시키자.” 그 발상을 실제로 굴러가게 하는 것이 헝가리안 매칭 과 집합 손실 입니다. 이 둘을 수식과 손계산으로 끝까지 따라간 다음, 도형 세상에서 미니 DETR 을 처음부터 학습하고 “NMS 가 정말 필요 없는지” 를 직접 확인합니다. RF-DETR 도 뼈대는 이 장의 것 그대로입니다.
- 앵커와 NMS 없이 탐지하려면 무엇을 바꿔야 하는지: 탐지를 집합 예측으로 보는 관점
- 고정된 $N$ 개의 예측 슬롯과 “객체 없음(∅)”, 순서 없는 집합끼리 비교하는 문제
- 이분 매칭: 비용 행렬에서 총비용이 최소인 일대일 배정을 손으로 찾고, 헝가리안 알고리즘이 왜 필요한지 숫자로 보기
- DETR 의 매칭 비용 세 항과, 분류 항에 로그 확률이 아니라 확률을 쓰는 이유
- 집합 손실(헝가리안 손실): 매칭된 질의와 안 된 질의가 각각 무엇을 배우는지, 한 그림의 손실 손계산
- 일대일 매칭이 중복 예측을 없애는 원리와, 질의끼리의 자기 어텐션이 맡는 일
- DETR 의 구조(CNN 백본 → 인코더 → 디코더 → 머리)와 텐서 모양, 객체 질의, 병렬 디코딩, 보조 손실
- 미니 DETR 을 학습해 학습 곡선 · 질의의 전문화 · 교차 어텐션 · 층별 AP · NMS 실험을 읽고, DETR 의 한계를 정리하기
- $N$: 객체 질의(예측 슬롯)의 수. 5장에서는 토큰의 수였지만 이 장에서는 늘 질의의 수입니다. DETR 논문은 100, 이 장의 미니 모델은 12 입니다.
- $T$: 그림 한 장의 정답 객체 수. 늘 $T \le N$ 입니다. (2장은 정답의 수를 $M$ 이라고 적었지만, 5장부터 $M$ 은 인코더가 만든 그림 토큰 묶음을 뜻하므로 여기서는 코드와 같이 $T$ 를 씁니다.)
- $K$: 클래스의 수(도형 세상은 3). “객체 없음” 클래스는 $\varnothing$ 로 적고, 로짓의 마지막 칸(번호 $K$)을 차지합니다. 그래서 분류 출력은 $K + 1$ 칸입니다.
- $i$: 예측(질의)의 번호, $j$: 정답의 번호. 코드와 맞추어 0 부터 셉니다. “예측 1” 은 두 번째 예측입니다.
- $\hat{p}_i(c)$: 예측 $i$ 가 클래스 $c$ 에 준 확률(“피 햇”). $\hat{b}_i$: 예측 $i$ 의 박스. 모자(^)가 붙은 것은 모델의 예측, 없는 것($c_j$, $b_j$)은 정답입니다. 박스는 모두 정규화한 $(c_x, c_y, w, h)$ 입니다.
- $C$: 비용 행렬, 모양 $(N, T)$. $C_{ij}$ 는 예측 $i$ 를 정답 $j$ 에 배정하는 비용입니다. 2장에서 $C$ 는 둘러싸는 박스였지만 이 장에서는 비용 행렬에만 씁니다.
- $\sigma$(“시그마”): 배정. $\sigma(j)$ 는 정답 $j$ 의 짝이 된 예측의 번호입니다. 4장의 시그모이드 $\sigma(\cdot)$ 와 글자가 같아서, 이 장에서 시그모이드는 식으로 쓰지 않고 말로만 적습니다.
- $B$: 배치 크기, $D$: 모델 차원, $H \times W$: 특징 맵의 높이 · 너비, $L$: 디코더 층의 수.
손으로 만든 부품을 없앨 수 있을까
앵커와 NMS 를 다시 보면
1장에서 DETR 이전의 탐지기를 훑어보았습니다. 그 탐지기들은 그림 위에 수천 – 수만 개의 후보 자리(앵커, 격자 칸, 후보 영역)를 깔아 놓고, 자리마다 “여기 객체가 있나, 있다면 박스를 얼마나 고쳐야 하나” 를 묻습니다. 이 방식에는 사람이 정한 규칙이 두 군데 끼어 있습니다.
- 학습할 때: 어느 자리가 어느 정답을 맡는가. “정답 박스와 IoU 가 문턱값을 넘는 앵커는 모두 그 정답을 맡는다” 같은 규칙으로 정합니다. 정답 하나를 여러 자리가 함께 맡으므로, 잘 학습된 탐지기는 객체 하나에 비슷한 박스를 여러 개 내놓습니다. 3장에서 본 중복 예측입니다.
- 추론할 때: 중복을 어떻게 지우는가. 3장의 NMS(비최대 억제)가 점수 순으로 예측을 훑으며 많이 겹치는 것을 지웁니다. IoU 문턱값이라는 손잡이가 하나 더 생기고, 3장에서 보았듯이 서로 가까이 붙은 진짜 객체를 지워 버릴 수도 있습니다.
앵커의 크기 · 비율, 정답을 맡기는 규칙, NMS 의 문턱값은 모두 데이터에서 배운 것이 아니라 사람이 손으로 정한 것입니다. DETR 논문은 이것들을 “과제에 대한 사전 지식을 명시적으로 넣은, 손으로 설계한 부품” 이라고 부르고, 탐지기의 성능이 이 부품들의 설계에 크게 좌우된다고 지적합니다.
물음을 바꾸기
중복은 왜 생길까요? “정답 하나를 여러 자리가 맡는다” 는 학습 규칙 때문입니다. 그렇다면 물음을 이렇게 바꿀 수 있습니다.
객체마다 예측을 딱 하나만 내도록 학습시킬 수는 없을까? 그렇게 되면 지울 중복이 없으니 NMS 가 필요 없고, 후보 자리를 촘촘히 깔 필요도 없으니 앵커도 필요 없다.
2020년의 DETRDEtection TRansformer(Carion 외, “End-to-End Object Detection with Transformers”, ECCV 2020)이 이 물음에 답한 모델입니다. 답의 재료는 둘입니다. 하나는 예측과 정답을 일대일로 짝짓는 손실이고, 다른 하나는 예측들이 서로를 볼 수 있는 Transformer 구조입니다. 그림을 넣으면 손으로 만든 후처리 없이 최종 답이 바로 나오고, 그 답에서 계산한 손실이 처음부터 끝까지 한 번에 역전파됩니다. 이런 방식을 종단 간end-to-end 탐지라고 부릅니다.
집합 예측
고정된 수의 슬롯과 객체 없음
1장에서 말했듯이 탐지기의 답은 (클래스, 박스) 의 집합 입니다. 그림마다 원소의 수가 다르고, 원소 사이에 순서가 없습니다. 신경망은 크기가 정해진 텐서를 내놓으므로 “개수가 그때그때 다른 집합” 을 그대로 출력할 수는 없습니다. DETR 은 이 문제를 아주 단순하게 풉니다.
- 예측 자리를 고정된 수 $N$ 개 둡니다. 이 자리를 예측 슬롯prediction slot 이라고 부릅니다. 슬롯 하나가 (클래스 확률, 박스) 한 벌을 냅니다.
- $N$ 은 그림 한 장에 나올 수 있는 객체 수보다 넉넉히 크게 잡습니다. DETR 논문은 COCO(그림당 평균 7개, 학습 세트에서 최대 63개)에 $N = 100$ 을 썼고, 도형 세상(그림당 1 – 4개)의 미니 모델은 $N = 12$ 를 씁니다.
- 객체보다 슬롯이 많으니 슬롯이 남습니다. 남는 슬롯은 “객체 없음” 이라고 답하게 합니다. 이것이 4장에서 본 배경 클래스 $\varnothing$ 입니다. 클래스가 $K$ 개면 분류 출력은 $K + 1$ 칸입니다.
이렇게 하면 출력의 모양이 그림과 무관하게 고정됩니다. 분류 로짓이 (B, N, K+1), 박스가 (B, N, 4) 입니다. 객체가 2개인 그림이면 12개 슬롯 가운데 2개가 객체를, 10개가 ∅ 를 답하면 됩니다.
이렇게 “정해진 수의 원소로 이루어진 집합을 한 번에 내놓는” 문제를 집합 예측set prediction 이라고 합니다.
슬롯을 만들어 내는 것이 5장에서 예고한 객체 질의object query 입니다. 객체 질의는 “물체 하나를 찾아오라” 는 임무를 맡은 학습되는 벡터 로, 디코더에 $N$ 개가 들어가 $N$ 개의 출력 벡터가 되고, 출력 벡터 하나가 슬롯 하나의 예측이 됩니다. 구조는 뒤의 DETR 의 구조 절에서 자세히 봅니다. 지금은 “질의 $i$ = 슬롯 $i$ = 예측 $i$” 로 읽으면 됩니다.
순서 없는 집합끼리의 비교
이제 학습입니다. 모델이 예측 $N$ 개를 냈고, 정답은 $T$ 개입니다. 손실을 계산하려면 “어떤 예측을 어떤 정답과 견줄지” 가 정해져야 합니다. 분류기라면 고민할 것이 없습니다. 출력이 하나, 정답이 하나이니까요. 그런데 탐지에서는 이것이 정해져 있지 않습니다.
- 정답에 순서가 없습니다. 정답 파일에 원이 먼저 적혀 있든 삼각형이 먼저 적혀 있든 같은 정답입니다.
- 슬롯에도 정해진 임무가 없습니다. “슬롯 0 은 가장 왼쪽 객체” 같은 약속을 사람이 정해 주지 않습니다(정해 주면 그것이 또 하나의 손으로 만든 규칙입니다).
“예측 $i$ 는 정답 $i$ 와 견준다” 고 번호대로 짝지으면 어떻게 될까요? 예측이 정답과 내용은 완전히 같은데 나온 순서만 다른 경우에 큰 손실이 나옵니다. 모델은 풀 필요가 없는 문제(정답 파일의 줄 순서 맞히기)를 풀어야 합니다. 그래서 집합 예측의 손실은 예측을 어떤 순서로 늘어놓아도 값이 같아야 합니다. 이 성질을 순열 불변permutation invariance 이라고 합니다(5장의 순열 등변 은 “입력을 섞으면 출력도 같이 섞인다” 였고, 순열 불변 은 “섞어도 값이 그대로다” 입니다).
DETR 의 해법은 이렇습니다. 손실을 계산하기 전에, 지금의 예측을 보고 가장 잘 맞는 짝을 먼저 찾는다. 예측 가운데 정답 $j$ 와 가장 잘 맞는 것을 그 정답의 짝으로 삼되, 한 예측이 두 정답의 짝이 되지 않게 합니다. 짝이 정해지면 그다음은 평범한 손실 계산입니다. 이 “짝 찾기” 가 다음 절의 이분 매칭입니다.
이분 매칭
비용 행렬과 배정
짝 찾기를 문제로 적어 봅시다. 재료는 표 하나입니다. 예측 $i$ 와 정답 $j$ 의 모든 쌍에 대해 “이 둘을 짝지으면 얼마나 안 맞는가” 를 숫자로 적어 둔 표를 비용 행렬cost matrix 이라고 하고 $C$ 로 적습니다. 모양은 $(N, T)$ 이고, $C_{ij}$ 가 작을수록 예측 $i$ 와 정답 $j$ 가 잘 맞습니다.
정답마다 예측을 하나씩 골라 주는 것을 배정assignment 이라고 하고 $\sigma$ 로 적습니다. $\sigma(j)$ 는 정답 $j$ 의 짝이 된 예측의 번호입니다. 조건은 하나입니다.
$$ j \ne j' \;\Rightarrow\; \sigma(j) \ne \sigma(j') \qquad \text{(서로 다른 정답은 서로 다른 예측과 짝이 된다)} $$즉 정답 하나에 예측 하나, 예측 하나에는 정답이 많아야 하나입니다. 이것이 일대일 매칭one-to-one matching 입니다. 배정의 총비용은 짝지어진 칸의 비용을 모두 더한 것이고, 우리가 찾는 것은 총비용이 가장 작은 배정 $\hat{\sigma}$(“시그마 햇”)입니다.
$$ \hat{\sigma} = \argmin_{\sigma} \sum_{j=0}^{T-1} C_{\sigma(j),\, j} $$$\argmin_{\sigma}$ 는 “뒤의 값을 가장 작게 만드는 $\sigma$” 라는 뜻입니다. 한쪽에 예측, 다른 쪽에 정답을 늘어놓고 양쪽을 잇는 선을 고르는 문제이므로 이분 매칭bipartite matching 이라고 부릅니다(“이분” 은 점들이 두 무리로 나뉘고 선은 무리 사이에만 있다는 뜻입니다). 수학에서는 배정 문제(assignment problem)라는 이름으로 오래 연구되었습니다.
DETR 논문의 식 (1) 은 $\hat{\sigma} = \argmin_{\sigma \in \mathfrak{S}_N} \sum_{i}^{N} \mathcal{L}_{\text{match}}(y_i, \hat{y}_{\sigma(i)})$ 입니다. 논문은 정답 집합에 $\varnothing$ 를 채워 넣어 크기를 $N$ 으로 맞춘 다음, $N$ 개 원소의 순열($\mathfrak{S}_N$ 은 그 순열 전체의 집합) 가운데 최소를 찾는다고 적습니다. 논문의 $i$ 는 정답의 번호이고 $\sigma(i)$ 가 그 짝인 예측의 번호입니다. 이 장은 비용 행렬의 행 · 열과 맞추려고 정답 번호를 $j$ 로 적었을 뿐, 같은 식입니다. $\varnothing$ 로 채운 정답과의 비용은 논문의 말대로 예측과 무관한 상수이므로, 진짜 정답 $T$ 개의 짝만 정하면 됩니다. 이 점은 조금 뒤에 다시 씁니다.
손으로 풀기: 스물네 가지를 모두 해 본다
작은 예로 직접 풀어 봅시다. 예측이 4개($N = 4$), 정답이 3개($T = 3$: 원, 원, 삼각형)인 그림입니다. 비용 행렬은 다음과 같다고 합시다.
(이 숫자가 어디서 나왔는지는 다음 절 DETR 의 매칭 비용 에서 계산합니다. 실습 코드의 toy_example 이 쓰는 것과 같은 예입니다.)
| $C_{ij}$ | 정답 0 (원) | 정답 1 (원) | 정답 2 (삼각형) |
|---|---|---|---|
| 예측 0 | −1.3618 | −0.2609 | 5.5975 |
| 예측 1 | −0.2370 | 2.2602 | 6.8998 |
| 예측 2 | 5.8077 | 4.2476 | −1.4608 |
| 예측 3 | 4.3247 | 1.8215 | 3.7627 |
비용이 음수인 칸이 있어도 이상할 것이 없습니다. 비용은 “작을수록 잘 맞는다” 는 순서만 뜻하므로 0 보다 작아도 됩니다. 배정을 (정답 0 의 짝, 정답 1 의 짝, 정답 2 의 짝) 으로 적겠습니다. 예를 들어 $(1, 0, 2)$ 는 정답 0 ↔ 예측 1, 정답 1 ↔ 예측 0, 정답 2 ↔ 예측 2 입니다. 정답 0 의 짝을 고르는 방법이 4가지, 정답 1 의 짝은 남은 3가지, 정답 2 의 짝은 남은 2가지이므로 배정은 모두 $4 \times 3 \times 2 = 24$ 가지입니다. 전부 계산해서 총비용 순으로 늘어놓으면 다음과 같습니다.
| 순위 | 배정 | 총비용 | 순위 | 배정 | 총비용 | 순위 | 배정 | 총비용 |
|---|---|---|---|---|---|---|---|---|
| 1 | (1, 0, 2) | −1.9587 | 9 | (0, 2, 3) | 6.6485 | 17 | (2, 1, 3) | 11.8307 |
| 2 | (0, 3, 2) | −1.0011 | 10 | (1, 3, 0) | 7.1820 | 18 | (3, 1, 0) | 12.1825 |
| 3 | (0, 1, 2) | −0.5624 | 11 | (0, 3, 1) | 7.3595 | 19 | (2, 0, 1) | 12.4466 |
| 4 | (1, 3, 2) | 0.1237 | 12 | (1, 2, 3) | 7.7734 | 20 | (2, 3, 0) | 13.2268 |
| 5 | (3, 0, 2) | 2.6030 | 13 | (2, 0, 3) | 9.3096 | 21 | (2, 1, 0) | 13.6655 |
| 6 | (1, 0, 3) | 3.2648 | 14 | (1, 2, 0) | 9.6082 | 22 | (3, 2, 0) | 14.1699 |
| 7 | (0, 1, 3) | 4.6611 | 15 | (0, 2, 1) | 9.7856 | 23 | (2, 3, 1) | 14.5290 |
| 8 | (3, 1, 2) | 5.1242 | 16 | (3, 0, 1) | 10.9636 | 24 | (3, 2, 1) | 15.4722 |
(실습 코드의 brute_force_assignment 와 같은 방법으로 계산해 소수 넷째 자리로 적은 값입니다.) 맨 위의 줄을 손으로 확인해 봅시다.
그림에서 읽을 것은 둘입니다. 첫째, 예측 0 과 예측 1 은 둘 다 “원” 이라고 답했고 박스도 둘 다 정답 0 근처에 있습니다(다음 절에서 확인합니다). 그래도 둘이 정답 0 을 함께 가질 수는 없습니다. 둘째, 그래서 선이 엇갈립니다. 예측 0 은 자기와 가장 잘 맞는 정답 0($-1.36$)을 예측 1 에게 내주고 정답 1 로 갔습니다. 왜 그것이 전체로 보아 더 나은지가 다음 이야기입니다.
탐욕 배정은 왜 안 되나
24가지를 다 해 보지 않고 더 쉽게 할 수는 없을까요? 가장 먼저 떠오르는 방법은 “정답 0 부터 차례로, 남은 예측 가운데 가장 싼 것을 준다” 입니다. 눈앞의 가장 좋은 것을 그때그때 집는 이런 방법을 탐욕 배정greedy assignment 이라고 합니다. 위의 표에서 해 보면 이렇게 됩니다.
어디서 손해를 보았을까요? 정답 0 과 1 만 떼어 놓고 보면 분명합니다. 탐욕은 $-1.3618 + 1.8215 = 0.4597$ 을 냈고, 최적은 $-0.2370 - 0.2609 = -0.4979$ 를 냈습니다. 예측 0 은 정답 0 에도 1 에도 쓸 만한데, 예측 1 은 정답 0 에만 쓸 만합니다(정답 1 과는 $2.2602$). 그러니 쓸 곳이 한 군데뿐인 예측 1 을 정답 0 에 주고, 여기저기 쓸 수 있는 예측 0 을 정답 1 로 돌리는 편이 낫습니다. 한 칸만 보아서는 알 수 없고 표 전체를 보아야 나오는 답입니다. 이것이 배정 문제가 “칸마다 따로 최솟값 고르기” 보다 어려운 까닭입니다.
경우의 수의 폭발
그렇다면 늘 전부 해 보면 되지 않을까요? 배정의 수를 세어 봅시다.
| 경우 | $N$ | $T$ | 배정의 수 $N!/(N-T)!$ |
|---|---|---|---|
| 손계산 예 | 4 | 3 | 24 |
| 이 장의 미니 DETR, 객체 4개인 그림 | 12 | 4 | $12 \times 11 \times 10 \times 9 = 11{,}880$ |
| DETR($N = 100$), COCO 의 평균인 객체 7개 | 100 | 7 | $80{,}678{,}106{,}432{,}000 \approx 8.1 \times 10^{13}$ |
| DETR($N = 100$), 객체 20개 | 100 | 20 | $\approx 1.3 \times 10^{39}$ |
1초에 배정 10억($10^{9}$) 가지를 계산하는 컴퓨터가 있다고 해도, 객체 7개인 그림 한 장 의 매칭에 $8.1 \times 10^{13} / 10^{9} \approx 80{,}678$ 초, 곧 22시간 남짓이 걸립니다. 객체가 20개면 $1.3 \times 10^{30}$ 초로, 햇수로 $10^{22}$ 년을 넘습니다. 학습은 이 매칭을 스텝마다, 그림마다 해야 합니다. 전부 해 보는 방법(무차별 탐색)은 장난감 크기에서만 쓸 수 있습니다.
헝가리안 알고리즘의 직관
다행히 이 문제는 전부 해 보지 않고도 정확한 최적 배정을 찾을 수 있습니다. 그 고전적인 방법이 헝가리안 알고리즘Hungarian algorithm 입니다(Kuhn, 1955). 걸리는 시간이 행렬 한 변의 길이의 세제곱 정도로만 늘어서, $N = 100$ 이면 $100^3 = 10^{6}$ 번 남짓의 연산이면 됩니다. $10^{39}$ 과는 견줄 수 없이 작습니다. DETR 이 이 방법으로 짝을 찾기 때문에 그 짝짓기를 헝가리안 매칭Hungarian matching 이라고 부릅니다.
알고리즘 전체를 증명과 함께 다루는 것은 이 튜토리얼의 범위를 넘습니다. 여기서는 그 바탕에 있는 생각 하나만, 정사각형 행렬의 작은 예로 확인합니다. 생각은 이것입니다.
정사각형 비용 행렬에서 어느 한 행(또는 한 열)의 모든 칸에서 같은 수를 빼도 최적 배정은 바뀌지 않는다. 어떤 배정이든 그 행에서 정확히 한 칸을 쓰므로, 모든 배정의 총비용이 똑같이 그 수만큼 줄어들 뿐이고 순위는 그대로이기 때문이다.
이 관찰을 써서 행렬을 “0 이 많은” 꼴로 바꿔 갑니다. 모든 칸이 0 이상이고, 0 인 칸만 골라서 배정을 완성할 수 있다면 그 배정의 총비용은 0 이고, 0 보다 작은 총비용은 있을 수 없으니 그것이 최적입니다. 일꾼 3명(행)에게 일 3개(열)를 하나씩 맡기는 예로 해 봅시다.
헝가리안 알고리즘은 “0 만으로 배정이 완성되는지 확인하고, 안 되면 어느 행에서 빼고 어느 열에 더할지를 정하는” 일을 체계적으로 되풀이하는 방법입니다. 그 정하는 규칙과, 되풀이가 반드시 끝난다는 증명이 알고리즘의 본체인데 여기서는 다루지 않습니다. 우리에게 필요한 사실은 둘뿐입니다. 찾은 답이 정확히 최적이라는 것, 그리고 빠르다는 것 입니다.
우리의 비용 행렬은 $(N, T)$ 로 정사각형이 아닙니다. 이때는 열에서 빼는 것만 안전합니다. 모든 배정이 열(정답)은 빠짐없이 한 번씩 쓰지만, 행(예측)은 쓰이지 않는 것이 있어서 “어느 배정이든 그 행에서 한 칸을 쓴다” 가 성립하지 않기 때문입니다. 가장 쉬운 해결은 논문처럼 비용이 모두 0 인 가짜 열을 $N - T$ 개 붙여 $N \times N$ 정사각형으로 만드는 것입니다. 가짜 열이 곧 “∅ 와 짝이 된다” 이고, 그 비용이 예측과 무관한 상수(0)이므로 진짜 정답들의 짝에는 영향을 주지 않습니다. 이렇게 보면 배정은 $N$ 개 원소의 순열이 되어 $N!$ 가지이지만, 가짜 열끼리 자리를 바꾼 $(N - T)!$ 가지는 같은 배정이므로 서로 다른 것은 앞에서 센 $N!/(N-T)!$ 가지입니다.
무차별 탐색과 scipy 대조
실제로는 직접 구현하지 않고 SciPy 의 scipy.optimize.linear_sum_assignment(cost) 를 씁니다. 직사각형 행렬을 그대로 받아, 총비용이 최소인 배정의 (행 번호들, 열 번호들) 을 돌려줍니다.
RF-DETR 의 공개 코드(matcher.py)도 이 함수로 매칭을 풉니다.
이 장에서 쓴 SciPy 1.18 의 문서는 이 함수의 구현이 “수정된 Jonker – Volgenant 알고리즘” 이라고 적고 있습니다. 헝가리안 알고리즘과 같은 문제를 풀어 같은 최소 총비용을 내는 다른 (더 빠른) 알고리즘입니다. DETR 논문이 “헝가리안 알고리즘으로 계산한다” 고 썼기 때문에 이 계열에서는 어떤 풀이를 쓰든 헝가리안 매칭이라고 부릅니다. 우리에게 중요한 것은 풀이의 내부가 아니라 “최적 일대일 배정을 돌려준다” 는 약속입니다.
그 약속을 믿기만 할 것이 아니라 확인해 봅시다. 실습 코드에는 모든 배정을 훑는 무차별 탐색과 탐욕 배정이 들어 있습니다.
itertools.permutations(range(N), T) 가 “$N$ 개 가운데 $T$ 개를 순서 있게 고르는” 모든 방법, 곧 $N!/(N-T)!$ 가지의 배정을 차례로 내놓습니다.
위의 비용 행렬에 세 방법을 모두 적용한 출력은 다음과 같습니다(이 장의 실습 파일을 돌렸을 때 맨 앞에 나오는 부분입니다. 전체 실행은 뒤의 결과 읽기 절에서 합니다).
무차별 탐색: 배정 24가지 가운데 최소 — 정답 0,1,2 의 짝 = 예측 (1, 0, 2), 총비용 -1.9587
scipy linear_sum_assignment: 예측 (1, 0, 2), 총비용 -1.9587
탐욕 배정(정답 0 부터 가장 싼 예측): 예측 (0, 3, 2), 총비용 -1.0011
check 무차별 탐색 = scipy: True
check 무작위 6×T 비용 행렬 200개: 최소 비용의 최대 차이 = 8.88e-16
손으로 찾은 답과 같습니다. 마지막 줄은 예 하나로는 못 미더워서 넣은 확인입니다. 무작위로 만든 $6 \times T$ 비용 행렬($T$ 는 1 – 4) 200개에서 무차별 탐색의 최소 총비용과 SciPy 의 총비용을 견주었고, 가장 큰 차이가 $8.88 \times 10^{-16}$(64비트 실수의 반올림 오차 수준)이었습니다. 200개 모두에서 SciPy 는 진짜 최솟값을 찾았습니다.
DETR 의 매칭 비용
세 항의 정의
이제 비용 행렬의 숫자가 어디서 오는지 볼 차례입니다. “예측 $i$ 와 정답 $j$ 가 얼마나 안 맞는가” 는 두 가지를 함께 보아야 합니다. 클래스를 맞혔는가, 그리고 박스가 가까운가 입니다. DETR 의 매칭 비용matching cost 은 세 항의 합입니다.
$$ C_{ij} \;=\; \underbrace{-\,\hat{p}_i(c_j)}_{\text{클래스}} \;+\; \lambda_{\text{L1}}\,\underbrace{\lVert \hat{b}_i - b_j \rVert_1}_{\text{L1 거리}} \;+\; \lambda_{\GIoU}\,\underbrace{\big(-\GIoU(\hat{b}_i, b_j)\big)}_{\text{겹침}}, \qquad \lambda_{\text{L1}} = 5, \quad \lambda_{\GIoU} = 2 $$- 클래스 항 $-\hat{p}_i(c_j)$. 예측 $i$ 가 정답 $j$ 의 클래스 $c_j$ 에 준 소프트맥스 확률에 음의 부호를 붙인 것입니다. 정답 클래스에 확률을 많이 줄수록 비용이 작습니다. 범위는 $-1$ 에서 $0$ 입니다.
- L1 항. 2장의 L1 거리입니다. $(c_x, c_y, w, h)$ 네 숫자의 차의 절댓값을 더합니다.
- GIoU 항. 2장의 GIoU 에 음의 부호를 붙인 것입니다. GIoU 는 클수록 잘 겹친 것이므로($-1$ 에서 $1$), 부호를 뒤집어 “작을수록 좋은” 비용으로 만듭니다.
계수 $\lambda_{\text{L1}} = 5$, $\lambda_{\GIoU} = 2$ 는 DETR 논문 부록 A.4 의 값이고(논문은 뒤의 것을 $\lambda_{\text{iou}}$ 로 적습니다), 클래스 항의 계수는 1 입니다. 2장 끝의 박스 손실 $\mathcal{L}_{\text{box}}$ 와 같은 계수입니다. 손계산 예의 세 항을 따로 적으면 다음과 같습니다(실습 코드의 출력 그대로).
[손계산 예] 예측 4개 × 정답 3개 (정답: 원, 원, 삼각형)
C_cls = −p̂_i(c_j)
 [[-0.7  -0.7  -0.1 ]
 [-0.6  -0.6  -0.1 ]
 [-0.1  -0.1  -0.6 ]
 [-0.05 -0.05 -0.1 ]]
C_L1 = ‖b̂_i − b_j‖₁
 [[0.12 0.24 0.86]
 [0.18 0.54 1.08]
 [0.9  0.66 0.08]
 [0.8  0.44 0.7 ]]
C_GIoU = −GIoU
 [[-0.6309 -0.3805  0.6988]
 [-0.2685  0.0801  0.7999]
 [ 0.7039  0.5238 -0.6304]
 [ 0.1874 -0.1642  0.1814]]
C = 1·C_cls + 5·C_L1 + 2·C_GIoU
 [[-1.3618 -0.2609  5.5975]
 [-0.237   2.2602  6.8998]
 [ 5.8077  4.2476 -1.4608]
 [ 4.3247  1.8215  3.7627]]
네 행렬의 모양은 모두 (예측 수, 정답 수) $= (4, 3)$ 입니다. 미니 DETR 에서는 그림마다 $(12, T)$, DETR 논문의 설정이라면 $(100, T)$ 입니다. 이 예의 예측과 정답은 다음과 같습니다.
| 클래스 확률 [원, 사각형, 삼각형, ∅] | 박스 $(c_x, c_y, w, h)$ | |
|---|---|---|
| 예측 0 | [0.70, 0.10, 0.10, 0.10] | (0.33, 0.31, 0.24, 0.24) |
| 예측 1 | [0.60, 0.20, 0.10, 0.10] | (0.24, 0.26, 0.16, 0.16) |
| 예측 2 | [0.10, 0.20, 0.60, 0.10] | (0.66, 0.70, 0.30, 0.24) |
| 예측 3 | [0.05, 0.05, 0.10, 0.80] | (0.50, 0.50, 0.40, 0.40) |
| 정답 0 | 원 | (0.30, 0.30, 0.20, 0.20) |
| 정답 1 | 원 | (0.42, 0.34, 0.30, 0.30) |
| 정답 2 | 삼각형 | (0.70, 0.70, 0.30, 0.20) |
$C_{\text{cls}}$ 의 첫 두 열이 같은 것은 정답 0 과 1 이 같은 클래스(원)이기 때문입니다. 클래스만으로는 두 원을 구별할 수 없고, 박스 항이 구별해 줍니다.
한 칸을 손으로 계산하기
최적 배정에 쓰인 칸 $C_{1,0}$(예측 1 과 정답 0)을 처음부터 계산해 봅시다. GIoU 는 2장의 순서대로 모서리 표현으로 바꾼 다음 계산합니다.
같은 방법으로 예측 0 과 정답 0 을 계산하면 $-0.70 + 5 \times 0.12 - 2 \times 0.6309 = -1.3618$ 입니다. 예측 0 이 예측 1 보다 정답 0 에 훨씬 잘 맞습니다(박스도 더 가깝고 확률도 높습니다). 그런데도 최적 배정이 정답 0 을 예측 1 에게 준 까닭은 앞에서 보았습니다. 예측 0 이 정답 1 까지 맡을 수 있는 유일한 후보였기 때문입니다.
논문은 매칭 비용의 박스 부분을 손실과 같은 $\mathcal{L}_{\text{box}} = \lambda_{\text{iou}}\,(1 - \GIoU) + \lambda_{\text{L1}} \lVert \cdot \rVert_1$ 로 적습니다. 이 장의 코드(와 RF-DETR 의 공개 코드)는 $1 - \GIoU$ 대신 $-\GIoU$ 를 씁니다. 둘의 차이는 칸마다 $\lambda_{\GIoU} \times 1 = 2$ 라는 상수입니다. 어떤 배정이든 정확히 $T$ 칸을 쓰므로 모든 배정의 총비용이 똑같이 $2T$ 만큼 달라질 뿐이고, 최적 배정은 같습니다. 이 예라면 논문 식으로 계산한 최소 총비용은 $-1.9587 + 2 \times 3 = 4.0413$ 이고 배정은 여전히 $(1, 0, 2)$ 입니다.
왜 로그 확률이 아니라 확률인가
4장에서 분류 손실은 $-\log \hat{p}$ 였습니다. 그런데 매칭 비용의 클래스 항은 로그가 없는 $-\hat{p}$ 입니다. 논문은 이렇게 설명합니다. 매칭 비용에는 로그 확률 대신 확률을 쓰는데, 그러면 클래스 항이 박스 항 $\mathcal{L}_{\text{box}}$ 와 견줄 만한 크기 가 되고, 실험에서도 결과가 더 좋았다는 것입니다. 숫자로 보면 무슨 말인지 알 수 있습니다.
| 정답 클래스에 준 확률 $\hat{p}$ | 0.9 | 0.5 | 0.1 | 0.01 | 0.001 |
|---|---|---|---|---|---|
| $-\hat{p}$ (DETR 의 매칭 비용) | −0.9 | −0.5 | −0.1 | −0.01 | −0.001 |
| $-\log \hat{p}$ (로그를 썼다면) | 0.105 | 0.693 | 2.303 | 4.605 | 6.908 |
- $-\hat{p}$ 는 어떤 경우에도 $-1$ 과 $0$ 사이입니다. 두 예측의 클래스 비용 차이는 많아야 1 입니다.
- $-\log \hat{p}$ 는 확률이 0 에 가까워질수록 끝없이 커집니다. $\hat{p} = 0.001$ 이면 6.9 입니다.
- 박스 쪽은 어떨까요. 손계산 예에서 $5 \times C_{\text{L1}}$ 은 0.4 에서 5.4 사이, $2 \times C_{\GIoU}$ 는 $-1.26$ 에서 $1.60$ 사이에 있습니다. GIoU 항은 정의상 $-2$ 와 $2$ 사이를 벗어나지 못합니다.
확률을 쓰면 세 항이 모두 끝이 막힌 값이 되어 서로 견줄 수 있습니다. 로그를 쓰면 클래스 항만 끝없이 커질 수 있어서, 아직 클래스를 잘 모르는 학습 초기에 “박스는 거의 정확한데 확률이 아주 낮은” 예측이 짝에서 밀려나기 쉽습니다. 뒤의 문장은 이 튜토리얼의 해석이고, 논문은 위의 이유(크기를 맞춘다, 실험에서 더 좋았다)만 적고 있습니다.
Deformable DETR 부터는 분류가 클래스별 시그모이드와 포컬 손실로 바뀌면서 매칭의 클래스 항도 포컬 손실 꼴로 바뀝니다(8장).
실습 코드의 HungarianMatcher 는 그때를 위해 class_cost="focal" 도 받게 만들어 두었습니다. 이 장에서는 "prob" 만 씁니다.
매칭에는 기울기가 없다
매칭의 출력은 “정답 0 의 짝은 예측 1” 같은 번호 입니다. 번호는 정수이고, 예측을 아주 조금 바꾸어도 대개 그대로이다가 어느 순간 다른 번호로 툭 바뀝니다.
이런 값에는 4장에서 배운 기울기(조금 바꾸면 얼마나 변하는가)가 정의되지 않습니다. 그래서 매칭은 기울기 계산 밖에서 합니다. PyTorch 로는 @torch.no_grad() 입니다.
- 매칭은 누가 누구의 짝인지 정하는 일 만 합니다. 비용 행렬의 값 자체는 손실에 들어가지 않습니다.
- 짝이 정해지면 그것을 주어진 상수 로 보고 손실을 계산합니다. 기울기는 그 손실을 통해서만 흐릅니다.
- 매칭은 스텝마다, 그림마다 새로 합니다. 학습이 진행되어 예측이 달라지면 짝도 달라질 수 있습니다. 어떤 질의가 어제는 이 객체를 맡았다가 오늘은 ∅ 를 맡을 수 있습니다.
집합 손실
헝가리안 손실의 식
짝이 정해졌으니 손실을 계산합니다. 먼저 질의마다 목표 클래스 $t_i$ 를 정합니다.
$$ t_i = \begin{cases} c_j & \text{예측 } i \text{ 가 정답 } j \text{ 의 짝일 때 } \big(i = \hat{\sigma}(j)\big) \\ \varnothing & \text{예측 } i \text{ 에게 짝이 없을 때} \end{cases} $$그러면 DETR 논문의 식 (2), 곧 집합 손실set loss, Hungarian loss 은 이 장의 표기로 다음과 같습니다. 논문은 이것을 헝가리안 손실이라고 부릅니다.
$$ \mathcal{L}_{\text{Hungarian}} \;=\; \underbrace{\sum_{i=0}^{N-1} -\log \hat{p}_i(t_i)}_{\text{모든 질의의 분류}} \;+\; \underbrace{\sum_{j=0}^{T-1} \mathcal{L}_{\text{box}}\big(b_j,\, \hat{b}_{\hat{\sigma}(j)}\big)}_{\text{짝이 있는 질의의 박스}} $$- 분류 항은 $N$ 개 질의 모두 에 겁니다. 짝이 있는 질의는 정답 클래스를, 없는 질의는 $\varnothing$ 를 맞혀야 합니다. 4장의 소프트맥스 교차 엔트로피(CE) 그대로입니다.
- 박스 항은 짝이 있는 $T$ 개 질의에만 겁니다. 짝이 없는 질의는 견줄 정답 박스가 없으므로 박스가 어디에 있든 손실이 없습니다.
- 박스 손실은 2장의 $\mathcal{L}_{\text{box}}(b, \hat{b}) = \lambda_{\text{L1}} \lVert b - \hat{b} \rVert_1 + \lambda_{\GIoU}\,(1 - \GIoU(b, \hat{b}))$ 이고 계수는 5 와 2 입니다. 여기서는 $1 - \GIoU$ 입니다(손실은 0 이상이 되게 합니다).
매칭 비용과 손실은 닮았지만 다른 것입니다. 나란히 놓으면 차이가 분명해집니다.
| 매칭 비용 $C_{ij}$ | 집합 손실 | |
|---|---|---|
| 하는 일 | 누가 누구의 짝인지 정한다 | 정해진 짝으로 모델을 학습시킨다 |
| 계산 범위 | 모든 쌍 $(N, T)$ | 짝끼리($T$ 쌍) + 분류는 $N$ 개 모두 |
| 클래스 항 | $-\hat{p}_i(c_j)$ (확률) | $-\log \hat{p}_i(t_i)$ (로그 확률) |
| 박스 항 | $5 \cdot \text{L1} - 2 \cdot \GIoU$ | $5 \cdot \text{L1} + 2 \cdot (1 - \GIoU)$ |
| ∅ 의 취급 | 나오지 않는다(상수) | 짝 없는 질의의 목표 클래스 |
| 기울기 | 없음(no_grad) | 있음(역전파) |
객체 없음의 가중치를 낮추는 이유
위의 식을 그대로 쓰면 문제가 하나 있습니다. 질의 대부분의 목표가 $\varnothing$ 라는 것입니다.
- DETR 논문의 설정($N = 100$, COCO 의 그림당 평균 객체 7개)이라면 분류 항 100개 가운데 93개 가 “∅ 를 맞혀라” 입니다.
- 이 장의 미니 모델($N = 12$)은 검증 그림 500장에 정답이 1,265개이므로 그림당 평균 2.53개가 객체, 9.47개 가 ∅ 입니다.
4장에서 본 클래스 불균형입니다. 그대로 두면 “무조건 ∅” 라고 답하기만 해도 분류 손실의 대부분이 사라지므로, 모델이 그쪽으로 쏠립니다. DETR 의 처방은 단순합니다. 목표가 ∅ 인 항에 가중치 0.1 을 곱합니다. 논문의 말로는 “클래스 불균형을 고려해 $c_i = \varnothing$ 일 때의 로그 확률 항을 10분의 1 로 낮춘다” 이고, Faster R-CNN 이 양성 · 음성 후보의 비율을 맞추려고 일부만 골라 학습하던 것과 같은 구실이라고 덧붙입니다.
가중치를 곱한 뒤의 “목소리 크기” 를 세어 보면, 논문 설정에서 ∅ 쪽은 $93 \times 0.1 = 9.3$, 객체 쪽은 $7 \times 1 = 7$ 로 비슷해집니다. 미니 모델에서는 ∅ 쪽이 $9.47 \times 0.1 = 0.947$, 객체 쪽이 $2.53$ 입니다. 4장의 포컬 손실이 “쉬운 예의 손실을 줄이는” 정교한 처방이라면, 이것은 “∅ 의 손실을 통째로 줄이는” 투박한 처방입니다. 8장부터는 포컬 손실 계열로 바뀝니다.
정규화: 논문의 식과 구현의 차이
식 (2) 는 합으로 적혀 있지만, 합은 배치 크기와 객체 수에 따라 크기가 달라지므로 실제로는 나누어 줍니다. 이 장의 구현(SetCriterion)이 계산하는 것을 정확히 적으면 다음 세 항입니다.
$T_{\text{batch}}$ 는 배치 전체의 정답 객체 수, $w(c)$ 는 클래스 가중치($\varnothing$ 이면 0.1, 그 밖에는 1)이고, 합은 배치의 모든 그림에 걸친 것입니다.
논문 부록 A.2 는 “모든 손실을 배치 안의 객체 수로 정규화한다” 고 적습니다. 박스 손실 두 항은 이 장의 구현도 그대로입니다($T_{\text{batch}}$ 로 나눕니다. 객체가 하나도 없는 배치에서 0 으로 나누지 않도록 최소 1 로 둡니다).
그런데 분류 손실은 PyTorch 의 F.cross_entropy(..., weight=...) 를 쓰고, 이 함수는 가중치를 곱한 합을 가중치의 합 으로 나눕니다(가중 평균).
그래서 분모가 $T_{\text{batch}}$ 가 아니라 $T_{\text{batch}} + 0.1 \times (\text{∅ 가 목표인 질의의 수})$ 입니다.
DETR 의 공개 코드도 이 함수를 쓰는 것으로 알려져 있지만, 이 튜토리얼을 만든 환경에는 그 저장소가 없어 직접 확인하지는 못했습니다.
두 방식은 분류 손실의 크기가 조금 다를 뿐(아래 손계산에서 0.4518 과 0.4669), “∅ 항을 10분의 1 로” 라는 뜻은 같습니다.
한 그림의 손실을 끝까지 계산하기
손계산 예로 돌아가 최적 배정 $(1, 0, 2)$ 에서 손실을 끝까지 계산합니다. 그림이 한 장이므로 $T_{\text{batch}} = 3$ 입니다.
실습 코드의 출력이 같은 값을 냅니다.
손실: loss_ce 0.4518, loss_bbox 0.1667, loss_giou 0.5735 → 전체 1·ce + 5·bbox + 2·giou = 2.4322
질의별 목표 클래스: ['circle', 'circle', 'triangle', 'no-object'] −log p̂: [0.3567 0.5108 0.5108 0.2231] 가중치: [1.  1.  1.  0.1]
check 가중 교차 엔트로피 손계산 0.451820 vs SetCriterion 0.451819
이 숫자에서 읽을 것이 있습니다. 전체 2.43 가운데 GIoU 항이 1.15, L1 항이 0.83, 분류 항이 0.45 입니다. 이 예에서는 박스 쪽이 손실의 대부분 입니다. 그리고 예측 3 은 ∅ 에 0.80 밖에 주지 않았는데도 분류 손실에 0.0223 만 보탰습니다. 가중치 0.1 때문입니다. 예측 3 의 박스 $(0.50, 0.50, 0.40, 0.40)$ 는 어디에도 쓰이지 않았습니다.
왜 중복 예측이 사라지는가
이제 이 장의 처음 물음으로 돌아갑니다. 이 손실로 학습하면 왜 객체마다 예측이 하나만 남을까요? 상황 하나를 숫자로 따져 봅시다. 원 하나에 질의 A 와 질의 B 가 둘 다 거의 같은 박스를 내고, 둘 다 “원 0.90, ∅ 0.05” 라고 답했다고 합시다. 3장의 채점이라면 하나는 참 양성, 다른 하나는 거짓 양성(중복 예측)입니다.
- 매칭. 정답은 하나이므로 일대일 매칭은 둘 가운데 비용이 조금이라도 작은 쪽, 이를테면 A 만 짝으로 삼습니다. B 는 짝이 없습니다.
- A 의 손실. 목표가 원입니다. 분류 항은 $-\log 0.90 = 0.105$ 로 작고, 박스 손실이 박스를 더 정확하게 끌어당깁니다. A 는 칭찬받습니다.
- B 의 손실. 목표가 ∅ 입니다. B 는 ∅ 에 0.05 밖에 주지 않았으므로 분류 항은 $0.1 \times (-\log 0.05) = 0.1 \times 2.996 = 0.300$ 입니다. B 가 ∅ 에 0.90 을 주었다면 $0.1 \times 0.105 = 0.011$ 이었을 것입니다. B 는 똑같이 잘 맞혔는데도 벌을 받습니다.
즉 같은 객체를 두 질의가 함께 높은 점수로 가리키는 한, 둘 가운데 하나는 반드시 “∅ 라고 답했어야 한다” 는 기울기를 받습니다. 손실이 가장 작아지는 상태는 객체마다 질의 하나만 높은 점수를 내고 나머지는 모두 ∅ 라고 답하는 상태입니다. 3장의 채점 규칙 “정답 하나는 한 번만 쓰인다” 를 학습의 규칙으로 옮긴 셈입니다. 3장에서 NMS 가 출력이 나온 뒤에 하던 일을, DETR 은 학습으로 모델 안에 넣습니다.
그런데 여기에는 조건이 하나 있습니다. B 가 “이 원은 A 가 맡았다” 는 것을 알 수 있어야 합니다. 질의들이 서로를 전혀 보지 못한 채 각자 그림만 보고 답한다면, A 와 B 는 누가 물러나야 하는지 정할 방법이 없습니다. 그 통로가 디코더의 자기 어텐션 입니다(5장). 디코더 층마다 질의들이 서로의 상태를 보고, “그 객체는 저 질의가 이미 가리키고 있으니 나는 ∅ 로 가겠다” 를 조정합니다. DETR 논문은 Transformer 의 자기 어텐션이 원소 사이의 모든 쌍의 상호작용을 다루기 때문에 중복 예측을 없애는 것 같은 집합 예측의 제약에 특히 잘 맞는다고 설명합니다.
짝이 없는 질의에는 박스 손실이 없습니다. 그러니 B 의 박스 가 A 와 겹치는 것 자체는 벌을 받지 않고, B 의 점수 가 높은 것만 벌을 받습니다. 학습이 잘 된 DETR 에서도 낮은 점수의 예측들은 여전히 객체 위에 겹쳐 있을 수 있습니다. 3장의 실험에서 보았듯이 점수가 낮은 중복은 AP 를 거의 깎지 않으므로 그것으로 충분합니다. 뒤의 실험에서 “중복이 정확히 0 인가” 를 셀 때 이 점을 기억해 두세요.
DETR 의 구조
전체 흐름과 텐서 모양
손실이 정해졌으니, 그 손실로 학습할 모델을 봅니다. 논문의 말대로 구조는 놀랄 만큼 단순해서 부품이 셋뿐입니다. 그림에서 특징을 뽑는 CNN 백본, Transformer 인코더 · 디코더, 그리고 최종 예측을 내는 작은 머리 입니다. 부품은 모두 4 – 5장에서 만든 것입니다.
그림을 왼쪽에서 오른쪽으로 따라가며 모양이 바뀌는 자리를 짚습니다. 오른쪽 열에 논문의 설정을 나란히 적었습니다(논문 값은 DETR 논문 3.2절 · 4절 · 부록 A.4 에서 옮긴 것입니다).
| 단계 | 하는 일 | 이 장의 미니 DETR | DETR 논문 (ResNet-50) |
|---|---|---|---|
| 입력 | 그림 | (B, 3, 96, 96) | $(3, H_0, W_0)$, 짧은 변 480 – 800 픽셀 |
| 백본 | CNN 이 해상도를 줄이며 특징을 뽑는다 | 3×3 합성곱 6층, 스트라이드 8 → (B, 128, 12, 12) | ResNet-50, 스트라이드 32 → $(2048, H_0/32, W_0/32)$ |
| 1×1 합성곱 | 채널 수를 모델 차원 $D$ 로 | 128 → 128, (B, 128, 12, 12) | 2048 → 256 |
| 펴기 | 격자를 토큰 한 줄로(행 우선) | (B, 144, 128), 토큰 $12 \times 12 = 144$ 개 | $(HW, 256)$ |
| 위치 인코딩 | 2차원 사인(고정) | (144, 128) | $(HW, 256)$ |
| 인코더 | 그림 토큰끼리 자기 어텐션 → FFN | 3층, 머리 8, FFN 256 → (B, 144, 128) | 6층, 머리 8 |
| 객체 질의 | 학습되는 위치 임베딩 | (12, 128), $N = 12$ | $(100, 256)$, $N = 100$ |
| 디코더 | 자기 어텐션 → 교차 어텐션 → FFN | 3층 → (B, 12, 128) | 6층 → $(100, 256)$ |
| 분류 머리 | 선형 층 하나 | (B, 12, 4) ($K + 1 = 4$) | $(100, K + 1)$ |
| 박스 머리 | 3층 MLP(은닉 $D$, ReLU) → 시그모이드 | (B, 12, 4) | $(100, 4)$ |
| 드롭아웃 | 0 | 0.1 | |
| 매개변수 | 1,333,608개 | 4,130만 개(ResNet-50 2,350만 + Transformer 1,780만) |
- 백본. 4장의 합성곱을 쌓은 것입니다. 스트라이드 2 인 층을 세 번 지나며 $96 \to 48 \to 24 \to 12$ 로 줄어듭니다. 논문의 ResNet-50 은 스트라이드가 32 인데, 96픽셀 그림에 그대로 쓰면 $3 \times 3$ 격자밖에 남지 않아서 스트라이드 8 로 줄였습니다.
- 1×1 합성곱과 펴기. 1×1 합성곱은 칸마다 채널만 섞어 채널 수를 $D$ 로 맞춥니다(4장). 미니 모델에서는 백본의 출력이 이미 128 채널이어서 수는 그대로지만, 논문과 같은 자리에 두었습니다. 그다음 $(B, D, H, W)$ 를 $(B, HW, D)$ 로 폅니다. 격자의 칸 하나가 토큰 하나가 됩니다(5장).
- 인코더. 5장의 post-norm 인코더 층입니다. 144개 그림 토큰이 서로를 모두 봅니다. 논문은 인코더가 전역 자기 어텐션으로 객체들을 서로 떼어 놓는 구실을 한다고 보았고, 인코더 층을 아예 없애면 AP 가 3.9 떨어진다고 보고합니다(논문 표 2, COCO).
-
디코더. 5장의 post-norm 디코더 층입니다. 질의끼리 자기 어텐션 → 그림 토큰에 교차 어텐션 → FFN. 인코더의 출력(5장의 $M$, 코드의
memory)은 읽기만 합니다. - 머리. 디코더가 낸 벡터 $N$ 개를 하나씩 따로 예측으로 바꿉니다. 분류 머리는 선형 층 하나, 박스 머리는 3층 MLP 입니다. 박스 머리의 끝에 시그모이드가 있어 네 숫자가 모두 0 과 1 사이, 곧 정규화 좌표가 됩니다. 논문의 말대로 DETR 은 어떤 기준(앵커)에서 얼마나 고칠지가 아니라 박스 자체를 직접 예측합니다.
객체 질의란 무엇인가
디코더에 들어가는 객체 질의는 무엇일까요? 구현을 보면 허무할 만큼 단순합니다. nn.Embedding(12, 128), 곧 모양 (12, 128) 의 학습되는 표 하나 입니다.
숫자 $12 \times 128 = 1{,}536$ 개가 전부이고, 그림과 무관하게 늘 같은 값이 들어갑니다. 논문은 이것을 “학습되는 위치 인코딩” 이라고 부르며 객체 질의라는 이름을 붙였습니다.
6장의 말로는 위치 임베딩(학습되는 것)입니다.
디코더의 입력은 둘로 나뉩니다. 코드의 변수 이름으로 적겠습니다.
tgt(B, N, D): 질의의 내용. 첫 층에는 0 으로 채운 텐서 가 들어갑니다. 층을 지나며 그림에서 읽어 온 정보가 여기에 쌓입니다.query_pos(N, D): 객체 질의. 층마다 어텐션의 질의와 열쇠에 더해집니다. 값이 변하지 않는 “이름표” 구실을 합니다.
디코더 한 층의 두 어텐션에 무엇이 질의 · 열쇠 · 값으로 들어가는지 적으면 다음과 같습니다(pos 는 그림 토큰의 사인 위치 인코딩).
| 어텐션 | 질의 | 열쇠 | 값 | 가중치의 모양(머리 평균) |
|---|---|---|---|---|
| 자기 어텐션 (질의끼리) | tgt + query_pos | tgt + query_pos | tgt | (B, 12, 12) |
| 교차 어텐션 (질의 → 그림) | tgt + query_pos | memory + pos | memory | (B, 12, 144) |
왜 질의마다 달라야 할까요? 5장에서 어텐션 층은 순서를 모른다(순열 등변)는 것을 보았습니다. 디코더에 똑같은 벡터 12개를 넣으면 12개가 똑같은 계산을 거쳐 똑같은 출력 이 나옵니다. 예측 12개가 모두 같아서는 쓸모가 없습니다. 논문도 같은 이유를 댑니다. 디코더가 순열에 대해 불변이므로 서로 다른 결과를 내려면 $N$ 개의 입력 임베딩이 서로 달라야 한다는 것입니다. 학습되는 객체 질의가 그 “서로 다름” 을 줍니다. 무엇을 다르게 할지는 사람이 정하지 않고 학습이 정합니다. 뒤의 실험에서 질의들이 실제로 무엇을 나누어 맡게 되는지 봅니다.
첫 층에서 tgt 는 0 입니다. 자기 어텐션의 값 이 tgt 이므로, 가중치가 어떻게 나오든 가중 평균의 재료가 모두 같습니다(0 에 편향을 더한 것).
그래서 첫 층의 자기 어텐션을 지난 뒤에도 질의 12개의 tgt 는 서로 같습니다. 질의들이 그림을 처음 보는 것은 그다음의 교차 어텐션이고,
그림을 본 뒤에 서로 이야기할 기회는 둘째 층부터 옵니다. 논문도 디코더 층 하나만으로는 출력 원소들 사이의 관계를 계산할 수 없어 같은 객체를 여러 번 예측하기 쉽다고 설명합니다.
이것이 뒤의 실험에서 첫 층의 출력에 중복이 가장 많은 까닭입니다.
병렬 디코딩
5장에서 원래의 Transformer 디코더는 낱말을 하나씩 차례로 만들어 낸다고 했습니다(앞에서 만든 낱말을 다음 입력으로 넣습니다). DETR 의 디코더는 그렇게 하지 않습니다. 질의 $N$ 개가 한꺼번에 들어가 $N$ 개의 예측이 한 번의 순전파로 나옵니다. 이것을 병렬 디코딩parallel decoding 이라고 합니다.
- 객체 사이에는 “첫째, 둘째” 가 없으므로 차례로 만들 이유가 없습니다. 집합 손실이 예측의 순서에 무관하기(순열 불변) 때문에 가능한 일입니다.
- 차례로 만들면 객체 수만큼 디코더를 되풀이해 돌려야 하지만, 병렬 디코딩은 객체가 1개든 50개든 계산량이 같습니다.
- 미래를 가리는 인과 마스크(5장)가 필요 없습니다. 질의들은 서로를 자유롭게 봅니다.
위치 인코딩을 넣는 곳
어텐션은 순서를 모르므로 그림 토큰에 위치를 알려 주어야 합니다. DETR 은 5장의 2차원 사인 위치 인코딩(고정된 값, 학습되지 않음)을 쓰는데, 넣는 곳이 원래의 Transformer 와 다릅니다.
맨 처음 입력에 한 번 더하는 것이 아니라 인코더와 디코더의 모든 어텐션 층에서 질의와 열쇠에 더합니다. 값에는 더하지 않습니다.
위 표에서 인코더 자기 어텐션은 질의 = 열쇠 = src + pos, 값 = src 이고, 디코더 교차 어텐션의 열쇠가 memory + pos 입니다.
“어디를 볼지”(질의와 열쇠의 내적)에는 위치를 쓰고, “무엇을 가져올지”(값)에는 내용만 쓰는 셈입니다. 논문은 위치 인코딩을 넣는 방법을 여럿 견주었고(표 3, COCO), 원래의 Transformer 처럼 입력에 한 번만 더하면 층마다 어텐션에 넣을 때보다 AP 가 1.4 낮았다고 보고합니다.
후처리: 출력에서 예측 목록으로
추론할 때는 매칭도 손실도 없습니다. 모델의 출력 (B, N, K+1) 과 (B, N, 4) 를 3장의 채점기가 받는 (박스, 점수, 클래스) 목록으로 바꾸기만 하면 됩니다.
- 로짓에 소프트맥스를 걸어 확률로 바꿉니다.
- ∅ 칸을 뺀 $K$ 칸 가운데 가장 큰 확률 이 그 질의의 점수, 그 자리가 클래스입니다.
- 질의 $N$ 개가 모두 예측으로 나갑니다. ∅ 라고 답한 질의는 나머지 칸의 확률이 작아서 점수가 저절로 낮고, 3장에서 보았듯이 점수가 낮은 예측은 AP 를 거의 깎지 않습니다.
NMS 는 없습니다. 논문도 같은 방식을 씁니다. ∅ 를 예측한 슬롯을 버리는 대신 둘째로 높은 클래스와 그 확률을 예측으로 삼으면 AP 가 2 올랐다고 적고 있습니다(∅ 가 가장 높은 슬롯에서 “∅ 를 뺀 최댓값” 이 곧 둘째로 높은 클래스입니다). 그림으로 보여 줄 때처럼 “확실한 것만” 필요하면 점수 문턱값(이 장에서는 0.5)으로 거릅니다.
보조 손실
DETR 에는 학습을 돕는 장치가 하나 더 있습니다. 손실을 마지막 디코더 층의 출력에만 걸지 않고 모든 디코더 층의 출력에 겁니다. 중간 층의 출력에 거는 손실을 보조 손실auxiliary loss 이라고 합니다. 방법은 이렇습니다.
- 디코더 층 $l$ 의 출력
(B, N, D)를 같은 층 정규화, 같은 분류 머리, 같은 박스 머리 에 넣어 예측을 만듭니다. 머리는 층마다 따로 두지 않고 모든 층이 함께 씁니다. - 그 예측으로 매칭부터 다시 합니다. 층마다 예측이 다르므로 짝도 다를 수 있습니다.
- 같은 집합 손실을 계산해 모두 더합니다.
$L$ 은 디코더 층의 수(미니 모델 3, 논문 6)이고, 위첨자 $(l)$ 은 “$l$ 번째 층의 출력으로, 그 층의 매칭 $\hat{\sigma}^{(l)}$ 로 계산한” 이라는 뜻입니다. $l = L$ 인 항이 본래의 손실이고 나머지 $L - 1$ 개가 보조 손실입니다. 추론할 때는 마지막 층의 예측만 씁니다.
왜 도움이 될까요? 논문은 보조 손실이 도움이 되었고, 특히 모델이 클래스마다 객체의 수를 올바르게 내도록 돕는다고 적습니다. 이유를 풀어 보면 다음과 같이 읽을 수 있습니다(논문의 문장이 아니라 일반적인 설명입니다).
- 기울기의 지름길. 손실이 마지막 층에만 있으면 아래층은 위층 여럿을 거쳐 온 기울기만 받습니다. 층마다 손실이 있으면 모든 층이 “정답에서 얼마나 먼가” 라는 신호를 직접 받습니다.
- 층마다 “읽을 수 있는” 답. 모든 층의 출력을 같은 머리가 읽으므로, 어느 층의 출력이든 그 자체로 (클래스, 박스) 로 풀리는 표현이어야 합니다. 디코더는 “첫 층이 대강의 답을 내고, 다음 층들이 그것을 조금씩 고치는” 꼴로 학습됩니다.
둘째 성질에는 중요한 부산물이 있습니다. 어느 층에서 멈추어도 예측이 나온다 는 것입니다. 논문은 디코더 각 층의 출력으로 AP 를 재어, 층을 지날 때마다 AP 가 오르고 첫 층과 마지막 층 사이에 AP 가 8.2, AP50 이 9.5 차이 난다고 보고합니다(논문 그림 4, COCO). 거꾸로 읽으면 “층을 덜 쓰면 조금 덜 정확한 대신 더 빠른 탐지기” 가 공짜로 생깁니다.
RF-DETR 은 이 성질을 설계의 일부로 씁니다. RF-DETR 논문은 모든 디코더 층의 출력에 손실을 걸기 때문에 추론 때 디코더 층의 일부 또는 전부를 떼어 낼 수 있다 고 설명하고, 디코더 층의 수를 가중치 공유 NAS 가 고르는 손잡이 가운데 하나로 삼습니다. 같은 가중치로 “디코더 2층짜리 빠른 모델” 과 “6층짜리 정확한 모델” 을 모두 얻는 것입니다. 자세한 것은 12장에서 다룹니다. 이 장의 실험에서도 층별 AP 를 재어 봅니다.
구현 따라 읽기
이제 code/ch07_detr.py 를 위에서 본 순서대로 읽습니다. 매칭 → 손실 → 모델 → 학습 고리 → 후처리입니다. 박스 연산은 2장의 ch02_boxes.py,
채점과 NMS 는 3장의 ch03_metrics.py, 데이터는 rf_shapes.py 에서 가져옵니다.
이 파일의 HungarianMatcher 와 SetCriterion 은 8장부터의 실습이 그대로 가져다 쓰는 공용 부품이기도 합니다.
매칭: HungarianMatcher
-
cost_parts가 세 비용 행렬을 만듭니다.prob[:, tgt_labels]는 확률 표(Q, K+1)에서 정답들의 클래스에 해당하는 열만 골라(Q, T)로 만드는 색인입니다. 정답이 [원, 원, 삼각형] 이면 0번 열, 0번 열, 2번 열을 차례로 뽑습니다. 손계산 예에서 $C_{\text{cls}}$ 의 첫 두 열이 같았던 까닭입니다. torch.cdist(boxes, tgt_boxes, p=1)은 모든 쌍의 L1 거리(Q, T)를,generalized_box_iou는 2장의 “모든 쌍” GIoU(Q, T)를 냅니다. 모서리 표현으로 바꾼 뒤 넣습니다.-
forward는 배치를 한 번에 처리합니다. 배치의 모든 예측 $B \cdot N$ 개와 배치의 모든 정답 $\sum T$ 개 사이의 큰 비용 행렬을 한 번 계산하고,(B, N, ΣT)로 모양을 바꾼 다음, 열을 그림별 정답 수로 잘라(split) 그림 $b$ 의 예측과 그림 $b$ 의 정답 이 만나는 조각block[b]만linear_sum_assignment에 넣습니다. 다른 그림의 정답과 만나는 칸은 계산만 되고 쓰이지 않습니다. 낭비처럼 보이지만 GPU 에서 한 번에 계산하는 편이 그림마다 따로 하는 것보다 빠릅니다. - 헝가리안 풀이는 CPU 에서 NumPy 배열로 합니다(
.cpu(),.numpy()). 돌려주는 것은 그림마다 (예측 번호들, 정답 번호들) 한 쌍입니다. - 세 메서드 모두
@torch.no_grad()입니다. 앞에서 본 대로 매칭에는 기울기가 없습니다.
손실: SetCriterion
-
__init__의class_weight가 $[1, 1, 1, 0.1]$ 입니다. 마지막 칸(∅)만eos_coef = 0.1입니다. (eos는 문장의 끝을 뜻하는 end of sequence 의 약자로, DETR 의 공개 코드에서 온 이름으로 알려져 있습니다. 여기서는 “∅ 의 가중치” 로 읽으면 됩니다.) -
match는 매칭 결과를 번호 세 줄로 폅니다.pred[batch_idx[k], query_idx[k]]가 $k$ 번째 짝의 예측이고,tgt_idx[k]가 그 짝의 정답이 “배치의 정답을 한 줄로 이은 것” 에서 몇 번째인지입니다. 작은 텐서를 GPU 로 하나씩 옮기면 느리므로 이렇게 한 번에 옮깁니다. -
loss_labels: 목표 클래스 표(B, N)을 먼저 전부 ∅(번호 $K$)로 채우고, 짝이 있는 자리에만 정답 클래스를 써넣습니다. 앞의 $t_i$ 의 정의 그대로입니다. 그다음이 가중 교차 엔트로피 한 줄입니다. -
loss_boxes: 짝이 있는 예측만 골라(pred_boxes[batch_idx, query_idx]) 정답과 나란히 놓고, L1 의 합과 $1 - \GIoU$ 의 합을 각각num_boxes(배치의 객체 수)로 나눕니다. 여기서 쓰는 것은 2장의 “짝끼리” GIoU(paired_generalized_box_iou)입니다. 매칭은 모든 쌍, 손실은 짝끼리입니다. -
forward: 마지막 층의 출력으로 한 번,aux_outputs의 중간 층마다 한 번씩layer_loss를 부릅니다. 층마다 매칭을 다시 합니다. 마지막 줄이 모든 낱개 손실에 계수(1, 5, 2)를 곱해 더한 전체 손실"loss"이고, 이것 하나만 역전파합니다.
"loss" 는 디코더 세 층의 손실을 모두 더한 것입니다. 한편 "loss_ce" · "loss_bbox" · "loss_giou" 는 마지막 층만의, 계수를 곱하기 전 값입니다.
그래서 뒤의 학습 로그에서 “손실” 은 괄호 안 세 값의 가중합보다 약 3배 큽니다. 헷갈리지 마세요(확인 문제 7).
부품: 위치 인코딩 · 백본 · 인코더 층 · 디코더 층
모델의 부품들입니다. 5장에서 만든 것과 원리가 같으므로 달라진 점만 짚습니다. 코드는 접어 두었으니 펼쳐 읽으세요.
sine_embed 는 0 과 1 사이의 좌표를 사인 · 코사인 벡터로 바꾸는 함수이고, sine_position_2d 가 그것으로 $H \times W$ 격자의 위치 인코딩 (HW, D) 를 만듭니다.
식은 5장과 같습니다(좌표에 $2\pi$ 를 곱하고, 주파수는 $10000$ 의 거듭제곱으로 줄어들고, 사인과 코사인이 번갈아 나옵니다). sine_embed 를 따로 떼어 둔 것은 8장부터 박스 좌표 를 같은 방식으로 임베딩할 때 다시 쓰기 때문입니다.
3×3 합성곱 – 배치 정규화 – ReLU 묶음 6개입니다. 마지막 특징 맵의 칸 하나가 내려다보는 입력의 범위(수용 영역)는 43픽셀로, 도형 세상에서 가장 큰 도형(약 40픽셀)을 덮습니다.
디코더 층의 forward 가 앞의 표 그대로입니다. ① 자기 어텐션의 질의 · 열쇠는 tgt + query_pos, 값은 tgt. ② 교차 어텐션의 질의는 tgt + query_pos, 열쇠는 memory + pos, 값은 memory. ③ FFN.
각 단계 뒤에 잔차 연결과 층 정규화가 옵니다(post-norm). 교차 어텐션의 가중치 (B, N, HW) 도 함께 돌려주는데, 뒤에서 어텐션 지도를 그리는 데 씁니다.
어텐션 자체는 PyTorch 의 nn.MultiheadAttention 을 씁니다. 5장에서 직접 만든 것과 출력이 같음을 확인했으므로 여기서는 내장 모듈을 믿고 씁니다.
모델: MiniDETR
forward의 첫 네 줄이 그림 7-2 의 왼쪽 절반입니다. 백본 → 1×1 합성곱 →flatten(2).transpose(1, 2)로(B, HW, D)→ 인코더 층 3개.query_pos = self.query_embed.weight가 객체 질의(N, D)이고,tgt = torch.zeros(...)가 0 에서 출발하는 디코더 입력입니다.-
디코더 층을 하나 지날 때마다 그 출력을
decoder_norm→ 두 머리에 넣어 예측을 만들고 목록에 쌓습니다. 마지막 것이 본 출력, 나머지가aux_outputs(보조 손실용)입니다. 세 층이 같은decoder_norm,class_embed,bbox_embed를 씁니다. 논문의 말(예측 FFN 은 매개변수를 공유하고, 그 입력을 정규화하는 층 정규화도 공유한다)과 같습니다. self.bbox_embed(hidden).sigmoid(): 박스 머리의 출력을 시그모이드로 0 과 1 사이에 넣습니다.
매개변수 1,333,608개의 내역은 디코더 596,352, 인코더 397,440, 백본 287,456, 박스 머리 33,540, 1×1 합성곱 16,512, 객체 질의 1,536, 분류 머리 516, 마지막 층 정규화 256 입니다. 객체 질의와 머리는 전체의 3% 가 안 됩니다. DETR 의 “탐지기다움” 은 매개변수가 아니라 손실 에 들어 있다고 해도 좋습니다.
학습 고리와 후처리
train_one_epoch 가 4장의 학습 고리 5단계 그대로입니다. 순전파 → 손실(criterion) → 기울기 지우기 → 역전파 → 갱신.
하나 더 있는 것이 clip_grad_norm_(…, 0.1), 곧 기울기 전체의 크기(노름)가 0.1 을 넘으면 0.1 이 되게 줄이는 기울기 자르기입니다. 논문 부록 A.4 의 값입니다(자세한 것은 11장).
fit 은 에폭마다 손실을 기록하고, 처음 10 에폭은 매번, 그 뒤로는 5 에폭마다 검증 AP 를 잽니다(3장의 evaluate_ap 가 순수 Python 이라 느려서 매번 재지 않습니다).
앞에서 설명한 후처리가 세 줄입니다. prob[..., :-1].max(-1) 이 “∅ 칸을 뺀 최댓값과 그 자리” 입니다.
논문과 다른 점
이 장의 미니 DETR 은 논문의 DETR 을 15분 안에 학습되도록 줄인 것입니다. 원리(매칭, 손실, 구조의 짜임)는 같지만 다음이 다릅니다.
| 항목 | 이 장의 실습 | DETR 논문 | 이유 |
|---|---|---|---|
| 백본 | 3×3 합성곱 6층, 처음부터 학습, 배치 정규화도 학습 | ImageNet 으로 사전 학습한 ResNet-50, 배치 정규화는 고정 | 작은 그림 · 짧은 학습 시간 |
| 학습률 | 전체 $2 \times 10^{-4}$ | Transformer $10^{-4}$, 백본 $10^{-5}$ | 사전 학습된 백본이 아니라서 따로 낮출 이유가 없음. 작은 모델이라 2배로 잡았음($10^{-4}$ 와 견주는 실험은 하지 않았음) |
| 크기 | $D = 128$, 인코더 3 · 디코더 3층, $N = 12$, 드롭아웃 0 | $D = 256$, 6 · 6층, $N = 100$, 드롭아웃 0.1 | 작게 |
| 일정 | 배치 32, 60 에폭, 에폭 48 뒤 학습률 1/10 | 배치 64, 300 에폭(200 뒤 1/10) 또는 500 에폭(400 뒤 1/10) | 낮추는 시점의 비율(80%)은 500 에폭 일정과 같게 |
| 데이터 증강 | 없음 | 크기 바꾸기, 무작위 자르기 | 합성 데이터 |
| 위치 인코딩의 좌표 | 칸의 중심 $(c + 0.5)/W$, 벡터의 앞 절반이 $x$ · 뒤 절반이 $y$ | 5장에서 본 공개 코드 방식: 1 부터 센 번호를 $W$ 로 나눔, 앞 절반이 $y$ | 2장 · 8장의 “픽셀 중심” 좌표 규약과 맞추려고. 주파수와 사인 · 코사인의 짜임은 같고, 반 칸의 차이와 절반의 순서는 기능에 영향이 없음 |
| 패딩 마스크 | 없음 | 있음(크기가 다른 그림을 한 배치로) | 도형 세상의 그림은 크기가 모두 같음 |
| 분류 손실의 분모 | 가중치의 합 | 식 (2) 는 합, 부록은 “객체 수로 정규화” | 앞의 주의 상자 참고 |
| 매칭의 GIoU 항 | $-\GIoU$ | $1 - \GIoU$ | 상수 차이, 배정은 같음 |
같은 것도 적어 둡니다. 매칭 비용의 계수(1, 5, 2), 손실의 계수(1, 5, 2)와 ∅ 가중치 0.1, 보조 손실(층마다 다시 매칭, 머리 공유), 옵티마이저 AdamW 와 가중치 감쇠 $10^{-4}$, 기울기 자르기 0.1, Transformer 가중치의 Xavier 초기화, 디코더 입력 0 과 층마다 더하는 객체 질의, NMS 없는 후처리는 논문과 같습니다.
결과 읽기
실행
학습 데이터는 도형 세상 그림 4,000장(ShapesDataset(4000, seed=0)), 검증 데이터는 500장(seed=1, 정답 객체 1,265개)입니다.
배치 32 로 60 에폭(에폭당 125 스텝, 모두 7,500 스텝)을 학습합니다.
$ python ch07_detr.py            # 노트북 GPU 로 약 15분 (다른 작업과 GPU 를 나눠 쓰며 잰 값)
$ python ch07_detr.py --quick    # 2 에폭짜리 축소판, 오류 확인용 (CPU 로 십여 초)
맨 앞에는 앞에서 본 손계산 예의 출력이 나오고, 이어서 학습 기록이 나옵니다. 아래는 본 실행의 출력 그대로입니다. 여러분의 실행에서는 GPU 연산의 비결정성 때문에 숫자가 조금 다를 수 있습니다.
학습 4000장 · 검증 500장, 배치 32, 에폭 60 (에폭당 125 스텝), 학습률 0.0002 → 에폭 48 뒤 2e-05
MiniDETR 매개변수 1,333,608개, 객체 질의 12개
에폭   1 | 손실 12.6154 (ce 1.2969 bbox 0.2971 giou 0.7206) | 검증 AP 0.0048 AP50 0.0250 AP75 0.0002 |    19초
에폭   2 | 손실 10.1097 (ce 1.1764 bbox 0.2141 giou 0.5627) | 검증 AP 0.0140 AP50 0.0578 AP75 0.0019 |    35초
에폭   3 | 손실  8.8297 (ce 0.9631 bbox 0.1905 giou 0.5117) | 검증 AP 0.0405 AP50 0.1603 AP75 0.0075 |    54초
에폭   4 | 손실  7.0474 (ce 0.6766 bbox 0.1537 giou 0.4396) | 검증 AP 0.1456 AP50 0.4354 AP75 0.0639 |    72초
에폭   5 | 손실  5.3105 (ce 0.4792 bbox 0.1119 giou 0.3541) | 검증 AP 0.1915 AP50 0.5406 AP75 0.0706 |    91초
에폭   6 | 손실  4.1738 (ce 0.3691 bbox 0.0853 giou 0.2896) | 검증 AP 0.3426 AP50 0.7499 AP75 0.2352 |   111초
에폭   7 | 손실  3.6388 (ce 0.3052 bbox 0.0747 giou 0.2617) | 검증 AP 0.4193 AP50 0.8290 AP75 0.3580 |   130초
에폭   8 | 손실  3.1404 (ce 0.2531 bbox 0.0637 giou 0.2308) | 검증 AP 0.4669 AP50 0.8717 AP75 0.4399 |   148초
에폭   9 | 손실  2.8969 (ce 0.2171 bbox 0.0602 giou 0.2189) | 검증 AP 0.5264 AP50 0.9187 AP75 0.5359 |   168초
에폭  10 | 손실  2.6690 (ce 0.1904 bbox 0.0565 giou 0.2052) | 검증 AP 0.5788 AP50 0.9294 AP75 0.6682 |   186초
에폭  15 | 손실  1.9690 (ce 0.0971 bbox 0.0437 giou 0.1650) | 검증 AP 0.6327 AP50 0.9637 AP75 0.7393 |   240초
에폭  20 | 손실  1.6111 (ce 0.0532 bbox 0.0371 giou 0.1427) | 검증 AP 0.7039 AP50 0.9756 AP75 0.8523 |   283초
에폭  25 | 손실  1.3062 (ce 0.0279 bbox 0.0310 giou 0.1200) | 검증 AP 0.7081 AP50 0.9853 AP75 0.8592 |   362초
에폭  30 | 손실  1.1662 (ce 0.0174 bbox 0.0282 giou 0.1089) | 검증 AP 0.7576 AP50 0.9836 AP75 0.9104 |   440초
에폭  35 | 손실  1.0231 (ce 0.0128 bbox 0.0243 giou 0.0979) | 검증 AP 0.7381 AP50 0.9848 AP75 0.9078 |   516초
에폭  40 | 손실  0.9763 (ce 0.0090 bbox 0.0233 giou 0.0958) | 검증 AP 0.7358 AP50 0.9868 AP75 0.9080 |   586초
에폭  45 | 손실  0.9123 (ce 0.0067 bbox 0.0222 giou 0.0892) | 검증 AP 0.7923 AP50 0.9895 AP75 0.9315 |   652초
에폭  50 | 손실  0.5119 (ce 0.0029 bbox 0.0123 giou 0.0470) | 검증 AP 0.8386 AP50 0.9865 AP75 0.9549 |   703초
에폭  55 | 손실  0.4543 (ce 0.0016 bbox 0.0111 giou 0.0414) | 검증 AP 0.8381 AP50 0.9862 AP75 0.9514 |   754초
에폭  60 | 손실  0.4232 (ce 0.0011 bbox 0.0104 giou 0.0383) | 검증 AP 0.8375 AP50 0.9863 AP75 0.9500 |   845초
학습 끝: 845초
검증 AP 가 처음 0.5 이상이 된 에폭(채점한 에폭 가운데): 9
검증 AP 가 처음 0.8 이상이 된 에폭(채점한 에폭 가운데): 50
검증 AP 가 처음 0.9 이상이 된 에폭(채점한 에폭 가운데): 도달하지 못함
ch07_detr.pt · ch07_history.json 저장

[최종] 검증 AP 0.8375, AP50 0.9863, AP75 0.9500, 클래스별 AP circle 0.8741, rectangle 0.8010, triangle 0.8374
줄마다 “손실” 은 세 디코더 층의 합(역전파한 값), 괄호 안은 마지막 층의 낱개 손실, 그 뒤가 3장의 채점기로 잰 검증 AP 입니다. AP 는 처음 10 에폭은 매번, 그 뒤로는 5 에폭마다 쟀으므로 로그에 없는 에폭이 있습니다. 최종 성적은 AP 0.8375, AP50 0.9863, AP75 0.9500 입니다. 앵커도 NMS 도 없는 130만 매개변수짜리 모델이, 헝가리안 매칭과 집합 손실만으로 도형을 거의 다 찾습니다. 클래스별로는 사각형이 0.8010 으로 가장 낮은데, 그 원인은 따로 분석하지 않았습니다.
학습 곡선
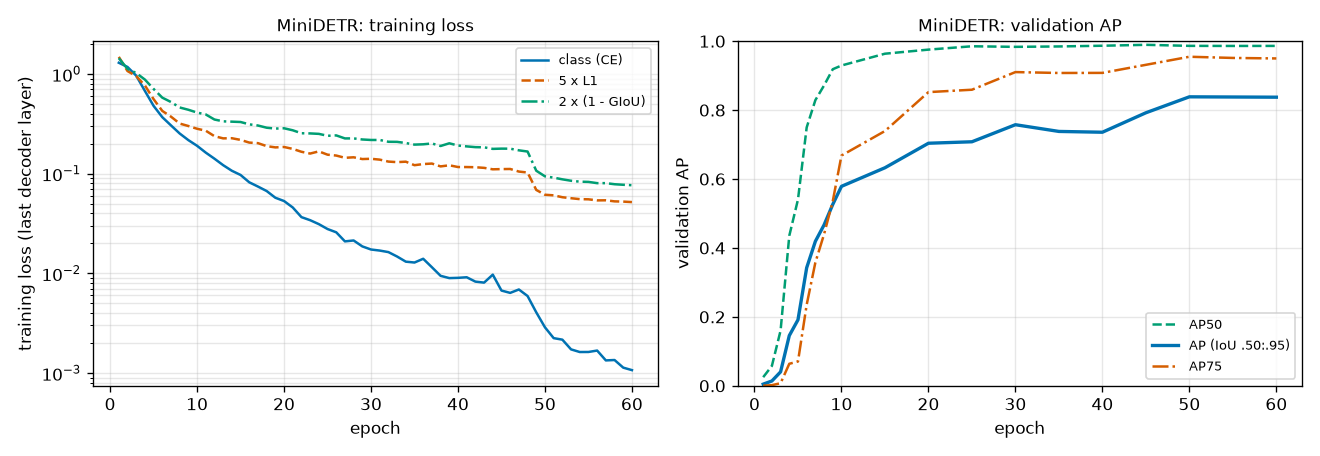
이 그림에서 읽을 것은 넷입니다.
- 처음 세 에폭의 정체. 검증 AP 가 0.0048 → 0.0140 → 0.0405 로 거의 바닥입니다. 손실은 12.6 → 10.1 → 8.8 로 줄고 있는데 AP 는 따라오지 않다가, 4 에폭에 0.1456, 6 에폭에 0.3426 으로 갑자기 오르기 시작합니다. 학습 초기에는 예측이 거의 무작위여서 매칭이 스텝마다 크게 달라지고(같은 객체를 맡는 질의가 계속 바뀝니다), 교차 어텐션도 아직 어디를 볼지 모릅니다. 이 실험에서 매칭이 얼마나 바뀌는지를 직접 재지는 않았으므로 이것은 가능한 설명으로만 적어 둡니다.
- AP50 은 빨리, AP75 는 천천히. AP50 은 10 에폭에 벌써 0.9294 입니다. 같은 때 AP75 는 0.6682 이고, 20 에폭에 0.8523, 30 에폭에 0.9104, 50 에폭에 0.9549 로 수십 에폭에 걸쳐 오릅니다. 3장에서 배운 대로 AP50 은 “IoU 0.5 만 넘으면 맞힌 것” 이고 AP75 는 “0.75 를 넘어야 맞힌 것” 입니다. 객체를 대강 찾기는 금방 배우지만, 박스를 정확히 맞추는 데는 오래 걸립니다. 왼쪽 그림도 같은 이야기를 합니다. 분류 손실(파란 선)은 가파르게 떨어져 끝에는 0.001 까지 가지만, 박스 손실 두 항은 훨씬 느리게 줄어 끝에는 손실의 거의 전부를 차지합니다.
- 학습률을 낮춘 자리의 계단. 48 에폭 뒤에 학습률을 10분의 1 로 낮추자 손실이 계단처럼 떨어지고(45 에폭 0.9123 → 50 에폭 0.5119), AP 가 0.7923 에서 0.8386 으로 오릅니다. 큰 학습률로는 정답 근처에서 왔다 갔다 하던 박스가, 작은 학습률에서 자리를 잡는 것입니다.
- 출렁임. AP 가 30 에폭 0.7576 에서 35 에폭 0.7381, 40 에폭 0.7358 로 조금 내려갔다가 다시 오릅니다. 시드 하나, 5 에폭 간격으로 잰 값이므로 이 정도의 오르내림에 뜻을 두기는 어렵습니다.
AP 가 0.84 에서 멈춘 것도 짚어 둡니다. AP50 이 0.986 이므로 객체는 거의 다 찾습니다. AP 는 IoU 문턱값 0.50 부터 0.95 까지 열 개의 평균이어서(3장), 0.90 · 0.95 같은 엄격한 문턱값에서 깎입니다. 96픽셀 그림에서 그런 IoU 를 넘으려면 박스의 변이 한두 픽셀 안으로 맞아야 합니다.
예측 그림
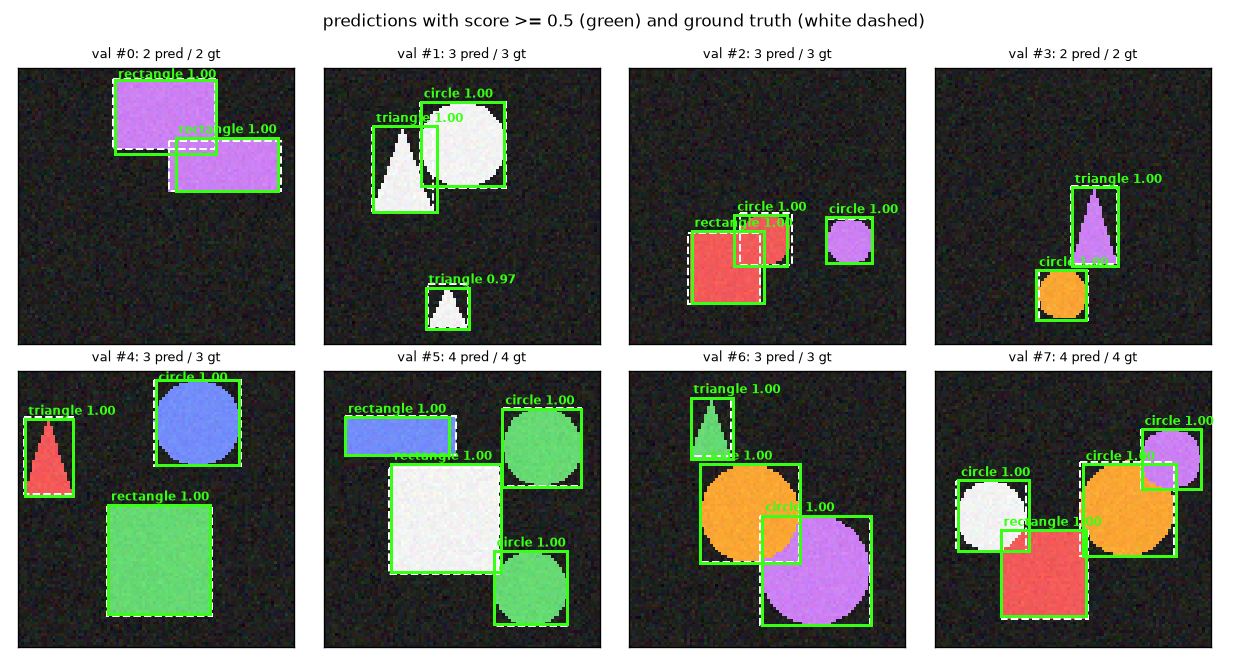
- 여덟 장 모두 예측 수와 정답 수가 같고, 초록 실선이 흰 점선과 거의 겹칩니다. 점수는 대부분 1.00 이고 1번 그림의 작은 삼각형만 0.97 입니다.
- 도형이 서로 겹친 그림(2번, 6번, 7번)에서도 객체마다 박스가 하나씩입니다. NMS 가 없는데도 같은 객체에 초록 박스가 두 개 겹쳐 있는 곳이 없습니다.
- 다만 이 여덟 장이 전부는 아닙니다. 검증 500장 가운데 점수 0.5 이상인 예측 수가 정답 수와 같은 그림은 443장 이고, 57장은 다릅니다. “언제나 맞는다” 가 아니라 “대부분 맞는다” 입니다.
질의의 전문화
객체 질의는 그림과 무관한 고정된 벡터 12개입니다. 학습이 끝난 뒤 질의마다 무엇을 맡게 되었을까요? 검증 500장 전체에서 질의마다 낸 박스의 중심 을 점으로 찍어 봅니다. 논문의 그림 7 과 같은 종류의 그림입니다.
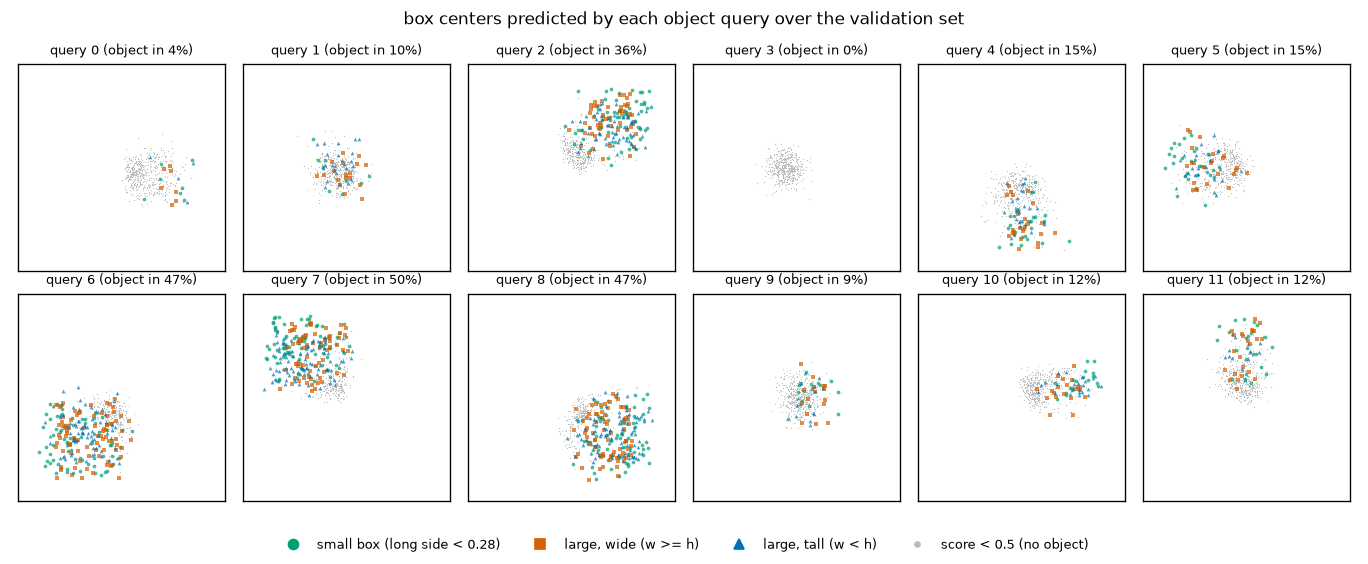
[질의의 전문화] 질의별로: 점수≥0.5 로 '객체가 있다' 고 답한 그림의 비율, 그때 낸 박스의 평균(± 표준편차)
질의 | 쓰인 비율 | 중심 x        중심 y        | 너비          높이
  0  |   0.04    | 0.75 ± 0.07   0.57 ± 0.08  | 0.26 ± 0.08   0.27 ± 0.06
  1  |   0.10    | 0.47 ± 0.07   0.50 ± 0.07  | 0.30 ± 0.07   0.29 ± 0.08
  2  |   0.36    | 0.70 ± 0.09   0.29 ± 0.08  | 0.28 ± 0.08   0.28 ± 0.08
  3  |   0.00    | (거의 쓰이지 않음)
  4  |   0.15    | 0.51 ± 0.06   0.74 ± 0.09  | 0.27 ± 0.08   0.27 ± 0.07
  5  |   0.15    | 0.28 ± 0.09   0.49 ± 0.08  | 0.27 ± 0.08   0.27 ± 0.08
  6  |   0.47    | 0.32 ± 0.10   0.69 ± 0.10  | 0.29 ± 0.08   0.28 ± 0.08
  7  |   0.50    | 0.30 ± 0.10   0.29 ± 0.09  | 0.27 ± 0.08   0.28 ± 0.08
  8  |   0.47    | 0.70 ± 0.09   0.68 ± 0.10  | 0.28 ± 0.08   0.28 ± 0.08
  9  |   0.09    | 0.57 ± 0.06   0.49 ± 0.08  | 0.27 ± 0.09   0.28 ± 0.08
 10  |   0.12    | 0.74 ± 0.08   0.44 ± 0.05  | 0.27 ± 0.08   0.29 ± 0.08
 11  |   0.12    | 0.49 ± 0.06   0.27 ± 0.09  | 0.27 ± 0.08   0.26 ± 0.08
그림마다 점수≥0.5 인 예측 수가 정답 객체 수와 같은 그림: 443 / 500장
- 질의마다 맡는 위치가 다릅니다. 질의 7 은 왼쪽 위(중심 0.30, 0.29), 질의 2 는 오른쪽 위(0.70, 0.29), 질의 6 은 왼쪽 아래(0.32, 0.69), 질의 8 은 오른쪽 아래(0.70, 0.68)입니다($y$ 는 아래로 갈수록 커집니다). 이 넷이 그림의 네 구역을 나누어 맡아 36 – 50% 의 그림에서 쓰이고, 가운데와 변 쪽을 맡은 질의들(1, 4, 5, 9, 10, 11)은 9 – 15% 의 그림에서 쓰입니다. 누구도 “너는 왼쪽 위” 라고 정해 주지 않았습니다. 일대일 매칭 아래에서 손실을 줄이다 보니 질의들이 스스로 구역을 나눈 것입니다. 손으로 만들던 앵커의 구실을 학습이 대신한 셈입니다.
- 크기별 전문화는 보이지 않습니다. 논문은 COCO 에서 슬롯마다 맡는 영역과 박스 크기 가 다르다고 보고합니다. 이 실험에서는 칸마다 세 가지 색이 섞여 있고, 표의 평균 너비 · 높이도 질의마다 0.26 – 0.30 으로 거의 같습니다. 위치의 전문화만 확인되었습니다. 도형 세상의 객체 크기가 COCO 처럼 다양하지 않은 것이 한 이유일 수 있지만 확인하지는 않았습니다.
- 안 쓰이는 질의가 있습니다. 질의 3 은 500장에서 한 번도 점수 0.5 를 넘지 않았고(0%), 질의 0 은 4% 뿐입니다. 그림당 객체가 많아야 4개인데 질의가 12개이니 남는 것이 당연합니다. 쓰인 비율을 모두 더하면 2.57 로, 그림당 평균 객체 수 2.53 과 거의 같습니다.
- 회색 점(∅ 라고 답한 그림에서의 박스)도 질의마다 한곳에 모여 있습니다. 짝이 없는 질의의 박스에는 손실이 없으므로, 객체가 없을 때는 그 질의의 “기본 자리” 근처에 박스가 머뭅니다.
교차 어텐션 지도
질의가 그림의 어디를 보고 박스를 내는지도 볼 수 있습니다. 검증 그림 1번(객체 3개)에서 점수 0.5 이상인 질의 셋의 마지막 디코더 층 교차 어텐션 가중치 를 그렸습니다. 질의 하나의 가중치는 그림 토큰 144개에 걸친 확률 분포(합 1)이므로 $12 \times 12$ 지도로 그릴 수 있습니다(머리 8개의 평균입니다).
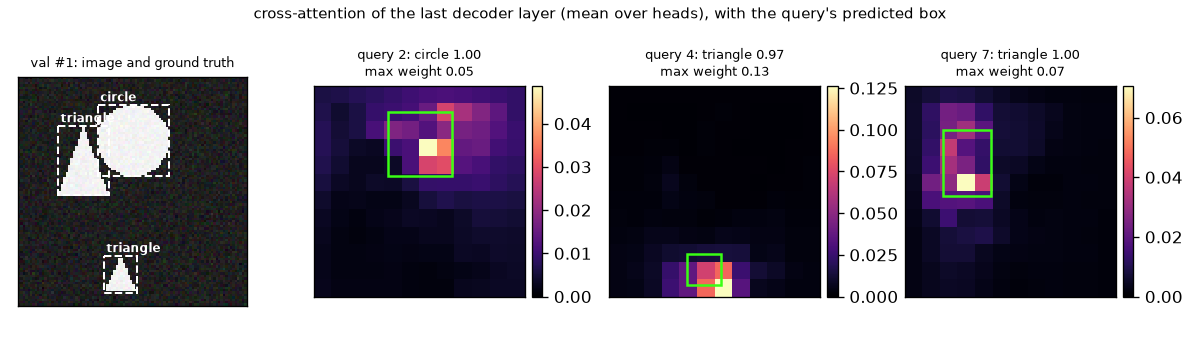
[교차 어텐션] 검증 그림 #1: 점수≥0.5 인 질의 [2, 4, 7]. 지도는 144칸에 걸친 확률 분포(합 1)이고, 칸마다 고르게 보면 1/144 = 0.0069
  질의 2: 가장 큰 가중치 0.049, 상위 5칸의 합 0.171
  질의 4: 가장 큰 가중치 0.126, 상위 5칸의 합 0.406
  질의 7: 가장 큰 가중치 0.071, 상위 5칸의 합 0.210
- 질의마다 자기 객체 근처를 봅니다. 질의 2 는 위쪽의 원, 질의 4 는 아래의 작은 삼각형, 질의 7 은 왼쪽 위의 삼각형 근처가 밝습니다. 앞의 표에서 본 구역(질의 2 는 오른쪽 위, 질의 4 는 아래 가운데, 질의 7 은 왼쪽 위)과 맞습니다.
- 고르게 보는 것보다 훨씬 몰려 있습니다. 144칸을 고르게 보면 칸마다 0.0069 인데, 가장 큰 가중치가 0.049 – 0.126 으로 그 7 – 18배입니다. 상위 5칸이 가중치의 17 – 41% 를 차지합니다.
- 박스 전체를 고르게 덮지는 않습니다. 밝은 칸은 박스 안팎의 몇 칸에 몰려 있고, 질의 4 와 7 에서는 가장 밝은 칸이 박스의 아래쪽 가장자리에 있습니다. 논문도 디코더의 어텐션이 꽤 국소적이고 주로 객체의 끝부분(머리나 다리 같은)을 본다고 관찰하며, 인코더가 객체들을 이미 떼어 놓았으므로 디코더는 경계를 읽어 내기만 하면 되는 것 같다는 가설을 적습니다. 우리 그림은 한 장뿐이므로 “같은 종류의 모습이 보인다” 까지만 말할 수 있습니다.
디코더 층별 AP 와 NMS 실험
이제 3장에서 예고한 실험입니다. 학습한 DETR 의 출력에 3장의 nms 를 걸어 정말로 필요 없는지 봅니다. 보조 손실 덕분에 디코더의 모든 층에서 예측이 나오므로, 층마다 다음을 잽니다.
- 그 층의 예측으로 잰 AP, 그리고 클래스별 NMS(IoU 문턱값 0.5)를 건 뒤의 AP
- 점수 0.5 이상인 예측의 수
- 그 예측들 가운데 서로 IoU 가 0.5 를 넘게 겹치는 쌍 의 수. 도형 세상은 정답끼리의 IoU 가 0.2 를 넘지 않게 만들어져 있으므로, 이런 쌍은 한 객체를 두 번 가리킨 것(중복 예측)입니다.
[디코더 층별 예측과 중복]
디코더 층 | AP     AP50   AP75  | NMS 뒤 AP  AP50  | 점수≥0.5 예측 수 | 그중 IoU>0.5 로 겹치는 쌍
    1     | 0.8067 0.9742 0.9197 | 0.8082  0.9878 |     1367         |    153
    2     | 0.8365 0.9872 0.9536 | 0.8335  0.9893 |     1305         |     55
    3     | 0.8375 0.9863 0.9500 | 0.8359  0.9884 |     1290         |     45
검증 정답 객체 수 1265개. 마지막 층: 점수≥0.5 예측 1290개, 겹치는 쌍 45개, NMS 전후 AP 차이 -0.0016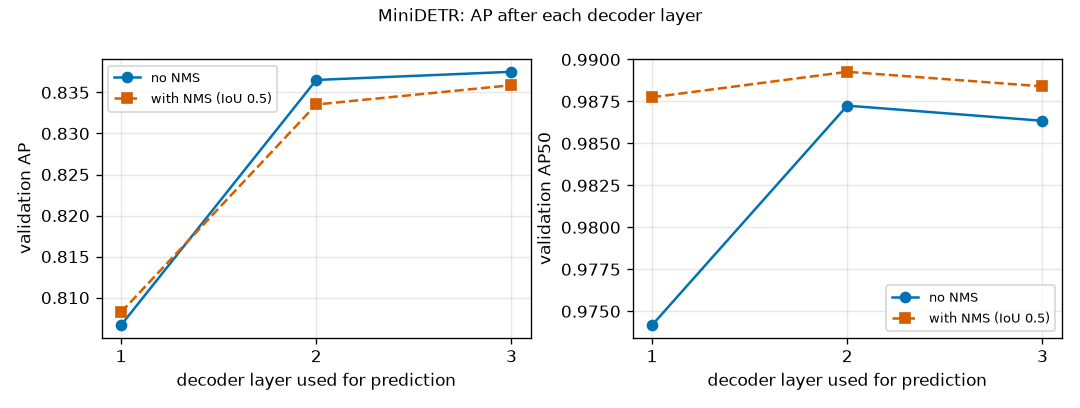
표와 그림에서 읽을 것은 다음과 같습니다.
- 마지막 층: NMS 의 이득이 없습니다. NMS 를 걸면 AP 는 0.8375 → 0.8359 로 0.0016 내려가고, AP50 은 0.9863 → 0.9884 로 0.0021 오릅니다. 사실상 변화가 없습니다. 3장의 실험에서 중복이 많은 예측에 NMS 를 걸었을 때 AP 가 크게 오르던 것과 견주면, 이 모델의 출력에는 NMS 가 지워서 이득을 볼 중복이 거의 없다는 뜻입니다.
- 그렇다고 중복이 0 은 아닙니다. 마지막 층에서 점수 0.5 이상인 예측은 1,290개로 정답 1,265개보다 25개 많고, 서로 겹치는 쌍이 45개 있습니다. 객체 1,265개 가운데 약 3.6% 꼴입니다. “DETR 은 중복을 전혀 내지 않는다” 가 아니라 “NMS 없이도 중복이 드물고, NMS 를 걸어도 얻을 것이 없다” 가 이 실험이 보여 주는 것입니다.
- 첫 층은 중복이 많습니다. 첫 층의 출력에는 겹치는 쌍이 153개(객체의 약 12%)이고, NMS 가 AP50 을 0.9742 → 0.9878 로 0.0136 올립니다. 층을 지나며 겹치는 쌍은 153 → 55 → 45 로 줄고, NMS 의 AP50 이득도 +0.0136 → +0.0021 → +0.0021 로 줄어듭니다. 앞의 참고 상자에서 본 대로 첫 층의 질의들은 그림을 본 뒤에 서로 이야기할 기회가 없었습니다. 둘째 층부터 자기 어텐션으로 조율하면서 중복이 줄어듭니다.
- 보조 손실의 효과. 첫 층의 출력만으로도 AP 0.8067 이 나옵니다. 층을 더 지나면 0.8365, 0.8375 로 오릅니다. “디코더 층을 덜 쓰면 조금 덜 정확하고 더 빠른 모델” 이 실제로 얻어집니다.
이 모습은 DETR 논문이 COCO 에서 보고한 것(논문 그림 4)과 방향이 같습니다. 논문에 따르면 NMS 는 첫 디코더 층의 예측에서는 성능을 올리지만 층이 깊어질수록 이득이 줄고, 마지막 층들에서는 참 양성을 잘못 지워 AP 가 조금 내려갑니다. 다만 크기는 섞어 읽으면 안 됩니다. 논문은 6층 디코더에서 첫 층과 마지막 층의 AP 차이가 8.2 라고 보고하지만, 이 장의 3층 미니 모델에서는 0.03 입니다. 또 우리의 차이 가운데 ±0.002 수준의 것(둘째 · 셋째 층의 NMS 전후)은 시드 하나로 잰 값이라 우연의 범위일 수 있습니다.
NMS 는 겹친 예측 가운데 점수가 높은 쪽 을 남깁니다. 그런데 점수가 높은 쪽이 꼭 박스가 더 정확한 쪽은 아닙니다. 덜 정확한 박스가 남으면 IoU 0.5 기준(AP50)으로는 여전히 맞지만 엄격한 문턱값에서는 틀리게 되어, AP50 은 오르고 AP 는 내려가는 일이 생길 수 있습니다. 이 실험에서 실제로 그런 예측이 몇 개였는지는 세지 않았으므로 가능한 설명으로만 적어 둡니다.
논문의 느린 수렴과 이 실험
DETR 은 “학습이 느리다” 는 것으로 유명합니다. 논문이 보고한 숫자는 이렇습니다.
- DETR 논문: COCO(학습 그림 약 11만 8천 장)에서 절제 실험은 300 에폭(V100 GPU 16대로 3일), Faster R-CNN 과 견주는 본 실험은 500 에폭 을 학습했고, 500 에폭 일정이 300 에폭보다 AP 가 1.5 높았습니다. 논문 스스로 “아주 긴 학습 일정이 필요하다” 고 적습니다.
- Deformable DETR 논문: DETR 은 COCO 에서 수렴하는 데 500 에폭이 필요하고, 이는 Faster R-CNN 보다 10 – 20배 느린 것이라고 지적합니다.
이 장의 실험은 그 느림을 재현하지 못합니다. 미니 DETR 은 9 에폭에 AP 0.5 를 넘고 60 에폭(7,500 스텝)에 0.84 에 이릅니다. 기대와 다른 결과이므로 그대로 적어 둡니다. 왜 다를 수 있는지 생각해 볼 만한 점은 다음과 같습니다(따로 실험해 확인한 것은 아닙니다).
- 볼 곳이 적습니다. 교차 어텐션이 훑어야 하는 그림 토큰이 144개뿐입니다. 논문의 설정에서는 그림 한 장이 스트라이드 32 로도 천 개 안팎의 토큰이 됩니다(예를 들어 $800 \times 1216$ 픽셀이면 $25 \times 38 = 950$ 개).
- 문제가 쉽습니다. 배경은 어둡고 단순하며, 도형은 그림에 비해 크고, 클래스는 3개, 객체는 많아야 4개, 질의는 12개입니다.
- “에폭” 의 크기가 다릅니다. 우리의 1 에폭은 125 스텝입니다. 논문의 500 에폭은 배치 64 로 약 92만 스텝($118{,}000 \times 500 / 64$)입니다.
그래도 느린 모습의 흔적은 두 군데에서 보았습니다. 처음 세 에폭의 정체(AP 0.05 미만)와, AP50 이 다 오른 뒤에도 AP75 · AP 가 수십 에폭에 걸쳐 천천히 오르는 것 입니다. “느리다” 는 말은 늘 무엇과 견주어서입니다. 8장에서 Deformable DETR 을 같은 데이터, 같은 학습 고리 로 학습해 이 곡선 위에 겹쳐 그립니다. 그때 이 장의 곡선이 느린 쪽이었는지 판단할 수 있습니다.
DETR 의 한계
DETR 은 탐지의 틀을 바꾸었지만 그대로는 쓰기 어려운 모델이었습니다. 논문 스스로 결론에서 “학습, 최적화, 작은 객체에서의 성능” 을 새로 생긴 과제로 꼽았고, 같은 해에 나온 Deformable DETR 논문이 그 원인을 구조에서 짚었습니다. 정리하면 셋입니다.
- 느린 수렴. 위에서 본 대로 COCO 에서 500 에폭입니다. Deformable DETR 논문의 진단은 이렇습니다. 초기화 직후의 어텐션은 특징 맵의 모든 칸에 거의 같은 가중치를 주고, 그 가중치가 드문드문 있는 의미 있는 자리에 모이도록 배우는 데 긴 학습이 필요하다는 것입니다. 이 장의 실험에서 학습이 끝난 뒤의 교차 어텐션이 고른 값(0.0069)의 7 – 18배로 몰려 있던 것이 그 “배운 뒤” 의 모습입니다.
- 작은 객체에 약함. 논문 표 1(COCO)에서 DETR 과 Faster R-CNN-FPN+ 는 AP 가 42.0 으로 같지만, 작은 객체의 APS 는 DETR 20.5 대 Faster R-CNN 26.6 으로 DETR 이 낮고, 큰 객체의 APL 은 61.1 대 53.4 로 DETR 이 높습니다. 작은 객체를 찾으려면 해상도가 높은 특징 맵이 필요한데, DETR 은 스트라이드 32 의 거친 특징 맵 한 장만 씁니다.
- 인코더의 제곱 비용. 그렇다면 특징 맵의 해상도를 올리면 되지 않을까요? 인코더의 자기 어텐션은 모든 토큰이 모든 토큰을 보므로 비용이 토큰 수의 제곱 으로 늡니다(5장). 미니 모델은 $144^2 = 20{,}736$ 쌍이지만, 토큰이 950개면 $950^2 = 902{,}500$ 쌍이고, 해상도를 가로 · 세로 2배로 올리면 토큰이 4배, 쌍은 16배인 $14{,}440{,}000$ 이 됩니다. DETR 논문도 해상도를 2배로 올린 변형(DETR-DC5)에서 인코더 자기 어텐션의 비용이 16배가 되고 전체 계산량이 2배가 되었다고 적습니다. 작은 객체를 위해 해상도를 올리기가 어려운 구조입니다.
세 한계의 뿌리는 하나입니다. 어텐션이 그림의 모든 칸을 본다 는 것입니다. 모든 칸을 보니 어디를 볼지 배우는 데 오래 걸리고, 모든 칸을 보니 칸이 늘면 비용이 감당할 수 없이 커집니다. 다음 장의 Deformable DETR 은 “모든 칸” 을 “필요한 몇 군데” 로 바꾸어 이 셋을 한꺼번에 덜어 냅니다. 이 장에서 만든 매칭과 손실은 거의 그대로 가져갑니다.
- DETR 은 탐지를 집합 예측으로 본다. 고정된 $N$ 개의 슬롯(객체 질의)이 각각 (클래스, 박스) 하나를 내고, 남는 슬롯은 “객체 없음(∅)” 이라고 답한다. 출력은
(B, N, K+1)과(B, N, 4). - 예측과 정답은 순서 없는 집합이므로, 손실을 계산하기 전에 비용 행렬 $C$ $(N, T)$ 에서 총비용이 최소인 일대일 배정 $\hat{\sigma}$ 를 찾는다(이분 매칭). 배정은 $N!/(N-T)!$ 가지라 전부 해 볼 수 없고, 헝가리안 알고리즘 계열(
linear_sum_assignment)이 정확한 최적을 빠르게 찾는다. 탐욕 배정은 최적이 아닐 수 있다. - 매칭 비용은 $C_{ij} = -\hat{p}_i(c_j) + 5\,\lVert \hat{b}_i - b_j \rVert_1 - 2\,\GIoU(\hat{b}_i, b_j)$. 클래스 항에 로그가 아닌 확률을 써서 박스 항과 크기를 맞춘다. 매칭은 번호만 정하므로 기울기가 없다.
- 집합 손실은 모든 질의의 교차 엔트로피(짝이 있으면 정답 클래스, 없으면 ∅, ∅ 의 가중치 0.1) + 짝이 있는 질의의 박스 손실($5 \cdot \text{L1} + 2 \cdot (1 - \GIoU)$, 배치의 객체 수로 나눔)이다.
- 일대일 매칭에서는 한 객체를 두 질의가 가리키면 하나는 반드시 ∅ 를 맞혀야 하는 벌을 받는다. 질의들이 디코더의 자기 어텐션으로 서로를 보고 조율하므로 중복 예측이 줄고, NMS 가 필요 없어진다.
- 구조는 CNN 백본 → 1×1 합성곱 → 펴기 + 2차원 사인 위치 인코딩 → 인코더 → 디코더(자기 어텐션 → 교차 어텐션 → FFN) → 분류 머리 · 박스 머리(시그모이드). 객체 질의는 학습되는 위치 임베딩이고, 디코더 입력은 0 이며, $N$ 개가 병렬로 나온다.
- 보조 손실은 모든 디코더 층의 출력에 같은 머리로 같은 손실을 건다(층마다 다시 매칭). 그래서 어느 층에서 멈추어도 예측이 나오고, RF-DETR 이 추론 때 디코더 층을 떼어 낼 수 있는 근거가 된다.
- 이 장의 실험에서 미니 DETR 은 60 에폭에 AP 0.8375(AP50 0.9863)에 이르렀다. 질의들은 위치별로 구역을 나누어 맡았고(크기별 전문화는 보이지 않았다), 마지막 층의 출력에 NMS 를 걸어도 AP 는 0.0016 내려갈 뿐 이득이 없었다. 중복은 0 이 아니라 드물었다(겹치는 쌍 45개, 첫 층은 153개).
- 이 작은 데이터에서는 논문이 COCO 에서 보고한 느린 수렴(500 에폭)이 재현되지 않았다. 흔적은 처음 세 에폭의 정체와 느리게 오르는 AP75 에서만 보였다.
- DETR 의 한계는 느린 수렴, 작은 객체, 인코더의 제곱 비용이고, 모두 “어텐션이 모든 칸을 본다” 에서 나온다.
확인 문제
예측 3개, 정답 2개의 비용 행렬이 다음과 같습니다(행 = 예측 0, 1, 2 / 열 = 정답 0, 1).
$$ C = \begin{pmatrix} 1 & 2 \\ 2 & 6 \\ 5 & 4 \end{pmatrix} $$(가) 배정은 모두 몇 가지입니까? (나) 모든 배정의 총비용을 구해 최적 배정을 찾으세요. (다) 정답 0 부터 차례로 고르는 탐욕 배정의 총비용은 얼마입니까?
답 보기
(가) $3!/(3-2)! = 3 \times 2 = 6$ 가지.
(나) (정답 0 의 짝, 정답 1 의 짝) 으로 적으면 $(0,1)$: $1 + 6 = 7$, $(0,2)$: $1 + 4 = 5$, $(1,0)$: $2 + 2 = 4$, $(1,2)$: $2 + 4 = 6$, $(2,0)$: $5 + 2 = 7$, $(2,1)$: $5 + 6 = 11$. 최적은 $(1, 0)$, 곧 정답 0 ↔ 예측 1, 정답 1 ↔ 예측 0 이고 총비용 4 입니다. 예측 2 는 ∅ 를 배웁니다.
(다) 정답 0 은 가장 싼 예측 0(비용 1)을 가져가고, 정답 1 은 남은 예측 1(6)과 예측 2(4) 가운데 예측 2 를 고릅니다. 총비용 $1 + 4 = 5$ 로 최적보다 1 큽니다. 본문의 예와 같은 꼴입니다. 예측 0 은 두 정답 모두에 쓸 만하므로 정답 1 에게 양보하는 편이 낫습니다.
RF-DETR 의 탐지 모델은 질의를 300개 씁니다. 객체가 5개인 그림에서 가능한 배정은 몇 가지입니까? 1초에 $10^{9}$ 가지를 계산한다면 전부 해 보는 데 얼마나 걸립니까?
답 보기
$300 \times 299 \times 298 \times 297 \times 296 = 2{,}349{,}940{,}507{,}200 \approx 2.35 \times 10^{12}$ 가지. $2.35 \times 10^{12} / 10^{9} \approx 2{,}350$ 초, 약 39분입니다. 객체가 고작 5개인 그림 한 장, 한 스텝의 매칭에 그만큼 걸리므로 무차별 탐색은 쓸 수 없습니다.
예측의 박스가 $(0.50, 0.50, 0.20, 0.20)$, 정답의 박스가 $(0.55, 0.50, 0.20, 0.20)$ 이고, 예측이 정답 클래스에 준 확률이 0.8 입니다. DETR 의 매칭 비용(계수 1, 5, 2)을 구하세요.
답 보기
클래스 항: $-0.8$. L1: $|0.50 - 0.55| + 0 + 0 + 0 = 0.05$.
모서리 표현은 예측 $(0.40, 0.40, 0.60, 0.60)$, 정답 $(0.45, 0.40, 0.65, 0.60)$. 교집합 $(0.60 - 0.45) \times (0.60 - 0.40) = 0.15 \times 0.20 = 0.03$, 합집합 $0.04 + 0.04 - 0.03 = 0.05$, $\IoU = 0.6$. 둘러싸는 박스는 $(0.65 - 0.40) \times 0.20 = 0.05$ 로 합집합과 같아서(옆으로만 밀렸으므로 빈 곳이 없습니다) $\GIoU = 0.6 - 0 = 0.6$.
$C = -0.8 + 5 \times 0.05 - 2 \times 0.6 = -0.8 + 0.25 - 1.2 = -1.75$.
질의가 3개, 정답이 1개(사각형)인 그림 한 장입니다. 매칭 결과 질의 0 이 정답의 짝이 되었습니다. 질의 0 은 사각형에 확률 0.5 를 주었고, 짝과의 L1 거리는 0.10, GIoU 는 0.70 입니다. 질의 1 과 2 는 ∅ 에 각각 0.9 와 0.6 을 주었습니다. 이 장의 구현대로 $\mathcal{L}_{\text{cls}}$, $\mathcal{L}_{\text{L1}}$, $\mathcal{L}_{\GIoU}$ 와 전체 손실을 구하세요. ($-\log 0.5 = 0.6931$, $-\log 0.9 = 0.1054$, $-\log 0.6 = 0.5108$)
답 보기
분류: 가중치를 곱한 합은 $1 \times 0.6931 + 0.1 \times 0.1054 + 0.1 \times 0.5108 = 0.6931 + 0.0105 + 0.0511 = 0.7547$, 가중치의 합은 $1 + 0.1 + 0.1 = 1.2$. $\mathcal{L}_{\text{cls}} = 0.7547 / 1.2 = 0.6289$.
박스: 객체가 1개이므로 $\mathcal{L}_{\text{L1}} = 0.10 / 1 = 0.10$, $\mathcal{L}_{\GIoU} = (1 - 0.70) / 1 = 0.30$.
전체: $0.6289 + 5 \times 0.10 + 2 \times 0.30 = 0.6289 + 0.5 + 0.6 = 1.7289$. 질의 1 과 2 의 박스는 어디에도 쓰이지 않았습니다.
본문의 $4 \times 3$ 비용 행렬에 대해 답하세요. (가) 모든 칸에 2 를 더하면 최적 배정이 바뀝니까? (나) 정답 1 의 열 전체에 10 을 더하면? (다) 예측 0 의 행 전체에 10 을 더하면?
답 보기
(가) 바뀌지 않습니다. 어떤 배정이든 세 칸을 쓰므로 모든 배정의 총비용이 똑같이 6 늘어납니다. 논문의 $1 - \GIoU$ 와 코드의 $-\GIoU$ 가 같은 배정을 내는 까닭입니다.
(나) 바뀌지 않습니다. 어떤 배정이든 정답 1 의 열에서 정확히 한 칸을 쓰므로 모두 10 씩 늘어납니다.
(다) 바뀝니다. 예측이 정답보다 많아서 예측 0 을 쓰지 않는 배정이 있고, 그런 배정의 총비용은 그대로이기 때문입니다. 본문의 표에서 예측 0 을 쓰지 않는 배정 가운데 가장 좋은 것은 $(1, 3, 2)$ 의 0.1237 이고, 예측 0 을 쓰는 배정은 모두 10 이 늘어 가장 좋은 것이 $-1.9587 + 10 = 8.0413$ 이 됩니다. 새 최적 배정은 $(1, 3, 2)$ 입니다. 직사각형 행렬에서는 열에서 빼는 것만 안전하다고 한 이유입니다.
삼각형 하나에 질의 A 와 B 가 거의 같은 박스를 냈습니다. A 는 삼각형에 0.95, B 는 삼각형에 0.75 · ∅ 에 0.20 을 주었습니다. 매칭은 A 를 짝으로 골랐습니다. (가) B 의 목표 클래스는 무엇이고, B 가 분류 손실의 분자에 보태는 값은 얼마입니까? ($-\log 0.2 = 1.609$) (나) B 의 박스는 어떤 손실을 받습니까? (다) 질의들 사이의 자기 어텐션이 없다면 무엇이 어려워집니까?
답 보기
(가) 목표는 ∅ 입니다. $0.1 \times (-\log 0.2) = 0.1 \times 1.609 = 0.161$. 삼각형을 맞혔는데도 “∅ 라고 답했어야 한다” 는 벌을 받습니다.
(나) 없습니다. 박스 손실은 짝이 있는 질의에만 걸립니다. 벌을 받는 것은 B 의 점수뿐입니다.
(다) B 가 “이 삼각형은 A 가 맡았다” 는 것을 알 방법이 없습니다. 질의마다 그림만 보고 따로 답하면, 같은 객체가 잘 보이는 두 질의 가운데 누가 물러날지 정할 수 없습니다. 본문의 실험에서 질의끼리 이야기할 기회가 없었던 첫 디코더 층의 출력에 겹치는 쌍이 153개로 가장 많았습니다.
학습 로그의 마지막 줄은 손실 0.4232 (ce 0.0011 bbox 0.0104 giou 0.0383) 입니다. (가) 괄호 안 세 값으로 마지막 디코더 층의 가중합을 구하세요. (나) “손실” 0.4232 는 그 몇 배입니까? 왜 그렇습니까?
답 보기
(가) $1 \times 0.0011 + 5 \times 0.0104 + 2 \times 0.0383 = 0.0011 + 0.0520 + 0.0766 = 0.1297$.
(나) $0.4232 / 0.1297 \approx 3.26$ 배. “손실” 은 디코더 세 층의 손실을 모두 더한 것(본 손실 + 보조 손실 2개)이기 때문입니다. 정확히 3배가 아니라 3.26배인 것은 앞쪽 층의 손실이 마지막 층보다 조금 크기 때문입니다(나머지 두 층의 합이 $0.4232 - 0.1297 = 0.2935$, 층당 평균 0.147). 층을 지날수록 예측이 좋아진다는 것과 맞습니다.
DETR 논문의 설정($D = 256$, $N = 100$, 스트라이드 32)에 $800 \times 1216$ 픽셀 그림 한 장을 넣습니다. (가) 그림 토큰은 몇 개입니까? (나) 인코더 자기 어텐션과 디코더 교차 어텐션의 가중치 표는 (머리 하나당) 각각 몇 칸입니까? (다) 스트라이드를 16 으로 바꾸면 (나)의 두 값은 각각 몇 배가 됩니까?
답 보기
(가) $800 / 32 = 25$, $1216 / 32 = 38$ 이므로 $25 \times 38 = 950$ 개.
(나) 인코더 자기 어텐션은 토큰 × 토큰이므로 $950 \times 950 = 902{,}500$ 칸, 디코더 교차 어텐션은 질의 × 토큰이므로 $100 \times 950 = 95{,}000$ 칸.
(다) 토큰이 $50 \times 76 = 3{,}800$ 개로 4배가 됩니다. 인코더 자기 어텐션은 $4^2 = 16$ 배($14{,}440{,}000$ 칸), 디코더 교차 어텐션은 4배($380{,}000$ 칸)입니다. 무거워지는 것은 디코더가 아니라 인코더 입니다. 논문이 해상도를 2배로 올린 DETR-DC5 에서 인코더 자기 어텐션의 비용이 16배가 되었다고 적은 것과 같습니다.
이제 손에 탐지기가 하나 있습니다. 앵커도 NMS 도 없이, 매칭과 집합 손실만으로 학습되는 탐지기입니다. 그러나 이 탐지기의 어텐션은 그림의 모든 칸을 보느라 배우는 데 오래 걸리고, 해상도를 올리면 비용이 제곱으로 늘어 작은 객체를 놓칩니다.
8장의 Deformable DETR 은 질의마다 기준점 둘레의 몇 군데만 보게 하는 변형 어텐션으로 이 문제를 풉니다.
이 장의 HungarianMatcher 와 SetCriterion 을 그대로 가져가 분류 손실만 포컬 손실로 바꾸고, 같은 도형 세상에서 학습 곡선을 이 장의 것과 겹쳐 그려 봅니다.