어텐션과 Transformer
RF-DETR 은 그림을 읽는 백본(DINOv2 ViT)도, 박스를 내놓는 디코더도 모두 어텐션 으로 되어 있습니다. 어텐션을 모르면 6장부터의 모든 그림이 “상자와 화살표” 로만 보입니다. 이 장에서는 어텐션 한 번을 손으로 계산하고, 식 한 줄 $\softmax(QK^\top/\sqrt{d_k})\,V$ 의 모든 글자가 왜 거기 있는지 따져 본 다음, 다중 머리 어텐션과 Transformer 층을 직접 구현합니다. 마지막에는 학습되는 질의가 도형 세상 그림에서 “빨간 도형” 을 찾아 그 위치를 가져오는 작은 실험을 합니다.
- 합성곱이 한 번에 보지 못하는 것을 어텐션은 어떻게 보는지, 토큰이 무엇인지
- 질의 · 열쇠 · 값으로 어텐션 한 번을 손으로 계산하기(토큰 3개, 차원 2)
- 행렬 꼴 $\softmax(QK^\top/\sqrt{d_k})\,V$ 와 텐서 모양 추적, $\sqrt{d_k}$ 로 나누는 이유의 유도와 실험
- 자기 어텐션과 교차 어텐션의 차이, 토큰 수의 제곱으로 느는 계산량, 마스크
- 다중 머리 어텐션의 투영 행렬 · 모양 · 매개변수 수를 세고, PyTorch 내장 모듈과 출력이 같은지 확인하기
- 어텐션이 순서를 모른다는 것(순열 등변성)과 사인 위치 인코딩(1차원 · 2차원)
- Transformer 인코더 층 · 디코더 층의 조립, post-norm 과 pre-norm 의 차이
- 교차 어텐션 한 층이 그림에서 도형을 찾는 실험과, 그 어텐션 지도를 읽는 법
- $N$: 토큰의 수. 질의가 $N_q$ 개, 열쇠 · 값이 $N_k$ 개일 때는 첨자로 구별합니다.
- $D$: 토큰 벡터의 차원(모델 차원). $d_k$: 질의 · 열쇠 벡터의 차원, $d_v$: 값 벡터의 차원. 다중 머리 어텐션에서는 $d_k = d_v = D/h$ ($h$ 는 머리 수)입니다.
- 소문자 $q, k_j, v_j$ 는 벡터 하나, 대문자 $Q, K, V$ 는 그 벡터들을 행으로 쌓은 행렬 입니다. 벡터는 모두 행벡터로 씁니다(원 논문 · PyTorch 와 같은 방식).
- “값” 이라는 낱말은 일상어이기도 합니다. 어텐션의 값(value)을 가리킬 때는 “값 벡터” 또는 “값 $v_j$” 처럼 씁니다.
- 텐서 모양의 $B$ 는 배치 크기입니다. 소문자 $b_1, b_2$ 는 FFN 의 편향 벡터입니다(2 · 3장에서 박스를 뜻하던 $b$ 와 다릅니다).
왜 어텐션인가
합성곱은 이웃만 본다
4장에서 본 합성곱은 작은 창(보통 3×3)을 그림 위에서 밀고 다니며, 창 안의 값만 섞습니다. 한 층을 지나면 각 위치는 바로 옆 한 칸 까지의 정보를 갖게 되고, 두 층을 지나면 두 칸, $L$ 층을 지나면 $L$ 칸 떨어진 곳까지의 정보를 갖습니다.
도형 세상의 96×96 그림을 8×8 조각 144개(12×12 격자)로 나누었다고 합시다. 맨 왼쪽 조각과 맨 오른쪽 조각은 11칸 떨어져 있습니다. 3×3 합성곱만으로 이 둘의 정보를 한자리에 모으려면 11층 이 필요합니다. 그런데 탐지에서는 멀리 떨어진 곳끼리 정보를 주고받아야 할 일이 많습니다.
- 그림을 가로지르는 큰 사각형의 왼쪽 변과 오른쪽 변이 같은 물체 의 양 끝이라는 것을 알아야 박스 하나로 묶을 수 있습니다.
- 같은 물체를 두 번 세지 않으려면 “이 물체는 이미 다른 예측이 맡았다” 는 것을 예측끼리 알아야 합니다(7장).
어텐션의 답은 단순합니다. 모든 조각이 모든 조각을 한 번에 본다. 거리와 상관없이, 한 층 만에 그림 반대편의 정보를 가져올 수 있습니다. 다만 144개를 똑같이 섞으면 그냥 평균이 되어 버리므로, 어느 조각을 얼마나 볼지 를 조각의 내용에 따라 그때그때 정합니다. 그 “얼마나” 를 정하는 방법이 이 장의 전부입니다.
토큰: 어텐션이 다루는 단위
어텐션이 다루는 “조각” 하나를 토큰token 이라고 부릅니다. 토큰은 그저 길이 $D$ 의 벡터 하나 입니다. 언어 모델에서는 낱말(의 조각) 하나가 토큰이지만, 이 튜토리얼에서 만날 토큰은 두 가지입니다.
- 그림 토큰: 그림을 작은 정사각형 조각(패치)으로 자르고, 조각 하나를 벡터 하나로 바꾼 것(6장). 96×96 그림을 8×8 패치로 자르면 토큰이 144개 생깁니다.
- 객체 질의: “물체 하나를 찾아오라” 는 임무를 맡은, 학습되는 벡터(7장). RF-DETR 의 탐지 모델은 이것을 300개 씁니다.
토큰 $N$ 개는 행렬 $X \in \R^{N \times D}$ 한 장으로 적습니다. $i$ 번째 행 $x_i$ 가 $i$ 번째 토큰입니다. 그림 여러 장을 한꺼번에 다루면 맨 앞에 배치 축이 붙어 모양이 (B, N, D) 가 됩니다.
어텐션 층은 이 토큰들을 받아 같은 수의, 서로의 정보가 섞인 새 토큰들 을 내놓습니다.
어텐션 한 번을 손으로 계산하기
내적으로 비슷함 재기
“어느 토큰을 얼마나 볼까” 를 정하려면 두 벡터가 얼마나 잘 맞는지 숫자 하나로 재야 합니다. 어텐션은 내적dot product 을 씁니다. 길이가 같은 두 벡터 $a = (a_1, \dots, a_d)$, $c = (c_1, \dots, c_d)$ 의 내적은 같은 자리끼리 곱해서 모두 더한 값입니다.
$$ a \cdot c = \sum_{m=1}^{d} a_m c_m = \lVert a \rVert\, \lVert c \rVert \cos\varphi $$$\lVert a \rVert$ 는 벡터의 길이, $\varphi$ (파이)는 두 벡터 사이의 각도입니다. 오른쪽 꼴에서 내적의 성질이 보입니다.
- 같은 방향($\varphi = 0$)이면 $\cos\varphi = 1$ 로 내적이 가장 큽니다. 예: $(2, 0)\cdot(2, 0) = 4$.
- 직각($\varphi = 90^\circ$)이면 0 입니다. 예: $(2, 0)\cdot(0, 2) = 2\cdot 0 + 0\cdot 2 = 0$.
- 비스듬하면 그 사이입니다. 예: $(2, 0)\cdot(1, 1) = 2\cdot 1 + 0\cdot 1 = 2$.
- 반대 방향이면 음수입니다. 예: $(2, 0)\cdot(-1, 0) = -2$.
내적은 방향뿐 아니라 길이 에도 비례한다는 점을 기억해 두세요. 벡터가 길면(그리고 차원이 크면) 내적도 커집니다. 이것이 뒤에서 $\sqrt{d_k}$ 로 나누는 이유가 됩니다.
질의 · 열쇠 · 값
어텐션attention 은 벡터 세 종류로 이루어집니다.
- 질의query $q \in \R^{d_k}$: “나는 이런 것을 찾고 있다”. 정보를 받을 쪽이 냅니다.
- 열쇠key $k_j \in \R^{d_k}$: “나는 이런 것을 갖고 있다”. 정보를 줄 쪽 토큰 $j$ 가 내거는 표지입니다. 질의와 내적을 해야 하므로 차원이 질의와 같습니다.
- 값value $v_j \in \R^{d_v}$: 토큰 $j$ 가 실제로 건네줄 내용. 열쇠와 하나씩 짝을 이룹니다. 차원 $d_v$ 는 $d_k$ 와 달라도 됩니다.
열쇠와 값을 따로 두는 까닭은 “찾을 때 쓰는 정보” 와 “찾은 뒤 가져올 정보” 가 다를 수 있기 때문입니다. 이 장 끝의 실험에서는 열쇠가 “나는 빨갛다” 를 알리고, 값이 “나는 그림의 오른쪽 아래에 있다” 를 건네주는 모습을 보게 됩니다.
점수에서 가중 평균까지
질의 하나 $q$ 와, 열쇠 · 값의 짝 $N_k$ 개 $(k_1, v_1), \dots, (k_{N_k}, v_{N_k})$ 가 있을 때 어텐션은 세 단계입니다.
- 점수: 질의와 열쇠마다의 내적을 구하고 $\sqrt{d_k}$ 로 나눕니다. $$ s_j = \frac{q \cdot k_j}{\sqrt{d_k}} \qquad (j = 1, \dots, N_k) $$
- 가중치: 점수에 소프트맥스(4장)를 씌워, 모두 양수이고 합이 1 인 숫자 $N_k$ 개로 바꿉니다. 이것이 어텐션 가중치attention weight 입니다. $$ \alpha_j = \frac{\exp(s_j)}{\sum_{l=1}^{N_k} \exp(s_l)}, \qquad \alpha_j \gt 0, \qquad \sum_{j=1}^{N_k} \alpha_j = 1 $$
- 출력: 값 벡터들을 그 가중치로 평균 냅니다. $$ o = \sum_{j=1}^{N_k} \alpha_j\, v_j $$
$s_j$ 는 점수(score), $\alpha_j$ (알파)는 가중치, $o$ 는 출력(output)입니다. 출력은 값들의 가중 평균 이므로 두 가지가 따라옵니다.
- 출력의 차원은 값의 차원 $d_v$ 입니다. 질의의 차원이 아닙니다.
- 가중치가 모두 양수이고 합이 1 이므로, 출력은 값 벡터들이 둘러싼 범위 안쪽 에만 놓입니다. 값이 모두 0 과 1 사이면 출력도 0 과 1 사이입니다. 어텐션은 값을 “고르고 섞을” 뿐, 새 값을 지어내지 않습니다.
파이썬의 d[key] 는 열쇠가 정확히 같은 항목 하나의 값을 돌려줍니다. 어텐션은 “부드러운 사전” 입니다. 질의와 비슷한 열쇠일수록 큰 가중치를 주고, 모든 값을 그 가중치로 섞어 돌려줍니다.
정확히 하나만 고르는 연산은 미분할 수 없지만, 부드럽게 섞는 연산은 미분할 수 있어서 경사 하강법으로 “무엇을 찾을지” 를 학습할 수 있습니다.
손계산: 토큰 3개, 차원 2
토큰 세 개를 2차원 벡터로 둡니다. 가장 단순한 경우로, 토큰 자신을 그대로 질의 · 열쇠 · 값으로 씁니다($q_i = k_i = v_i = x_i$, $d_k = d_v = 2$).
$$ x_1 = (2, 0), \qquad x_2 = (0, 2), \qquad x_3 = (1, 1) $$첫째 토큰이 질의일 때($q = x_1$)의 출력을 끝까지 계산해 봅시다.
둘째 토큰은 첫째와 대칭이므로 가중치가 $(0.0454, 0.7679, 0.1867)$, 출력이 $(0.2775, 1.7225)$ 입니다. 셋째 토큰 $q = (1, 1)$ 은 세 열쇠와의 내적이 모두 2 여서 점수가 모두 같고, 가중치는 $(\tfrac13, \tfrac13, \tfrac13)$ 입니다. 출력은 세 값의 단순 평균 $(1, 1)$ 입니다. 같은 계산을 코드로 해 봅니다.
$ python ch05_attention.py[손계산] 내적 Q Kᵀ =
tensor([[4., 0., 2.],
[0., 4., 2.],
[2., 2., 2.]])
[손계산] √d_k 로 나눈 점수 =
tensor([[2.8284, 0.0000, 1.4142],
[0.0000, 2.8284, 1.4142],
[1.4142, 1.4142, 1.4142]])
[손계산] 가중치 A =
tensor([[0.7679, 0.0454, 0.1867],
[0.0454, 0.7679, 0.1867],
[0.3333, 0.3333, 0.3333]])
[손계산] 출력 A V =
tensor([[1.7225, 0.2775],
[0.2775, 1.7225],
[1.0000, 1.0000]])가중치 행렬의 $i$ 번째 행이 “$i$ 번째 토큰이 질의일 때 세 토큰을 본 비율” 입니다. 첫 행이 손계산의 $(0.7679, 0.0454, 0.1867)$ 과 같고, 행마다 합이 1 입니다.
이 예에서는 질의와 열쇠가 같은 벡터라서 자기 자신과의 내적이 가장 큽니다. 실제 어텐션은 토큰에 학습되는 행렬 을 곱해 질의와 열쇠를 따로 만들기 때문에(뒤의 다중 머리 어텐션), “나와 같은 색인 토큰을 본다”, “내 왼쪽 토큰을 본다” 처럼 자기 자신이 아닌 곳을 보도록 얼마든지 배울 수 있습니다.
행렬로 한꺼번에: 스케일드 내적 어텐션
행렬 꼴과 모양 추적
질의가 여러 개면 같은 계산을 질의마다 되풀이하면 됩니다. 이것을 행렬 곱 한 번으로 적은 것이 “Attention Is All You Need”(Vaswani 외, 2017)의 식 (1), 스케일드 내적 어텐션scaled dot-product attention 입니다.
$$ \operatorname{Attention}(Q, K, V) = \softmax\!\left( \frac{Q K^{\top}}{\sqrt{d_k}} \right) V $$$Q \in \R^{N_q \times d_k}$ 는 질의 $N_q$ 개를 행으로 쌓은 행렬, $K \in \R^{N_k \times d_k}$ 와 $V \in \R^{N_k \times d_v}$ 는 열쇠와 값 $N_k$ 개를 행으로 쌓은 행렬입니다. $K^\top$ 의 $\top$ 는 전치(행과 열을 바꿈)이고, 소프트맥스는 행마다(질의마다) 따로 씌웁니다. 한 줄씩 풀어 보면 앞 절의 세 단계 그대로입니다.
| 단계 | 식 | 모양 | 손계산 예에서 |
|---|---|---|---|
| 질의 | $Q$ | $(N_q, d_k)$ | (3, 2) |
| 열쇠 · 값 | $K$, $V$ | $(N_k, d_k)$, $(N_k, d_v)$ | (3, 2), (3, 2) |
| 점수 | $S = QK^\top/\sqrt{d_k}$ | $(N_q, N_k)$ | (3, 3) |
| 가중치 | $A = \softmax(S)$ | $(N_q, N_k)$ | (3, 3), 행의 합 1 |
| 출력 | $O = AV$ | $(N_q, d_v)$ | (3, 2) |
기억할 것은 두 가지입니다. 점수 · 가중치 행렬의 크기는 질의 수 × 열쇠 수 이고, 출력의 행 수는 질의의 수 를 따릅니다. 질의가 300개, 그림 토큰이 576개면 가중치는 (300, 576), 출력은 300개입니다.
코드로 옮기기
식이 그대로 네 줄이 됩니다. 앞쪽 축(...)은 배치나 머리 축이 몇 개 붙어도 되게 한 것입니다. mask 는 조금 뒤에 설명합니다.
왜 √d 로 나누는가
식에서 가장 수상한 글자는 $\sqrt{d_k}$ 입니다. 내적을 그대로 쓰면 안 될까요? 원 논문은 “차원이 크면 내적이 커져서 소프트맥스가 기울기가 아주 작은 영역으로 밀려난다고 짐작한다” 고 적고, 각주에서 그 까닭을 한 줄로 설명합니다. 그 한 줄을 풀어서 유도하고, 숫자로 확인해 봅시다.
내적의 분산은 차원에 비례한다
질의와 열쇠의 성분을 $q = (a_1, \dots, a_{d_k})$, $k = (c_1, \dots, c_{d_k})$ 라고 적겠습니다. 성분 $2 d_k$ 개가 모두 서로 독립이고 평균 0, 분산 1 인 확률 변수라고 가정합니다. 가중치를 무작위로 초기화한 직후의 신경망에서 대략 맞는 가정입니다. 쓰는 도구는 기댓값 $\E[\cdot]$(여러 번 뽑았을 때의 평균)과 분산 $\Var(X) = \E[X^2] - (\E[X])^2$(평균 둘레로 퍼진 정도)의 성질 세 가지입니다.
- 독립인 두 확률 변수는 곱의 기댓값이 기댓값의 곱입니다: $\E[XY] = \E[X]\,\E[Y]$.
- 독립인 확률 변수들은 합의 분산이 분산의 합입니다: $\Var(X + Y) = \Var(X) + \Var(Y)$.
- 상수 $t$ 를 곱하면 분산은 $t^2$ 배가 됩니다: $\Var(tX) = t^2 \Var(X)$.
세 성질의 증명은 World Model 튜토리얼의 확률 장에 있습니다.
숫자로 보면, $d_k = 64$ 일 때 나누지 않은 내적은 표준편차가 $\sqrt{64} = 8$ 입니다. 점수가 $-8$ 에서 $+8$ 사이를 예사로 오간다는 뜻입니다. $\sqrt{d_k} = 8$ 로 나누면 표준편차 1 로 줄어듭니다.
점수가 크면 소프트맥스가 굳는다
점수가 크면 왜 곤란할까요? 소프트맥스는 점수 차이 를 지수 함수로 키우기 때문에, 차이가 크면 가중치가 한 곳에 거의 1 로 쏠리고 나머지는 0 에 붙습니다. 이렇게 쏠린 상태에서는 점수를 조금 바꿔도 가중치가 거의 움직이지 않습니다. 곧 기울기가 0 에 가까워 학습이 더뎌집니다. 점수가 둘뿐인 가장 단순한 경우 $\alpha_1 = e^{s_1}/(e^{s_1} + e^{s_2})$ 로 확인해 봅시다.
$d_k = 64$ 에서 나누지 않으면 점수 $(8, 0)$ 같은 차이가 흔합니다. 이때 $\alpha_1 = e^8/(e^8 + 1) = 0.99966$ 이고 기울기는 $0.99966 \times 0.00034 = 0.00034$ 입니다. $\sqrt{d_k} = 8$ 로 나눈 점수 $(1, 0)$ 이면 $\alpha_1 = e/(e + 1) = 0.73106$, 기울기는 $0.73106 \times 0.26894 = 0.19661$ 입니다. 기울기가 약 590배 큽니다($0.19661 / 0.000335 \approx 587$).
실험: 차원을 키우면서 재 보기
유도가 맞는지 실험합니다. 표준 정규 분포에서 질의 하나와 열쇠 16개를 뽑아 내적을 구하는 일을 2만 번 되풀이하고, 차원 $d$ 를 4 에서 1024 까지 바꿉니다. 소프트맥스가 얼마나 쏠렸는지는 두 숫자로 잽니다.
- 가장 큰 가중치: 16개가 고르면 $1/16 = 0.0625$, 한 곳에 다 쏠리면 1.
- 엔트로피 $-\sum_j \alpha_j \log \alpha_j$: 가중치가 얼마나 고루 퍼졌는지를 재는 값. 16개가 고르면 $\log 16 = 2.773$, 한 곳에 다 쏠리면 0.
[√d] 열쇠 16개. 고른 가중치라면 최대 가중치 0.0625, 엔트로피 log 16 = 2.773
[√d] d =    4: Var(q·k) =     4.00, Var(q·k/√d) = 1.001 | 최대 가중치: 안 나눔 0.425, 나눔 0.234 | 엔트로피: 안 나눔 1.768, 나눔 2.382
[√d] d =   16: Var(q·k) =    15.99, Var(q·k/√d) = 1.000 | 최대 가중치: 안 나눔 0.684, 나눔 0.242 | 엔트로피: 안 나눔 0.906, 나눔 2.366
[√d] d =   64: Var(q·k) =    64.05, Var(q·k/√d) = 1.001 | 최대 가중치: 안 나눔 0.842, 나눔 0.245 | 엔트로피: 안 나눔 0.416, 나눔 2.360
[√d] d =  256: Var(q·k) =   256.19, Var(q·k/√d) = 1.001 | 최대 가중치: 안 나눔 0.924, 나눔 0.247 | 엔트로피: 안 나눔 0.190, 나눔 2.356
[√d] d = 1024: Var(q·k) =  1024.57, Var(q·k/√d) = 1.001 | 최대 가중치: 안 나눔 0.962, 나눔 0.247 | 엔트로피: 안 나눔 0.093, 나눔 2.356
[소프트맥스] 점수 [8.0, 0.0] → 가중치 [0.99966, 0.00034], 기울기 p(1−p) = 0.00034
[소프트맥스] 점수 [1.0, 0.0] → 가중치 [0.73106, 0.26894], 기울기 p(1−p) = 0.19661
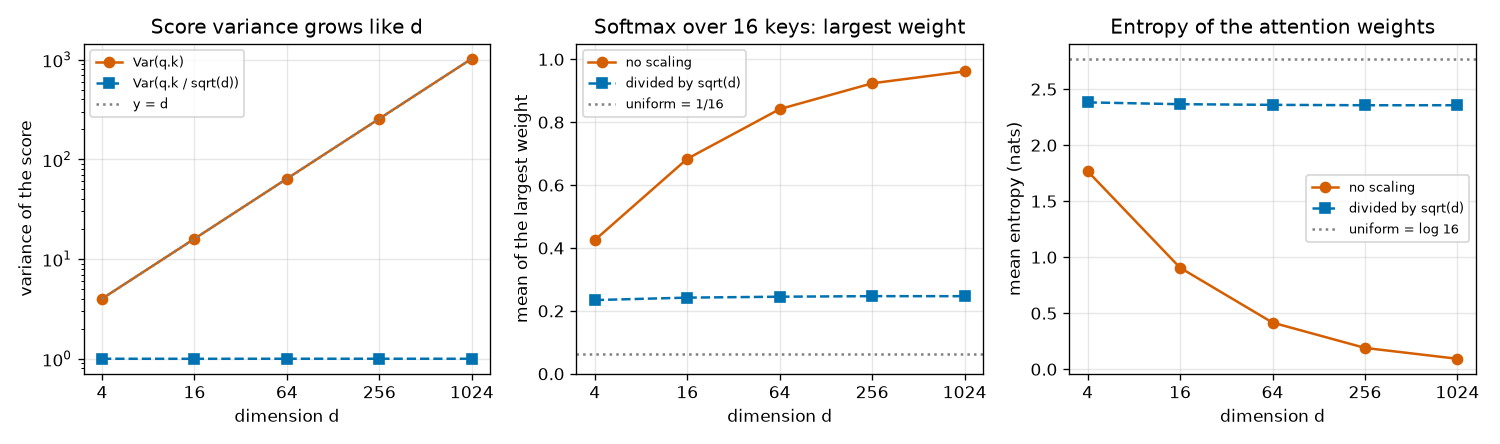
출력의 마지막 두 줄은 앞에서 손으로 구한 기울기 0.00034 와 0.19661 입니다. 그림과 나머지 출력에서 읽을 것은 세 가지입니다.
- 왼쪽: 나누지 않은 점수의 분산은 회색 점선 $y = d$ 와 겹칩니다(4.00, 15.99, 64.05, 256.19, 1024.57). 유도한 $\Var(q\cdot k) = d_k$ 그대로입니다. 나누면 차원과 상관없이 1 입니다.
- 가운데: 나누지 않으면 차원이 커질수록 한 열쇠가 가중치를 독차지합니다. $d = 64$ 에서 평균 0.842, $d = 1024$ 에서 0.962 입니다. 아직 아무것도 배우지 않은 무작위 벡터인데도 “한 곳만 보는” 상태로 출발하는 셈입니다. 나누면 어느 차원에서나 0.25 안팎입니다.
- 오른쪽: 엔트로피도 같은 이야기를 합니다. 나누지 않으면 $d = 1024$ 에서 0.093 까지 떨어지고, 나누면 2.36 안팎에 머뭅니다(완전히 고른 2.773 보다는 조금 낮습니다. 분산 1 의 점수 차이만큼은 가중치가 다르기 때문입니다).
“성분이 독립이고 분산 1” 이라는 가정은 학습을 시작할 때의 이야기입니다. 학습이 진행되면 모델은 가중치를 키워 필요한 만큼 뾰족한 어텐션을 스스로 만들 수 있습니다(이 장 끝의 실험에서 가중치가 한 도형에 거의 다 몰리는 것을 봅니다). $\sqrt{d_k}$ 로 나누는 것은 뾰족한 어텐션을 막는 장치가 아니라, 출발점 을 기울기가 잘 흐르는 곳에 놓는 장치입니다. 그리고 원 논문도 이 설명을 실험으로 증명했다기보다 “그럴 것이라고 짐작한다” 고 적었습니다.
자기 어텐션과 교차 어텐션
지금까지는 질의 · 열쇠 · 값이 “주어졌다” 고 했습니다. 실제로는 토큰에서 만듭니다. 어느 토큰 묶음에서 만드느냐 에 따라 어텐션의 이름이 둘로 갈립니다.
- 자기 어텐션self-attention: 질의 · 열쇠 · 값을 모두 같은 토큰 묶음 $X$ 에서 만듭니다. 토큰들이 서로를 봅니다. $N_q = N_k = N$ 이고, 토큰 $N$ 개가 들어가 $N$ 개가 나옵니다.
- 교차 어텐션cross-attention: 질의는 한 묶음 $Z$ 에서, 열쇠 · 값은 다른 묶음 $M$ 에서 만듭니다. $Z$ 의 토큰들이 $M$ 의 토큰들을 보고 정보를 가져옵니다. $Z$ 가 $N_q$ 개면 출력도 $N_q$ 개입니다. $M$ 은 변하지 않습니다.
“토큰에서 만든다” 는 것은 학습되는 행렬을 곱한다는 뜻입니다. 행렬 $W_Q, W_K \in \R^{D \times d_k}$, $W_V \in \R^{D \times d_v}$ 로 다음과 같이 적습니다.
$$ \begin{aligned} \text{자기 어텐션:}\quad & Q = X W_Q, \quad K = X W_K, \quad V = X W_V \\ \text{교차 어텐션:}\quad & Q = Z W_Q, \quad K = M W_K, \quad V = M W_V \end{aligned} $$연산 자체는 똑같이 $\softmax(QK^\top/\sqrt{d_k})\,V$ 입니다. 달라지는 것은 재료의 출처뿐입니다. 이 튜토리얼에서 두 어텐션이 쓰이는 자리는 다음과 같습니다.
| 어디서 | 종류 | 질의의 출처 | 열쇠 · 값의 출처 | 자세히 |
|---|---|---|---|---|
| 백본(ViT) | 자기 어텐션 | 그림 토큰 | 같은 그림 토큰 | 6장 |
| 디코더 | 자기 어텐션 | 객체 질의 | 같은 객체 질의 | 7장 |
| 디코더 | 교차 어텐션 | 객체 질의 | 그림 토큰 | 7장, 8장 |
DETR 계열 탐지기의 심장은 셋째 줄입니다. 객체 질의 하나하나가 그림 토큰 전체를 훑어보고, 자기가 맡을 물체가 있는 곳의 정보를 끌어옵니다. “객체 질의” 라는 이름도 여기서 나왔습니다. 교차 어텐션에서 질의 자리에 들어가는 토큰 이기 때문입니다.
계산량: 토큰 수의 제곱
“모든 토큰이 모든 토큰을 본다” 에는 값이 따릅니다. 자기 어텐션의 점수 행렬 $S$ 는 $N \times N$ 이고, 성분 하나가 길이 $d_k$ 의 내적입니다. 따라서 곱셈 횟수가 대략 $N^2 \cdot d_k$ 이고, 가중치 행렬을 담을 메모리도 $N^2$ 에 비례합니다. 원 논문의 표 1 은 이것을 “층마다의 복잡도 $O(N^2 \cdot D)$” 라고 적습니다. $O(\cdot)$ 는 “상수배를 무시하고 이만큼의 비율로 는다” 는 뜻의 표기입니다.
그림에서 토큰 수는 (한 변의 픽셀 수 ÷ 패치 크기)² 입니다. 패치를 절반으로 줄이거나 해상도를 두 배로 올리면 토큰은 4배, 토큰 쌍은 16배 가 됩니다.
| 그림 한 변 | 패치 크기 | 격자 | 토큰 수 $N$ | 토큰 쌍 $N^2$ | 패치 16 대비 |
|---|---|---|---|---|---|
| 96 | 16 | 6×6 | 36 | 1,296 | 1배 |
| 96 | 8 | 12×12 | 144 | 20,736 | 16배 |
| 96 | 4 | 24×24 | 576 | 331,776 | 256배 |
| 96 | 2 | 48×48 | 2,304 | 5,308,416 | 4,096배 |
도형 세상은 장난감이지만 실제 모델도 같은 산수를 따릅니다. RF-DETR 논문의 표 7 에 실린 구성으로 패치 토큰 수를 세어 보면 다음과 같습니다(백본이 덧붙이는 몇 개의 특수 토큰은 뺀 값입니다. 6장).
| 모델(논문 표 7) | 해상도 | 패치 크기 | 격자 | 토큰 수 $N$ | 토큰 쌍 $N^2$ |
|---|---|---|---|---|---|
| RF-DETR N | 384 | 16 | 24×24 | 576 | 331,776 |
| RF-DETR M | 576 | 16 | 36×36 | 1,296 | 1,679,616 |
| RF-DETR 2XL | 880 | 20 | 44×44 | 1,936 | 3,748,096 |
N 에서 2XL 로 가면 토큰은 3.4배지만 토큰 쌍은 11.3배입니다. 실시간 탐지기에게 이 제곱 비용은 큰 짐이고, 뒤의 두 장이 바로 이 짐을 덜어 내는 이야기입니다.
- 8장의 변형 어텐션(deformable attention): 디코더의 교차 어텐션에서 질의가 그림 토큰 전체가 아니라 몇 개의 점 만 보게 합니다.
- 9장의 윈도 어텐션: 백본의 자기 어텐션에서 그림을 몇 개의 창으로 나눠 같은 창 안의 토큰끼리만 보게 합니다. 창이 4개면 쌍의 수가 $4 \times (N/4)^2 = N^2/4$ 로 줄어듭니다.
이 장 끝에서 토큰 수를 늘려 가며 실제 시간을 재 봅니다.
마스크: 보면 안 되는 곳 가리기
때로는 어떤 질의가 어떤 열쇠를 아예 보지 못하게 막아야 합니다. 방법은 소프트맥스 앞에서 그 자리의 점수에 $-\infty$ 를 더하는 것입니다. 막을 자리가 $-\infty$, 나머지가 0 인 행렬 $M^{\text{mask}} \in \R^{N_q \times N_k}$ 를 만들어 점수에 더합니다.
$$ A = \softmax\!\left( \frac{QK^\top}{\sqrt{d_k}} + M^{\text{mask}} \right), \qquad M^{\text{mask}}_{ij} = \begin{cases} -\infty & (i, j)\text{ 를 막을 때} \\ 0 & \text{그 밖} \end{cases} $$손계산 예에서 셋째 열쇠를 가려 봅시다. 첫째 질의의 점수는 $(2.8284, 0, 1.4142)$ 였습니다. 셋째를 빼면 $e^{2.8284} + e^{0} = 16.919 + 1 = 17.919$ 이고, 가중치는 $(16.919/17.919,\; 1/17.919,\; 0) = (0.9442,\; 0.0558,\; 0)$ 입니다. 원래 셋째 토큰에 주던 0.1867 이 나머지 둘에게 비율대로 돌아갔습니다.
마스크는 쓰임새에 따라 두 가지로 부릅니다. PyTorch 의 인자 이름도 이것을 따릅니다.
-
열쇠 패딩 마스크key padding mask, 모양
(B, N_k): 크기가 다른 그림들을 한 배치로 묶으려면 작은 그림에 빈 칸을 채워(패딩) 크기를 맞춰야 합니다. 채워 넣은 가짜 토큰을 어떤 질의도 보지 못하게 열쇠 쪽에서 통째로 가립니다. 그림마다 가릴 자리가 다르므로 배치 축이 있습니다. -
어텐션 마스크attention mask, 모양
(N_q, N_k): (질의, 열쇠) 쌍 마다 볼 수 있는지를 정합니다. “질의 $i$ 는 열쇠 $j$ 를 못 본다” 를 마음대로 적을 수 있습니다.
어텐션 마스크는 뒤에서 한 번 더 만납니다. LW-DETR 과 RF-DETR 은 학습 때 객체 질의를 여러 묶음으로 나눠 쓰는 Group DETR 이라는 기법을 쓰는데(9장, 11장), 이때 디코더의 자기 어텐션에서 다른 묶음의 질의끼리는 서로 보지 못해야 합니다. “묶음이 다르면 막는다” 는 어텐션 마스크 한 장이면 이것을 구현할 수 있습니다. (RF-DETR 의 공개 코드는 마스크 대신 질의를 묶음별로 잘라 따로따로 자기 어텐션을 하는 방식으로 같은 효과를 냅니다.) 아래 코드의 둘째 예가 그 축소판입니다. 질의 4개를 두 묶음으로 나눴습니다.
[마스크] 세 번째 열쇠를 가린 가중치 =
 tensor([[0.9442, 0.0558, 0.0000],
        [0.0558, 0.9442, 0.0000],
        [0.5000, 0.5000, 0.0000]])
[마스크] 묶음 마스크 =
 tensor([[0, 0, 1, 1],
        [0, 0, 1, 1],
        [1, 1, 0, 0],
        [1, 1, 0, 0]], dtype=torch.int32)
[마스크] 묶음끼리만 보는 가중치 =
 tensor([[0.9122, 0.0878, 0.0000, 0.0000],
        [0.2729, 0.7271, 0.0000, 0.0000],
        [0.0000, 0.0000, 0.9958, 0.0042],
        [0.0000, 0.0000, 0.0237, 0.9763]])
첫 출력의 첫 행이 방금 손으로 구한 $(0.9442, 0.0558, 0)$ 입니다. 둘째 출력에서는 가중치가 왼쪽 위 2×2 와 오른쪽 아래 2×2 에만 남았습니다. 묶음 $\{0, 1\}$ 과 $\{2, 3\}$ 이 서로 완전히 끊긴 것입니다.
어떤 질의가 볼 수 있는 열쇠가 하나도 없으면 소프트맥스가 $0/0$ 이 되어 NaN(숫자 아님)이 나오고, 그것이 손실까지 번집니다.
마스크를 만들 때는 모든 질의가 적어도 열쇠 하나는 볼 수 있는지 확인하세요. 학습 도중 손실이 갑자기 NaN 이 되면 의심해 볼 곳 가운데 하나입니다.
다중 머리 어텐션
왜 머리를 여럿 두나
어텐션 한 번은 질의마다 가중치를 한 벌 만 만듭니다. 그런데 토큰 하나가 알고 싶은 것은 여러 가지일 수 있습니다. 도형의 가장자리에 놓인 그림 토큰이라면 “나와 같은 색인 토큰은 어디까지 이어지나” 와 “내 바로 옆에는 무엇이 있나” 를 둘 다 알고 싶을 것입니다. 가중치 한 벌로 두 가지를 다 보려 하면 둘이 평균되어 흐려집니다. 원 논문의 말로는 “머리가 하나면 평균 내기가 이것을 막는다” 입니다.
다중 머리 어텐션multi-head attention 은 작은 어텐션을 $h$ 개 나란히 돌립니다. 하나하나를 머리(head)라고 부릅니다. 머리마다 자기만의 투영 행렬로 질의 · 열쇠 · 값을 따로 만들기 때문에, 머리마다 다른 기준으로 다른 곳을 볼 수 있습니다. 마지막에 머리들의 출력을 이어 붙입니다.
투영 행렬 넷과 모양 추적
머리 $i$ ($i = 1, \dots, h$)는 투영 행렬 $W_i^Q, W_i^K \in \R^{D \times d_k}$, $W_i^V \in \R^{D \times d_v}$ 를 갖습니다. 질의의 재료를 $X_q \in \R^{N_q \times D}$, 열쇠 · 값의 재료를 $X_k \in \R^{N_k \times D}$ 라고 하면(자기 어텐션이면 둘이 같습니다) 다음과 같습니다.
$$ \begin{aligned} \text{head}_i &= \operatorname{Attention}\big(X_q W_i^Q,\; X_k W_i^K,\; X_k W_i^V\big) \in \R^{N_q \times d_v} \\ \operatorname{MultiHead}(X_q, X_k) &= \operatorname{Concat}(\text{head}_1, \dots, \text{head}_h)\, W^O \in \R^{N_q \times D} \end{aligned} $$$\operatorname{Concat}$ 은 머리 $h$ 개의 출력을 옆으로 이어 붙여 $(N_q, h\, d_v)$ 로 만드는 것이고, $W^O \in \R^{h d_v \times D}$ 는 이어 붙인 것을 다시 섞어 $D$ 차원으로 되돌리는 출력 투영입니다. 머리의 차원은 보통 $D$ 를 머리 수로 나눈 값 으로 정합니다.
$$ d_k = d_v = \frac{D}{h} $$원 논문은 $D = 512$, $h = 8$ 이라 $d_k = 64$ 입니다. RF-DETR 기본 구성의 디코더는 $D = 256$ 이고 자기 어텐션의 머리가 8개라 $d_k = 256/8 = 32$ 입니다. 이렇게 나누면 머리가 여럿이어도 전체 계산량이 “$D$ 차원 머리 하나” 와 비슷합니다. 머리 하나가 $N_q N_k\, d_k$ 번의 곱셈을 하므로 $h$ 개면 $h \cdot N_q N_k \cdot (D/h) = N_q N_k D$ 입니다.
구현에서는 머리마다 작은 행렬을 따로 두지 않습니다. $W_1^Q, \dots, W_h^Q$ 를 옆으로 이어 붙이면 $D \times (h\,d_k) = D \times D$ 행렬 하나 $W_Q$ 가 되므로, $X W_Q$ 를 한 번 계산한 다음 결과의 $D$ 개 열을 $d_k$ 개씩 $h$ 묶음으로 쪼개면 머리별 질의가 됩니다. $W_K$, $W_V$ 도 같습니다. 그래서 매개변수는 $D \times D$ 행렬 넷 $W_Q, W_K, W_V, W_O$ (와 편향)뿐입니다.
배치까지 넣어 텐서 모양을 따라가면 다음과 같습니다. 코드의 줄과 하나씩 맞춰 보세요.
| 단계 | 연산 | 모양 | $B = 2$, $N_q = 5$, $N_k = 12$, $D = 256$, $h = 8$ |
|---|---|---|---|
| 입력 | 질의 재료 / 열쇠 · 값 재료 | $(B, N_q, D)$ / $(B, N_k, D)$ | (2, 5, 256) / (2, 12, 256) |
| 투영 | $W_Q$, $W_K$, $W_V$ 곱하기 | 그대로 | (2, 5, 256) / (2, 12, 256) |
| 머리로 쪼개기 | 마지막 축을 $(h, d_k)$ 로, 머리 축을 앞으로 | $(B, h, N_q, d_k)$ / $(B, h, N_k, d_k)$ | (2, 8, 5, 32) / (2, 8, 12, 32) |
| 점수 · 가중치 | $QK^\top/\sqrt{d_k}$, 소프트맥스 | $(B, h, N_q, N_k)$ | (2, 8, 5, 12) |
| 머리별 출력 | $AV$ | $(B, h, N_q, d_k)$ | (2, 8, 5, 32) |
| 이어 붙이기 | 머리 축을 뒤로 보내 합치기 | $(B, N_q, h\,d_k) = (B, N_q, D)$ | (2, 5, 256) |
| 출력 투영 | $W_O$ 곱하기 | $(B, N_q, D)$ | (2, 5, 256) |
매개변수 수 세기
$D = 256$, $h = 8$ 인 다중 머리 어텐션의 매개변수를 손으로 세어 봅시다. PyTorch 의 선형 층은 가중치 행렬에 편향 벡터를 더합니다.
구현과 내장 모듈 대조
이제 직접 구현합니다. 앞에서 만든 scaled_dot_product_attention 에 투영 넷과 “머리로 쪼개기 · 이어 붙이기” 만 더하면 됩니다.
두 마스크는 (B, 1, N_q, N_k) 로 넓혀질 수 있는 꼴로 합쳐서 넘깁니다(가운데 1 은 머리 축: 모든 머리에 같은 마스크).
제대로 만들었는지는 PyTorch 내장 nn.MultiheadAttention 과 견주어 확인합니다. 내장 모듈은 $W_Q, W_K, W_V$ 를 세로로 쌓은 in_proj_weight 한 덩어리로 갖고 있으므로,
우리 가중치를 그 순서대로 이어 붙여 넣어 주면 됩니다. 같은 입력에 같은 출력이 나와야 합니다.
[다중 머리] 매개변수 수: 직접 구현 263,168, 내장 263,168 (손계산 4 × (256·256 + 256) = 263,168)
[다중 머리] 교차 어텐션 모양: 출력 (2, 5, 256), 가중치 (2, 8, 5, 12)
[check] nn.MultiheadAttention 과의 최대 차이: 출력 1.19e-07, 가중치 4.47e-08
[check] 패딩된 열쇠의 가중치 합: 0.0, 가중치 행의 합(모두 1 이어야): 최소 1.000000 최대 1.000000
[check] 어텐션 마스크를 준 자기 어텐션의 최대 차이: 1.79e-07
[check] F.scaled_dot_product_attention 과의 최대 차이: 4.77e-07
- 매개변수 수가 손계산 263,168 과 같고, 내장 모듈과도 같습니다.
- 질의 5개와 그림 토큰 12개의 교차 어텐션에서 출력은 (2, 5, 256), 가중치는 (2, 8, 5, 12) 입니다. 위 표의 모양 그대로입니다.
- 내장 모듈과의 차이는 $10^{-7}$ 수준입니다. 32비트 실수의 반올림 오차 크기이므로 같은 계산이라고 보아도 됩니다. 열쇠 패딩 마스크와 어텐션 마스크를 준 경우도 같습니다.
- 패딩으로 가린 열쇠 3개의 가중치 합은 정확히 0.0 이고, 가중치의 모든 행은 합이 1 입니다.
RF-DETR 의 공개 코드도 디코더의 자기 어텐션에 내장 nn.MultiheadAttention 을 씁니다. 둘이 같은 계산이라는 것을 여기서 확인했으므로, 뒤의 장에서 내장 모듈을 만나면 이 절의 코드를 떠올리면 됩니다.
어텐션은 순서를 모른다
순열 등변성
어텐션 식을 다시 보면 “토큰이 몇 번째인가” 가 어디에도 없습니다. 점수는 내용끼리의 내적일 뿐입니다. 그래서 토큰의 순서를 섞어 넣으면, 출력도 똑같이 섞여서 나올 뿐 값 자체는 달라지지 않습니다. 이 성질을 순열 등변성permutation equivariance 이라고 합니다. 식으로 보이겠습니다.
토큰의 순서를 바꾸는 일은 순열 행렬 $P$ 를 곱하는 것으로 적습니다. $P$ 는 행마다 · 열마다 1 이 딱 하나씩 있고 나머지는 0 인 $N \times N$ 행렬입니다. $PX$ 는 $X$ 의 행(토큰)을 다시 늘어놓은 것이고, 오른쪽에 $P^\top$ 를 곱하면 열을 같은 순서로 다시 늘어놓습니다. 섞었다가 되돌리면 원래대로이므로 $P^\top P = I$ (단위 행렬)입니다.
손계산 예로 확인하면, 토큰을 $(x_2, x_1, x_3)$ 순서로 넣어도 $x_1 = (2, 0)$ 의 출력은 여전히 $(1.7225, 0.2775)$ 입니다. 그 출력이 첫째 자리가 아니라 둘째 자리에 나올 뿐입니다. 여러 층을 쌓아도, 뒤에서 볼 FFN 과 층 정규화를 끼워 넣어도(모두 토큰마다 따로 하는 계산입니다) 이 성질은 그대로입니다.
그림에는 치명적입니다. 그림 토큰 144개를 마구 섞어 넣어도 각 토큰의 출력이 같다면, 모델은 빨간 조각이 그림의 어디에 있는지 알 길이 없습니다. 박스의 좌표를 맞혀야 하는 탐지기에게 위치는 전부입니다. DETR 논문도 “Transformer 구조는 순열에 불변이므로 고정된 위치 인코딩으로 보충한다” 고 적습니다.
입력을 섞으면 출력도 따라 섞이는 것이 등변($f(PX) = P f(X)$), 입력을 섞어도 출력이 아예 같은 것이 불변($f(PX) = f(X)$)입니다. 자기 어텐션 층 자체는 등변이고, 그 출력을 토큰 방향으로 평균 내면(순서와 상관없는 연산) 불변이 됩니다. 논문들은 둘을 뭉뚱그려 “순열 불변” 이라고 부르기도 합니다.
[순열] 섞는 순서 [6, 9, 0, 2, 4, 8, 1, 5, 3, 7]
[순열] 위치 인코딩 없음: |f(PX) − P f(X)| 의 최댓값 = 1.19e-07  (0 → 순서를 모른다)
[순열] 위치 인코딩 더함: 같은 차이 = 0.150  (0 이 아님 → 순서가 출력을 바꾼다)
토큰 10개를 섞어 넣은 출력과, 원래 출력을 같은 순서로 섞은 것의 차이가 $1.19 \times 10^{-7}$ 입니다(반올림 오차). 유도한 대로 어텐션은 순서를 모릅니다. 둘째 줄은 토큰에 곧 설명할 위치 인코딩을 더했을 때입니다. 같은 차이가 0.150 으로, 이제는 “어느 자리에 놓였는가” 가 출력을 바꿉니다.
사인 위치 인코딩
해결책은 토큰에 “나는 몇 번째다” 라는 정보를 직접 더해 주는 것입니다. 위치마다 다른 벡터를 만들어 토큰 벡터에 더합니다. 이 벡터를 위치 인코딩positional encoding 이라고 합니다. 토큰과 더해야 하므로 차원이 토큰과 같은 $D$ 입니다. 원 논문은 사인 · 코사인 함수로 만든, 학습하지 않는 고정된 벡터를 씁니다. 위치 $pos$ ($0, 1, 2, \dots$)의 인코딩에서 성분은 둘씩 짝을 이룹니다.
$$ \begin{aligned} PE(pos,\, 2i) &= \sin\!\big(pos \cdot \omega_i\big), \\ PE(pos,\, 2i+1) &= \cos\!\big(pos \cdot \omega_i\big), \end{aligned} \qquad \omega_i = \frac{1}{10000^{\,2i/D}}, \qquad i = 0, 1, \dots, \tfrac{D}{2} - 1 $$$PE(pos, c)$ 는 위치 $pos$ 의 인코딩 벡터에서 $c$ 번째 성분입니다. $\omega_i$ (오메가)는 $i$ 번째 짝의 각진동수 로, 위치가 1 늘 때 사인의 각도가 얼마나 도는지를 정합니다. 원 논문은 $\sin(pos / 10000^{2i/D})$ 라고 적는데 같은 식입니다. $i = 0$ 이면 $\omega_0 = 1$ 로 가장 빨리 돌고, $i$ 가 커질수록 느려집니다. 한 바퀴 도는 데 필요한 위치의 수(파장)는 $2\pi/\omega_i = 2\pi \cdot 10000^{2i/D}$ 여서, 가장 빠른 짝이 $2\pi \approx 6.28$ 이고 가장 느린 짝은 $10000 \cdot 2\pi$ 에 다가갑니다.
가장 작은 예 $D = 4$ 로 손계산해 봅시다. 짝이 둘이고 $\omega_0 = 1/10000^{0} = 1$, $\omega_1 = 1/10000^{2/4} = 1/100 = 0.01$ 입니다.
| $pos$ | $\sin(pos \cdot 1)$ | $\cos(pos \cdot 1)$ | $\sin(pos \cdot 0.01)$ | $\cos(pos \cdot 0.01)$ |
|---|---|---|---|---|
| 0 | 0.0000 | 1.0000 | 0.0000 | 1.0000 |
| 1 | 0.8415 | 0.5403 | 0.0100 | 0.9999 |
| 2 | 0.9093 | −0.4161 | 0.0200 | 0.9998 |
| 3 | 0.1411 | −0.9900 | 0.0300 | 0.9996 |
각도의 단위는 라디안입니다($\sin 1 = 0.8415$). 앞의 두 성분은 위치마다 크게 달라지고, 뒤의 두 성분은 아주 천천히 변합니다. 코드는 실수 위치를 받는 sine_embed 하나로 만들어 두고, 1차원 · 2차원 인코딩이 이것을 불러 씁니다.
[위치] sine_position_1d(4, 4) =
 tensor([[ 0.0000,  1.0000,  0.0000,  1.0000],
        [ 0.8415,  0.5403,  0.0100,  0.9999],
        [ 0.9093, -0.4161,  0.0200,  0.9998],
        [ 0.1411, -0.9900,  0.0300,  0.9996]])
[위치] d = 64: PE(32)·PE(32) = 32.00, PE(32)·PE(33) = 30.92, PE(32)·PE(36) = 23.93, PE(32)·PE(48) = 19.37
[위치] 위치가 달라도 간격이 같으면 내적이 같다: PE(10)·PE(14) = 23.93, PE(50)·PE(54) = 23.93
[위치] sine_position_2d(12, 12, 64) 모양 (144, 64), 같은 행의 두 토큰은 앞 절반(y)이 같다: True, 같은 열의 두 토큰은 뒤 절반(x)이 같다: True
첫 표가 위의 손계산과 같습니다. 나머지 줄은 조금 뒤에 읽습니다.
왜 여러 주파수인가
위치 인코딩도 같습니다. 빠른 성분(작은 $i$)은 바로 옆 위치를 또렷이 구별하지만 6칸쯤마다 같은 값으로 돌아옵니다. 느린 성분(큰 $i$)은 먼 위치끼리 구별해 주지만 이웃끼리는 거의 같습니다. 빠른 것부터 느린 것까지 여러 개를 나란히 두면, 위치마다 다른 벡터가 되면서 가까운 위치끼리는 비슷한 벡터가 됩니다.
“가까우면 비슷하다” 는 것은 내적으로 정확히 말할 수 있습니다. 사인과 코사인을 짝으로 둔 까닭이 여기서 드러납니다.
위 출력에서 [위치] d = 64 로 시작하는 줄과 그 다음 줄이 이것입니다. $D = 64$ 에서 자기 자신과의 내적은 $D/2 = 32.00$, 한 칸 옆은 30.92, 네 칸 옆은 23.93, 열여섯 칸 옆은 19.37 로 줄어듭니다.
그리고 위치 10 과 14 의 내적(23.93)이 위치 50 과 54 의 내적(23.93)과 같습니다. 간격이 4 로 같기 때문입니다.
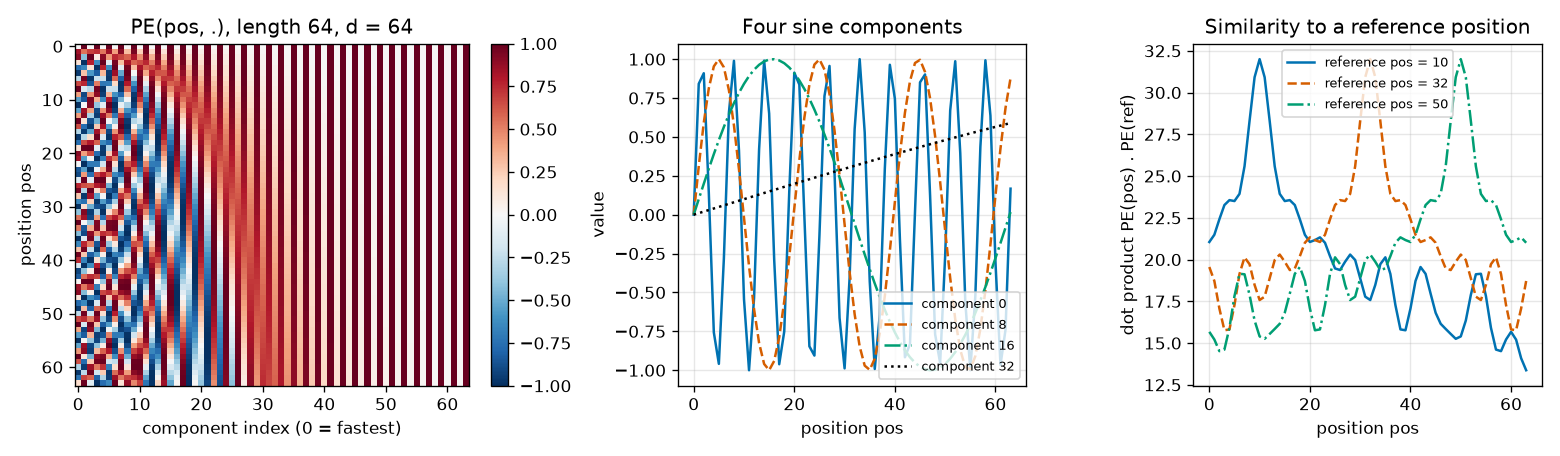
- 왼쪽: 한 행이 위치 하나의 인코딩 벡터입니다. 왼쪽 열(빠른 성분)은 위에서 아래로 가며 빨강 · 파랑이 잦게 바뀌고, 오른쪽 열(느린 성분)은 거의 변하지 않아 세로 줄무늬(사인은 0 근처, 코사인은 1 근처)로 보입니다. 어느 두 행도 같지 않습니다.
- 가운데: 성분 0 은 파장 $2\pi \approx 6.3$, 성분 8($i = 4$)은 $2\pi \cdot 10000^{8/64} \approx 19.9$, 성분 16($i = 8$)은 $2\pi \cdot 10 \approx 62.8$, 성분 32($i = 16$)는 $2\pi \cdot 100 \approx 628$ 입니다. 마지막 것은 이 범위에서 거의 직선입니다.
- 오른쪽: 내적은 기준 위치에서 가장 크고(32) 멀어질수록 줄어듭니다. 세 곡선은 봉우리의 자리만 다르고 모양이 같습니다. 방금 유도한 “간격에만 달려 있다” 그대로입니다.
원 논문은 사인 꼴을 고른 까닭을 “간격 $\Delta$ 만큼 떨어진 위치의 인코딩이 원래 인코딩의 선형 변환 으로 적히므로, 모델이 상대 위치를 보는 법을 쉽게 배울 것이라고 가정했다” 고 적습니다. 실제로 덧셈 정리를 쓰면 짝 하나에 대해 $$ \begin{pmatrix} \sin\omega_i(p + \Delta) \\ \cos\omega_i(p + \Delta) \end{pmatrix} = \begin{pmatrix} \cos\omega_i\Delta & \sin\omega_i\Delta \\ -\sin\omega_i\Delta & \cos\omega_i\Delta \end{pmatrix} \begin{pmatrix} \sin\omega_i p \\ \cos\omega_i p \end{pmatrix} $$ 이고, 가운데 행렬은 $p$ 와 상관없이 $\Delta$ 만으로 정해집니다. 같은 논문은 위치마다 벡터를 학습 하는 방식도 시험했고 결과가 거의 같았다고 보고합니다(논문 표 3 의 (E) 행). 학습하는 쪽은 이 튜토리얼에서 “위치 임베딩” 이라고 부르며, ViT 와 DINOv2 가 쓰는 방식이라 6장에서 다룹니다.
그림을 위한 2차원 위치 인코딩
그림 토큰의 위치는 숫자 하나가 아니라 (행, 열) 둘입니다. DETR 은 1차원 인코딩을 다음과 같이 넓혀 씁니다. $D$ 차원의 절반은 세로 좌표 $y$ 의 사인 인코딩에, 나머지 절반은 가로 좌표 $x$ 의 사인 인코딩에 씁니다.
$$ PE_{2D}(x, y) = \big[\; \underbrace{PE_{D/2}(\tilde{y})}_{D/2\text{ 개}} \;,\; \underbrace{PE_{D/2}(\tilde{x})}_{D/2\text{ 개}} \;\big], \qquad \tilde{y} = 2\pi\,\frac{y}{H}, \quad \tilde{x} = 2\pi\,\frac{x}{W} $$$H$, $W$ 는 토큰 격자의 높이와 너비(도형 세상에서는 12, 12)이고, $y = 1, \dots, H$ 와 $x = 1, \dots, W$ 는 1부터 센 행 · 열 번호입니다. $PE_{D/2}$ 는 앞의 1차원 식에서 $D$ 자리에 $D/2$ 를 넣은 것입니다($D = 64$ 면 축마다 32개 성분, 짝 16개, $\omega_i = 10000^{-i/16}$). $\tilde{y}, \tilde{x}$ (물결표)는 좌표를 $(0, 2\pi]$ 범위로 바꾼 것입니다. DETR 의 공개 코드가 이렇게 하는데, 격자가 12×12 든 40×40 든 좌표가 같은 범위에 놓이게 하려는 것입니다.
숫자로 확인해 봅시다. 12×12 격자의 맨 윗줄($y = 1$)은 $\tilde{y} = 2\pi/12 = 0.5236$ 이고, 가장 빠른 성분은 $\sin(0.5236 \cdot 1) = 0.5$ 입니다. 셋째 줄($y = 3$)은 $\tilde{y} = \pi/2$ 여서 $\sin(\pi/2) = 1$, 맨 아랫줄($y = 12$)은 $\tilde{y} = 2\pi$ 여서 $\sin(2\pi) = 0$ 입니다. 가장 빠른 성분이 그림의 위에서 아래까지 딱 한 바퀴 도는 셈입니다.
위 출력의 마지막 줄이 이 함수의 성질을 확인합니다. 모양은 (144, 64) 이고, 같은 행의 두 토큰은 앞 절반($y$)이 같고, 같은 열의 두 토큰은 뒤 절반($x$)이 같습니다.
이 구현은 RF-DETR 공개 코드의 PositionEmbeddingSine(normalize=True) 와 견주어 차이가 $10^{-6}$ 아래인 것을 따로 확인했습니다.
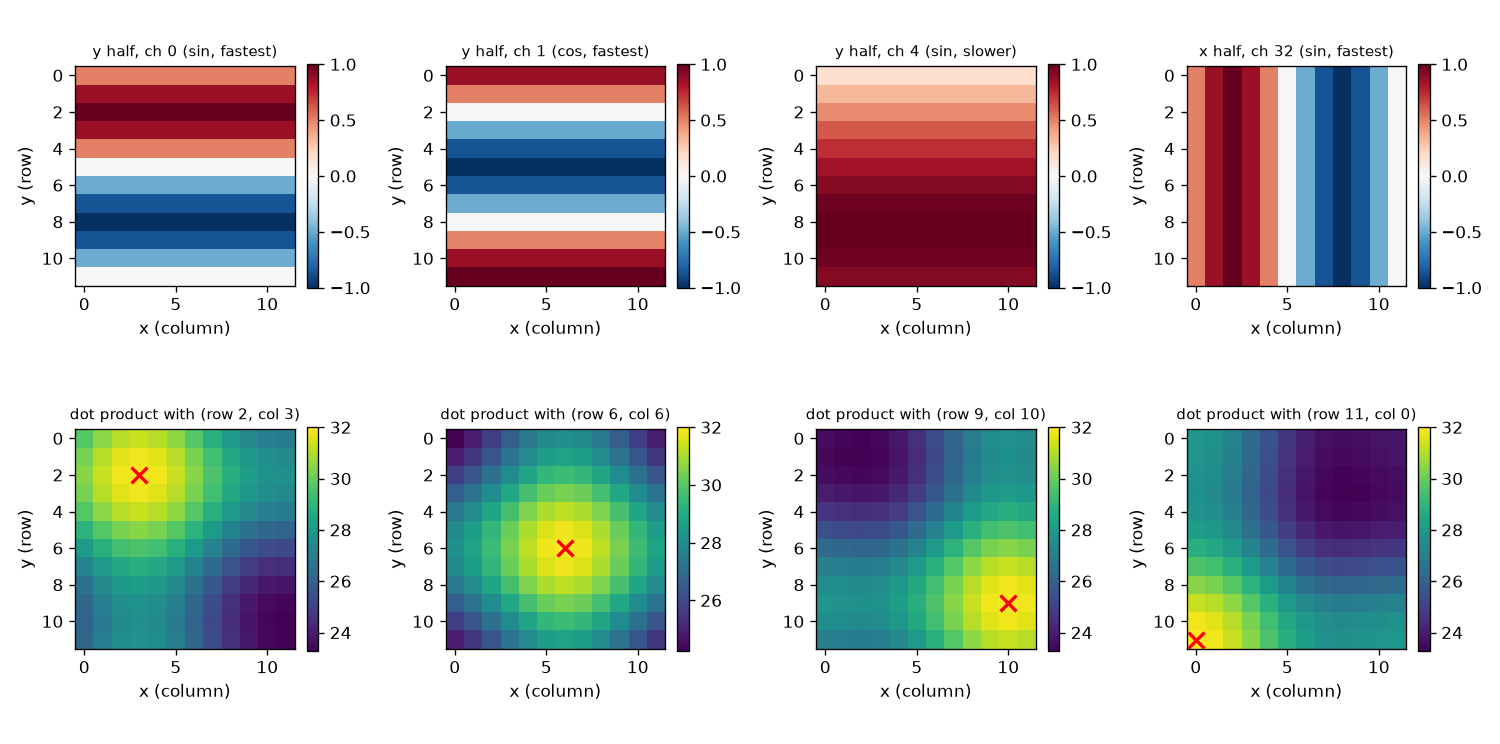
- 위 줄: $y$ 절반의 성분(왼쪽 셋)은 가로줄 무늬입니다. 같은 행이면 값이 같기 때문입니다. 첫 그림이 방금 계산한 성분으로, 맨 윗줄이 0.5, 셋째 줄이 1, 맨 아랫줄이 0 입니다. 느린 성분(셋째 그림)은 위에서 아래로 천천히 변합니다. $x$ 절반의 성분(넷째 그림)은 세로줄 무늬입니다.
- 아래 줄: 내적은 기준 위치에서 최댓값 $D/2 = 32$ 이고 멀어질수록 줄어듭니다. 1차원에서 유도한 것을 $y$ 와 $x$ 에 따로 쓰면 내적이 $\sum_i \cos(\omega_i \Delta\tilde{y}) + \sum_i \cos(\omega_i \Delta\tilde{x})$ 가 되기 때문입니다. 위치 인코딩의 내적이 곧 “그림 위에서 얼마나 가까운가” 의 지도입니다.
위치 인코딩을 어디에 더할지는 모델마다 다릅니다. 원 논문은 맨 처음 입력 토큰에 한 번 더합니다. DETR 은 어텐션 층마다 질의와 열쇠에 더합니다(논문은 이렇게 할 때 가장 좋았다고 보고합니다). 자세한 것은 7장에서 봅니다.
Transformer 층 조립하기
TransformerTransformer 는 “Attention Is All You Need” 가 내놓은 신경망 구조로, 다중 머리 어텐션을 중심으로 한 층 을 여러 번 쌓은 것입니다. 원 논문은 번역 모델이라 문장을 읽는 인코더 6층과 문장을 쓰는 디코더 6층으로 되어 있었습니다. 탐지기에서는 그림을 읽는 쪽이 인코더(RF-DETR 에서는 백본 ViT), 박스를 내놓는 쪽이 디코더입니다. 어텐션 말고 필요한 부품은 셋인데, 둘은 이미 4장에서 보았습니다.
- 잔차 연결: 부품의 출력에 입력을 그대로 더합니다($x + f(x)$). 기울기가 지나갈 지름길이 됩니다.
- 층 정규화 $\operatorname{LN}$: 토큰 하나의 $D$ 개 성분을 평균 0, 분산 1 로 맞춘 뒤 학습되는 배율과 이동을 적용합니다.
- FFN: 바로 아래에서 설명합니다.
토큰마다 따로 생각하기: FFN
어텐션은 토큰끼리 정보를 모으는 일만 합니다. 값들의 가중 평균이라, 모은 정보를 가지고 새로운 것을 계산해 내는 힘은 약합니다. 그래서 어텐션 뒤에 작은 2층 신경망을 둡니다. 이것을 FFNfeed-forward network(순방향 신경망)이라고 부릅니다. MLP 라고 부르는 논문도 많습니다.
$$ \operatorname{FFN}(x) = \max(0,\; x W_1 + b_1)\, W_2 + b_2, \qquad W_1 \in \R^{D \times rD}, \quad W_2 \in \R^{rD \times D} $$$x$ 는 토큰 하나(길이 $D$ 의 행벡터), $\max(0, \cdot)$ 는 ReLU, $b_1, b_2$ 는 편향입니다. 가운데 은닉 층은 토큰보다 $r$ 배 넓습니다. $r$ 을 확장 비율 이라고 합니다. 원 논문은 $D = 512$ 에 은닉 2048 이라 $r = 4$ 이고, RF-DETR 디코더의 기본 구성은 $D = 256$ 에 은닉 2048 이라 $r = 8$ 입니다. 중요한 점은 FFN 이 토큰마다 따로, 같은 가중치로 적용된다는 것입니다. 토큰 사이의 정보 교환은 어텐션만 맡고, FFN 은 한 토큰 안에서 일합니다.
매개변수 수는 $W_1$ 과 $b_1$ 이 $D \cdot rD + rD$, $W_2$ 와 $b_2$ 가 $rD \cdot D + D$ 입니다. $D = 256$, $r = 8$ 이면 $(256 \times 2048 + 2048) + (2048 \times 256 + 256) = 526{,}336 + 524{,}544 = 1{,}050{,}880$ 으로, 어텐션(263,168)의 네 배쯤입니다. Transformer 층의 매개변수 대부분은 FFN 에 있습니다.
인코더 층: post-norm 과 pre-norm
인코더 층 하나는 “자기 어텐션” 과 “FFN” 두 부분으로 되어 있고, 두 부분 모두 잔차 연결과 층 정규화로 감쌉니다. 감싸는 순서에 두 가지 유파가 있습니다. 토큰 묶음을 $x$, 자기 어텐션을 $\operatorname{SA}$ 라고 적으면 다음과 같습니다.
$$ \begin{aligned} \textbf{post-norm:}\quad & x' = \operatorname{LN}\big(x + \operatorname{SA}(x)\big), & y &= \operatorname{LN}\big(x' + \operatorname{FFN}(x')\big) \\ \textbf{pre-norm:}\quad & x' = x + \operatorname{SA}\big(\operatorname{LN}(x)\big), & y &= x' + \operatorname{FFN}\big(\operatorname{LN}(x')\big) \end{aligned} $$- post-normpost-normalization: 더한 뒤에 정규화합니다. 원 논문이 “$\operatorname{LayerNorm}(x + \operatorname{Sublayer}(x))$” 라고 적은 방식이고, DETR 과 RF-DETR 의 디코더가 이 방식입니다. 층의 출력이 늘 정규화되어 나옵니다.
- pre-normpre-normalization: 부품에 넣기 전에 정규화합니다. ViT 와 DINOv2 가 이 방식입니다. 식을 보면 $y = x + \operatorname{SA}(\cdot) + \operatorname{FFN}(\cdot)$ 꼴이라, 입력 $x$ 가 정규화에 한 번도 걸리지 않고 출력까지 그대로 더해집니다. 층을 깊게 쌓아도 기울기가 이 지름길로 곧장 흐릅니다. 대신 맨 마지막 층의 출력은 정규화되지 않은 채이므로, ViT 는 층을 다 쌓은 맨 끝에 층 정규화를 한 번 더 둡니다.
두 방식 모두 입력과 출력의 모양이 (B, N, D) 로 같습니다. 그래서 같은 층을 몇 번이고 쌓을 수 있습니다. 구현은 스위치 하나로 둘 다 지원합니다.
pos 를 주면 DETR 처럼 질의와 열쇠에만 위치 인코딩을 더합니다.
[check] 인코더 층(post-norm) nn.TransformerEncoderLayer 와의 최대 차이: 7.15e-07
[check] 인코더 층(pre-norm ) nn.TransformerEncoderLayer 와의 최대 차이: 4.77e-07
[인코더 층] 매개변수 수 (D = 256, h = 8, FFN 2048): 어텐션 263,168, FFN 1,050,880, 층 정규화 2개 1,024 → 합 1,315,072
[인코더 층] 모양: 입력 (2, 20, 256) → 출력 (2, 20, 256)
같은 가중치를 넣은 PyTorch 내장 nn.TransformerEncoderLayer 와 두 방식 모두 $10^{-7}$ 수준으로 일치합니다.
$D = 256$, 머리 8개, FFN 은닉 2048 인 층 하나의 매개변수는 어텐션 263,168 + FFN 1,050,880 + 층 정규화 둘 $2 \times (256 + 256) = 1{,}024$ 로 모두 1,315,072개입니다.
디코더 층
디코더 층은 인코더 층에 교차 어텐션을 하나 끼운 것입니다. 객체 질의 묶음을 $z$, 인코더가 만든 그림 토큰 묶음을 $M$, 교차 어텐션을 $\operatorname{CA}$ 라고 적으면 post-norm 디코더 층은 세 줄입니다.
$$ \begin{aligned} z' &= \operatorname{LN}\big(z + \operatorname{SA}(z)\big) && \text{질의끼리 서로 본다} \\ z'' &= \operatorname{LN}\big(z' + \operatorname{CA}(z', M)\big) && \text{질의가 그림 토큰을 본다} \\ y &= \operatorname{LN}\big(z'' + \operatorname{FFN}(z'')\big) && \text{질의마다 따로 생각한다} \end{aligned} $$- 자기 어텐션: 질의들이 서로의 상태를 봅니다. “그 물체는 내가 맡았다” 를 서로 알려 같은 물체를 두 번 내놓지 않게 하는 통로입니다.
- 교차 어텐션: 질의마다 그림 토큰에서 자기 물체의 정보를 가져옵니다. 그림 토큰 $M$ 은 읽기만 하고 바꾸지 않습니다.
- FFN: 가져온 정보를 질의마다 따로 가공합니다.
RF-DETR 의 디코더 층도 이 세 단계(자기 어텐션 → 교차 어텐션 → FFN, 모두 post-norm)입니다. 다만 둘째 단계의 교차 어텐션이 8장의 변형 어텐션으로 바뀌어 있습니다.
원 논문의 디코더는 낱말을 하나씩 차례로 만들어 냅니다. 학습할 때 정답 문장을 통째로 넣되, 각 위치가 자기보다 뒤의 낱말을 미리 보지 못하게 디코더의 자기 어텐션에 어텐션 마스크를 겁니다. 질의 $i$ 가 열쇠 $j \gt i$ 를 못 보게 하는 삼각형 모양의 마스크로, 인과 마스크causal mask 라고 부릅니다. 탐지 디코더는 이것을 쓰지 않습니다. DETR 논문의 말대로 객체 $N$ 개를 차례로가 아니라 한꺼번에(병렬로) 내놓기 때문에, 질의들이 서로를 자유롭게 봅니다.
실험: 질의가 그림에서 도형을 찾는다
부품을 다 만들었으니 어텐션이 실제로 “찾아서 가져오는” 모습을 봅시다. DETR 디코더의 축소판으로, 학습되는 질의 3개 와 교차 어텐션 한 층 만 씁니다.
과제와 모델
도형 세상 그림에 빨강 · 초록 · 파랑 도형을 하나씩 놓습니다(도형의 종류 · 크기 · 위치는 무작위). 질의도 셋입니다. 첫째 질의는 빨간 도형의 중심을, 둘째는 초록, 셋째는 파란 도형의 중심 $(c_x, c_y)$ 를 맞혀야 합니다. 모델의 흐름과 텐서 모양은 다음과 같습니다.
- 그림
(B, 3, 96, 96)을 8×8 패치 144개로 자르고, 패치마다 픽셀 $3 \times 8 \times 8 = 192$ 개를 한 줄로 폅니다 →(B, 144, 192). - 선형 층 하나로 토큰 벡터로 바꿉니다 →
(B, 144, 64). 여기에 2차원 사인 위치 인코딩(144, 64)를 더합니다(원 논문처럼 입력에 한 번). - 학습되는 질의
(3, 64)가 질의, 그림 토큰이 열쇠와 값인 교차 어텐션(머리 1개) →(B, 3, 64). 가중치는(B, 3, 144). - 작은 2층 신경망과 시그모이드로 중심을 냅니다 →
(B, 3, 2). 손실은 정답 중심과의 L1 거리입니다.
머리를 하나만 쓴 것은 가중치 (3, 144) 를 12×12 로 접어 질의마다의 어텐션 지도 로 바로 읽기 위해서입니다. 매개변수는 모두 33,474개인 아주 작은 모델입니다.
학습용 그림 4,000장, 검증용 1,000장을 쓰고 30 에폭 학습합니다.
재는 것은 둘입니다.
- 검증 중심 오차: 예측한 중심과 정답 중심의 좌표 차이(절댓값)의 평균을 픽셀로 나타낸 것. 견줄 기준선은 “그림을 보지 않고 늘 평균 중심을 답하기” 입니다.
- 맡은 도형 위의 어텐션: 질의의 가중치 144개 가운데, 자기가 맡은 색 도형이 걸쳐 있는 패치에 떨어진 가중치의 합. 1 에 가까우면 그 도형만 본다는 뜻이고, 가중치가 144개에 고르게 퍼져 있다면 도형이 차지한 패치의 비율(평균 0.103)이 나옵니다.
초기값에 따라 결과가 달라지는지 보려고, 같은 모델을 시드만 바꿔 다섯 번 학습했습니다. 견줄 대상으로 위치 인코딩을 더하지 않은 모델도 하나 학습합니다.
[찾기] 학습 4000장, 검증 1000장 (6.9초). 그림 (3, 96, 96) → 토큰 (144, 192)
[찾기] 기준선(늘 학습 데이터의 평균 중심을 답함): 검증 중심 오차 17.06 픽셀. 고른 어텐션이라면 맡은 도형 위의 가중치 합 0.103
[찾기 · 위치 인코딩 있음] 시드 0: 검증 중심 오차(픽셀) 에폭 1 · 5 · 10 · 30 = 16.99, 13.96, 11.71,  2.90 | 맡은 도형 위의 어텐션 0.019 → 도형만 빼고 본다
[찾기 · 위치 인코딩 있음] 시드 1: 검증 중심 오차(픽셀) 에폭 1 · 5 · 10 · 30 = 16.97,  2.07,  1.30,  1.06 | 맡은 도형 위의 어텐션 0.935 → 도형을 본다
[찾기 · 위치 인코딩 있음] 시드 2: 검증 중심 오차(픽셀) 에폭 1 · 5 · 10 · 30 = 16.91,  2.09,  1.31,  1.06 | 맡은 도형 위의 어텐션 0.971 → 도형을 본다
[찾기 · 위치 인코딩 있음] 시드 3: 검증 중심 오차(픽셀) 에폭 1 · 5 · 10 · 30 = 16.09,  2.83,  1.59,  1.10 | 맡은 도형 위의 어텐션 0.960 → 도형을 본다
[찾기 · 위치 인코딩 있음] 시드 4: 검증 중심 오차(픽셀) 에폭 1 · 5 · 10 · 30 = 17.00, 15.06, 12.34,  6.76 | 맡은 도형 위의 어텐션 0.014 → 도형만 빼고 본다
[찾기 · 위치 인코딩 없음] 시드 0: 검증 중심 오차(픽셀) 에폭 1 · 5 · 10 · 30 = 17.07, 17.06, 17.06, 17.07 | 맡은 도형 위의 어텐션 0.012
[찾기] '도형을 본다' 풀이: 시드 3개, 마지막 검증 중심 오차 평균 1.07 픽셀 (최소 1.06, 최대 1.10)
[찾기] '도형만 빼고 본다' 풀이: 시드 2개, 마지막 검증 중심 오차 평균 4.83 픽셀 (최소 2.90, 최대 6.76)
[찾기] 모델 6개 학습 40.3초, 모델 매개변수 33,474개
결과: 풀이가 둘이다
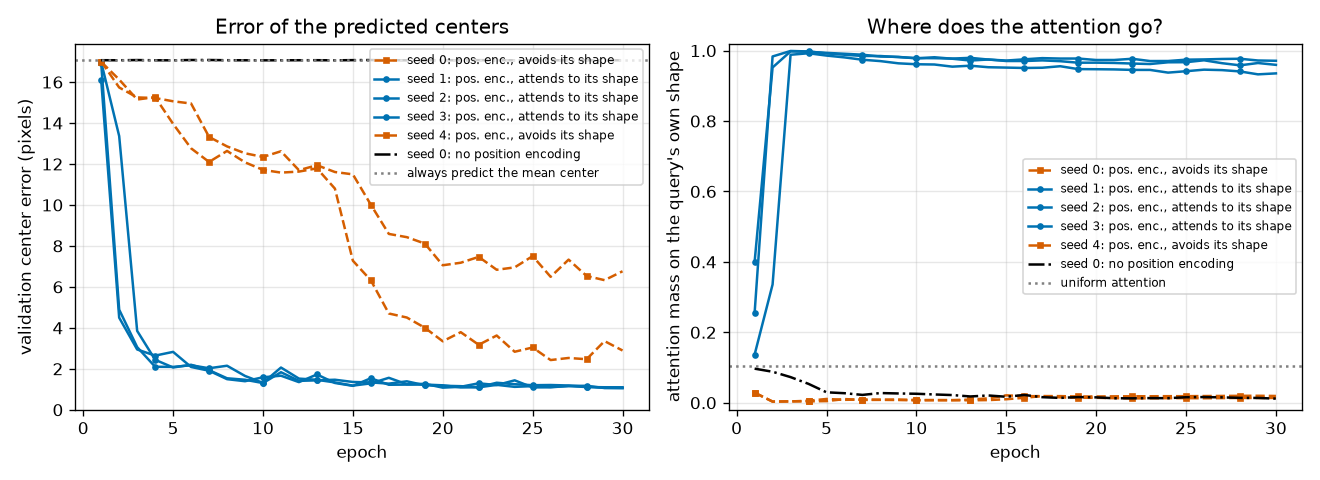
위치 인코딩이 있는 다섯 모델은 모두 기준선(17.06 픽셀)보다 훨씬 잘 맞힙니다. 그런데 오른쪽 그림에서 다섯 시드가 두 무리 로 뚜렷이 갈립니다. 기대하지 않았던 결과이지만 그대로 싣고 따져 봅니다.
- 도형을 보는 풀이(시드 1, 2, 3): 맡은 도형 위의 어텐션이 두세 에폭 만에 1 가까이로 뛰고, 30 에폭에 0.93 – 0.97 입니다. 오차도 5 에폭 만에 2 – 3 픽셀로 떨어져 마지막에는 평균 1.07 픽셀입니다.
- 도형만 빼고 보는 풀이(시드 0, 4): 맡은 도형 위의 어텐션이 0.014 – 0.019 입니다. 고르게 볼 때의 0.103 보다도 훨씬 낮으니, 그 도형을 일부러 피하는 것입니다. 그런데도 오차는 천천히 줄어 30 에폭에 2.90, 6.76 픽셀입니다(곡선이 아직 내려가는 중입니다).
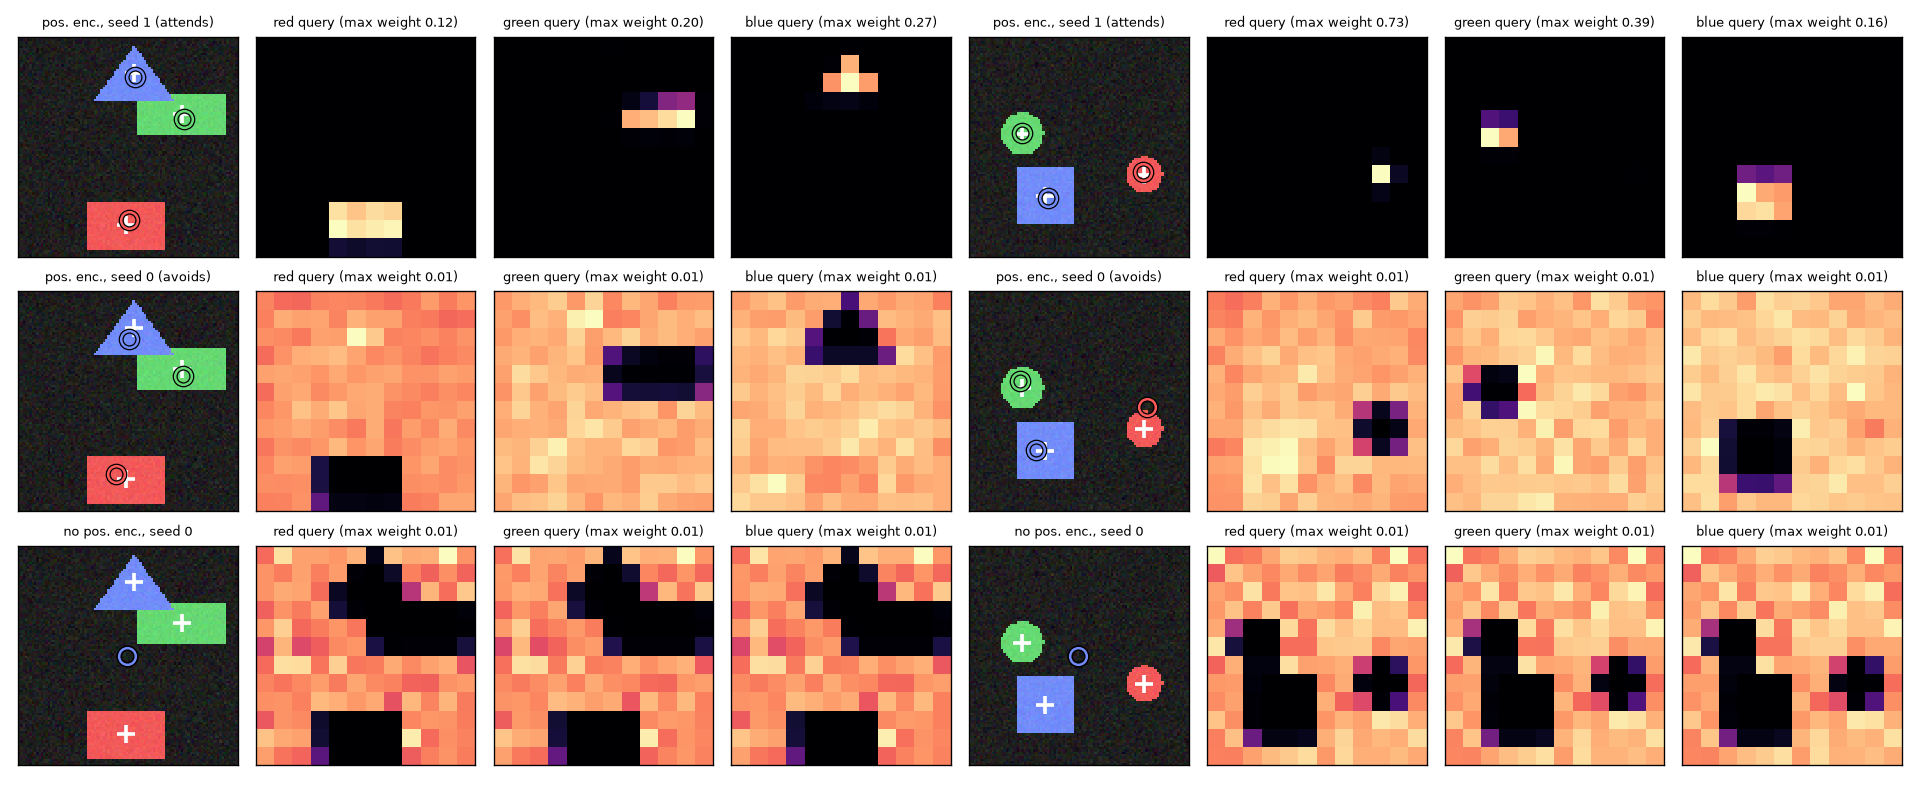
그림 5-10 을 줄마다 읽어 봅시다.
- 첫 줄(도형을 본다): 빨강 질의의 지도는 빨간 도형이 있는 패치만 밝고 나머지는 까맣습니다. 초록 · 파랑 질의도 저마다 자기 도형만 봅니다. 질의는 “빨간 것” 을 찾고, 열쇠가 “나는 빨갛다” 고 답한 토큰의 값에서 “나는 여기에 있다” 를 가져온 것입니다. 이 장에서 설명한 “찾아서 가져오기” 그대로이고, 예측 동그라미가 + 위에 놓입니다.
- 둘째 줄(도형만 빼고 본다): 지도가 뒤집혀 있습니다. 그림 전체가 고르게 밝고(가중치의 최댓값이 0.01 로, 고른 값 $1/144 \approx 0.007$ 과 비슷합니다), 맡은 도형의 자리만 까맣게 비어 있습니다.
둘째 풀이가 어떻게 위치를 맞히는지는 “출력은 값의 가중 평균” 이라는 사실로 풀이할 수 있습니다. 맡은 도형이 걸친 토큰의 집합을 $T$ (토큰 $n$ 개)라 하고, 나머지 $N - n$ 개 토큰을 고르게 본다면 출력은
$$ o = \frac{1}{N - n} \sum_{j \notin T} v_j = \frac{1}{N - n} \Big( \sum_{j=1}^{N} v_j - \sum_{j \in T} v_j \Big) $$입니다. 값에 실린 위치 정보를 모든 토큰에 걸쳐 더한 것은 그림이 달라져도 같습니다(격자는 늘 같으니까요). 그러니 출력에는 “전체에서 무엇이 빠졌는가” 곧 맡은 도형의 위치가 남습니다. 빈자리를 보고 위치를 아는 셈입니다. 다만 다른 두 도형의 내용까지 함께 평균에 섞여 들어오므로 신호가 흐리고, 이 실험에서 더 느리게 배우고 오차도 더 컸던 것은 그 때문으로 보입니다.
- 어텐션은 내용으로 찾고(열쇠: 무슨 색인가) 다른 정보를 가져올(값: 어디에 있는가) 수 있습니다. 세 시드에서 질의는 가중치의 93 – 97% 를 자기 도형에 주었습니다.
- 같은 구조 · 같은 데이터 · 같은 손실인데도 초기값에 따라 전혀 다른 어텐션 지도 가 나올 수 있습니다. 손실은 “중심을 맞혀라” 고만 했지 “도형을 보라” 고 하지 않았습니다.
- 그래서 어텐션 지도를 “모델이 중요하게 여기는 곳” 으로 읽을 때는 조심해야 합니다. 둘째 풀이의 지도는 맡은 도형만 까맣지만, 그 모델은 바로 그 도형의 위치를 맞히고 있습니다.
이것은 층 하나 · 머리 하나짜리 장난감 모델에서 본 것입니다. 큰 탐지기에서는 어떨까요? DETR 논문은 학습된 디코더의 어텐션을 그려 보이고(논문 그림 6), 질의가 물체의 머리나 다리 같은 끝부분 을 주로 본다고 적습니다. 첫째 풀이 쪽의 모습입니다.
위치 인코딩을 빼면
위치 인코딩을 더하지 않은 모델(검정 쇄선, 그림 5-10 의 셋째 줄)은 전혀 배우지 못합니다. 검증 오차가 30 에폭 내내 17.06 – 17.07 픽셀로, 그림을 보지 않고 평균 중심을 답하는 기준선(17.06)과 같습니다. 그림 5-10 의 셋째 줄에서 세 질의의 예측 동그라미는 그림 한가운데쯤의 한 점에 겹쳐 있습니다.
까닭은 앞 절에서 유도한 그대로입니다. 위치 인코딩이 없으면 토큰에는 패치의 픽셀 내용만 들어 있습니다. 질의가 빨간 토큰을 찾아낼 수는 있어도, 그 토큰의 값 어디에도 “나는 어디에 있다” 가 없습니다. 가져올 위치 정보가 없으니 가장 나은 답은 평균입니다. 세 질의의 지도는 서로 거의 같고, 어느 색이든 도형이 있는 자리를 모두 피합니다. 평균을 답하는 데는 그림마다 달라지는 도형 토큰이 방해만 되므로 배경만 보게 된 것으로 풀이할 수 있습니다.
6장의 ViT 가 패치 토큰에 위치 임베딩을 더하는 것도, 7장의 DETR 이 어텐션 층마다 위치 인코딩을 더하는 것도 이 때문입니다.
실험: 토큰 수와 시간
마지막으로 “토큰 수의 제곱” 을 시계로 확인합니다. $D = 256$, 머리 8개의 자기 어텐션 한 번에 걸리는 시간을 토큰 수 $N$ 을 144 에서 4,096 까지 바꿔 가며 잽니다(배치 1, CPU 스레드 하나).
직접 구현한 MultiHeadAttention 과, 가중치를 돌려받지 않게 한 내장 nn.MultiheadAttention 을 함께 잽니다.
[시간] N =   144 (쌍     20,736개): 직접 구현    0.906 ms, 내장(가중치 안 돌려줌)    0.903 ms
[시간] N =   576 (쌍    331,776개): 직접 구현    8.026 ms, 내장(가중치 안 돌려줌)    6.989 ms
[시간] N =  1024 (쌍  1,048,576개): 직접 구현   50.701 ms, 내장(가중치 안 돌려줌)   29.119 ms
[시간] N =  1600 (쌍  2,560,000개): 직접 구현  125.457 ms, 내장(가중치 안 돌려줌)   70.994 ms
[시간] N =  2304 (쌍  5,308,416개): 직접 구현  289.069 ms, 내장(가중치 안 돌려줌)  138.507 ms
[시간] N =  4096 (쌍 16,777,216개): 직접 구현  969.299 ms, 내장(가중치 안 돌려줌)  452.642 ms
[시간] N 이 144 → 4096 (28.4배, N² 은 809배)일 때 시간: 직접 구현 1069배, 내장 501배
[시간] 로그-로그 직선 맞춤의 기울기(시간 ∝ N^기울기): 직접 구현 2.14, 내장 1.88
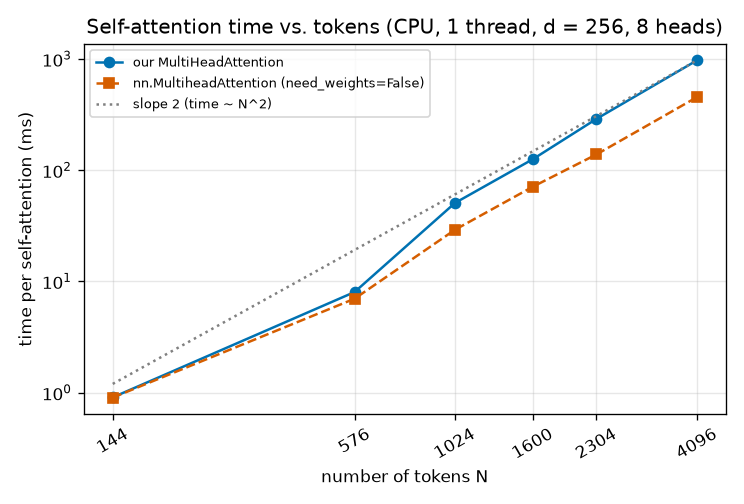
출력과 그림 5-11 에서 읽을 것은 다음과 같습니다.
- 전체 추세는 제곱입니다. 토큰이 144개에서 4,096개로 28.4배 늘 때 토큰 쌍은 809배가 되고, 시간은 직접 구현이 1,069배, 내장 모듈이 501배 늘었습니다. 로그-로그 그림에서 직선의 기울기는 “시간이 $N$ 의 몇 제곱으로 느는가” 인데, 여섯 점에 맞춘 기울기가 2.14 와 1.88 로 둘 다 2 근처입니다. 두 곡선이 회색 점선(기울기 2)과 나란합니다.
- 토큰이 많을수록 제곱에 가깝습니다. $N$ 을 1,024 에서 4,096 으로 4배 늘리면(토큰 쌍 16배) 직접 구현은 $969.299 / 50.701 \approx 19.1$ 배, 내장 모듈은 $452.642 / 29.119 \approx 15.5$ 배 느려집니다. 반면 144 에서 576 으로 4배 늘릴 때는 $8.026 / 0.906 \approx 8.9$ 배로 16배에 못 미칩니다. 어텐션 층에는 $N$ 에 그냥 비례하는 일도 있기 때문입니다. 투영 넷($W_Q, W_K, W_V, W_O$)은 토큰마다 $D \times D$ 행렬을 곱하므로 곱셈이 약 $4 N D^2$ 번이고, 점수 계산은 약 $N^2 D$ 번입니다. 둘이 같아지는 곳이 $N = 4D = 1{,}024$ 이므로, 그보다 토큰이 적으면 투영이, 많으면 제곱 항이 시간을 좌우합니다.
- 내장 모듈이 더 빠릅니다. $N = 4{,}096$ 에서 직접 구현 969 ms, 내장 모듈 453 ms 로 두 배쯤 차이가 납니다. 같은 식을 계산하지만, 내장 모듈은 가중치 행렬을 돌려주지 않아도 되는 만큼 메모리를 덜 쓰는 구현을 고를 수 있습니다. 그래도 두 곡선은 거의 나란합니다. 구현을 다듬으면 상수배가 줄 뿐, 제곱으로 느는 성질은 그대로입니다.
잰 방법도 적어 둡니다. 계산량의 추세만 보려고 CPU 의 스레드 하나로, 이 프로그램이 CPU 를 실제로 쓴 시간을 쟀습니다. 이 튜토리얼을 쓴 컴퓨터에서는 다른 작업이 함께 돌고 있어서 같은 측정을 되풀이하면 점 하나하나가 두 배 가까이 달라지기도 했습니다. 그러니 밀리초 값 자체보다 추세 를 읽으세요. 여러분의 컴퓨터에서는 숫자가 다르게 나오겠지만 기울기는 2 근처일 것입니다.
앞의 표로 돌아가면, RF-DETR N(토큰 576개)과 2XL(1,936개)의 백본은 층마다 이 제곱 비용을 치릅니다. 모든 층에서 모든 토큰이 서로를 보게 두면 해상도를 올릴 때마다 비용이 가파르게 뜁니다. 9장의 윈도 어텐션이 필요한 까닭입니다.
PyTorch 2.0 부터는 이 장의 첫 함수와 같은 일을 하는 torch.nn.functional.scaled_dot_product_attention 이 들어 있습니다. 다중 머리 어텐션 절의 마지막 [check] 줄에서 우리 구현과 결과가 같다는 것을 확인했습니다.
내장 함수는 같은 식을 계산하되, 쓸 수 있으면 더 빠른 구현을 골라 씁니다. 그 가운데 널리 알려진 것이 Flash AttentionFlashAttention(Dao 외, 2022)입니다.
$N \times N$ 가중치 행렬을 통째로 메모리에 만들어 두지 않고 작은 덩어리로 나눠 계산해서, 결과는 그대로이면서 메모리를 읽고 쓰는 양을 줄이는 방법입니다. 근사가 아니라 같은 값을 냅니다.
그 대신 가중치 행렬을 돌려주지 않으므로, 어텐션 지도를 그리려면 이 장에서처럼 직접 계산해야 합니다.
RF-DETR 논문도 4절에서 백본을 견주며 이 최적화를 언급합니다. SAM2 의 Hiera 백본이 기대만큼 빠르지 않았던 까닭으로, Hiera 가 “TensorRT 같은 컴파일러에서 고도로 최적화되어 있는 Flash Attention 커널” 을 고려하지 않았다는 점을 듭니다. 어텐션이 얼마나 빠른가는 식만이 아니라 배포 도구가 그 연산을 얼마나 잘 다듬어 놓았는가에도 달려 있다는 점을 짚은 것입니다. 지연 시간을 재는 이야기는 12장과 14장에서 합니다.
- 어텐션은 모든 토큰이 모든 토큰을 한 층 만에 보게 한다. 토큰은 벡터 하나이고, 이 튜토리얼에서는 그림 패치 또는 객체 질의다.
- 질의와 열쇠의 내적으로 점수를 내고, 소프트맥스로 가중치를 만들고, 값을 가중 평균한다: $\operatorname{Attention}(Q, K, V) = \softmax(QK^\top/\sqrt{d_k})\,V$. 모양은 $(N_q, d_k), (N_k, d_k), (N_k, d_v) \to (N_q, N_k) \to (N_q, d_v)$.
- 성분이 독립이고 분산 1 이면 $\Var(q \cdot k) = d_k$. $\sqrt{d_k}$ 로 나눠 분산을 1 로 맞추면 소프트맥스가 처음부터 한 곳에 쏠려 기울기 $\alpha(1 - \alpha)$ 가 사라지는 일을 막는다.
- 자기 어텐션은 $Q, K, V$ 가 같은 토큰에서, 교차 어텐션은 $Q$ 와 $K, V$ 가 다른 토큰에서 온다. DETR 디코더에서는 객체 질의가 그림 토큰을 본다.
- 자기 어텐션의 비용은 토큰 수의 제곱 $O(N^2 D)$ 이다. 8장의 변형 어텐션과 9장의 윈도 어텐션이 이것을 줄인다.
- 마스크는 점수에 $-\infty$ 를 더해 가중치를 정확히 0 으로 만든다(열쇠 패딩 마스크, 어텐션 마스크).
- 다중 머리 어텐션은 $D$ 를 머리 $h$ 개로 나눠($d_k = D/h$) 따로 어텐션하고 이어 붙인다. 매개변수는 $4(D^2 + D)$ 개로 머리 수와 무관하다($D = 256$ 이면 263,168).
- 어텐션은 순서를 모른다($f(PX) = Pf(X)$). 사인 위치 인코딩을 더해 위치를 알려 주며, 두 위치 인코딩의 내적은 간격에만 달려 있다. 그림에는 $y$ 절반 · $x$ 절반의 2차원 인코딩을 쓴다.
- Transformer 층 = 어텐션 + FFN, 각각 잔차 연결과 층 정규화. post-norm 은 $\operatorname{LN}(x + f(x))$, pre-norm 은 $x + f(\operatorname{LN}(x))$. 디코더 층은 자기 어텐션 → 교차 어텐션 → FFN.
- 이 장의 실험에서 교차 어텐션 한 층은 색으로 도형을 찾아 그 위치를 가져왔고, 위치 인코딩이 없으면 전혀 맞히지 못했다. 시드에 따라 “도형만 빼고 보는” 풀이도 나왔다.
확인 문제
질의 $q = (2, 2)$, 열쇠 $k_1 = (1, 0)$, $k_2 = (0, 1)$, $k_3 = (1, 1)$, 값은 숫자 하나씩 $v_1 = 10$, $v_2 = 20$, $v_3 = 30$ 입니다($d_k = 2$, $d_v = 1$). 점수, 가중치, 출력을 구하세요. ($e^{1.4142} = 4.113$, $e^{2.8284} = 16.919$)
답 보기
내적은 $(2, 2, 4)$, $\sqrt{2}$ 로 나눈 점수는 $(1.4142, 1.4142, 2.8284)$ 입니다. 지수는 $(4.113, 4.113, 16.919)$, 합은 $25.145$.
가중치는 $(4.113/25.145,\; 4.113/25.145,\; 16.919/25.145) = (0.1636, 0.1636, 0.6728)$.
출력은 $0.1636 \times 10 + 0.1636 \times 20 + 0.6728 \times 30 = 1.636 + 3.272 + 20.184 = 25.09$. 세 값 10, 20, 30 의 범위 안에 있고, 가장 잘 맞는 셋째 쪽으로 치우쳐 있습니다.
객체 질의 300개가 그림 토큰 576개를 보는 교차 어텐션입니다($D = 256$, 머리 8개, 배치 1). 머리 하나의 $d_k$, 가중치 텐서의 모양과 성분의 수, 출력의 모양을 적으세요.
답 보기
$d_k = 256/8 = 32$. 가중치는 (1, 8, 300, 576) 으로 $8 \times 300 \times 576 = 1{,}382{,}400$ 개. 출력은 질의의 수를 따라 (1, 300, 256) 입니다. 그림 토큰 576개는 바뀌지 않습니다.
질의 · 열쇠의 성분이 모두 독립이고 평균 0, 분산 $\sigma^2$ 이라면 $\Var(q \cdot k)$ 는 얼마입니까? 점수의 분산을 1 로 만들려면 무엇으로 나눠야 합니까?
답 보기
본문의 유도에서 $\E[a_m^2] = \E[c_m^2] = \sigma^2$ 으로 바뀌므로 $\Var(a_m c_m) = \sigma^2 \cdot \sigma^2 = \sigma^4$, 따라서 $\Var(q \cdot k) = d_k\, \sigma^4$ 입니다. 표준편차 $\sigma^2\sqrt{d_k}$ 로 나누면 분산이 1 이 됩니다. $\sigma = 1$ 이면 본문의 $\sqrt{d_k}$ 와 같습니다.
$D = 384$, 머리 6개, FFN 확장 비율 $r = 4$ 인 Transformer 인코더 층 하나(6장에서 볼 ViT-S 의 크기)의 매개변수를 세세요. 편향을 포함하고, 층 정규화 둘도 넣습니다(층 정규화 하나는 배율 $D$ 개 + 이동 $D$ 개).
답 보기
어텐션: $4(D^2 + D) = 4 \times (147{,}456 + 384) = 591{,}360$. 머리 수 6 은 쓰이지 않습니다.
FFN: 은닉 $4 \times 384 = 1536$. $(384 \times 1536 + 1536) + (1536 \times 384 + 384) = 591{,}360 + 590{,}208 = 1{,}181{,}568$.
층 정규화: $2 \times (384 + 384) = 1{,}536$. 합 $591{,}360 + 1{,}181{,}568 + 1{,}536 = 1{,}774{,}464$.
패치 크기 16 인 백본에 한 변 384 의 그림을 넣다가 768 로 바꾸었습니다. 토큰 수와, 자기 어텐션의 토큰 쌍 수는 몇 배가 됩니까? 해상도는 384 그대로 두고 패치 크기를 8 로 줄이면 어떻습니까?
답 보기
384/16 = 24 이므로 토큰 $24^2 = 576$ 개, 쌍 331,776개. 768/16 = 48 이므로 토큰 $48^2 = 2{,}304$ 개(4배), 쌍 5,308,416개(16배).
해상도 384 에 패치 8 이면 384/8 = 48 로 격자가 같습니다. 토큰 수가 (한 변 ÷ 패치 크기)² 로 정해지므로, 해상도를 두 배로 하는 것과 패치를 절반으로 하는 것은 비용이 똑같이 늡니다.
어떤 질의의 가중치가 $(0.5, 0.3, 0.2)$ 였습니다. 둘째 열쇠를 마스크로 가리면 가중치는 어떻게 됩니까? 점수를 몰라도 구할 수 있는 까닭도 설명하세요.
답 보기
$(0.5/0.7,\; 0,\; 0.2/0.7) = (0.714,\; 0,\; 0.286)$ 입니다. 가중치는 $\alpha_j = e^{s_j}/C$ ($C$ 는 지수들의 합) 꼴이라, 가리지 않은 열쇠들의 $e^{s_j}$ 끼리의 비율은 가중치끼리의 비율 $0.5 : 0.2$ 와 같습니다. 마스크는 분모에서 둘째 항만 빼므로, 남은 가중치를 그 합 $0.5 + 0.2 = 0.7$ 로 다시 나눈 것과 같습니다.
$D = 4$ 인 1차원 사인 위치 인코딩에서 $PE(0) \cdot PE(2)$ 를 두 가지 방법으로 구하세요. (가) 본문 표의 벡터를 직접 내적하기, (나) 공식 $\sum_i \cos(\omega_i \Delta)$ 쓰기. ($\cos 2 = -0.4161$, $\cos 0.02 = 0.9998$)
답 보기
(가) $PE(0) = (0, 1, 0, 1)$, $PE(2) = (0.9093, -0.4161, 0.0200, 0.9998)$ 이므로 내적은 $0 - 0.4161 + 0 + 0.9998 = 0.5837$.
(나) 간격 $\Delta = 2$, $\omega_0 = 1$, $\omega_1 = 0.01$ 이므로 $\cos(2) + \cos(0.02) = -0.4161 + 0.9998 = 0.5837$. 같습니다. 자기 자신과의 내적 $D/2 = 2$ 보다 작습니다.
위치 인코딩 없이 자기 어텐션 층을 여러 번 거친 뒤, 모든 토큰의 출력을 평균 내어 그림 전체의 벡터 하나를 만들었습니다. 그림의 패치를 마구 섞어 넣으면 이 벡터는 어떻게 됩니까? 이 모델로 “그림에 빨간 도형이 있는가” 와 “빨간 도형이 왼쪽에 있는가” 가운데 무엇을 맞힐 수 있습니까?
답 보기
자기 어텐션 층은 순열 등변이므로 섞어 넣으면 토큰별 출력이 같은 순서로 섞일 뿐이고, 평균은 순서와 상관없으므로 벡터는 전혀 변하지 않습니다(순열 불변). 따라서 “빨간 도형이 있는가” 처럼 패치의 내용만으로 정해지는 것은 맞힐 수 있지만, “왼쪽에 있는가” 는 맞힐 수 없습니다. 섞기 전과 후의 그림에 같은 답을 내야 하기 때문입니다. 본문 실험에서 위치 인코딩이 없는 모델이 기준선에서 한 발짝도 나아가지 못한 것과 같은 이유입니다.
이제 어텐션과 Transformer 층이라는 부품이 손에 있습니다. 6장에서는 이 부품으로 그림을 읽는 백본을 만듭니다. 그림을 패치로 잘라 토큰으로 바꾸고, 학습되는 위치 임베딩을 더하고, pre-norm 인코더 층을 쌓으면 Vision Transformer 입니다. 그리고 RF-DETR 이 왜 하필 DINOv2 라는 이름의 ViT 를 백본으로 골랐는지, 그 사전 학습이 무엇인지 알아봅니다.