딥러닝과 PyTorch 기초
World Model 은 결국 신경망 입니다. “상태와 행동을 넣으면 다음 상태가 나오는 함수” 를 신경망으로 만들고, 데이터를 보며 그 함수를 조금씩 고쳐 나갑니다. 이 장에서는 그 “고쳐 나가는 법” — 미분, 경사 하강법, 역전파 — 을 고등학교 수학에서 출발해 한 줄씩 유도하고, 2층 신경망의 역전파를 숫자로 끝까지 손계산한 뒤 PyTorch 가 같은 숫자를 내는 것을 확인합니다. 마지막에는 그림을 읽는 합성곱 신경망(CNN)으로 진자 그림에서 각도를 읽어 냅니다.
- 신경망을 “매개변수를 가진 함수” 로 보는 관점과 손실 함수의 역할
- 미분의 정의와 규칙(거듭제곱 · 곱 · 지수 · 로그 · 연쇄 법칙), 편미분과 기울기 벡터
- 경사 하강법이 왜 손실을 줄이는지(테일러 근사), 학습률이 너무 크면 왜 발산하는지
- 시그모이드 · tanh · ReLU 와 그 미분, 2층 신경망 역전파 손계산
- 소프트맥스 + 교차 엔트로피의 기울기 $p - y$, 미니배치 · Adam(편향 보정 유도)
- 과적합 · 검증 데이터 · L2 정규화 · 입력 표준화
- PyTorch 의 텐서 · 모양 · 브로드캐스팅,
nn.Module, 학습 고리 5단계 - 합성곱 · 출력 크기 공식 · 전치 합성곱, 그리고 CNN 으로 진자 그림 읽기
신경망은 매개변수를 가진 함수다
중학교에서 배운 일차 함수 $y = 2x + 1$ 을 떠올려 봅시다. 여기서 2 와 1 은 고정된 숫자입니다. 이 숫자를 비워 두고 $y = wx + b$ 라고 쓰면, $w$ 와 $b$ 를 바꿀 때마다 다른 직선이 됩니다. 이렇게 함수의 모양을 정하는 조절 손잡이를 매개변수parameter라고 합니다.
신경망neural network 은 이 생각을 아주 크게 키운 것입니다. 손잡이가 수천 개에서 수십억 개까지 있고, 그 손잡이들을 적당히 돌려 놓으면 “그림 → 각도”, “(상태, 행동) → 다음 상태” 처럼 복잡한 함수도 흉내 낼 수 있습니다. 매개변수를 모두 묶어 $\theta$ 라고 쓰고, 신경망이 나타내는 함수를 $f_\theta$ 라고 씁니다.
$$ \hat{y} = f_\theta(x) $$“학습” 이란 데이터 $\{(x_i, y_i)\}$ 를 보고 $f_\theta(x_i)$ 가 $y_i$ 에 가까워지도록 $\theta$ 를 찾는 일입니다. 이렇게 입력 $x_i$ 마다 정답 $y_i$ 가 짝지어진 데이터로 배우는 것을 지도 학습supervised learning이라고 합니다. “얼마나 가까운가” 를 숫자 하나로 잰 것을 손실 함수loss function $L(\theta)$ 라고 합니다. 가장 흔한 손실은 평균 제곱 오차mean squared error, MSE 입니다.
$$ L(\theta) = \frac{1}{N} \sum_{i=1}^{N} \big(f_\theta(x_i) - y_i\big)^2 $$예측이 정답과 같으면 0, 멀어질수록 커집니다. 왜 하필 “제곱” 인지는 2장에서 가우시안 분포의 최대우도로 설명합니다. 지금은 “틀린 정도를 양수로 만들어 평균 낸 것” 으로 충분합니다. 학습은 결국 다음 문제를 푸는 것입니다.
$$ \theta^\ast = \argmin_\theta L(\theta) $$6장의 World Model 도 똑같습니다. 입력 $x$ 가 (상태, 행동), 정답 $y$ 가 다음 상태일 뿐입니다. 그래서 이 장에서 배우는 도구가 이후 모든 장의 바탕이 됩니다.
남은 질문은 하나입니다. 손잡이 $\theta$ 를 어느 쪽으로, 얼마나 돌려야 $L$ 이 줄어드는가? 이 질문에 답하는 도구가 미분입니다.
미분: 기울기를 재는 도구
미분의 정의
함수 $f(x)$ 의 미분derivative $f'(x)$ 는 “$x$ 를 아주 조금 바꿨을 때 $f$ 가 몇 배로 바뀌는가”, 즉 그래프의 기울기입니다. $x$ 를 $h$ 만큼 움직였을 때의 평균 기울기는 $\frac{f(x+h) - f(x)}{h}$ 이고, $h$ 를 0 에 한없이 가깝게 줄인 값이 미분입니다.
$$ f'(x) = \frac{df}{dx} = \lim_{h \to 0} \frac{f(x+h) - f(x)}{h} $$$\lim_{h \to 0}$ 은 “$h$ 를 0 에 한없이 가깝게 할 때 다가가는 값” 이라는 뜻입니다(0 을 직접 넣으면 $\frac{0}{0}$ 이 되어 계산할 수 없으므로 “다가가는 값” 을 봅니다). $f(x) = x^2$ 의 $x = 3$ 에서의 기울기를 숫자로 재 봅시다.
| $h$ | $f(3+h)$ | $\frac{f(3+h) - f(3)}{h}$ |
|---|---|---|
| 0.1 | $3.1^2 = 9.61$ | $(9.61 - 9)/0.1 = 6.1$ |
| 0.01 | $3.01^2 = 9.0601$ | $(9.0601 - 9)/0.01 = 6.01$ |
| 0.001 | $3.001^2 = 9.006001$ | $(9.006001 - 9)/0.001 = 6.001$ |
$h$ 가 작아질수록 6 에 다가갑니다. 이번에는 식으로 정확히 구해 봅시다.
미분 규칙
매번 극한을 계산할 수는 없으므로, 자주 쓰는 규칙을 한 번씩 유도해 두고 그 뒤로는 규칙만 씁니다. 신경망 학습에 필요한 규칙은 다섯 가지면 충분합니다.
① 상수배 · 합의 규칙
$(c\,f)' = c\,f'$, $(f + g)' = f' + g'$. 정의식의 분자에서 $c$ 를 밖으로 빼거나 $f$ 와 $g$ 부분을 나눠 쓰면 바로 나옵니다. 예: $(3x^2 + x)' = 3 \cdot 2x + 1 = 6x + 1$.
② 거듭제곱 규칙
③ 곱의 규칙
④ 지수 · 로그 함수
$e \approx 2.71828$ 은 “$\lim_{h \to 0} \frac{e^h - 1}{h} = 1$ 이 되는 특별한 수” 로 정의할 수 있습니다($h = 0.001$ 이면 $\frac{e^{0.001} - 1}{0.001} = 1.0005\ldots$). 이 성질 하나로 $e^x$ 의 미분이 나옵니다.
⑤ 연쇄 법칙 — 역전파의 전부
함수 안에 함수가 들어 있는 합성 함수composite function $y = f(g(x))$ 의 미분입니다. 신경망은 층을 겹겹이 쌓은 합성 함수이므로, 이 규칙 하나가 곧 역전파 알고리즘입니다. 가운데 값을 $u = g(x)$ 라고 부르겠습니다.
예: $y = (3x + 1)^2$. 안쪽 $u = 3x + 1$, 바깥 $y = u^2$ 이므로 $\frac{dy}{dx} = 2u \cdot 3 = 6(3x+1)$. $x = 1$ 이면 $24$. 검산: $x = 1.001$ 이면 $y = 4.003^2 = 16.024009$, $x = 1$ 이면 $16$, 기울기 $\approx 0.024009/0.001 = 24.009$. 맞습니다.
편미분과 기울기 벡터
신경망의 손실은 매개변수 여러 개의 함수입니다. 이때는 하나만 움직이고 나머지는 고정 해서 미분하는데, 이를 편미분partial derivative이라 하고 $\partial$(“라운드 디” 또는 “파셜”)로 씁니다. 예를 들어 데이터 한 점 $(x, y) = (2, 5)$ 에 대한 손실 $L(w, b) = (wx + b - y)^2 = (2w + b - 5)^2$ 을 봅시다.
$\nabla_\theta L$ 의 각 성분은 “그 매개변수를 아주 조금 키우면 손실이 얼마나 커지는가” 입니다. 양수면 그 매개변수를 줄여야 하고, 음수면 키워야 합니다. 그리고 다음 절에서 보듯, 기울기 벡터는 손실이 가장 가파르게 커지는 방향 을 가리킵니다.
경사 하강법
기울기 반대로 가면 손실이 준다
경사 하강법gradient descent은 다음 한 줄을 되풀이합니다. $\eta$(에타)는 학습률learning rate, 한 번에 얼마나 움직일지 정하는 작은 양수입니다.
$$ \theta \leftarrow \theta - \eta \, \nabla_\theta L(\theta) $$왜 이렇게 하면 손실이 줄어들까요? “아주 조금 움직이면 함수는 거의 직선처럼 변한다” 는 1차 테일러 근사first-order Taylor approximation로 설명할 수 있습니다.
한 걸음 더 나가면, 같은 거리 $\|\Delta\|$ 를 움직일 때 손실을 가장 많이 줄이는 방향이 정확히 $-\nabla L$ 임도 보일 수 있습니다.
학습률이 너무 크면 왜 발산하는가
가장 단순한 그릇 모양 손실 $L(w) = \frac{a}{2}w^2$ ($a \gt 0$, 최솟값은 $w = 0$)에서 경사 하강을 정확히 풀어 보면, 학습률의 한계가 깔끔하게 나옵니다. $a$ 는 그릇이 얼마나 가파르게 휘었는지, 즉 곡률curvature입니다.
곡률이 큰(가파른) 방향일수록 허용되는 학습률이 작습니다. 매개변수가 여러 개면 방향마다 곡률이 다르고, 가장 가파른 방향 이 학습률의 상한을 정합니다. 바로 아래 선형 회귀 예제에서 이 한계를 실제 숫자로 확인합니다.
선형 회귀를 손으로 학습시키기
점 세 개 $(1, 3), (2, 5), (3, 7)$ 에 직선 $\hat{y} = wx + b$ 를 맞춥니다(정답은 $y = 2x + 1$). 손실은 MSE 입니다. 먼저 기울기 공식을 유도합니다.
이제 $w = b = 0$ 에서 출발해 학습률 $\eta = 0.05$ 로 두 스텝을 손으로 갑니다.
같은 계산을 numpy 로 씁니다. 손으로 유도한 기울기 공식이 코드 두 줄(dw, db)이 됩니다.
이 장의 모든 실습은 ch04_basics.py 하나에 들어 있고, wm_envs.py 와 같은 폴더에서
python ch04_basics.py 로 차례대로 실행됩니다. 이 튜토리얼을 쓴 환경(노트북 CPU 4스레드)에서 전체 약 3~6분(대부분 마지막 CNN 학습),
python ch04_basics.py --quick 은 약 10초 걸렸습니다. 그림은 figures/ 폴더에 저장됩니다. 이 작은 예제들은 GPU 로 돌려도 거의 빨라지지 않습니다.
  step 0: w=0.0000 b=0.0000 loss=27.6667  dL/dw=-22.6667 dL/db=-10.0000
  step 1: w=1.1333 b=0.5000 loss=5.4885  dL/dw=-10.0889 dL/db=-4.4667
  step 2: w=1.6378 b=0.7233 loss=1.0897  dL/dw=-4.4874 dL/db=-2.0022
  2000 스텝 뒤: w=2.0000, b=1.0000, loss=1.43e-24
  lr=0.01  200 스텝 뒤 loss=5.556e-04
  lr=0.05  200 스텝 뒤 loss=1.154e-05
  lr=0.17  200 스텝 뒤 loss=8.211e-11
  lr=0.19  200 스텝 뒤 loss=1.601e+19
손계산과 코드의 숫자가 정확히 같습니다. 학습률을 바꾼 결과도 보세요. 0.17 은 잘 수렴하는데 0.19 는 손실이 $10^{19}$ 까지 폭발합니다.
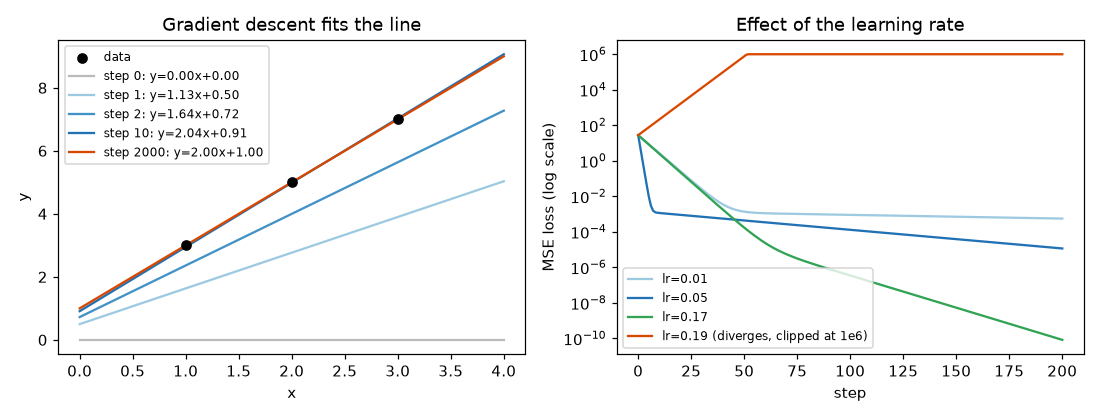
손실이 $w$, $b$ 두 개의 함수라서 “곡률” 이 방향마다 다릅니다. 두 번 미분한 값을 모은 표(헤세 행렬)는 $\frac{\partial^2 L}{\partial w^2} = \frac{2}{N}\sum x_i^2 = \frac{2}{3}(1 + 4 + 9) = \frac{28}{3} \approx 9.333$, $\frac{\partial^2 L}{\partial b^2} = 2$, $\frac{\partial^2 L}{\partial w \partial b} = \frac{2}{N}\sum x_i = 4$ 입니다.
활성 함수와 층 쌓기
선형 층
신경망의 기본 부품은 선형 층linear layer, fully-connected layer입니다. 입력 벡터 $x \in \R^{n}$ 을 가중치 행렬 $W \in \R^{m \times n}$ 과 편향 $b \in \R^m$ 으로 바꿉니다.
$$ z = W x + b, \qquad z_j = \sum_{i=1}^{n} W_{ji}\, x_i + b_j $$$z_j$ 는 “입력에 가중치를 곱해 더하고 편향을 더한 값”, 즉 $j$ 번째 출력 하나가 $y = wx + b$ 를 여러 입력으로 넓힌 것입니다. 예: $W = \begin{pmatrix} 0.5 & -0.4 \\ 0.3 & 0.8 \end{pmatrix}$, $x = \begin{pmatrix} 1 \\ 0.5 \end{pmatrix}$, $b = \begin{pmatrix} 0.1 \\ -0.2 \end{pmatrix}$ 이면 $z_1 = 0.5 \cdot 1 + (-0.4)\cdot 0.5 + 0.1 = 0.4$, $z_2 = 0.3 \cdot 1 + 0.8 \cdot 0.5 - 0.2 = 0.5$ 입니다(조금 뒤 역전파 예제에서 그대로 씁니다).
왜 비선형 함수가 필요한가
선형 층만 두 개 쌓으면 어떻게 될까요?
그래서 층과 층 사이에 구부러진 함수, 활성 함수activation function를 끼웁니다. $h = \sigma(Wx + b)$ 처럼 각 성분에 따로따로 적용합니다. 은닉 뉴런이 충분히 많으면 이 작은 구부림들을 모아 (유한한 구간 위의) 어떤 연속 함수든 원하는 만큼 가깝게 흉내 낼 수 있다는 것이 보편 근사 정리universal approximation theorem입니다.
시그모이드 · tanh · ReLU
시그모이드
$\sigma(z) = \frac{1}{1 + e^{-z}}$ 는 어떤 실수든 0 과 1 사이로 눌러 줍니다. $\sigma(0) = 0.5$, $\sigma(2) \approx 0.881$, $\sigma(-2) \approx 0.119$. “확률” 이나 “0~1 사이의 밝기” 를 출력할 때 씁니다. 미분이 아주 예쁜 꼴이 됩니다.
tanh
$\tanh(z) = \frac{e^z - e^{-z}}{e^z + e^{-z}}$ 는 $-1$ 과 $1$ 사이로 눌러 줍니다. 출력의 평균이 0 근처라 은닉층에 쓰기 좋고, RNN(9장)에서 자주 씁니다. 시그모이드를 늘이고 옮긴 것과 같아서 미분도 시그모이드에서 바로 나옵니다.
ReLU
$\mathrm{ReLU}(z) = \max(0, z)$. 음수는 0 으로, 양수는 그대로. 미분은 $z \gt 0$ 이면 1, $z \lt 0$ 이면 0 입니다($z = 0$ 에서는 정의되지 않지만 보통 0 으로 둡니다). 계산이 가장 싸고, 양수 쪽 미분이 1 로 줄어들지 않아서 깊은 신경망에서 기본으로 씁니다.
시그모이드의 미분은 최대 0.25 입니다. 층을 10개 쌓으면 역전파 때 이런 값이 10번 곱해져 $0.25^{10} \approx 10^{-6}$ 까지 줄 수 있습니다. 앞쪽 층에 기울기가 거의 전달되지 않는 이 현상을 기울기 소실vanishing gradient이라 합니다. 그래서 은닉층에는 ReLU 를 주로 쓰고, 시그모이드는 “0~1 사이 출력” 이 꼭 필요한 마지막 층에만 씁니다. RNN 에서 이 문제가 다시 나옵니다(9장).
역전파: 2층 신경망을 손으로 계산하기
이제 모든 도구가 모였습니다. 아주 작은 신경망 하나를 골라, 순전파 · 역전파를 숫자로 끝까지 계산해 봅니다. 역전파backpropagation는 새로운 수학이 아니라 “연쇄 법칙을 출력 쪽에서부터 차례로 적용하고, 중간 결과를 재사용하는 것” 일 뿐이라는 것을 직접 확인하는 것이 목표입니다.
신경망과 숫자
| 부분 | 식 | 값 |
|---|---|---|
| 입력 | $x = (x_1, x_2)$ | $(1.0,\ 0.5)$ |
| 1층(은닉 2개) | $z = W_1 x + b_1$, $h = \sigma(z)$ | $W_1 = \begin{pmatrix} 0.5 & -0.4 \\ 0.3 & 0.8 \end{pmatrix}$, $b_1 = (0.1,\ -0.2)$ |
| 2층(출력 1개) | $\hat{y} = w_2 \cdot h + b_2$ | $w_2 = (1.2,\ -0.7)$, $b_2 = 0.05$ |
| 손실 | $L = (\hat{y} - y)^2$ | 정답 $y = 1.0$ |
순전파
역전파
목표는 매개변수 9개($W_1$ 의 4개, $b_1$ 의 2개, $w_2$ 의 2개, $b_2$)에 대한 $\frac{\partial L}{\partial(\cdot)}$ 입니다. 출력 쪽부터 거꾸로 갑니다. 각 단계에서 바로 앞(오른쪽)에서 구한 값에 국소 미분 하나를 곱하는 것뿐입니다.
- 각 노드에서 하는 일은 단 하나: (오른쪽에서 받은 기울기) × (이 노드의 국소 미분) 을 왼쪽으로 넘긴다.
- 국소 미분에는 순전파에서 계산한 값($h_j$, $x_i$)이 다시 쓰인다. 그래서 순전파 값을 메모리에 저장해 둔다.
- 출력 쪽에서 한 번 계산한 $\frac{\partial L}{\partial \hat{y}}$ 가 모든 매개변수의 기울기에 재사용된다. 매개변수가 수십억 개여도 역전파 비용이 순전파의 2~3배 정도에 그치는 이유다.
한 스텝 갱신해 보기
학습률 $\eta = 0.1$ 로 9개 매개변수를 모두 $\theta \leftarrow \theta - \eta\,\frac{\partial L}{\partial \theta}$ 로 고칩니다. 예를 들어 $w_{2,1} = 1.2 - 0.1 \times (-0.799004) = 1.279900$, $W_{1,11} = 0.5 - 0.1 \times (-0.384780) = 0.538478$, $b_2 = 0.05 - 0.1\times(-1.334593) = 0.183459$ 입니다. 고친 매개변수로 다시 순전파하면 $\hat{y} = 0.599293$, $L = 0.160566$. 한 스텝 만에 손실이 0.4453 에서 0.1606 으로 줄었습니다.
PyTorch 로 확인하기
같은 계산을 numpy 로 한 줄씩 옮긴 것이 아래 코드입니다. 주석의 식이 위 풀이 상자의 각 줄과 짝을 이룹니다.
이제 PyTorch 의 자동 미분autograd에 맡겨 봅니다. 순전파만 쓰고 .backward() 를 부르면,
PyTorch 가 순전파 때 기록해 둔 계산 그래프를 거꾸로 따라가며 위와 똑같은 연쇄 법칙 계산을 해 줍니다.
requires_grad=True 는 “이 텐서에 대한 기울기를 구해 달라” 는 표시이고, 결과는 그 텐서의 .grad 에 들어갑니다.
  z=[0.4 0.5], h=[0.598688 0.622459], y_hat=0.332704, L=0.445284
  [손계산] dL/dw2 = [-0.799004 -0.83073 ]  dL/db2 = -1.334593
  [손계산] dL/dW1 = [[-0.38478, -0.19239], [0.219544, 0.109772]]  dL/db1 = [-0.38478   0.219544]
  [autograd] dL/dw2 = [-0.799004 -0.83073 ]  dL/db2 = -1.334593
  [autograd] dL/dW1 = [[-0.38478, -0.19239], [0.219544, 0.109772]]  dL/db1 = [-0.38478   0.219544]
  두 결과가 같은가? True
손으로 구한 9개의 숫자와 autograd 의 숫자가 소수점 여섯째 자리까지 같습니다. 앞으로는 역전파를 직접 쓰지 않고 autograd 에 맡기지만, 그 안에서 일어나는 일은 정확히 이 풀이 상자 라는 것을 기억해 두세요. 8장의 “재매개변수화 트릭” 이나 12장의 “상상 속에서 기울기를 흘려보내기” 는 모두 “연쇄 법칙이 끊기지 않게 계산 그래프를 잇는 요령” 입니다.
분류: 소프트맥스와 교차 엔트로피
출력이 “여러 개 중 하나” 인 문제(분류)에서는 신경망이 클래스마다 점수 $z_k$(로짓logit)를 내고, 소프트맥스softmax로 확률로 바꿉니다. 이 조합은 DreamerV2 · V3 의 범주형 잠재 변수(12장)와 이산 행동 정책(5장)에서 쓰입니다.
$$ p_k = \frac{e^{z_k}}{\sum_{j=1}^{K} e^{z_j}} $$$e^{z}$ 는 늘 양수이고, 모두 더한 값으로 나누므로 $p_k$ 는 0 과 1 사이, 합은 1 이 됩니다. 예: $z = (2,\ 1,\ 0.1)$ 이면 $e^z = (7.389,\ 2.718,\ 1.105)$, 합 $11.213$, 그러므로 $p = (0.659,\ 0.242,\ 0.099)$.
정답이 클래스 $c$ 일 때 손실은 정답 클래스 확률의 음의 로그, 교차 엔트로피cross-entropy입니다. 정답을 원-핫 벡터 $y$ (정답 자리만 1, 나머지 0)로 쓰면 $L = -\sum_k y_k \log p_k = -\log p_c$. 정답 확률이 1 이면 손실 0, 0 에 가까우면 손실이 끝없이 커집니다. 이 손실이 어디서 왔는지는 2장(최대우도)과 3장(정보 이론)에서 다룹니다. 여기서는 그 기울기가 놀랍도록 간단하다는 것을 유도합니다.
import torch
import torch.nn.functional as F

z = torch.tensor([2.0, 1.0, 0.1], requires_grad=True)  # 로짓
target = torch.tensor(0)                               # 정답 클래스 = 0번
loss = F.cross_entropy(z.unsqueeze(0), target.unsqueeze(0))
loss.backward()
print("p      =", torch.softmax(z, dim=0).detach().numpy().round(4))
print("loss   =", round(loss.item(), 4))
print("dL/dz  =", z.grad.numpy().round(4))   # p − y 와 같은가?
p = [0.659 0.2424 0.0986] loss = 0.417 dL/dz = [-0.341 0.2424 0.0986]
MSE 의 기울기도 $\frac{\partial}{\partial\hat{y}}\frac{1}{2}(\hat{y} - y)^2 = \hat{y} - y$, 시그모이드 + 이진 교차 엔트로피의 기울기도 $\sigma(z) - y$ 입니다. “예측 − 정답” 이 신호가 되는 이 공통점은 우연이 아니라, 세 손실 모두 어떤 확률 분포의 음의 로그 가능도이기 때문입니다(2장).
미니배치 · SGD · Adam
미니배치와 확률적 경사 하강
손실은 보통 데이터 $N$ 개의 평균 $L = \frac{1}{N}\sum_{i=1}^N \ell_i$ 이고, 기울기도 평균 $\nabla L = \frac{1}{N}\sum_i \nabla \ell_i$ 입니다. $N$ 이 백만이면 한 스텝 가는 데 백만 번 계산해야 합니다. 그래서 매번 무작위로 $B$ 개(예: 64개)만 뽑아 그 평균 기울기로 한 스텝 갑니다. 이 $B$ 개 묶음을 미니배치minibatch, 이 방법을 확률적 경사 하강stochastic gradient descent, SGD이라 합니다.
용어: 미니배치 하나로 한 번 갱신하는 것을 스텝(step) 또는 반복(iteration), 데이터 전체를 한 바퀴 도는 것을 에폭(epoch) 이라고 합니다.
모멘텀과 지수 이동 평균
미니배치 기울기는 출렁입니다. 그래서 지난 기울기들의 평균 쪽으로 가면 더 안정적입니다. 최근 것에 더 큰 가중치를 두는 평균, 지수 이동 평균exponential moving average, EMA을 씁니다.
Adam
Adamadaptive moment estimation은 오늘날 가장 많이 쓰는 최적화 알고리즘이고, 이 튜토리얼에서 신경망을 학습시키는 실습도 (10장에서 컨트롤러를 CMA-ES 로 학습하는 것만 빼고) 모두 Adam 을 씁니다. 기울기의 평균(1차 모멘트)과 기울기 제곱의 평균(2차 모멘트)을 함께 들고 다닙니다. 매개변수 하나하나에 따로 적용합니다.
$$ \begin{aligned} m_t &= \beta_1 m_{t-1} + (1-\beta_1)\, g_t &&\text{기울기의 이동 평균 (방향)}\\ v_t &= \beta_2 v_{t-1} + (1-\beta_2)\, g_t^2 &&\text{기울기 제곱의 이동 평균 (크기)}\\ \hat{m}_t &= \frac{m_t}{1 - \beta_1^t},\quad \hat{v}_t = \frac{v_t}{1 - \beta_2^t} &&\text{편향 보정}\\ \theta_t &= \theta_{t-1} - \eta\, \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} &&\text{갱신} \end{aligned} $$기본값은 $\beta_1 = 0.9$, $\beta_2 = 0.999$, $\epsilon = 10^{-8}$, 학습률 $\eta = 10^{-3}$ 입니다. 각 항의 뜻은 이렇습니다.
- $\hat{m}_t$: 최근 기울기의 평균 방향(모멘텀). 출렁이는 잡음을 걸러 냅니다.
- $\sqrt{\hat{v}_t}$: 최근 기울기 크기의 대푯값. 나누어 주면 매개변수마다 스텝 크기가 대략 $\eta$ 로 맞춰집니다. 기울기가 늘 같은 방향이면 $\hat{m}/\sqrt{\hat{v}} \approx \pm 1$ 이라 $\eta$ 만큼, 방향이 자주 바뀌면 $\hat{m}$ 이 작아져 조심스럽게 움직입니다. 기울기 크기가 매개변수마다 수천 배 차이 나도 학습률 하나로 다룰 수 있는 이유입니다.
- $\epsilon$: 0 으로 나누는 것을 막는 아주 작은 수.
- 편향 보정: $m_0 = v_0 = 0$ 에서 시작해서 생기는 문제를 바로잡습니다. 아래에서 유도합니다.
과적합 · 검증 데이터 · 정규화
과적합
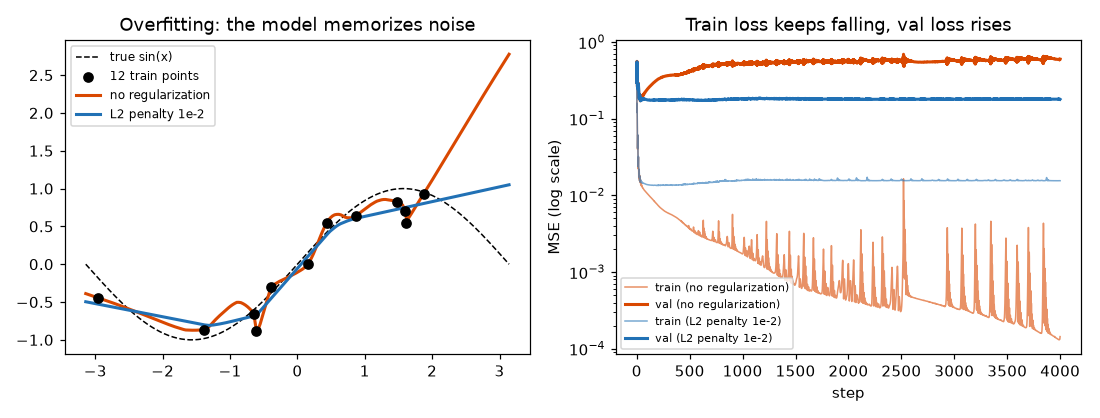
우리가 원하는 것은 훈련 데이터를 외우는 것이 아니라 처음 보는 데이터에서도 잘 맞추는 것, 즉 일반화generalization입니다. 훈련 데이터의 손실은 계속 줄어드는데 처음 보는 데이터의 손실은 오히려 커지는 현상을 과적합overfitting이라 합니다. 그래서 데이터를 나눠 씁니다.
- 훈련(train) 데이터: 기울기를 계산해 매개변수를 고치는 데 씁니다.
- 검증(validation) 데이터: 학습에는 쓰지 않고, 일반화가 잘 되는지 지켜보고 설정(학습률 · 모델 크기 등)을 고르는 데 씁니다.
- 시험(test) 데이터: 모든 결정을 끝낸 뒤 마지막에 한 번만 성능을 잽니다.
극단적인 예를 만들어 봅니다. 잡음이 큰 점 12개에 매개변수 약 6.6만 개짜리 신경망($1 \to 256 \to 256 \to 1$)을 4000 스텝 학습시킵니다.
  no regularization : 마지막 train 0.0001  마지막 val 0.5977  (val 최저 0.1709 @ step 33)
  L2 penalty 1e-2   : 마지막 train 0.0155  마지막 val 0.1793  (val 최저 0.1709 @ step 35)
L2 정규화(가중치 감쇠)
과적합한 모델은 작은 입력 변화에도 출력이 크게 출렁이고, 그러려면 가중치가 커야 합니다. 그래서 손실에 “가중치가 크면 벌점” 을 더합니다.
$$ L_{\text{total}}(\theta) = L(\theta) + \lambda \sum_{w} w^2 $$- 조기 종료(early stopping): 검증 손실이 가장 낮았던 시점의 매개변수를 쓴다. 위 실험에서는 약 30 스텝째.
- 데이터 늘리기: 가장 확실한 처방. World Model 은 환경과 상호작용해 데이터를 계속 모을 수 있다는 장점이 있습니다(7장).
- 드롭아웃 · 모델 줄이기 등. Adam 과 함께 쓸 때는 L2 벌점 대신 감쇠를 갱신식에 직접 넣는
AdamW가 흔히 쓰입니다.
입력 표준화
입력 성분마다 크기가 크게 다르면(예: 각도는 $-\pi$~$\pi$, 속도는 $-8$~$8$) 학습이 느려집니다. 그래서 학습 전에 성분마다 평균을 빼고 표준편차로 나눕니다. 이것을 표준화standardization라고 합니다. 6장의 World Model 도 입력과 출력을 모두 표준화합니다.
$$ x' = \frac{x - \mu}{s}, \qquad \mu = \frac{1}{N}\sum_i x_i,\quad s = \sqrt{\frac{1}{N}\sum_i (x_i - \mu)^2} $$표준화가 왜 학습을 빠르게 하는지는 앞의 선형 회귀로 정확히 보일 수 있습니다. $x = (1, 2, 3)$ 을 표준화하면 $\mu = 2$, $s \approx 0.8165$, $x' \approx (-1.2247,\ 0,\ 1.2247)$ 입니다. 이때 헤세 행렬은 $\frac{\partial^2 L}{\partial w^2} = \frac{2}{N}\sum x_i'^2 = 2 \times 1 = 2$, $\frac{\partial^2 L}{\partial w\,\partial b} = \frac{2}{N}\sum x_i' = 0$, $\frac{\partial^2 L}{\partial b^2} = 2$ 가 되어 두 방향의 곡률이 모두 2 로 같아집니다 (표준화 전에는 11.09 와 0.24 로 46배 차이). 그러면 $\eta = 1/2 = 0.5$ 로 한 스텝 만에 최솟값에 도착합니다. 곡률을 고르게 만드는 것, 이것이 표준화의 진짜 효과입니다.
PyTorch 기초: 텐서와 모양
PyTorch 의 기본 자료형은 텐서tensor, 숫자를 여러 축으로 늘어놓은 배열입니다. 숫자 하나는 0차원, 벡터는 1차원, 행렬은 2차원,
그림 묶음은 4차원 텐서입니다. 텐서를 다룰 때 가장 중요한 정보는 모양(shape), 즉 축마다의 길이입니다. 딥러닝 코드 오류의 대부분이 모양 불일치이므로,
이 튜토리얼의 코드에는 # (B, T, C) 처럼 모양을 주석으로 적어 둡니다.
a.shape        : (2, 3)
a[1, 2]        : 6.0
a.sum(dim=0)   : [5.0, 7.0, 9.0]
a.mean(dim=1)  : [2.0, 5.0]
a + b          : [[11.0, 22.0, 33.0], [14.0, 25.0, 36.0]]
a + c          : [[101.0, 102.0, 103.0], [204.0, 205.0, 206.0]]
(x @ W.T).shape: (5, 4)
x.reshape(15).shape: (15,)
x.unsqueeze(0).shape: (1, 5, 3)
dim: 어느 축을 따라 합치는지.sum(dim=0)은 0번 축(행)을 따라 더해 그 축이 사라지므로 모양 (2, 3) → (3,).- 브로드캐스팅: 모양이 다른 텐서끼리 계산할 때, 오른쪽 축부터 맞춰 보고 길이가 같거나 한쪽이 1(또는 없음)이면 그 축으로 복사해 늘립니다. (2, 3) + (3,) 은 (3,) 을 (1, 3) 으로 보고 2행으로 늘려 더합니다. (2, 3) + (2, 1) 은 (2, 1) 을 3열로 늘립니다. (2, 3) + (2,) 는 오른쪽 축 3 과 2 가 달라 오류입니다.
- 행렬 곱
@: (5, 3) @ (3, 4) → (5, 4). 안쪽 길이(3)가 같아야 하고, 그 축이 사라집니다. 선형 층nn.Linear(3, 4)가 하는 일이 정확히 이것(+ 편향)입니다. - 관례: 맨 앞 축은 배치(데이터 몇 개를 한꺼번에) 입니다. 벡터 데이터는 (B, D), 그림은 (B, C, H, W) = (배치, 채널, 높이, 너비), 시퀀스는 (B, T, D) 로 씁니다(9장부터).
nn.Module 과 학습 고리 5단계
신경망은 nn.Module 을 상속한 클래스로 만듭니다. __init__ 에서 층(매개변수를 가진 부품)을 만들고, forward 에서 순전파를 씁니다.
역전파는 autograd 가 해 주므로 쓰지 않습니다.
이 MLP(다층 퍼셉트론multi-layer perceptron)의 매개변수 개수를 세어 봅시다. nn.Linear(n, m) 은 가중치 $m \times n$ 개와 편향 $m$ 개를 가집니다.
$(1 \times 64 + 64) + (64 \times 64 + 64) + (64 \times 1 + 1) = 128 + 4160 + 65 = 4353$ 개. 아래 실행 결과의 숫자와 같습니다.
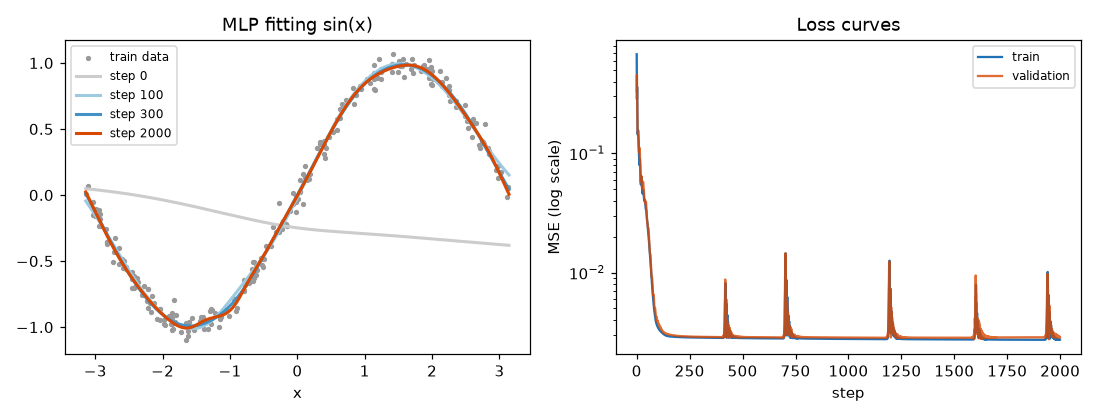
이 신경망으로 $\sin x$ 에 잡음을 섞은 점 256개를 맞춰 봅니다.
그리고 이 튜토리얼에서 수십 번 보게 될 학습 고리 입니다.
  step    0  train 0.67709  val 0.33090
  step  500  train 0.00282  val 0.00288
  step 1000  train 0.00277  val 0.00285
  step 1500  train 0.00274  val 0.00284
  step 1999  train 0.00273  val 0.00286
  매개변수 개수: 4353
optimizer.zero_grad(): PyTorch 는.backward()를 부를 때마다 기울기를.grad에 더합니다(덮어쓰지 않습니다). 지난 스텝의 기울기를 지우지 않으면 기울기가 쌓여 엉뚱한 방향으로 갑니다.- 순전파
model(x_train): 예측을 계산하며, 역전파에 필요한 계산 그래프와 중간값을 기록합니다. - 손실 계산:
nn.MSELoss()는 앞에서 쓴 MSE 와 같습니다. loss.backward(): 역전파. 모든 매개변수의.grad가 채워집니다.optimizer.step(): Adam 갱신식으로 매개변수를 고칩니다.
검증 손실은 torch.no_grad() 안에서 계산합니다. 기울기가 필요 없으니 계산 그래프를 기록하지 않아 빠르고 메모리도 아낍니다.
.item() 은 숫자 하나짜리 텐서를 파이썬 숫자로 꺼냅니다.
합성곱 신경망: 그림을 읽는 신경망
8장부터 World Model 은 64×64 그림을 봅니다. 그림을 4096개 숫자로 펴서 선형 층에 넣으면, 은닉 128개짜리 층 하나에만 매개변수가 $4096 \times 128 + 128 = 524{,}416$ 개 필요합니다. 게다가 “왼쪽 위의 막대” 와 “오른쪽 아래의 막대” 를 완전히 따로 배워야 합니다. 합성곱 신경망convolutional neural network, CNN은 두 가지 생각으로 이를 해결합니다.
- 국소성: 한 번에 작은 영역(예: 3×3 픽셀)만 봅니다. 선 · 모서리 같은 무늬는 작은 영역에 있습니다.
- 가중치 공유: 같은 작은 필터(커널kernel)를 그림 전체에 미끄러지며 적용합니다. 어디에 있든 같은 무늬는 같은 방식으로 찾습니다.
합성곱을 숫자로
4×4 입력에 세로 경계를 찾는 3×3 커널을 적용해 봅니다.
$$ X = \begin{pmatrix} 1 & 2 & 0 & 1 \\ 0 & 1 & 3 & 1 \\ 2 & 1 & 0 & 0 \\ 1 & 0 & 1 & 2 \end{pmatrix},\qquad K = \begin{pmatrix} 1 & 0 & -1 \\ 1 & 0 & -1 \\ 1 & 0 & -1 \end{pmatrix} $$커널을 입력 위에 겹쳐 놓고, 겹친 칸끼리 곱해 모두 더한 값이 출력 한 칸입니다. 커널을 한 칸씩 옮기면 2×2 출력이 나옵니다.
torch.nn.functional.conv2d 로 계산해도 같은 결과가 나옵니다. 학습에서는 커널의 9개 숫자가 매개변수이고, 어떤 무늬를 찾을지 데이터가 정합니다.
흑백 그림은 채널 1개, 컬러는 3개(R, G, B)입니다. nn.Conv2d(C_in, C_out, K) 은 커널을 $C_{\text{out}}$ 개 가지며, 커널 하나는 입력 채널 전부에 걸친 $C_{\text{in}} \times K \times K$ 크기입니다.
그래서 매개변수는 $C_{\text{out}} \cdot C_{\text{in}} \cdot K \cdot K + C_{\text{out}}$(편향) 개. 출력 채널 하나하나가 “어떤 무늬가 어디에 있는지” 를 나타내는 지도(feature map)가 됩니다.
그리고 PyTorch 의 “합성곱” 은 수학 교과서의 합성곱과 달리 커널을 뒤집지 않습니다(엄밀히는 상호 상관). 학습으로 커널을 정하므로 차이가 없습니다.
출력 크기 공식
커널 크기 $K$ 외에 두 가지 설정이 있습니다. 스트라이드stride $S$ 는 커널을 한 번에 몇 칸씩 옮길지, 패딩padding $P$ 는 입력 가장자리에 0 을 몇 줄 덧댈지입니다. 출력 크기를 유도해 봅시다(가로 한 줄만 보면 됩니다).
전치 합성곱: 작은 것을 크게
인코더는 그림을 작게 줄이고, 디코더(8장 VAE, 11장 RSSM)는 작은 잠재 벡터에서 그림을 다시 그려야 합니다. 이때 쓰는 것이
전치 합성곱transposed convolution(nn.ConvTranspose2d)입니다.
입력의 각 값이 커널에 곱해진 “도장” 을 출력에 찍고, 겹치는 자리는 더합니다. 1차원 예: 입력 $(1, 2)$, 커널 $(1, 2, 1)$, 스트라이드 2.
출력 크기는 합성곱 공식을 거꾸로 풀면 나옵니다. 합성곱이 큰 $W_{\text{big}}$ 을 작은 $W_{\text{small}} = \frac{W_{\text{big}} - K + 2P}{S} + 1$ 로 줄인다면(나누어떨어질 때), $W_{\text{big}}$ 에 대해 풀면 $W_{\text{big}} = (W_{\text{small}} - 1)S - 2P + K$ 입니다. 위 예는 $(2-1)\cdot 2 - 0 + 3 = 5$, $K = 4, S = 2, P = 1$ 이면 $(4 - 1)\cdot 2 - 2 + 4 = 8$ — 정확히 두 배가 되어, 인코더의 64 → 32 → 16 → 8 → 4 를 거꾸로 되돌릴 수 있습니다.
Conv2d(k=4, s=2, p=1)        : (1, 1, 64, 64) → (1, 16, 32, 32)
Conv2d(k=3, s=1, p=1)        : (1, 1, 64, 64) → (1, 8, 64, 64)
Conv2d(k=5, s=1, p=0)        : (1, 1, 64, 64) → (1, 8, 60, 60)
ConvTranspose2d(k=4, s=2, p=1): (1, 64, 4, 4) → (1, 32, 8, 8)
실습: 진자 그림에서 각도 읽기
이 장의 마지막 실습입니다. PixelPendulum 의 64×64 그림만 보고 막대의 각도를 $(\cos\theta, \sin\theta)$ 로 맞히는 CNN 을 학습시킵니다.
“그림 → 숫자” 로 바꾸는 이 일은 8장 VAE 인코더가 하는 일의 축소판이고, World Model 이 그림을 다루는 첫 단계입니다.
먼저 무작위 행동으로 진자를 돌리며 (그림, 정답 각도) 쌍을 모읍니다. 정답 각도는 env.state() 로 몰래 꺼내 라벨로만 씁니다.
그림은 0~255 정수라서 255 로 나눠 0~1 로 맞춥니다(표준화의 간단한 형태). unsqueeze(1) 은 채널 축을 만들어 (N, 64, 64) 를 (N, 1, 64, 64) 로 바꿉니다.
모델은 스트라이드 2 합성곱 4개로 64 → 32 → 16 → 8 → 4 로 줄인 뒤, 선형 층으로 숫자 2개를 냅니다.
매개변수는 합성곱 $272 + 8{,}224 + 32{,}832 + 65{,}600$, 선형 층 $131{,}200 + 258$ 로 모두 238,386 개입니다. 64×64 그림을 곧바로 선형 층(은닉 128)에 넣을 때의 절반도 안 되면서 훨씬 잘 배웁니다. 학습 고리는 앞과 같고, 매 스텝 무작위로 64장을 뽑는 미니배치를 씁니다.
  훈련 그림 6000장, 검증 그림 2000장 (모으는 데 2.9초)
  step    0  train 0.51018  val 0.50112
  step  500  train 0.00002  val 0.00003
  step 1000  train 0.00003  val 0.00004
  step 1500  train 0.00001  val 0.00002
  step 2000  train 0.00005  val 0.00003
  step 2500  train 0.00001  val 0.00001
  step 3000  train 0.00003  val 0.00005
  수집 + 학습 시간 200.7초 (장치: cpu)
  검증 각도 오차: 평균 0.26°, 중앙값 0.21°, 최대 0.66°
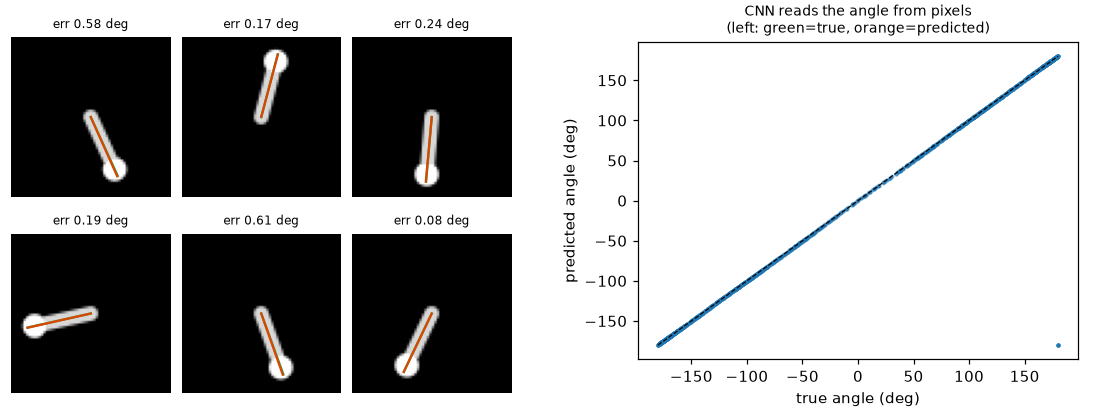
잡음 없는 단순한 그림이라 평균 오차가 1° 도 안 될 만큼 정확합니다. 그런데 이 CNN 은 각속도 $\dot\theta$ 는 절대 맞힐 수 없습니다. 그림 한 장에는 “얼마나 빨리 도는지” 가 담겨 있지 않기 때문입니다. 이 한계가 바로 다음 장에서 배우는 부분 관측 문제이고, 9 · 11장에서 기억(RNN)을 더해 해결합니다.
MLP의act=nn.Tanh를nn.ReLU로 바꾸면 sin 곡선이 어떻게 달라질까요? (꺾인 선분들을 이어 붙인 모양이 됩니다.)- 선형 회귀의 학습률을 0.18 근처에서 바꿔 가며 수렴 · 발산 경계를 찾아보세요.
- CNN 의 합성곱 층을 2개로 줄이면(64 → 32 → 16) 선형 층 입력이 몇이 되고, 정확도는 어떻게 될까요?
정리와 확인 문제
- 신경망은 매개변수 $\theta$ 를 가진 함수 $f_\theta$ 이고, 학습은 손실 $L(\theta)$ 을 줄이는 $\theta$ 를 찾는 것이다.
- 미분은 기울기이고, 연쇄 법칙은 “변화율은 곱해진다” 이다. 기울기 벡터 $\nabla L$ 은 가장 가파른 오르막을 가리킨다.
- 경사 하강 $\theta \leftarrow \theta - \eta\nabla L$ 은 1차 근사에서 손실을 $\eta\|\nabla L\|^2$ 만큼 줄인다. 곡률 $a$ 인 방향에서는 $\eta \lt 2/a$ 여야 수렴한다.
- 역전파 = 출력 쪽부터 (받은 기울기) × (국소 미분) 을 넘기는 연쇄 법칙. autograd 가 정확히 같은 계산을 한다.
- 소프트맥스 + 교차 엔트로피의 기울기는 $p - y$. 미니배치 기울기는 편향 없는 추정, Adam 은 모멘트 두 개와 편향 보정 $1/(1-\beta^t)$ 을 쓴다.
- 과적합은 검증 데이터로 알아채고, L2 정규화(가중치 감쇠) · 조기 종료 · 데이터 늘리기로 막는다. 표준화는 곡률을 고르게 한다.
- 학습 고리 5단계:
zero_grad→ 순전파 → 손실 →backward→step. - CNN 은 국소성과 가중치 공유로 그림을 읽는다. 출력 크기 $\lfloor (W - K + 2P)/S \rfloor + 1$, 전치 합성곱은 $(W-1)S - 2P + K$.
$f(x) = \log(1 + x^2)$ 의 미분을 구하고, $x = 1$ 에서의 값을 계산하세요.
답 보기
연쇄 법칙: 바깥 $\log u$ 의 미분 $\frac{1}{u}$, 안쪽 $u = 1 + x^2$ 의 미분 $2x$. $f'(x) = \frac{2x}{1 + x^2}$, $f'(1) = \frac{2}{2} = 1$.
손실 $L(w) = 2w^2$ 에서 경사 하강이 수렴하는 학습률의 범위는? 한 스텝 만에 최솟값에 도착하는 학습률은?
답 보기
$L = \frac{a}{2}w^2$ 꼴에서 $a = 4$. 수렴 조건 $0 \lt \eta \lt 2/a = 0.5$. $\eta = 1/a = 0.25$ 면 $w \leftarrow (1 - 0.25 \times 4)w = 0$ 으로 한 스텝에 도착합니다.
nn.Conv2d(3, 8, kernel_size=3, stride=2, padding=1) 에 (1, 3, 32, 32) 를 넣으면 출력 모양은? 매개변수는 몇 개?
답 보기
$\lfloor (32 - 3 + 2)/2 \rfloor + 1 = \lfloor 15.5 \rfloor + 1 = 16$ → (1, 8, 16, 16). 매개변수 $8 \times 3 \times 3 \times 3 + 8 = 224$.
로짓 $z = (0, 0)$, 정답 클래스 0 일 때 교차 엔트로피 손실과 $\frac{\partial L}{\partial z}$ 를 구하세요.
답 보기
$p = (0.5, 0.5)$, $L = -\log 0.5 = \log 2 \approx 0.693$. 기울기 $p - y = (0.5 - 1,\ 0.5 - 0) = (-0.5,\ 0.5)$.
Adam 에서 $\beta_1 = 0.9$, 첫 두 스텝의 기울기가 모두 $g$ 일 때 $m_2$ 와 $\hat{m}_2$ 를 구하세요.
답 보기
$m_1 = 0.1g$, $m_2 = 0.9 \times 0.1g + 0.1g = 0.19g$. $\hat{m}_2 = \frac{0.19g}{1 - 0.9^2} = \frac{0.19g}{0.19} = g$. 편향 보정 덕분에 참값 $g$ 가 나옵니다.
학습 고리에서 optimizer.zero_grad() 를 빼먹으면 어떤 일이 생길까요?
답 보기
.backward() 는 기울기를 .grad 에 더하므로, $t$ 번째 스텝의 기울기가 지금까지의 모든 기울기의 합이 됩니다. 스텝이 점점 커지고 엉뚱한 방향으로 가서 학습이 불안정해지거나 발산합니다.
이제 신경망을 만들고 학습시킬 수 있습니다. 하지만 World Model 은 단순히 “맞히는” 모델이 아니라, 행동하는 에이전트 를 돕기 위한 모델입니다. 다음 장에서는 에이전트가 보상을 최대로 하도록 행동을 배우는 틀, 강화학습을 처음부터 쌓아 올립니다.