RF-DETR-Seg: 인스턴스 분할
지금까지 만든 탐지기는 객체마다 박스 하나를 냅니다. 그런데 삼각형을 꼭 맞게 감싼 박스의 절반, 원을 감싼 박스의 5분의 1 남짓은 배경이고, 겹친 객체의 경계가 어디인지는 박스가 알려 주지 못합니다. RF-DETR-Seg 는 탐지기를 거의 그대로 둔 채 가벼운 분할 머리 하나 를 얹어, 객체마다 그 객체가 차지한 픽셀까지 냅니다. 원리는 한 줄입니다. 객체 질의의 임베딩과 픽셀마다의 임베딩을 내적 하면 그 객체의 마스크가 된다. 이 장에서는 그 한 줄을 식과 손계산으로 풀고, 공식 구현의 분할 머리를 층 하나씩 읽고, 11장에서 학습한 미니 RF-DETR 에 같은 머리를 달아 도형 세상에서 학습해 봅니다.
- 인스턴스 분할의 출력(객체마다 클래스 · 박스 · 마스크)과, 마스크를 0/1 격자와 로짓으로 나타내는 법
- 마스크를 “질의 임베딩과 픽셀 임베딩의 내적” 으로 만드는 발상과 2×2 손계산
- 픽셀 임베딩 맵을 프로토타입으로 읽는 법, MaskDINO · YOLACT 와의 관계
- RF-DETR-Seg 분할 머리의 실제 층 구성: 쌍선형 보간, 깊이별 분리 합성곱 블록, 질의 쪽 FFN, 내적과 편향
- 깊이별 분리 합성곱이 무엇이고 매개변수가 몇 개인지 손으로 세기
- 마스크 BCE 와 다이스 손실: 다이스 계수와 IoU 의 관계 유도, 작은 객체에서 두 손실이 어떻게 다른지
- 점 표본 추출: 마스크 전체가 아니라 뽑은 점에서만 손실 · 매칭 비용을 계산하는 방법
- 마스크 로짓에서 최종 마스크까지의 후처리와 마스크 AP
- 논문의 RF-DETR-Seg 결과와, NAS 가 찾은 분할 모델이 탐지 모델과 다르게 생긴 까닭
- 미니 RF-DETR 에 분할 머리를 달아 학습하고, 결과를 층 · 클래스 · 크기 · 가림별로 뜯어 보기
- $H, W$: 입력 그림의 높이 · 너비(픽셀). $h, w$: 프로젝터가 낸 특징 맵의 높이 · 너비(칸). $r$: 마스크를 그림의 몇 분의 1 해상도로 계산하는지(공식 설정 이름
mask_downsample_ratio, 기본값 4). 마스크 로짓의 격자는 $H/r \times W/r$ 입니다. - $(x, y)$: 격자 위의 칸 하나(열, 행). 4장에서 $y$ 는 정답 라벨이었지만 이 장에서는 세로 위치로만 씁니다. 그래서 정답은 $t$ 로 적습니다(target).
- $z$: 로짓, $p = \sigma(z)$: 확률, $t \in \{0, 1\}$: 정답. 첨자 $i$ 는 픽셀(또는 뽑은 점)의 번호이고 $P$ 는 그 개수입니다.
- $D$: 은닉 차원(미니 모델 128, RF-DETR 256). $N$: 질의 수, $n$: 질의 번호. $L$: 디코더 층 수, $l$: 층 번호(1 부터).
- $B$: 텐서 모양 $(B, N, \dots)$ 안에서는 배치 크기입니다. IoU 와 다이스 계수의 식에서만 아래의 집합 $B$ 를 뜻합니다.
- $q_n$: 디코더가 낸 질의 $n$ 의 임베딩(길이 $D$ 의 벡터). $f(q_n)$: 그것을 분할 머리의 FFN 에 통과시킨 벡터. $e(x, y)$: 칸 $(x, y)$ 의 픽셀 임베딩(길이 $D$). $E$: 픽셀 임베딩 맵 전체, 모양 $(D, H/r, W/r)$.
- $\beta$: 마스크 로짓에 더하는 편향(스칼라 하나). $b$ 는 박스에 쓰는 글자라 피했습니다.
- $A$: 예측 마스크가 1 인 픽셀의 집합, $B$: 정답 마스크가 1 인 픽셀의 집합. $|A|$ 는 픽셀 수입니다(2장에서는 넓이였습니다).
- $C$: 매칭의 비용 행렬(7장). 합성곱의 채널 수는 $C$ 대신 $D$ 로 적습니다.
박스에서 마스크로
박스로는 부족한 순간
1장에서 세 가지 문제를 나란히 놓았습니다. 이미지 분류는 그림 전체에 이름표를, 객체 탐지는 객체마다 박스를, 인스턴스 분할은 객체마다 그 객체가 차지한 픽셀을 냅니다. 2장부터 12장까지는 가운데 문제만 풀었습니다. 박스가 모자란 경우는 언제일까요.
그림 13-1 의 숫자는 손으로 셀 수 있습니다. 박스의 너비를 $w_b$, 높이를 $h_b$ 라 하면 박스의 넓이는 $w_b h_b$ 입니다.
- 도형 세상의 삼각형은 밑변 $w_b$, 높이 $h_b$ 인 이등변 삼각형이므로 넓이가 $\tfrac{1}{2} w_b h_b$ 입니다. 박스의 정확히 절반입니다.
- 원은 지름이 $w_b = h_b$ 이므로 넓이가 $\pi (w_b/2)^2 = \tfrac{\pi}{4} w_b^2$ 입니다. 박스의 $\pi/4 \approx 0.785$ 배입니다.
- 사각형만 박스를 꽉 채웁니다.
도형이 박스 안에 통째로 들어 있으므로, “박스를 그대로 객체의 영역이라고 답했을 때” 의 IoU 는 교집합(도형) ÷ 합집합(박스), 곧 위의 비율과 같습니다. 삼각형을 완벽한 박스로 찾아도, 그 박스를 영역으로 쓰면 IoU 가 0.5 에 그칩니다. 박스가 모자란 경우는 셋으로 정리됩니다.
- 모양이 사각형이 아닐 때. 넓이를 재거나(결함의 크기, 작물의 잎 넓이), 배경을 지우거나, 로봇이 집을 자리를 정할 때는 박스 속의 배경이 오차가 됩니다.
- 객체가 겹칠 때. 두 박스가 겹친 자리의 픽셀이 어느 객체의 것인지 박스는 말해 주지 않습니다.
- 가늘고 기울어진 객체. 대각선으로 놓인 막대는 박스의 대부분이 배경입니다(도형 세상에는 없지만 현실에는 흔합니다).
마스크라는 출력
인스턴스 분할의 출력은 객체마다 (클래스, 박스, 마스크) 세 가지입니다. 클래스와 박스는 탐지와 같고, 새로 생긴 것이 마스크입니다. 마스크mask 는 그림과 같은 크기의 격자에 칸마다 0 또는 1 을 적은 것입니다. 1 은 “이 픽셀은 이 객체의 것”, 0 은 “아니다” 입니다. $H \times W$ 그림에 객체가 $T$ 개 있으면 정답 마스크의 모양은 $(T, H, W)$ 입니다. 객체마다 격자 한 장씩입니다.
도형 세상의 정답 마스크는 ShapesDataset(…, with_masks=True) 가 줍니다. 모양은 (객체 수, 96, 96), 자료형은 bool 입니다.
한 가지 약속이 있습니다. 나중에 그려진 도형이 먼저 그려진 도형을 덮으면, 덮인 픽셀은 밑에 깔린(먼저 그려진) 도형의 마스크에서 빠집니다. 마스크는 “실제로 보이는 부분” 만 1 입니다.
그래서 한 픽셀은 많아야 한 객체의 것이고, 가려진 객체의 마스크는 원래 도형보다 작습니다. 박스는 그대로입니다(가려진 부분까지 포함한 원래 도형의 박스).
모델은 0/1 을 바로 내지 않습니다. 4장의 이진 분류와 똑같이 칸마다 로짓 $z$ 를 내고, 시그모이드로 확률 $p = \sigma(z)$ 를 만들고, 0.5 를 넘으면 1 로 봅니다. $\sigma(0) = 0.5$ 이고 시그모이드는 늘 증가하므로 $p \gt 0.5$ 는 $z \gt 0$ 과 같은 말입니다. 그래서 추론 때는 시그모이드를 계산할 필요 없이 로짓의 부호만 봅니다.
| 단계 | 값 | 모양 (질의 $N$ 개) |
|---|---|---|
| 마스크 로짓 | 실수. 클수록 “객체” 쪽 | $(N, H/r, W/r)$ |
| 확률 | $\sigma(z)$, 0 과 1 사이 | 같음 |
| 이진 마스크 | $z \gt 0$ 이면 1 | $(N, H, W)$ — 그림 크기로 키운 뒤 자릅니다 |
표의 $r$ 이 눈에 띕니다. RF-DETR-Seg 는 마스크를 그림 크기가 아니라 그 4분의 1 해상도 로 계산하고, 마지막에만 그림 크기로 키웁니다. 이유는 분할 머리의 구조를 볼 때 다룹니다.
마스크끼리의 IoU
예측 마스크가 정답과 얼마나 맞는지는 2장의 IoU 로 잽니다. 정의는 그대로이고, 넓이를 픽셀 수 로 세는 것만 다릅니다. 예측 마스크가 1 인 픽셀의 집합을 $A$, 정답 마스크가 1 인 픽셀의 집합을 $B$ 라 하면
$$ \IoU(A, B) = \frac{|A \cap B|}{|A \cup B|} = \frac{\text{둘 다 1 인 픽셀 수}}{\text{하나라도 1 인 픽셀 수}} $$
이것을 마스크 IoUmask IoU 라고 부릅니다. 박스 IoU 는 꼭짓점 좌표 네 개로 계산했지만, 마스크 IoU 는 두 격자를 칸마다 견주어 셉니다.
코드로는 두 불(bool) 배열의 & 와 | 를 각각 더한 값의 비입니다.
발상: 질의와 픽셀의 내적
픽셀마다 따로 맞히면 생기는 일
탐지기에는 이미 객체마다 하나씩 객체 질의 가 있습니다(7장). 디코더를 지나온 질의 임베딩 $q_n$ 은 길이 $D$ 의 벡터이고, 여기에 Linear 하나를 달아 클래스를, MLP 를 달아 박스를 냈습니다. 마스크도 같은 식으로 낼 수 있을까요. 질의 임베딩에 Linear 를 달아 마스크의 모든 칸을 한꺼번에 내는 방법을 생각해 봅시다.
RF-DETR-Seg Nano 의 마스크 격자는 78×78 = 6,084칸이고 $D = 256$ 입니다. Linear 하나의 매개변수는 가중치 $256 \times 6{,}084 = 1{,}557{,}504$ 개에 편향 6,084개, 합해서 1,563,588개 입니다. 문제는 수만이 아닙니다.
- 출력 칸 수가 가중치의 모양에 박혀 있어서, 해상도를 바꾸면 쓸 수 없습니다. 12장의 NAS 는 해상도를 손잡이로 돌립니다.
- 질의 임베딩 256개의 숫자만으로 6,084칸의 경계를 그려야 합니다. 객체의 가장자리가 어디인지는 그림의 특징 맵에 있는데, 그것을 직접 쓰지 못합니다.
- 칸 $(3, 5)$ 를 맞히는 법과 칸 $(4, 5)$ 를 맞히는 법을 따로 배웁니다. 이웃한 칸끼리 닮았다는 사실을 쓰지 못합니다.
질의는 묻고 픽셀은 답한다
발상을 바꿉니다. 마스크의 칸을 질의가 혼자 다 그리지 않고, 픽셀 쪽에서도 벡터를 하나씩 내게 합니다.
- 그림의 특징 맵에서, 마스크 격자의 칸마다 길이 $D$ 의 벡터 $e(x, y)$ 를 만듭니다. 이것이 픽셀 임베딩pixel embedding 이고, 모든 칸의 것을 모은 $(D, H/r, W/r)$ 텐서가 픽셀 임베딩 맵 $E$ 입니다. 그림 한 장에 한 번만 만듭니다.
- 질의 임베딩 $q_n$ 을 작은 FFN 에 통과시켜 같은 길이의 벡터 $f(q_n)$ 을 만듭니다. 질의마다 하나입니다.
- 칸 $(x, y)$ 가 질의 $n$ 의 객체에 속하는지는 두 벡터의 내적 으로 정합니다.
이 식을 다르게 읽을 수도 있습니다. $z_n(x, y) \gt 0$ 인지 묻는 것은 벡터 $e(x, y)$ 를 가중치 $f(q_n)$ 과 편향 $\beta$ 를 가진 선형 분류기 에 넣는 것입니다(4장의 뉴런 하나). 보통의 분류기는 가중치가 학습 뒤에 고정되지만, 여기서는 가중치가 질의마다, 그림마다 새로 만들어집니다. 디코더가 “이 객체를 골라내는 분류기” 를 그 자리에서 써 주는 셈입니다.
모든 질의 · 모든 칸을 한꺼번에 계산하면 텐서 연산 하나입니다. 배치까지 넣어 모양을 적으면 다음과 같습니다.
$$ \underbrace{Z_{b,n,y,x}}_{(B,\, N,\, H/r,\, W/r)} \;=\; \sum_{c=1}^{D}\ \underbrace{E_{b,c,y,x}}_{(B,\, D,\, H/r,\, W/r)}\ \underbrace{F_{b,n,c}}_{(B,\, N,\, D)} \;+\; \beta $$
$F$ 는 $f(q_n)$ 을 질의 순서로 쌓은 것이고, 아래 첨자 $b$ 는 배치 안에서 그림의 번호입니다. 코드로는 torch.einsum("bchw,bnc->bnhw", E, F) + bias 한 줄입니다.
einsum 의 글자는 축의 이름이고, 양쪽에 다 있다가 결과에서 사라진 c 축을 따라 곱해 더한다는 뜻입니다. 위 식의 $\sum_c$ 가 바로 이것입니다.
늘어난 것을 세어 보면, 질의가 100개든 300개든 픽셀 임베딩 맵은 하나이고, 격자가 78×78 이든 192×192 든 가중치의 모양은 그대로입니다. 앞 절의 세 문제가 모두 풀립니다.
2×2 격자를 손으로 계산하기
가장 작은 예로 계산해 봅니다. 마스크 격자가 2×2, 임베딩이 2차원($D = 2$), 질의가 2개, $\beta = 0$ 입니다.
질의 2 도 같은 픽셀 임베딩을 씁니다. $f(q_2) = (-1, 1.5)$ 로 계산하면 로짓이 $-2,\ 0.5,\ 3,\ -0.5$ 이고 마스크는 오른쪽 위와 왼쪽 아래 칸입니다. 오른쪽 위 칸은 두 질의 모두에게 양수입니다. 질의마다 따로 판단하므로 이런 겹침을 막는 장치는 없습니다. 학습이 그렇게 되지 않도록 밀어 줄 뿐입니다. 코드가 같은 계산을 출력합니다.
[손계산 1] 내적으로 만드는 마스크: 2×2 픽셀, 임베딩 2차원, 질의 2개
  질의 1 f(q) = [2.0, -1.0]: 로짓 [[4.0, 1.0], [-2.0, -1.0]] → 확률 [[0.982, 0.731], [0.119, 0.269]] → 마스크 [[1, 1], [0, 0]]
  질의 2 f(q) = [-1.0, 1.5]: 로짓 [[-2.0, 0.5], [3.0, -0.5]] → 확률 [[0.119, 0.622], [0.953, 0.378]] → 마스크 [[0, 1], [1, 0]]
픽셀 임베딩은 프로토타입이다
내적의 식을 채널 쪽에서 다시 읽어 봅니다. 픽셀 임베딩 맵 $E$ 의 $c$ 번째 채널만 떼면 $(H/r, W/r)$ 크기의 그림 한 장 $E_c$ 입니다. 그러면 질의 $n$ 의 로짓 지도 전체는
$$ Z_n \;=\; \sum_{c=1}^{D} f(q_n)_c \; E_c \;+\; \beta $$입니다. $D$ 장의 그림 $E_1, \dots, E_D$ 를 계수 $f(q_n)_c$ 로 가중합 한 것입니다. 그림들은 모든 객체가 함께 쓰고, 객체마다 다른 것은 계수뿐입니다. 이렇게 함께 쓰는 바탕 그림을 프로토타입prototype 이라고 부릅니다. 앞의 2×2 예에서는 프로토타입이 두 장이었습니다. 첫 채널은 $\begin{pmatrix} 2 & 1 \\ 0 & -1 \end{pmatrix}$, 둘째 채널은 $\begin{pmatrix} 0 & 1 \\ 2 & -1 \end{pmatrix}$ 이고, 질의 1 의 로짓은 “첫 장의 2배 빼기 둘째 장” 이었습니다. 계수가 음수여서 프로토타입을 빼는 것도 됩니다.
이 이름은 YOLACT(Bolya 외, 2019)에서 왔습니다. YOLACT 는 그림 전체에 대해 $k$ 장의 프로토타입 마스크 $P$(모양 $h \times w \times k$)를 만들고, 탐지된 객체마다 $k$ 개의 마스크 계수를 예측한 뒤, 둘을 행렬곱 한 번과 시그모이드로 합칩니다. 논문의 식 (1) 은 $M = \sigma(P C^{\top})$ 이고 $C$ 는 객체 $n$ 개의 계수를 쌓은 $n \times k$ 행렬입니다. 이 장의 식과 같은 꼴입니다. YOLACT 논문은 프로토타입이 $k = 32$ 장만 되어도 성능이 떨어지지 않는다고 적었습니다. RF-DETR 논문은 자기 분할 머리의 픽셀 임베딩을 “분할 프로토타입(Bolya 외, 2019)으로 해석할 수 있다” 고 한 문장으로 적습니다. 이 장의 실험에서 픽셀 임베딩의 채널을 직접 그려 볼 것입니다.
- 같은 점: 마스크 = (그림마다 한 번 만드는 맵) × (객체마다의 벡터) 를 시그모이드에 넣은 것.
- 계수의 출처: YOLACT 는 앵커마다 달린 합성곱 머리가 계수를 내고(NMS 로 추린 객체에만 씁니다), RF-DETR-Seg 는 디코더가 낸 질의 임베딩에서 계수를 만듭니다. NMS 가 없습니다.
- 장 수: YOLACT 는 $k$ 가 수십 장, RF-DETR-Seg 는 은닉 차원과 같은 $D = 256$ 장입니다.
- YOLACT 는 합친 마스크를 예측 박스로 잘라 냅니다. RF-DETR 의 공식 후처리에는 그런 단계가 없습니다(뒤에서 소스로 확인합니다).
MaskDINO 와 닮은 곳, 다른 곳
RF-DETR 논문은 분할 머리가 MaskDINO(Li 외, 2023)에서 착안했다고 밝힙니다. MaskDINO 는 DETR 계열 탐지기 DINO 에 마스크 가지를 더한 모델이고, 마스크를 논문의 식 (1) 로 냅니다.
$$ m = q_c \otimes \mathcal{M}\big(\mathcal{T}(C_b) + \mathcal{F}(C_e)\big) $$$q_c$ 는 디코더의 내용 질의 임베딩, $\otimes$ 는 내적입니다. 괄호 안이 픽셀 임베딩 맵인데, 그림의 1/4 해상도 백본 특징 맵 $C_b$ 와 Transformer 인코더가 낸 1/8 해상도 특징 맵 $C_e$ 를 키운 것을 더해 만듭니다 ($\mathcal{T}$ 는 채널 수를 맞추는 합성곱, $\mathcal{F}$ 는 $C_e$ 를 2배로 키우는 보간, $\mathcal{M}$ 은 분할 머리). “질의 임베딩과 픽셀 임베딩 맵의 내적” 이라는 뼈대가 RF-DETR-Seg 와 같습니다.
다른 곳은 픽셀 임베딩 맵의 재료입니다. RF-DETR 논문의 표현으로는 “MaskDINO 와 달리, 지연 시간을 줄이려고 다중 스케일 백본 특징을 분할 머리에 넣지 않는다” 입니다. RF-DETR-Seg 의 재료는 프로젝터 출력 한 장 뿐입니다. 디코더의 변형 교차 어텐션이 읽는 바로 그 저해상도 맵을 쌍선형 보간으로 키워서 씁니다. 세밀한 고해상도 특징을 따로 가져오지 않으니 경계의 정밀함에서는 손해를 볼 수 있지만, 백본에서 고해상도 맵을 꺼내 합치는 계산이 통째로 없습니다. 논문 표 3 에서 MaskDINO(R50)는 COCO 마스크 AP 46.3 에 242 ms(PyTorch 로 잰 값), RF-DETR-Seg (medium) 은 45.3 에 5.9 ms(T4, TensorRT FP16)입니다.
RF-DETR-Seg 의 분할 머리
이제 발상을 실제 층으로 옮깁니다. 이 절의 구조는 모두 공식 저장소의 rfdetr/models/heads/segmentation.py(클래스 SegmentationHead)와 models/lwdetr.py 에서 읽은 것입니다.
논문은 분할 머리를 한 문단과 그림 2 로만 설명하므로, 층의 구성은 코드가 기준입니다.
전체 흐름과 텐서 모양
분할 머리segmentation head 는 탐지기에서 두 가지만 받아 씁니다. 프로젝터 출력 한 장, 그리고 디코더 층마다의 질의 임베딩입니다. 백본 · 프로젝터 · 디코더 · 분류 머리 · 박스 머리는 10장과 한 줄도 다르지 않습니다.
SegmentationHead 의 계산 흐름. 위쪽 줄이 픽셀 쪽(그림마다 한 번), 아래쪽 줄이 질의 쪽입니다. $l$ 번째 디코더 층의 질의 임베딩은 블록을 $l$ 개 지나온 픽셀 임베딩 맵 $E_l$ 과 내적됩니다.그림 13-3 을 위에서 아래로, 왼쪽에서 오른쪽으로 읽습니다.
- 프로젝터 출력 $(B, D, h, w)$ 를 쌍선형 보간으로 $(B, D, H/4, W/4)$ 로 키웁니다.
- 깊이별 합성곱 블록을 차례로 지납니다. 블록은 디코더 층 수만큼 있고, 블록 $l$ 의 출력이 블록 $l + 1$ 의 입력입니다.
- 블록 $l$ 의 출력에 1×1 합성곱을 한 번 더 적용한 것이 층 $l$ 의 픽셀 임베딩 맵 $E_l$ 입니다.
- 디코더 $l$ 층이 낸 질의 임베딩을 MLP 블록과 Linear 에 통과시켜 $f(q)$ 를 만듭니다.
- $E_l$ 과 $f(q)$ 를 내적하고 편향 $\beta$ 를 더해 층 $l$ 의 마스크 로짓 $(B, N, H/4, W/4)$ 를 얻습니다.
RF-DETR-Seg Nano 로 모양을 따라가 봅니다. 설치된 rfdetr 패키지의 모델에 훅을 걸어 잰 값입니다(학습된 가중치는 싣지 않았습니다. 모양과 매개변수 수는 가중치와 무관합니다).
[RF-DETR-Seg Nano 모양 추적] 설정: resolution 312, patch_size 12, num_windows 1, dec_layers 4, num_queries 100, hidden_dim 256, mask_downsample_ratio 4 (학습된 가중치는 싣지 않았다)
  그림                                               (1, 3, 312, 312)
  프로젝터 출력                                          (1, 256, 26, 26)
  쌍선형 보간 뒤 = 블록 1 의 입력                             (1, 256, 78, 78)
  블록 1 … 4 의 출력 (각각)                               (1, 256, 78, 78)
  1×1 합성곱 → 픽셀 임베딩 맵 (추론 때 1번 계산)                  (1, 256, 78, 78)
  질의 임베딩 → MLPBlock → Linear                       (1, 100, 256)
  pred_masks (마스크 로짓)                              (1, 100, 78, 78)
  pred_logits / pred_boxes                         ((1, 100, 91), (1, 100, 4))
  추론 모드의 보조 출력 키: ['pred_boxes', 'pred_logits'] × 3 (마스크는 마지막 층만 계산)
  매개변수: 전체 33,577,475개, 그 가운데 분할 머리 933,121개 (2.8%)
해상도 312 를 패치 12 로 나누면 격자가 $312 / 12 = 26$ 칸이고, 마스크 격자는 $312 / 4 = 78$ 칸입니다. 프로젝터 출력을 한 변 3배(칸 수로 9배)로 키우는 것입니다. 질의가 100개이므로 마스크 로짓은 그림 한 장에 $100 \times 78 \times 78 = 608{,}400$ 개의 수입니다. 분할 머리의 매개변수는 933,121개로 모델 전체 33,577,475개의 2.8% 입니다. 전체 수 33.6M 은 논문 표 3 의 RF-DETR-Seg (nano) 매개변수 수와 맞습니다. “가벼운 분할 머리” 라는 말의 실제 크기가 이 정도입니다.
쌍선형 보간으로 해상도 키우기
특징 맵의 칸 수를 늘리는 것을 해상도 키우기upsampling 라고 합니다. 새 칸의 값은 원래 칸들의 값에서 만들어 내야 하는데, 분할 머리는 8장에서 유도한 쌍선형 보간 을 씁니다. 새 격자의 칸 중심마다, 원래 격자에서 그 점을 둘러싼 네 칸의 값을 거리에 따라 가중 평균합니다. 공식 코드는 한 줄입니다.
target_size = (image_size[0] // self.downsample_ratio, image_size[1] // self.downsample_ratio)
spatial_features = F.interpolate(spatial_features, size=target_size, mode="bilinear", align_corners=False)
짚어 둘 것이 셋입니다.
- 학습되는 가중치가 없습니다. 4장의 전치 합성곱처럼 키우는 방법을 배우지 않고, 정해진 식으로 키웁니다. 보간만으로는 새 정보가 생기지 않으므로(흐릿하게 커질 뿐입니다), 뒤따르는 합성곱 블록이 경계를 다듬는 일을 맡습니다.
- 목표 크기가 입력 해상도로 정해집니다. 프로젝터 격자의 몇 배가 아니라 “그림의 1/4” 입니다. 그래서 패치 크기를 바꿔 프로젝터 격자가 달라져도 마스크 격자는 그대로입니다. 이 사실이 뒤에서 NAS 의 결과를 설명할 때 다시 나옵니다.
- 탐지와 같은 맵을 씁니다. 논문 그림 2 의 설명대로, 변형 교차 어텐션도 분할 머리도 프로젝터 출력을 쌍선형 보간으로 읽습니다. 디코더가 박스를 찾을 때 본 특징과 마스크를 그릴 때 쓰는 특징이 같은 맵이므로 둘의 공간 배치가 어긋나지 않습니다.
왜 그림 크기가 아니라 1/4 일까요. 논문은 이유를 따로 적지 않습니다. 계산량으로 따져 보면, 그림 크기로 만들 경우 블록이 다루는 칸 수와 마스크 로짓의 수가 모두 16배가 됩니다. Nano 라면 마스크 로짓이 그림 한 장에 약 973만 개입니다. MaskDINO 의 픽셀 임베딩 맵도 1/4 해상도였습니다.
깊이별 분리 합성곱 블록
키운 맵을 다듬는 블록은 공식 코드의 DepthwiseConvBlock 입니다. 독스트링은 이 블록을 “MLP 부분을 뺀, 단순화한 ConvNeXt 블록” 이라고 소개합니다. 계산 순서는 다음과 같습니다.
- 깊이별 3×3 합성곱 (
nn.Conv2d(dim, dim, kernel_size=3, padding=1, groups=dim)) - 층 정규화 (
nn.LayerNorm(dim, eps=1e-6), 채널 축을 맨 뒤로 옮긴 뒤 적용) - 1×1 합성곱 (
nn.Linear(dim, dim)으로 구현) - GELU 활성 함수
- 입력을 더하는 잔차 연결
1번과 3번을 이은 것이 깊이별 분리 합성곱depthwise separable convolution 입니다. 4장의 보통 합성곱은 출력 채널 하나를 만들 때 입력의 모든 채널 의 3×3 이웃을 한꺼번에 봅니다. “이웃을 보는 일” 과 “채널을 섞는 일” 을 한 필터가 같이 하는 것입니다. 깊이별 분리 합성곱은 이 두 일을 나눕니다.
- 깊이별 합성곱(depthwise): 채널마다 자기 3×3 필터 하나만 가집니다. 채널 $c$ 의 출력은 채널 $c$ 의 이웃만 봅니다. 채널끼리 섞이지 않습니다.
groups=dim이 이 뜻입니다. - 점별 합성곱(pointwise, 1×1): 이웃을 보지 않고, 칸마다 채널들을 섞습니다. 칸마다 같은 Linear 를 적용하는 것과 같아서 공식 코드는
nn.Linear로 씁니다.
블록 하나 전체는 여기에 층 정규화의 256개(채널마다 배율과 이동)를 더한 18,048개입니다. 층 정규화를 쓴 것은 프로젝터와 같은 이유로 읽힙니다. 10장에서 보았듯 RF-DETR 은 작은 배치와 기울기 누적으로도 학습되도록 배치 정규화를 층 정규화로 바꿨습니다. 코드가 센 값입니다.
[손계산 5] 깊이별 분리 합성곱의 매개변수 수 (C = 128, 3×3)
  보통의 3×3 합성곱: 128·128·9 + 128 = 147,584
  깊이별 3×3: 128·9 + 128 = 1,280, 1×1(점별): 128·128 + 128 = 16,512, 합 17,792 (8.3배 적다)
  DepthwiseConvBlock 전체 (층 정규화 256 포함): 18,048
  분할 머리 미니 (D = 128, 블록 3개): 블록 54,144 + 1×1 합성곱 16,512 + 질의 MLP 131,968 + 질의 Linear 16,512 + 편향 1 = 219,137
  분할 머리 RF-DETR-Seg Nano (D = 256, 블록 4개): 블록 275,456 + 1×1 합성곱 65,792 + 질의 MLP 526,080 + 질의 Linear 65,792 + 편향 1 = 933,121
(출력 첫 줄의 C 는 채널 수, 곧 본문의 $D$ 입니다.) 마지막 두 줄이 분할 머리 전체입니다. RF-DETR-Seg Nano 의 933,121개는 앞의 모양 추적에서 잰 값과 같습니다. 눈에 띄는 것은 몫의 배분입니다.
Nano 에서 78×78 격자 위를 네 번 지나가는 블록 넷이 합쳐 275,456개인데, 질의 쪽의 MLP 블록 하나가 526,080개로 머리의 절반이 넘습니다.
매개변수는 질의 쪽에 많지만 계산은 픽셀 쪽에 많습니다. 질의 쪽은 벡터 100개를 한 번 지나가고, 픽셀 쪽은 6,084칸을 네 번 지나가기 때문입니다.
질의 쪽의 FFN 과 내적
질의 쪽은 블록 하나와 Linear 하나입니다. 공식 코드의 MLPBlock 은 5장의 FFN 과 같은 모양입니다.
- 층 정규화
Linear(D, 4D)→ GELU →Linear(4D, D)- 입력을 더하는 잔차 연결
그 뒤에 Linear(D, D)(이름 query_features_proj)가 하나 더 있습니다. 이 둘을 합친 것이 앞에서 $f(\cdot)$ 로 적은 변환입니다. 논문이 “FFN 으로 변환한 질의 토큰 임베딩” 이라고 부른 것입니다.
왜 질의 임베딩을 그대로 내적하지 않을까요. 디코더가 낸 $q_n$ 은 분류 머리와 박스 머리도 함께 읽는 벡터입니다. 클래스를 가리키기 좋은 방향과 픽셀을 골라내기 좋은 방향이 같을 까닭이 없으므로, 마스크 전용의 변환을 한 번 거치게 한 것으로 읽을 수 있습니다.
픽셀 쪽의 1×1 합성곱(spatial_features_proj)도 같은 자리의 짝입니다.
내적은 공식 코드에서도 einsum 한 줄이고, 편향은 스칼라 매개변수 하나입니다.
spatial_features = block(spatial_features)
spatial_features_proj = self.spatial_features_proj(spatial_features)
qf = self.query_features_proj(self.query_features_block(qf))
mask_logits.append(torch.einsum("bchw,bnc->bnhw", spatial_features_proj, qf) + self.bias)
SegmentationHead 에는 bottleneck_ratio 라는 인자가 있어, 내적하는 차원을 $D$ 보다 작게 줄일 수 있게 되어 있습니다(1×1 합성곱과 query_features_proj 의 출력 차원이 in_dim // bottleneck_ratio).
모델을 조립하는 코드(build_model)는 이 인자를 넘기지 않아 기본값 1 이 쓰입니다. 그래서 실제로는 $D$ 차원 그대로 내적합니다.
디코더 층마다 마스크를 낸다
7장의 보조 손실을 떠올려 봅시다. 디코더의 마지막 층만이 아니라 모든 층의 출력에 머리를 달아 손실을 걸었습니다. RF-DETR 은 여기에 뜻을 하나 더 얹었습니다. 모든 층이 쓸 만한 예측을 내도록 학습해 두면, 추론 때 뒤쪽 층을 떼어 내고 빠른 모델로 쓸 수 있습니다(12장의 “디코더 층 수” 손잡이). 분할 머리도 같은 규칙을 따릅니다. 논문 그림 2 의 설명은 “모든 디코더 층에 탐지 손실과 분할 손실을 걸어, 추론 때 디코더 층을 떼어 낼 수 있게 한다” 입니다.
구현을 보면 층과 블록이 짝지어져 있습니다. 모델을 조립할 때 블록 수를 디코더 층 수로 줍니다.
segmentation_head = SegmentationHead(args.hidden_dim, args.dec_layers, downsample_ratio=args.mask_downsample_ratio)
그리고 순전파는 zip(self.blocks, query_features) 로 블록과 층별 질의 임베딩을 한 쌍씩 꺼냅니다. 여기서 세 가지 성질이 나옵니다.
- 층이 깊을수록 픽셀 임베딩도 깊습니다. 1층의 질의는 블록을 한 번 지난 맵과, 4층의 질의는 블록을 네 번 지난 맵과 내적됩니다. 3×3 합성곱을 한 번 지날 때마다 한 칸이 보는 범위가 사방으로 한 칸씩 넓어집니다.
- 디코더를 줄이면 분할 머리도 줄어듭니다. 질의 임베딩이 $k$ 층 것까지만 있으면
zip이 블록도 앞의 $k$ 개만 씁니다. 논문은 이것을 “디코더를 줄이면 분할 가지의 크기도 줄어, 분할의 지연 시간을 더 세밀하게 조절할 수 있다” 고 적습니다. - 추론 때는 마지막 층의 마스크만 계산합니다. 블록은 앞의 것을 지나야 뒤의 것을 계산할 수 있으므로 모두 실행하지만, 1×1 합성곱 · 질의 쪽 변환 · 내적은 마지막 층에만 합니다(인자
final_layer_only=True). 앞의 모양 추적에서 1×1 합성곱이 한 번만 불린 까닭입니다.
10장의 2단계 질의 선택에서 나온 인코더 제안 에도 마스크 손실이 걸립니다. 이때는 디코더 층이 없으니 짝이 될 블록도 없습니다.
공식 코드는 블록을 건너뛰고(skip_blocks=True), 보간한 맵에 1×1 합성곱만 적용한 것을 선택된 칸의 특징과 내적합니다.
디코더를 모두 떼어 낸 모델(디코더 0층)에서는 이 마스크가 곧 예측입니다.
공식 구현은 학습 모드에서 forward 대신 sparse_forward 를 부릅니다. 이 함수는 마스크 로짓을 계산하지 않고, 층마다 (픽셀 임베딩 맵, 질의 쪽 벡터, 편향) 을 사전으로 돌려줍니다.
내적은 손실 함수 안에서, 정답과 매칭된 질의에 대해서만 합니다. 학습 때 Nano 의 질의는 묶음 13개 × 100개 = 1,300개인데 정답과 짝이 된 것은 그 가운데 일부이므로, 나머지의 78×78 로짓 지도를 만들지 않아 메모리를 아낍니다.
결과는 전부 계산한 것과 같습니다. 이 장의 미니 모델은 작아서 그냥 전부 계산합니다.
분할 머리의 구현
미니 모델의 분할 머리는 공식 구현과 같은 계산 을 크기만 줄여 옮긴 것입니다. 먼저 블록입니다.
permute 가 두 번 나오는 것은 축의 순서 때문입니다. 합성곱은 (B, C, H, W) 를, LayerNorm 과 Linear 는 마지막 축이 채널인 (B, H, W, C) 를 받습니다.
머리 전체는 다음과 같습니다.
매개변수 이름(blocks, spatial_features_proj, query_features_block, query_features_proj, bias)을 공식 구현과 똑같이 지었습니다.
그래서 공식 SegmentationHead 에 이 머리의 가중치를 그대로 실어 같은 입력을 넣어 볼 수 있습니다. 코드의 대조 결과는 실험 절에서 봅니다.
탐지 모델에 머리를 붙이는 쪽은 짧습니다. 10장의 MiniRFDETR 을 고치지 않고 하위 클래스로 만들었습니다.
features["projector"][0] 은 프로젝터 출력 $(B, 128, 12, 12)$, features["hs"] 는 디코더 층별 질의 임베딩 $(3, B, Q, 128)$, features["enc_hs"] 는 인코더 제안으로 선택된 칸의 특징 $(B, Q, 128)$ 입니다.
분할 머리가 탐지기에서 가져오는 것은 이 셋이 전부입니다.
마스크 손실
마스크를 배우게 하는 손실은 둘입니다. 픽셀마다의 BCE 와 다이스 손실. 공식 구현에서는 models/criterion.py 의 loss_masks 가 둘을 계산합니다.
둘 다 정답과 매칭된 질의 에만 겁니다. 짝이 없는 질의의 마스크에는 손실이 없습니다(그 질의는 분류 손실이 “객체 아님” 으로 눌러 줍니다).
픽셀마다의 BCE
마스크의 칸 하나하나는 “객체다 / 아니다” 의 이진 분류입니다. 4장의 이진 교차 엔트로피를 칸마다 적용하면 됩니다. 칸 $i$ 의 로짓이 $z_i$, 확률이 $p_i = \sigma(z_i)$, 정답이 $t_i$ 일 때
$$ L_{\BCE} = \frac{1}{P} \sum_{i=1}^{P} \Big[ -t_i \log p_i - (1 - t_i) \log (1 - p_i) \Big] $$
입니다. $P$ 는 손실을 계산하는 칸(점)의 수이고, 마스크 하나 안에서 평균 을 냅니다. 공식 구현의 이름은 sigmoid_ce_loss 입니다.
마스크마다 이 값을 구해 모두 더하고, 박스 손실과 같은 분모(정답 객체 수 × 질의 묶음 수)로 나눕니다.
작은 객체는 배경에 묻힌다
BCE 는 모든 칸을 똑같이 한 표로 셉니다. 여기에 약점이 있습니다. 객체가 작으면 칸의 대부분이 배경이고, 배경만 잘 맞혀도 평균 손실이 작아집니다. 숫자로 봅니다. 마스크 격자가 24×24 = 576칸이고, 모델이 모든 칸에 $p = 0.01$ 을 냈다고 합시다. “객체는 없다, 전부 배경이다” 라는 답입니다.
4장에서 본 클래스 불균형과 같은 문제가 마스크 안에서 일어난 것입니다. 작은 객체일수록 “일단 다 배경” 이라는 답이 싸게 먹힙니다. 객체의 크기와 상관없이 “겹친 정도” 를 직접 재는 손실이 하나 더 필요합니다.
다이스 계수와 IoU
두 집합이 얼마나 겹치는지 재는 수로 IoU 말고 다이스 계수Dice coefficient 가 있습니다.
$$ \operatorname{Dice}(A, B) = \frac{2\,|A \cap B|}{|A| + |B|} $$교집합의 크기를 두 집합 크기의 평균 으로 나눈 것입니다($|A \cap B|$ 를 $\tfrac{1}{2}(|A| + |B|)$ 로 나누면 이 식입니다). 두 집합이 같으면 $2|A| / 2|A| = 1$, 하나도 안 겹치면 0 입니다. IoU 와는 분모만 다릅니다. IoU 는 합집합으로, 다이스는 두 크기의 평균으로 나눕니다. 둘은 서로 바꿔 쓸 수 있습니다.
숫자를 넣어 봅니다. 예측이 6칸, 정답이 4칸, 겹친 것이 3칸이면 합집합은 $6 + 4 - 3 = 7$ 칸이므로 $\IoU = 3/7 = 0.4286$, $\operatorname{Dice} = 2 \times 3 / (6 + 4) = 0.6$ 입니다. 식으로도 $2 \times 0.4286 / 1.4286 = 0.6$ 입니다.
[손계산 2] 다이스 계수와 IoU: |A| = 6, |B| = 4, |A∩B| = 3
  IoU = 3/7 = 0.4286, 다이스 = 6/10 = 0.6000, 2·IoU/(1 + IoU) = 0.6000
  IoU  → 다이스: 0.10 → 0.1818, 0.25 → 0.4000, 0.50 → 0.6667, 0.75 → 0.8571, 0.90 → 0.9474
두 가지를 읽을 수 있습니다. 첫째, 다이스는 IoU 가 커지면 늘 같이 커집니다. 하나를 올리는 것은 다른 하나를 올리는 것입니다. 둘째, 0 과 1 사이에서 다이스가 늘 IoU 이상입니다($2/(1 + \IoU) \ge 1$ 이므로). IoU 0.5 는 다이스 0.667 입니다. 같은 겹침에 다이스가 더 후한 점수를 줄 뿐, 순서는 바꾸지 않습니다.
부드러운 다이스 손실
다이스 계수를 손실로 쓰려면 두 가지를 고쳐야 합니다. 클수록 좋은 수이므로 1 에서 빼야 하고, 0/1 로 자른 마스크는 미분이 안 되므로 확률 로 계산해야 합니다. 집합의 크기를 확률의 합으로 바꿉니다.
| 집합의 말 | 0/1 마스크에서 | 확률로 바꾸면 |
|---|---|---|
| $|A|$ (예측의 크기) | 예측이 1 인 칸 수 | $\sum_i p_i$ |
| $|B|$ (정답의 크기) | 정답이 1 인 칸 수 | $\sum_i t_i$ |
| $|A \cap B|$ (겹친 크기) | 둘 다 1 인 칸 수 | $\sum_i p_i\, t_i$ |
$p_i$ 가 0 또는 1 이면 오른쪽 열이 가운데 열과 정확히 같습니다. 그 사이의 값일 때는 “칸 $i$ 가 0.7 만큼 들어 있다” 고 세는 것입니다.
이렇게 만든 다이스 손실Dice loss 의 공식 구현(dice_loss)은 다음 식입니다.
분자와 분모에 더해진 1 은 평활 항 입니다. 필요한 까닭은 정답이 비어 있을 때 드러납니다. 뒤에서 보겠지만 손실은 뽑은 점 몇십 개에서만 계산하므로, 작은 객체는 뽑힌 점이 하나도 객체 위에 없을 수 있습니다. 그러면 $\sum t_i = 0$, $\sum p_i t_i = 0$ 입니다. 평활 항이 없으면 손실이 $1 - 0 / \sum p_i = 1$ 로, 예측이 아무리 0 에 가까워도 최댓값에 붙어 있습니다. 평활 항이 있으면 $1 - 1 / (\sum p_i + 1)$ 이 되어, 예측이 0 에 가까울수록 손실도 0 에 가까워집니다.
[손계산 3] 부드러운 다이스 손실 (+1 평활): p = (0.9, 0.8, 0.3, 0.1), t = (1, 1, 0, 0)
  분자 2·Σpt = 3.40, 분모 Σp + Σt = 4.10, 손실 = 1 − (3.40 + 1)/(4.10 + 1) = 0.1373  (dice_loss 함수: 0.1373)
  평활 없이: 1 − 3.40/4.10 = 0.1707. 같은 점들의 BCE 평균 = 0.1976
  ∂(다이스 손실)/∂p_i (autograd): [-0.223, -0.223, 0.1692, 0.1692]  손계산: t = 1 인 점 −(2·5.1 − 4.4)/5.1² = -0.2230, t = 0 인 점 4.4/5.1² = 0.1692
  ∂(BCE 평균)/∂p_i (autograd): [-0.2778, -0.3125, 0.3571, 0.2778]
  정답이 빈 마스크이고 p = (0.01, 0.01, 0.01, 0.01) 이면: 평활 없이 1 − 0/0.04 = 1.0000, +1 평활이면 0.0385
마지막 줄이 방금 말한 빈 정답의 경우입니다(가운데의 기울기 두 줄은 조금 뒤에 씁니다). 이제 BCE 가 실패한 예를 다이스 손실로 다시 계산합니다. 576칸 모두에 $p = 0.01$ 을 낸 예측입니다.
[손계산 4] 작은 객체와 큰 객체: 24×24 = 576 픽셀, 모든 픽셀에 p = 0.01 (전부 배경이라고 답한 예측)
  객체   9 픽셀 (1.6%): BCE = 0.0818, 다이스 손실 = 0.9251
  객체 288 픽셀 (50.0%): BCE = 2.3076, 다이스 손실 = 0.9771
  −log 0.01 = 4.6052, −log 0.99 = 0.01005
BCE 는 칸마다 채점해 평균을 내므로 객체가 작으면 놓친 칸이 배경에 묻힙니다. 다이스 손실은 겹친 비율 을 채점하므로 객체의 크기와 무관합니다. 같은 “통째로 놓친” 예측에 BCE 는 9칸 객체 0.08, 288칸 객체 2.31 을, 다이스 손실은 0.93, 0.98 을 줍니다.
두 손실의 기울기는 어떻게 다른가
그러면 다이스 손실만 쓰면 될까요. 기울기를 보면 두 손실의 성격이 드러납니다. 다이스 손실의 분자를 $U = 2\sum_i p_i t_i + 1$, 분모를 $V = \sum_i p_i + \sum_i t_i + 1$ 이라 두면 $L_{\text{dice}} = 1 - U/V$ 입니다.
앞의 네 점 예에서 $U = 4.4$, $V = 5.1$ 이므로 객체인 점은 $-(2 \times 5.1 - 4.4)/5.1^2 = -0.2230$, 배경인 점은 $4.4 / 5.1^2 = 0.1692$ 입니다. BCE 평균의 기울기는 4장에서처럼 점마다 $\tfrac{1}{P}\big(-t_i/p_i + (1 - t_i)/(1 - p_i)\big)$ 입니다. 앞의 출력에서 자동 미분으로 확인한 두 줄을 다시 봅니다.
  ∂(다이스 손실)/∂p_i (autograd): [-0.223, -0.223, 0.1692, 0.1692]  손계산: t = 1 인 점 −(2·5.1 − 4.4)/5.1² = -0.2230, t = 0 인 점 4.4/5.1² = 0.1692
  ∂(BCE 평균)/∂p_i (autograd): [-0.2778, -0.3125, 0.3571, 0.2778]
두 줄을 견주면 차이가 보입니다.
- BCE 는 점마다 다릅니다. 더 틀린 점일수록 크게 밀립니다. 정답이 1 인데 0.8 을 준 점($-0.3125$)이 0.9 를 준 점($-0.2778$)보다, 정답이 0 인데 0.3 을 준 점이 0.1 을 준 점보다 큽니다. 어느 칸을 고칠지 알려 주는 국소적인 신호입니다. 경계를 한 칸씩 다듬기에 알맞습니다.
- 다이스는 전체의 겹침으로 정해집니다. 분모 $V$ 가 작을수록, 곧 객체와 예측이 작을수록 기울기가 커집니다. 작은 객체가 무시되지 않게 해 주지만, 개별 점이 얼마나 틀렸는지는 구별하지 않습니다.
그래서 둘을 더해 씁니다. 공식 설정(SegmentationTrainConfig)의 계수는 mask_ce_loss_coef = 5.0, mask_dice_loss_coef = 5.0 입니다. 층 하나의 손실은
이고(앞의 세 항은 11장의 탐지 손실), 이것을 모든 디코더 층과 인코더 제안에 대해 더합니다. 다이스 손실 자체는 의료 영상 분할 모델 V-Net(Milletari 외, 2016)이 “관심 영역이 영상의 아주 작은 부분일 때 예측이 배경 쪽으로 쏠리는 문제” 를 풀려고 제안한 것입니다. V-Net 논문의 식은 분모가 $\sum p_i^2 + \sum g_i^2$ 으로 제곱이 들어 있고, RF-DETR 의 구현은 제곱 없이 $\sum p_i + \sum t_i$ 를 씁니다(+1 평활 포함). 이 장은 구현의 식을 따랐습니다.
점 표본 추출
손실을 마스크의 모든 칸에서 계산하면 정확하지만 비쌉니다. 정답 마스크는 그림 크기인데(COCO 그림을 Nano 에 넣으면 312×312), 예측은 78×78 이라 크기부터 맞춰야 하고, 매칭된 쌍이 수백 개면 그만큼의 큰 격자를 메모리에 올려야 합니다. 공식 구현은 다른 길을 갑니다. 마스크 위에서 점을 몇 개 뽑아, 그 점들에서만 예측과 정답을 읽어 손실을 계산합니다. 이것이 점 표본 추출point sampling 입니다. Mask2Former(Cheng 외, 2021)가 PointRend 에서 착안해 도입한 방법이고(그 논문은 점 12,544개를 써서 학습 메모리를 그림 한 장당 18 GB 에서 6 GB 로 줄였다고 보고합니다), RF-DETR 의 코드에도 같은 방식의 함수가 PointRend 논문을 가리키는 주석과 함께 들어 있습니다.
점은 0 – 1 의 정규화 좌표 $(x, y)$ 입니다. 격자의 칸 한가운데에 떨어지지 않으므로 값을 읽는 방법이 필요합니다.
- 예측 로짓(78×78)은 그 점에서 쌍선형 보간 으로 읽습니다. 8장에서 보았듯 보간한 값은 원래 칸의 값으로 미분할 수 있어서 기울기가 흐릅니다.
- 정답 마스크(그림 크기)는 그 점에서 가장 가까운 픽셀 의 값을 읽습니다. 정답은 0 아니면 1 이어야 하기 때문입니다.
좌표가 정규화되어 있으니 두 격자의 크기가 달라도 같은 점을 가리킵니다. 예측을 키울 필요도, 정답을 줄일 필요도 없습니다.
점의 수는 설정 mask_point_sample_ratio(기본값 16)로 정해집니다. 코드에서 확인한 뜻은 “마스크 격자의 칸 수를 이 값으로 나눈 만큼 점을 뽑는다” 입니다.
Nano 는 $\lfloor 78 \times 78 / 16 \rfloor = 380$ 개입니다. 마스크 하나에 6,084칸 대신 380점만 보는 것입니다.
[손계산 6] 점 표본 추출의 점 수 (mask_point_sample_ratio = 16)
  미니, 마스크 24×24: 손실 max(24, 576 // 16) = 36개 (불확실한 점 27 + 균등 9, 후보 108), 매칭 비용 36개
  Seg Nano, 마스크 78×78: 손실 max(78, 6084 // 16) = 380개 (불확실한 점 285 + 균등 95, 후보 1140), 매칭 비용 380개
  Seg 2XLarge, 마스크 192×192: 손실 max(192, 36864 // 16) = 2304개 (불확실한 점 1728 + 균등 576, 후보 6912), 매칭 비용 2304개
어떤 점을 뽑느냐가 남았습니다. 공식 구현은 손실과 매칭에서 다르게 뽑습니다.
손실 (loss_masks) | 매칭 비용 (_compute_mask_costs) | |
|---|---|---|
| 점의 수 | $\max(H/r,\ \lfloor \text{칸 수} / 16 \rfloor)$ | $\lfloor \text{칸 수} / 16 \rfloor$ |
| 뽑는 방법 | 불확실한 점 위주(아래) | 균등 무작위 |
| 점을 함께 쓰는 범위 | 매칭된 쌍마다 따로 뽑습니다 | 모든 예측 · 모든 정답이 같은 점을 씁니다 |
손실 쪽의 “불확실한 점 위주” 는 함수 get_uncertain_point_coords_with_randomness 의 세 단계입니다. 뽑을 점의 수를 $P$ 라 하면
- 균등 무작위로 후보 점을 $3P$ 개 뽑고, 각 점에서 예측 로짓을 읽습니다.
- 로짓의 절댓값이 작은 순으로 $\lfloor 0.75 P \rfloor$ 개를 고릅니다. 로짓이 0 근처라는 것은 확률이 0.5 근처, 곧 모델이 망설이는 자리입니다. 대개 객체의 경계입니다.
- 나머지 $P - \lfloor 0.75 P \rfloor$ 개는 다시 균등 무작위로 뽑습니다.
쉬운 자리(배경 한가운데, 객체 한가운데)는 이미 잘 맞히므로 손실에 보탬이 적습니다. 점을 경계에 몰아 주면 같은 수의 점으로 더 많이 배웁니다. 3번의 균등 점은 모델이 확신하지만 틀린 자리를 놓치지 않게 하는 안전장치입니다. 매칭 쪽이 균등하게, 모두 같은 점을 쓰는 까닭은 공정한 비교 때문입니다. 비용 행렬은 “예측 $i$ 와 정답 $j$ 가 얼마나 맞는가” 를 모든 쌍에 대해 견주는 표인데, 쌍마다 다른 점에서 재면 값을 서로 견줄 수 없습니다.
매칭 비용에 더해지는 마스크 항
7장에서 헝가리안 매칭은 비용 행렬 $C$ 로 예측과 정답의 짝을 정했습니다. 분할 모델에서는 이 비용에도 마스크 항이 들어갑니다. 예측 $i$ 와 정답 $j$ 의 비용은
$$ C_{ij} = 2\,C^{\text{cls}}_{ij} + 5\,C^{\text{L1}}_{ij} + 2\,C^{\GIoU}_{ij} + 5\,C^{\BCE}_{ij} + 5\,C^{\text{dice}}_{ij} $$
입니다. 앞의 세 항은 11장과 같고(포컬 꼴의 분류 비용, 박스의 L1 거리, $-\GIoU$), 새 두 항은 예측 $i$ 의 마스크와 정답 $j$ 의 마스크를 같은 점들에서 견준 BCE 평균과 다이스 손실입니다.
마스크 비용의 계수는 공식 코드에서 손실의 계수를 그대로 넘겨받습니다(cost_mask_ce = mask_ce_loss_coef, cost_mask_dice = mask_dice_loss_coef. 둘 다 5).
박스는 비슷한데 마스크가 다른 두 예측이 있으면, 이제 마스크가 더 잘 맞는 쪽이 그 정답의 짝이 됩니다.
모든 쌍의 비용을 한꺼번에 계산하는 요령이 있습니다. BCE 를 예로 들면, 예측 $i$ 의 점 $k$ 에서 “정답이 1 일 때의 손실” $a_{ik} = -\log p_{ik}$ 와 “정답이 0 일 때의 손실” $c_{ik} = -\log(1 - p_{ik})$ 를 미리 계산해 두면
$$ C^{\BCE}_{ij} = \frac{1}{P} \sum_{k=1}^{P} \Big[ a_{ik}\, t_{jk} + c_{ik}\, (1 - t_{jk}) \Big] $$이고, 이것은 행렬곱 두 번입니다($a\, t^{\top} + c\, (1 - t)^{\top}$). 다이스도 분자가 $2\, p\, t^{\top} + 1$ 로 행렬곱 한 번입니다. 코드는 다음과 같습니다.
손실 클래스는 11장의 RFDETRCriterion 을 물려받아 마스크 항만 더합니다. match_layers 는 비용에 마스크 항을 더하고, mask_loss 는 매칭된 쌍의 마스크 손실 둘을 계산합니다.
점 표본 추출은 스텝마다 다른 점을 뽑습니다. 같은 가중치 · 같은 배치라도 손실 값과 매칭 결과가 뽑힌 점에 따라 조금씩 달라집니다. 이 장의 미니 모델은 마스크 격자가 24×24 라서 점이 36개뿐입니다. 손실의 잡음이 Nano 의 380점보다 큽니다. 실험에서 “전체 픽셀로 계산한 것” 과 견주어 볼 것입니다.
추론: 로짓에서 마스크로
후처리 세 단계
모델이 낸 마스크 로짓 $(B, N, H/r, W/r)$ 을 쓸 수 있는 마스크로 바꾸는 일은 공식 구현의 models/postprocess.py(PostProcess._postprocess_masks)가 합니다. 세 단계입니다.
- 예측 고르기. 10장의 탐지 후처리 그대로입니다. (질의, 클래스) 쌍의 시그모이드 점수가 높은 순으로
num_select개를 고릅니다. NMS 는 없습니다. - 키우기. 고른 질의의 마스크 로짓을 원래 그림의 크기 $(H, W)$ 로 쌍선형 보간합니다(
F.interpolate(…, mode="bilinear", align_corners=False)). 확률이 아니라 로짓을 키웁니다. - 자르기. 키운 로짓이 0 보다 크면
True입니다(> 0.0). 확률 0.5 를 문턱값으로 쓴 것과 같습니다.
결과는 그림마다 박스 · 점수 · 클래스와 함께 불(bool) 마스크 (num_select, 1, H, W) 입니다. 순서가 “키운 뒤 자르기” 인 것이 중요합니다.
먼저 0 에서 자른 뒤 키우면 78×78 의 계단 모양 경계가 그대로 커집니다. 로짓을 먼저 키우면 경계가 칸과 칸 사이의 매끄러운 선(보간된 로짓이 0 이 되는 선)으로 정해집니다.
또 하나, 박스로 마스크를 잘라 내는 단계는 없습니다. 마스크와 박스는 같은 질의에서 나왔을 뿐 서로를 강제하지 않으므로, 마스크가 박스 밖으로 삐져나올 수도 있습니다.
마스크 AP
분할 모델의 채점도 3장의 AP 입니다. 예측을 점수 순으로 늘어놓고, 정답과 짝지어 참 양성 · 거짓 양성을 가리고, 정밀도 – 재현율 곡선 아래의 넓이를 구하고, IoU 문턱값 0.50 – 0.95 의 열 개와 클래스에 대해 평균합니다. 딱 한 곳만 다릅니다. 예측과 정답이 겹치는 정도를 박스 IoU 가 아니라 마스크 IoU 로 잽니다. 이렇게 구한 것이 마스크 APmask AP 이고, 구별할 때는 원래 것을 박스 AP 라고 부릅니다. COCO 의 분할 순위표와 RF-DETR 논문 표 3 의 AP 가 마스크 AP 입니다.
같은 모델이라도 마스크 AP 는 보통 박스 AP 보다 낮습니다. 박스는 숫자 네 개만 맞으면 되지만 마스크는 경계의 모든 픽셀이 맞아야 IoU 가 올라가기 때문입니다. 특히 IoU 문턱값이 높을 때(0.9, 0.95) 차이가 벌어집니다. 실험에서 문턱값별로 확인합니다.
구현은 3장의 채점 코드에서 “IoU 를 재는 함수” 만 갈아 끼울 수 있게 만든 것입니다. 정밀도 – 재현율 곡선과 AP 계산은 3장의 precision_recall_curve · average_precision 을 그대로 가져다 씁니다.
논문의 RF-DETR-Seg
구조와 손실을 보았으니, 논문이 이 모델로 무엇을 보고했는지 정리합니다. 이 절의 수치는 모두 RF-DETR 논문(arXiv:2511.09554)의 COCO 실험이고, 이 튜토리얼의 도형 세상 실험과는 별개입니다.
SAM2 의사 라벨로 사전 학습
11장에서 보았듯 RF-DETR 은 COCO 로 학습하기 전에 큰 탐지 데이터셋 Objects365 로 사전 학습합니다. 그런데 Objects365 의 정답은 박스뿐입니다. 분할 머리는 마스크 정답이 있어야 배울 수 있습니다. 논문의 해법은 의사 라벨pseudo-label 입니다. 사람이 붙인 정답 대신 다른 모델이 만든 출력을 정답으로 쓰는 것 입니다. 논문은 Objects365 에 분할 모델 SAM2(Ravi 외, 2024)로 인스턴스 마스크를 붙였고, 부록 A 는 그 목적을 “분할 머리와 탐지 머리를 같은 데이터로 사전 학습하기 위해서” 라고 적습니다. SAM2 에 무엇을 입력으로 주어 마스크를 얻었는지(예를 들어 정답 박스를 주었는지)는 논문에 나와 있지 않습니다.
의사 라벨은 공짜가 아닙니다. 그것을 만든 모델의 실수가 정답에 그대로 들어갑니다. 그래도 쓰는 까닭은 양입니다. 마스크를 사람 손으로 그리는 일은 박스를 치는 일보다 훨씬 오래 걸리므로, 박스만 있는 큰 데이터셋을 분할 학습에 쓸 수 있게 되는 이득이 큽니다. 6장의 증류와 닮은 생각입니다. 큰 모델(SAM2)이 아는 것을 작고 빠른 모델(RF-DETR-Seg)에게 정답의 꼴로 넘겨주는 것입니다.
COCO 에서의 결과
논문 표 3 과 표 13 의 RF-DETR-Seg 줄을 모았습니다. AP 는 마스크 AP 이고, 지연 시간은 논문의 측정 조건(NVIDIA T4, TensorRT, FP16)에서 잰 값입니다. 비교 대상 몇 줄을 함께 적었습니다.
| 모델 | 매개변수 | GFLOPs | 지연 시간 (ms) | AP | AP50 | AP75 | APS | APM | APL |
|---|---|---|---|---|---|---|---|---|---|
| RF-DETR-Seg N | 33.6M | 50.0 | 3.4 | 40.3 | 63.0 | 42.6 | 16.3 | 45.3 | 63.6 |
| RF-DETR-Seg S | 33.7M | 70.6 | 4.4 | 43.1 | 66.2 | 45.9 | 21.9 | 48.5 | 64.1 |
| RF-DETR-Seg M | 35.7M | 102.0 | 5.9 | 45.3 | 68.4 | 48.8 | 25.5 | 50.4 | 65.3 |
| RF-DETR-Seg L | 36.2M | 151.1 | 8.8 | 47.1 | 70.5 | 50.9 | 28.4 | 52.1 | 65.6 |
| RF-DETR-Seg XL | 38.1M | 260.0 | 13.5 | 48.8 | 72.2 | 53.1 | 30.6 | 53.3 | 65.9 |
| RF-DETR-Seg 2XL | 38.6M | 435.3 | 21.8 | 49.9 | 73.1 | 54.5 | 33.9 | 54.1 | 65.7 |
| YOLOv11 N | 2.9M | 10.4 | 3.6 | 30.0 | 47.8 | 31.5 | 10.0 | 33.4 | 47.7 |
| YOLOv11 M | 22.4M | 123.3 | 6.9 | 38.5 | 60.0 | 40.9 | 18.0 | 44.3 | 57.6 |
| YOLOv11 XL | 62.1M | 296.4 | 13.7 | 40.1 | 62.4 | 42.6 | 18.8 | 46.4 | 60.1 |
| FastInst (R50) | 29.7M | 99.7 | 39.6* | 34.9 | 56.0 | 36.2 | 13.3 | 38.0 | 56.8 |
| MaskDINO (R50) | 52.1M | 586 | 242* | 46.3 | 69.0 | 50.7 | 26.1 | 49.3 | 66.1 |
- 별표(*)는 TensorRT 로 돌릴 수 없어 PyTorch 로 잰 지연 시간입니다(논문 표 3 의 표기).
- 논문은 YOLO 의 지연 시간에 프로토타입을 객체별 마스크로 바꾸는 시간을 넣어 쟀다고 밝힙니다. 기존 측정은 보통 이 시간을 빼는데, 실제로 쓰려면 드는 시간이라는 이유입니다.
표에서 읽을 것은 넷입니다.
- 가장 작은 RF-DETR-Seg 가 가장 큰 YOLO 를 넘습니다. N 의 40.3 은 YOLOv11 XL 의 40.1 보다 높고, 지연 시간은 3.4 ms 대 13.7 ms 입니다. 논문은 nano 가 “보고된 모든 크기의 YOLOv8 · YOLOv11 을 넘는다” 고 적습니다.
- MaskDINO 와의 거리. M 은 MaskDINO(R50)에 1.0 AP 모자라고(45.3 대 46.3), L 부터는 넘습니다(47.1). 다중 스케일 백본 특징을 쓰지 않는 가벼운 머리로도 그 수준에 닿았다는 것이 논문의 주장입니다.
- 매개변수는 거의 그대로, 계산량만 늡니다. N 에서 2XL 까지 매개변수는 33.6M → 38.6M 인데 GFLOPs 는 50 → 435 입니다. 백본이 모두 DINOv2-S 로 같고, 크기 차이는 해상도 · 디코더 층 수 · 질의 수에서 나오기 때문입니다.
- 작은 객체가 해상도를 가장 많이 탑니다. N 에서 2XL 로 가면 APS 는 16.3 → 33.9 로 두 배가 되는데 APL 은 63.6 → 65.7 로 거의 그대로입니다. 마스크 격자가 입력의 1/4 이므로 작은 객체는 몇 칸으로밖에 그릴 수 없고, 입력 해상도를 올려야 칸이 늘어납니다(이 해석은 표의 수치와 구조에서 이 튜토리얼이 읽은 것입니다. 실험 절에서 도형 세상의 크기별 마스크 IoU 로 같은 경향을 확인합니다).
12장에서 본 “NAS 뒤의 미세 조정” 은 분할에서도 이득이 거의 없었습니다. 논문 표 16 에서 N 은 +0.1 AP 였고, S 부터 2XL 까지는 “나아지지 않음” 으로 적혀 있습니다.
NAS 가 찾은 분할 모델의 생김새
분할 모델도 12장의 가중치 공유 NAS 로 찾았습니다. 논문 표 8 의 구성을 탐지 모델(표 7)과 나란히 놓습니다. 격자와 마스크 격자는 해상도에서 계산한 값입니다.
| 모델 | 해상도 | 패치 | 격자 (해상도 ÷ 패치) | 마스크 격자 (해상도 ÷ 4) | 윈도 | 디코더 층 | 질의 |
|---|---|---|---|---|---|---|---|
| RF-DETR-Seg N | 312 | 12 | 26 | 78 | 1 | 4 | 100 |
| RF-DETR-Seg S | 384 | 12 | 32 | 96 | 2 | 4 | 100 |
| RF-DETR-Seg M | 432 | 12 | 36 | 108 | 2 | 5 | 200 |
| RF-DETR-Seg L | 504 | 12 | 42 | 126 | 2 | 5 | 300 |
| RF-DETR-Seg XL | 624 | 12 | 52 | 156 | 2 | 6 | 300 |
| RF-DETR-Seg 2XL | 768 | 12 | 64 | 192 | 2 | 6 | 300 |
| RF-DETR N (탐지) | 384 | 16 | 24 | — | 2 | 2 | 300 |
| RF-DETR S (탐지) | 512 | 16 | 32 | — | 2 | 3 | 300 |
| RF-DETR M (탐지) | 576 | 16 | 36 | — | 2 | 4 | 300 |
- 백본은 모두 DINOv2-S 입니다. 논문 표 8 에는 Max(890 / 패치 10 / 윈도 1 / 디코더 6 / 질의 300)도 있습니다.
- 공개 코드의 설정(
config.py)은 표 8 과 한 곳이 다릅니다.RFDETRSegLargeConfig의 질의 수가 200 입니다(논문 표는 300). 나머지 크기는 표와 같습니다.
탐지 모델과 견주면 세 가지가 다릅니다.
- 패치가 16 이 아니라 12 입니다. 부록 L 은 DINOv2-S 백본에서 탐지 모델의 최적 패치는 16, 분할 모델은 12 였다고 적습니다.
- 질의 수가 변합니다. 탐지 모델은 모든 크기가 300개인데 분할 모델은 100 → 200 → 300 으로 늘어납니다. 부록 L 의 표현으로는, COCO 에서 탐지 모델은 질의 수를 고정한 채 디코더 깊이를 키우고, 분할 모델은 두 축을 함께 키웁니다.
- 디코더가 깊습니다. 가장 작은 N 부터 4층입니다(탐지 N 은 2층). 논문은 이것이 “쓸 만한 분할 머리의 최소 깊이” 를 반영하는 것 같다고 해석합니다. 분할 머리의 블록 수가 디코더 층 수와 묶여 있으므로, 디코더가 얕으면 픽셀 임베딩을 다듬는 블록도 적어집니다. 그 지연 시간을 상쇄하려고 질의 수를 줄여, 탐지의 “넓고 얕은” 디코더와 달리 “좁고 깊은” 디코더가 된다는 것입니다.
패치가 왜 달라졌는지는 12장의 발견과 이어집니다. 부록 L 은 탐지 모델의 성능이 해상도나 패치 크기 각각보다 공간 위치 수(해상도 ÷ 패치, 위 표의 “격자”)와 더 상관있다고 보고했습니다. 해상도를 올리든 패치를 줄이든 격자가 같으면 결과가 비슷했습니다. 그런데 논문은 곧바로 이 경향이 RF-DETR-Seg 에서는 성립하지 않는다 고 적습니다. 이유는 이 장에서 본 한 줄입니다. 분할 특징은 프로젝터 격자의 몇 배가 아니라 입력 해상도의 1/4 로 키워집니다.
그래서 해상도라는 손잡이가 분할 모델에서는 두 가지를 한꺼번에 움직입니다. 격자(백본 · 디코더의 계산량)와 마스크 격자(분할 머리의 계산량과 마스크의 세밀함)입니다. 부록 L 은 RF-DETR (medium) 과 RF-DETR-Seg (medium) 이 둘 다 격자 36 을 쓰지만 분할 모델이 더 낮은 입력 해상도에서 동작한다는 점을 들어, 분할 특징의 해상도가 입력 해상도에 묶여 있어서 파레토 최적점이 옮겨진다고 정리합니다. 패치를 12 로 줄이면 낮은 해상도(작은 마스크 격자)에서도 격자를 넉넉히 가질 수 있습니다. NAS 는 이 맞바꿈을 사람이 따져 보기 전에 탐색으로 찾아낸 것입니다.
실험: 미니 RF-DETR-Seg
이제 도형 세상에서 직접 해 봅니다. 11장에서 학습한 미니 RF-DETR 에 분할 머리를 달아 함께 학습하고, 결과를 여러 방향에서 뜯어 봅니다. 이 절의 수치는 모두 이 튜토리얼의 실험(96×96 도형 그림, 학습 4,000장, 검증 500장)에서 나온 것이고, 논문의 COCO 수치와는 견줄 수 없습니다.
공식 구현과 같은 점, 다른 점
| 항목 | 이 실습 (ch13_seg.py) | 공식 구현 |
|---|---|---|
| 분할 머리의 계산 | 같습니다. 쌍선형 보간 → 깊이별 합성곱 블록(디코더 층마다 하나) → 1×1 합성곱, 질의 쪽 MLP 블록 → Linear, einsum + 스칼라 편향 | |
| 크기 | $D = 128$, 블록 3개, 질의 12개. 매개변수 219,137개 | $D = 256$, 블록 4 – 6개, 질의 100 – 300개. Nano 는 933,121개 |
| 격자 | 그림 96 → 프로젝터 12×12 → 마스크 24×24 (한 변 2배) | Nano: 312 → 26×26 → 78×78 (한 변 3배) |
| 인코더 제안의 마스크 | 같습니다. 블록을 건너뛰고 선택된 칸의 특징과 내적 | |
| 학습 때의 마스크 계산 | 모든 질의의 로짓 지도를 다 만든 뒤 매칭된 것을 고릅니다 | sparse_forward: 매칭된 질의만 내적합니다(결과는 같고 메모리를 아낍니다) |
| 마스크 손실 | 같습니다. BCE(점 평균) · 다이스(+1 평활), 계수 5 · 5, 모든 디코더 층과 인코더 제안에 | |
| 손실의 점 | 36개(불확실한 점 27 + 균등 9) | 같은 규칙. Nano 는 380개 |
| 매칭 비용의 마스크 항 | 같습니다. 계수 5 · 5, 균등 무작위 점(여기서는 36개)을 모든 쌍이 함께 | |
| 후처리 | 같습니다. 점수 상위 선택 → 로짓을 그림 크기로 쌍선형 보간 → 0 에서 자르기 | |
| 시작 가중치 | 11장에서 탐지만 학습한 가중치 + 새로 초기화한 분할 머리 | SAM2 의사 라벨을 붙인 Objects365 에서 탐지와 분할을 함께 사전 학습(논문) |
| 채점 | 3장의 채점 코드에 마스크 IoU 를 끼운 것(객체 크기별 지표 없음) | COCO 방식의 마스크 AP |
“같습니다” 라고 적은 칸은 말이 아니라 수치로 확인했습니다. rfdetr 패키지가 설치되어 있으면 코드가 공식 SegmentationHead 에 미니 머리의 가중치를 그대로 싣고 같은 입력을 넣어 출력을 견줍니다. 손실 함수와 점 읽기 함수도 마찬가지입니다.
[check: 공식 구현과 대조]
  MiniSegHead vs 공식 SegmentationHead (같은 가중치): 층별 마스크 로짓 [(2, 12, 24, 24), (2, 12, 24, 24), (2, 12, 24, 24)], 최대 차이 0.00e+00 (마지막 층만 0.00e+00, skip_blocks 0.00e+00)
  sigmoid_ce_loss / dice_loss vs 공식: 최대 차이 0.00e+00 / 0.00e+00
  pairwise_sigmoid_ce / pairwise_dice vs 공식 batch_*: 최대 차이 0.00e+00 / 0.00e+00
  point_sample vs 공식 point_sample: 쌍선형 0.00e+00, nearest 0.00e+00
최대 차이가 모두 0 입니다. 같은 연산을 같은 순서로 하기 때문입니다. 패키지 없이 도는 대조도 있습니다.
[check]
  point_sample(픽셀 중심 전부) vs F.interpolate(쌍선형): 최대 차이 2.86e-06
  point_sample(nearest, 픽셀 중심 전부) 이 원래 마스크와 같은가: True
  pairwise_sigmoid_ce / pairwise_dice vs 쌍마다 따로 계산: 최대 차이 5.96e-08 / 5.96e-08
  무작위 마스크 200쌍에서 |다이스 − 2·IoU/(1 + IoU)| 의 최댓값: 2.98e-08
  evaluate_ap_with(박스 IoU) vs ch03 evaluate_ap: AP 0.195836 vs 0.195836, 표의 최대 차이 0.00e+00
  정답 마스크를 그대로 예측으로 넣은 마스크 AP: 1.0000
  모양: pred_masks (4, 12, 24, 24), 보조 출력 [(4, 12, 24, 24), (4, 12, 24, 24)], 인코더 제안 (4, 12, 24, 24)
  final_layer_only 의 마스크 = 전 층 계산의 마지막 층: 최대 차이 0.00e+00
  dec_layers=1 / 2 의 마스크 = 보조 출력 0 / 1: 최대 차이 0.00e+00 / 0.00e+00, dec_layers=0 = 인코더 제안의 마스크: 0.00e+00
읽어 둘 줄이 셋입니다. 첫 줄은 “모든 픽셀 중심에서 점을 읽는 것” 이 “쌍선형 보간으로 그림 크기로 키우는 것” 과 같다는 확인입니다. 점 표본 추출이 전체 픽셀 계산의 일부를 뽑은 것임을 뜻합니다.
다섯째 줄은 이 장의 채점 틀에 박스 IoU 를 끼우면 3장의 evaluate_ap 와 한 자리도 다르지 않다는 것, 마지막 두 줄은 디코더를 $k$ 층만 쓴 모델의 마스크가 전체 모델의 $k$ 번째 보조 출력과 정확히 같다는 것입니다.
그래서 모든 층에 손실을 걸어 두면 층을 떼어 낸 모델을 따로 학습할 필요가 없습니다.
정답 마스크와 겹친 도형
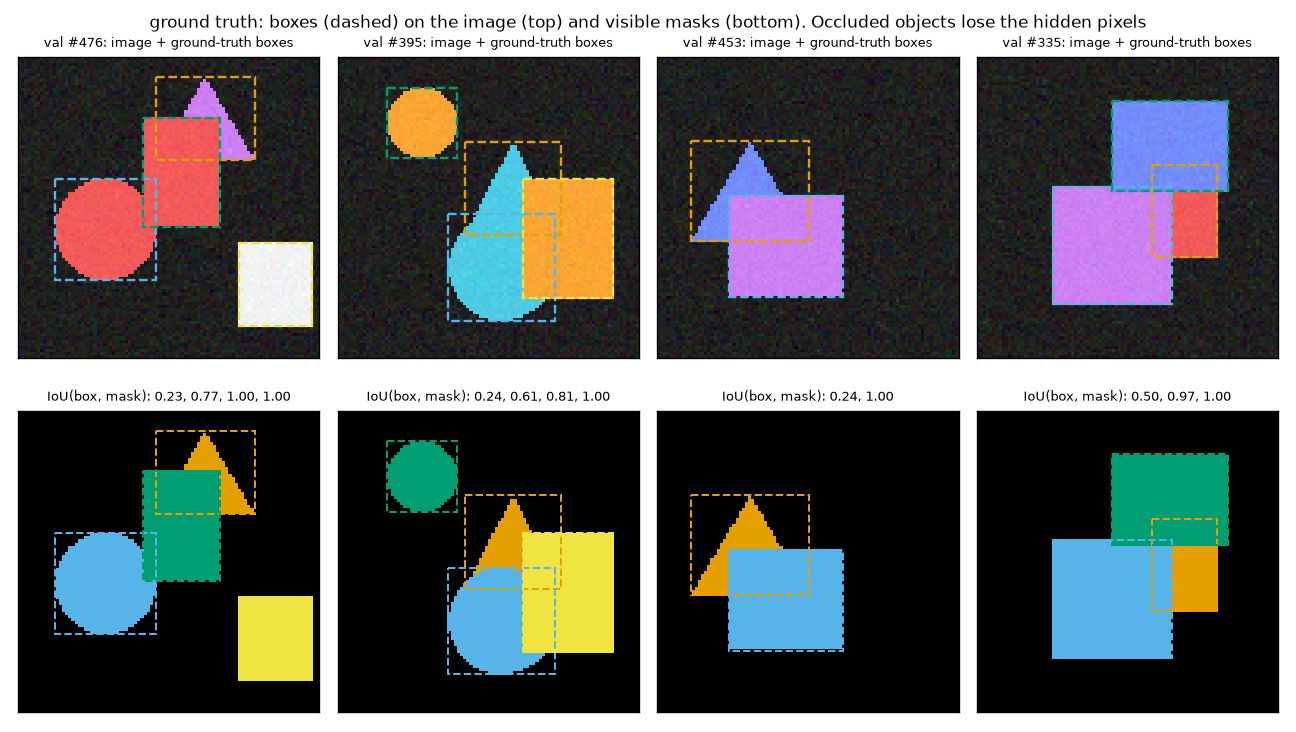
그림 13-4 에서 박스와 마스크가 갈라지는 두 경우가 보입니다. 하나는 모양입니다. 온전히 보이는 원은 0.8 안팎, 사각형은 1.00 입니다. 앞에서 손으로 구한 $\pi/4$ 와 1 그대로입니다. 다른 하나는 가림입니다. 첫째 그림의 삼각형은 사각형에 덮여 꼭대기와 오른쪽 귀퉁이만 남았고, 박스 기준 IoU 가 0.23 입니다. 넷째 그림의 빨간 사각형은 반이 가려져 0.50 입니다. 박스는 가려진 부분까지 포함한 원래 도형의 것이라 그대로이고, 마스크만 줄어듭니다. 검증 세트의 정답 객체 1,265개 가운데 252개가 이렇게 일부라도 가려져 있습니다(보이는 비율의 평균 0.899, 최소 0.467).
학습 설정과 실행
실험의 선택과 그 이유입니다.
- 11장의 체크포인트에서 시작합니다.
ch11_rfdetr.pt의 EMA 가중치(11장에서 박스 AP 0.9347 을 낸 가중치)를 싣고, 분할 머리만 새로 초기화합니다. 처음부터 다시 학습하면 16분쯤 걸리는 탐지 학습을 되풀이해야 하고, “탐지기에 머리 하나를 얹는다” 는 이 장의 주제에도 이쪽이 맞습니다. 공식 모델은 사전 학습 때부터 탐지와 분할을 함께 배운다는 점이 다릅니다. - 머리만이 아니라 전체를 함께 학습합니다. 백본 · 프로젝터 · 디코더를 얼리지 않습니다. 프로젝터 출력과 질의 임베딩은 원래 박스를 맞히려고 배운 것이라, 마스크에 맞게 조금 움직일 여지를 줍니다. 그 대가로 박스 AP 가 어떻게 되는지를 함께 봅니다.
- 나머지는 11장 그대로입니다. AdamW, 학습률 2e-4 일정(백본은 층별 감쇠), 배치 32, 기울기 자르기 0.1, EMA(감쇠 0.993). 분할 머리의 학습률은 기본값 2e-4 입니다.
- 30 에폭, 시드 1개. 본 실험은 시드 0 한 번입니다. 절제 실험만 시드 3개로 돌렸습니다.
$ python ch13_seg.py출력의 앞부분(손계산과 check)은 앞에서 보았습니다. 이어지는 학습 부분입니다.
[미니 RF-DETR-Seg (본 실험): BCE + 다이스, 점 표본 추출, 마스크 1/4 해상도]
  ch11_rfdetr.pt 의 EMA 가중치를 실었다. 새로 초기화된 텐서 29개 (모두 segmentation_head.*)
  매개변수 2,051,844개 (분할 머리 219,137개), 에폭 30, 에폭당 125 스텝, 학습 그림 4000장
에폭   0 | (학습 전) 박스 AP 0.9347 | 마스크 AP 0.0028
에폭   1 | 손실 13.4178 (ce 0.2578 bbox 0.0160 giou 0.0522 maskce 0.2413 maskdice 0.2870) | 박스 AP 0.8906 | 마스크 AP 0.4748 AP50 0.8007 AP75 0.5072 |   21초
에폭   2 | 손실  8.7491 (ce 0.2600 bbox 0.0176 giou 0.0569 maskce 0.1190 maskdice 0.1527) | 박스 AP 0.8914 | 마스크 AP 0.6361 AP50 0.9255 AP75 0.7108 |   50초
에폭   3 | 손실  7.1792 (ce 0.2570 bbox 0.0177 giou 0.0571 maskce 0.0916 maskdice 0.1127) | 박스 AP 0.9032 | 마스크 AP 0.6987 AP50 0.9610 AP75 0.7928 |   81초
에폭   4 | 손실  6.1754 (ce 0.2440 bbox 0.0170 giou 0.0551 maskce 0.0737 maskdice 0.0917) | 박스 AP 0.9077 | 마스크 AP 0.7384 AP50 0.9708 AP75 0.8255 |   95초
에폭   5 | 손실  5.4888 (ce 0.2332 bbox 0.0166 giou 0.0535 maskce 0.0624 maskdice 0.0785) | 박스 AP 0.9093 | 마스크 AP 0.7581 AP50 0.9709 AP75 0.8419 |  112초
  …
에폭  10 | 손실  3.9809 (ce 0.1947 bbox 0.0143 giou 0.0467 maskce 0.0402 maskdice 0.0544) | 박스 AP 0.9198 | 마스크 AP 0.8254 AP50 0.9727 AP75 0.9006 |  184초
  …
에폭  15 | 손실  3.3326 (ce 0.1711 bbox 0.0123 giou 0.0411 maskce 0.0328 maskdice 0.0448) | 박스 AP 0.9289 | 마스크 AP 0.8546 AP50 0.9797 AP75 0.9152 |  282초
  …
에폭  20 | 손실  2.9818 (ce 0.1561 bbox 0.0110 giou 0.0371 maskce 0.0295 maskdice 0.0415) | 박스 AP 0.9325 | 마스크 AP 0.8631 AP50 0.9769 AP75 0.9079 |  374초
  …
에폭  25 | 손실  2.7625 (ce 0.1477 bbox 0.0101 giou 0.0344 maskce 0.0266 maskdice 0.0391) | 박스 AP 0.9344 | 마스크 AP 0.8702 AP50 0.9840 AP75 0.9154 |  471초
  …
에폭  30 | 손실  2.6449 (ce 0.1428 bbox 0.0096 giou 0.0329 maskce 0.0256 maskdice 0.0386) | 박스 AP 0.9349 | 마스크 AP 0.8766 AP50 0.9884 AP75 0.9176 |  562초
저장: ch13_seg.pt (model · ema · config · history). 학습 561초 (3750 스텝)
노트북 GPU 한 장에서 학습에 561초, 분석까지 582초가 걸렸습니다(다른 작업과 GPU 를 함께 쓰며 잰 값입니다). 줄마다 괄호 안은 마지막 디코더 층의 손실(계수를 곱하기 전)이고, AP 는 검증 세트에서 EMA 모델을 채점한 값입니다. 가운데 에폭은 줄였습니다.
학습이 끝나면 실행 폴더에 ch13_seg.pt 가 남습니다. 뒤에 나오는 표와 그림은 python ch13_seg.py --analyze 로 학습 없이 다시 만들 수 있습니다(약 35초).
그림을 바꿔 그려 보거나 다른 검증 그림을 들여다볼 때 쓰세요. 이 장의 그림도 그렇게 다시 그린 것이고, 표의 수치는 학습 직후의 출력과 한 글자도 다르지 않았습니다.
학습 기록 읽기
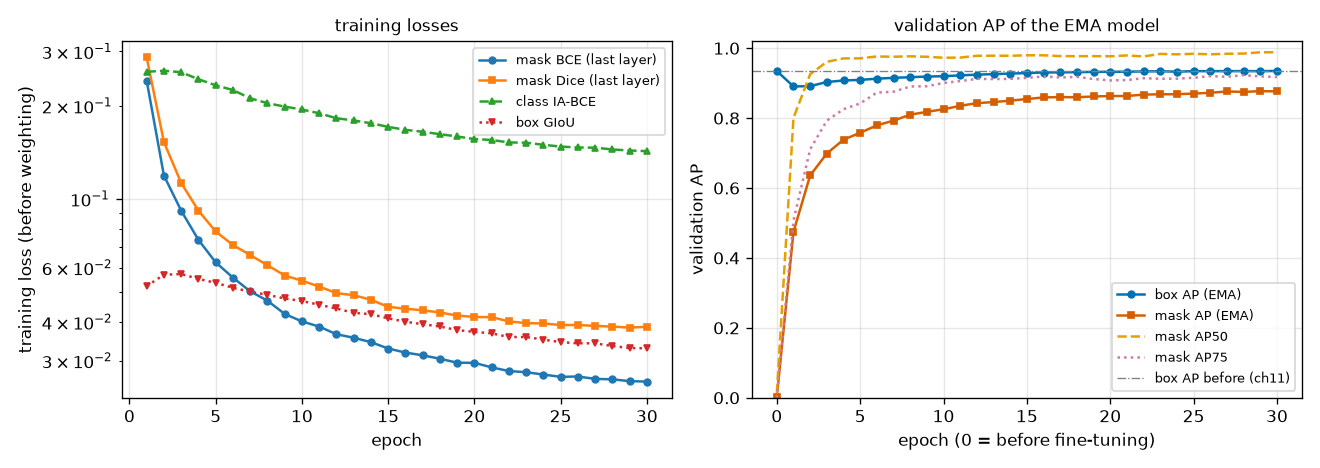
그림 13-5 와 위의 출력에서 읽을 것은 넷입니다.
- 마스크는 빨리 배웁니다. 마스크 AP 가 한 에폭 만에 0.4748, 다섯 에폭에 0.7581 이 되고, 30 에폭에 0.8766 입니다. 탐지기가 이미 객체를 찾을 줄 알고, 프로젝터 출력에 객체의 위치가 들어 있어서 머리는 그것을 마스크로 옮기는 법만 배우면 됩니다. 처음부터 학습한 11장의 탐지기는 한 에폭 뒤 박스 AP 가 0.31 이었습니다.
- 낮은 문턱값의 AP 가 먼저, 높은 문턱값이 나중에 찹니다. 마스크 AP50 은 세 에폭에 0.96 을 넘어 거의 다 찼는데 AP75 는 그때 0.79 이고 끝까지 조금씩 오릅니다. 대강의 영역은 금방 잡고, 경계를 다듬는 데 시간이 걸립니다.
- 박스 AP 가 처음에 떨어집니다. 0.9347 에서 한 에폭 뒤 0.8906 으로 내려갔다가 천천히 돌아와 30 에폭에 0.9349 입니다. 끝에서는 11장의 값과 사실상 같습니다(차이 0.0002). 분할 머리를 달았다고 박스가 좋아지지도 나빠지지도 않았습니다. 떨어진 까닭이 마스크 손실 때문인지는 이 곡선만으로는 알 수 없습니다. 절제 실험의 대조군에서 따져 봅니다.
- 두 마스크 손실은 함께 내려갑니다. BCE 는 0.24 에서 0.026 으로, 다이스는 0.29 에서 0.039 로 내려갑니다. 30 에폭에서도 아직 완전히 평평하지는 않습니다.
박스 AP 와 마스크 AP
[최종] EMA 모델, 검증 500장
  박스 AP 0.9349 AP50 0.9926 AP75 0.9797  (학습 전 0.9347)
  마스크 AP 0.8766 AP50 0.9884 AP75 0.9176
  클래스별 박스 AP: circle 0.9685, rectangle 0.9068, triangle 0.9294
  클래스별 마스크 AP: circle 0.9016, rectangle 0.9083, triangle 0.8199
  IoU 문턱값별 AP (클래스 평균):
    문턱값  | 0.50 | 0.55 | 0.60 | 0.65 | 0.70 | 0.75 | 0.80 | 0.85 | 0.90 | 0.95
    박스    | 0.99 | 0.99 | 0.99 | 0.99 | 0.99 | 0.98 | 0.97 | 0.94 | 0.89 | 0.62
    마스크  | 0.99 | 0.97 | 0.95 | 0.94 | 0.93 | 0.92 | 0.90 | 0.86 | 0.79 | 0.52
  기준선 (정답 마스크를 24×24 로 줄였다가 되키운 것을 예측으로): 마스크 AP 0.9266 AP50 1.0000 AP75 1.0000
마스크 AP 는 0.8766 로 박스 AP 0.9349 보다 0.06 가량 낮습니다. 어디서 벌어지는지는 문턱값별 줄이 보여 줍니다. IoU 0.50 에서는 둘이 같고(0.99), 0.75 에서 0.98 대 0.92, 0.90 에서 0.89 대 0.79, 0.95 에서 0.62 대 0.52 입니다. “대강 맞는 마스크” 는 박스만큼 잘 내지만 “거의 완벽한 마스크” 는 박스보다 어렵습니다.
클래스별로는 차이가 고르지 않습니다. 사각형은 마스크 AP(0.9083)가 박스 AP(0.9068)와 같은 수준이고, 원은 0.9016 대 0.9685, 삼각형은 0.8199 대 0.9294 로 가장 크게 벌어집니다. 삼각형의 뾰족한 꼭대기와 비스듬한 변은 4픽셀 간격의 24×24 격자로 그리기 가장 어려운 모양입니다.
마지막 줄의 기준선 은 이 해상도의 한계를 가늠하려고 넣은 것입니다. 정답 마스크를 24×24 로 줄였다가(칸마다 넓이 평균) 다시 96×96 으로 키워 0.5 에서 자른 것을, 점수 1 인 완벽한 탐지의 마스크로 넣었습니다. 모든 객체를 찾고 클래스도 다 맞힌 경우인데도 마스크 AP 가 0.9266 입니다. AP50 과 AP75 는 1.0 이므로 잃은 것은 모두 0.75 보다 높은 문턱값에서입니다. 미니 모델의 0.8766 은 이 기준선보다 0.05 낮습니다. 다만 이 기준선은 엄밀한 상한이 아닙니다. 모델은 로짓을 키운 뒤 자르므로 경계를 칸 사이 어디에나 둘 수 있어, 원리로는 이보다 잘할 수도 있습니다.
예측 마스크 보기
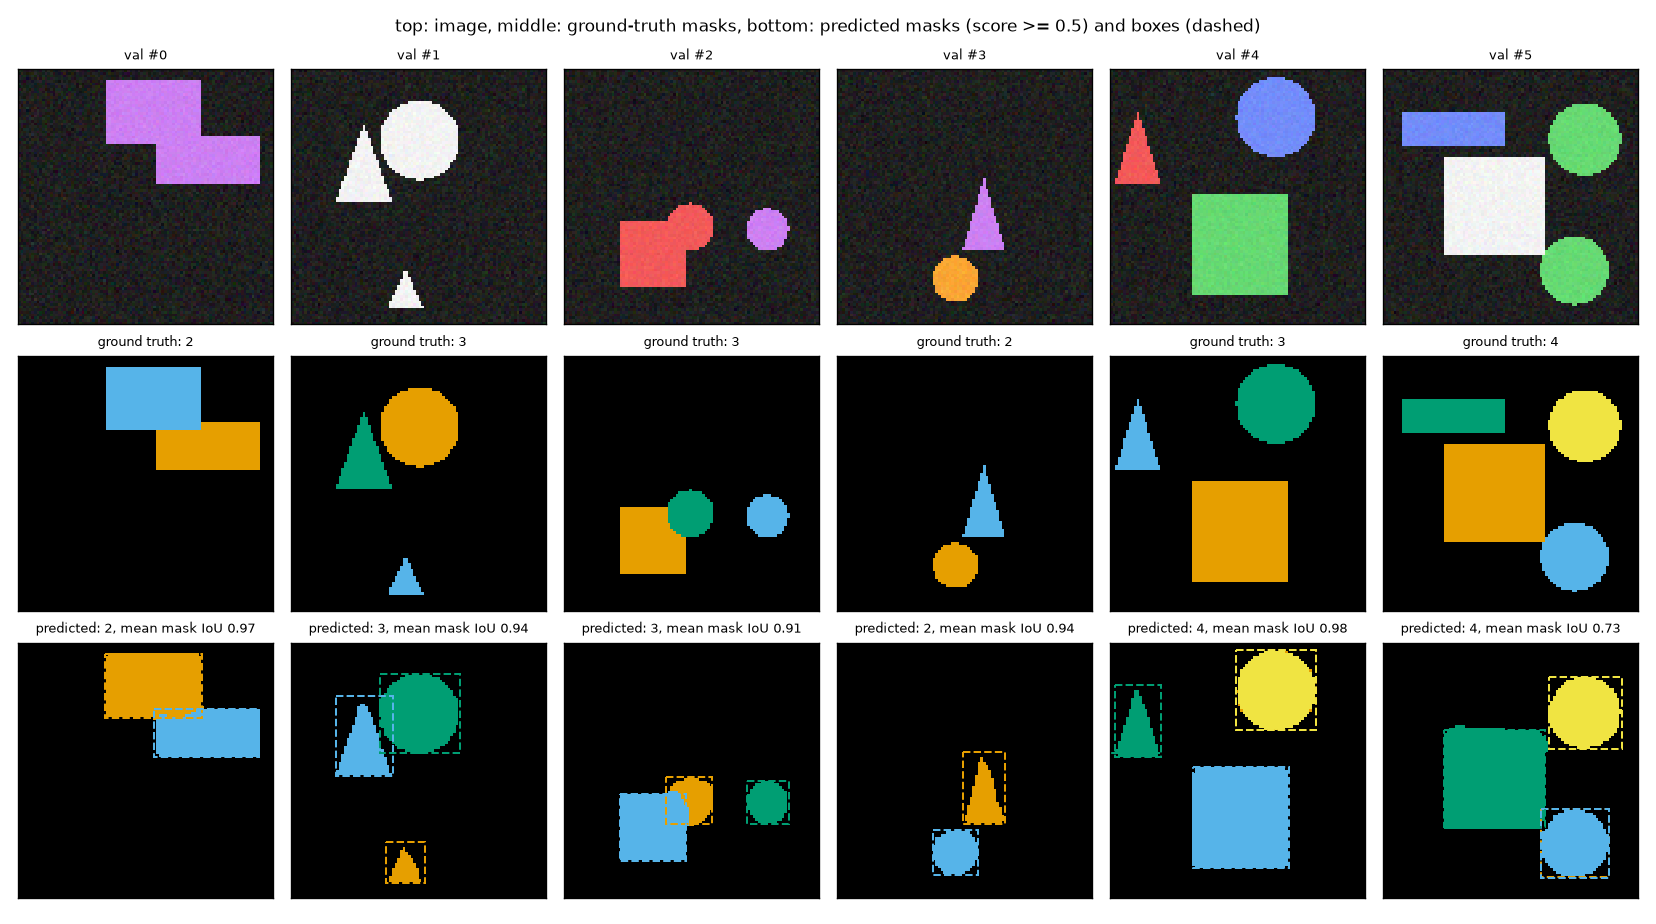
그림 13-6 의 아랫줄을 가운뎃줄과 견주어 봅니다. 원의 둥근 가장자리, 삼각형의 기울어진 변이 박스(점선)와 달리 모양대로 그려졌습니다. #0 의 맞닿은 두 사각형, #2 의 사각형 귀퉁이에 걸친 작은 원도 따로 떨어진 마스크로 나왔습니다. 잘못된 곳도 둘 있습니다. #4 는 정답이 셋인데 예측이 넷입니다. 위쪽 원에 예측이 두 개 붙었고(둘 다 마스크는 정확합니다), 하나가 다른 하나에 덧칠되어 그림에서는 하나로 보입니다. #5 는 왼쪽 위의 납작한 사각형이 빠져 있습니다. 그 사각형을 그린 질의가 있고 마스크도 정확한데, 클래스 점수가 0.5 에 못 미쳐 그림에 나오지 않은 것입니다. 대신 오른쪽 아래 원에 예측이 둘 붙었습니다. 두 경우 모두 마스크가 아니라 분류 점수 의 문제입니다. 마스크의 품질과 “이 질의가 객체인가” 의 판단은 서로 다른 머리가 맡습니다.
질의 하나의 내적 지도
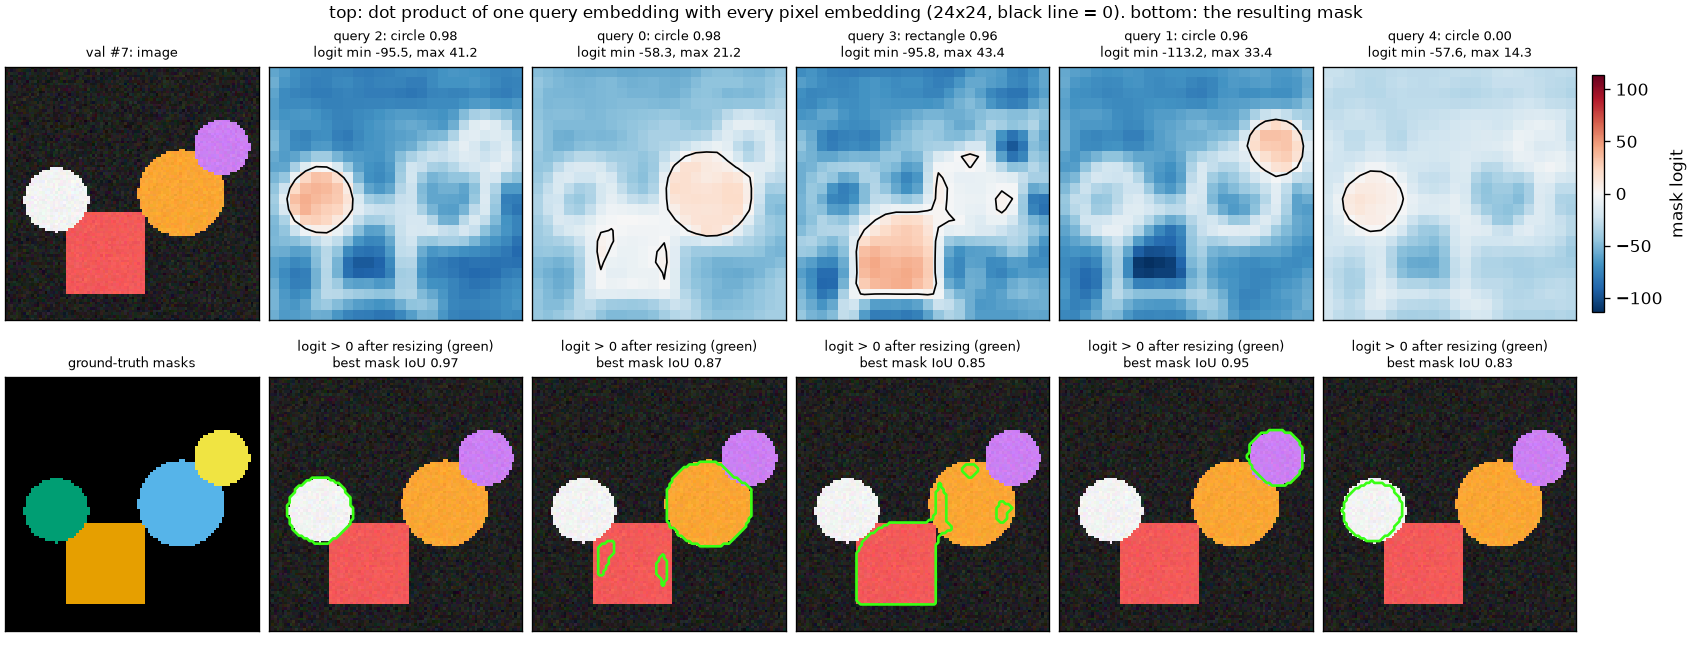
그림 13-7 은 이 장의 식 $z_n(x, y) = \langle f(q_n), e(x, y) \rangle + \beta$ 를 그대로 그린 것입니다.
- 질의마다 다른 객체가 양수입니다. 픽셀 임베딩 맵은 다섯 열 모두 같은 한 장입니다. 달라진 것은 질의 쪽 벡터뿐인데 양수인 자리가 흰 원, 주황 원, 사각형, 보라 원으로 갈립니다.
- 로짓의 크기가 큽니다. 최솟값이 $-113$, 최댓값이 $43$ 근처입니다. 시그모이드를 거치면 대부분의 칸이 0 아니면 1 에 붙습니다. 모델은 경계의 한두 칸에서만 망설입니다. 점 표본 추출이 “로짓이 0 에 가까운 점” 을 골라 주는 것이 왜 쓸모 있는지 보입니다.
- 다른 객체의 윤곽이 비칩니다. 어느 질의의 지도에서나 네 객체의 둘레가 옅은 띠로 보입니다. 픽셀 임베딩을 모두가 함께 쓰기 때문입니다. 대개는 음수에 머물지만 새어 나오기도 합니다. 둘째 열(주황 원)은 사각형 안에 작은 얼룩 둘이, 셋째 열(사각형)은 주황 원 쪽으로 삐져나온 부분이 0 을 넘었습니다. 마스크 IoU 가 0.87, 0.85 로 다른 둘(0.97, 0.95)보다 낮은 까닭입니다.
- 점수가 0 인 질의도 마스크를 그립니다. 맨 오른쪽 질의는 클래스 점수가 0.00 인데 흰 원을 IoU 0.83 으로 그렸습니다. 이상한 일이 아닙니다. 마스크 손실은 정답과 매칭된 질의에만 걸리므로, 짝이 없는 질의의 마스크는 어떤 모양이어도 벌을 받지 않습니다. 이 질의가 예측에서 빠지는 것은 마스크 때문이 아니라 분류 머리가 낮은 점수를 주기 때문입니다.
픽셀 임베딩을 들여다보기
픽셀 임베딩 맵은 칸마다 128개의 수라 그대로는 볼 수 없습니다. 두 가지 방법으로 봅니다. 하나는 주성분 분석(PCA)으로 128차원을 가장 많이 변하는 세 방향으로 줄여 빨강 · 초록 · 파랑에 대응시키는 것이고(6장에서 DINOv2 특징을 볼 때 쓴 방법), 다른 하나는 채널 몇 장을 그대로 보는 것입니다.
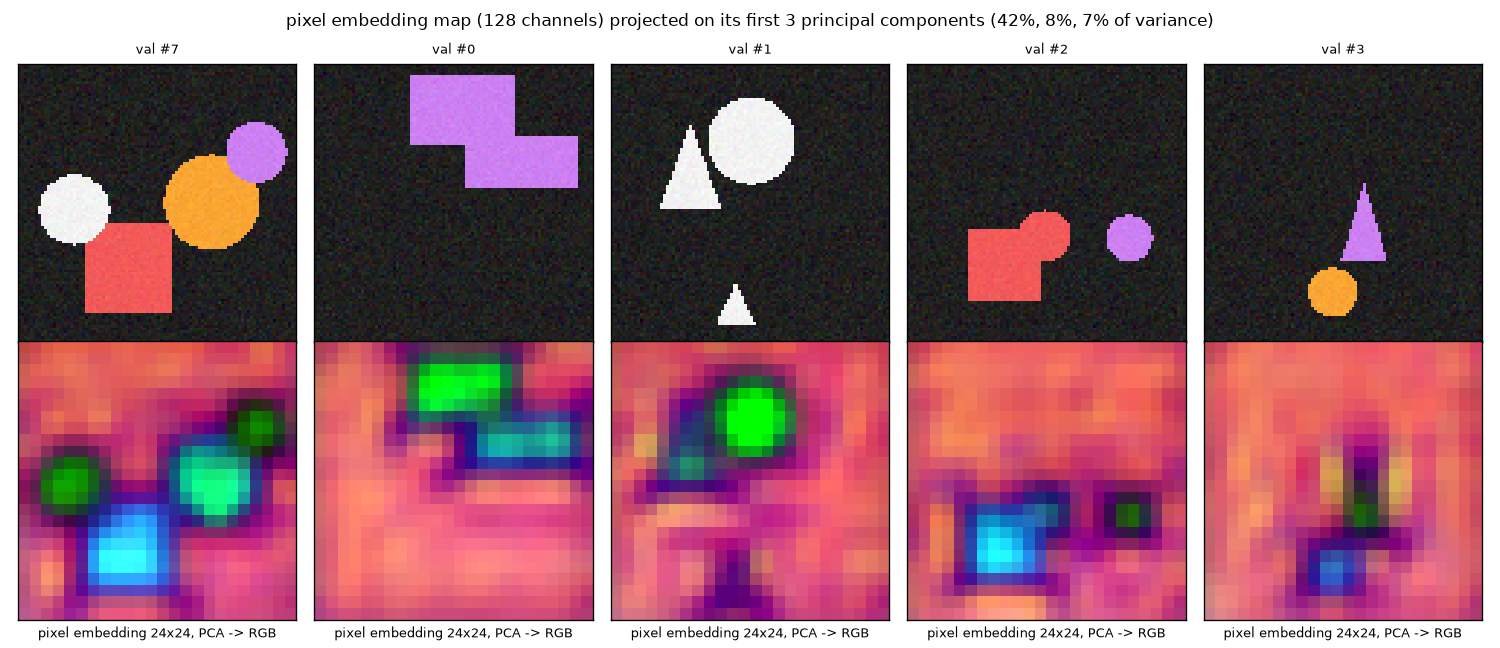
그림 13-8 에서 세 가지가 보입니다. 첫째, 객체와 배경이 갈립니다. 배경은 분홍 · 주황 계열이고 객체는 초록이나 파랑입니다. 둘째, 객체의 둘레에 짙은 띠 가 있습니다. 경계 근처의 칸은 안쪽과도 배경과도 다른 임베딩을 가집니다. 셋째, 객체마다 색이 다릅니다. #7 의 사각형은 하늘색, 원 셋은 밝기가 다른 초록입니다. 그런데 색이 클래스를 뜻하지는 않습니다. #3 의 원은 파랑이고 #0 의 두 사각형은 초록과 청록으로 서로 다릅니다. 내적으로 객체 하나만 골라내려면 같은 클래스의 다른 객체와도 임베딩이 달라야 하므로, 클래스로만 갈리면 오히려 곤란합니다. 배경도 한 가지 색이 아니라 위치에 따라 조금씩 달라집니다.
[픽셀 임베딩] 검증 그림 5장의 픽셀 임베딩 (5·24·24 = 2,880개, 128차원): 주성분 분산 비율 0.423, 0.083, 0.075, 0.063, 0.046, 0.039, 앞 3개 합 0.581, 앞 10개 합 0.822
  분산이 큰 채널 8개: [1, 63, 54, 32, 6, 111, 124, 75]. 그림에 쓴 검증 그림: #7 (객체 4개), #0 – #3
주성분의 분산 비율을 보면, 128개 채널 가운데 가장 큰 방향 하나가 분산의 42%, 앞의 열 개가 82% 를 가져갑니다. 채널은 128개지만 실제로 쓰이는 방향은 훨씬 적습니다. YOLACT 논문이 프로토타입 32장으로도 충분했다고 한 것과 통하는 관찰입니다(이 실험은 도형 세 종류의 작은 세상이라 필요한 방향이 더 적을 것입니다).
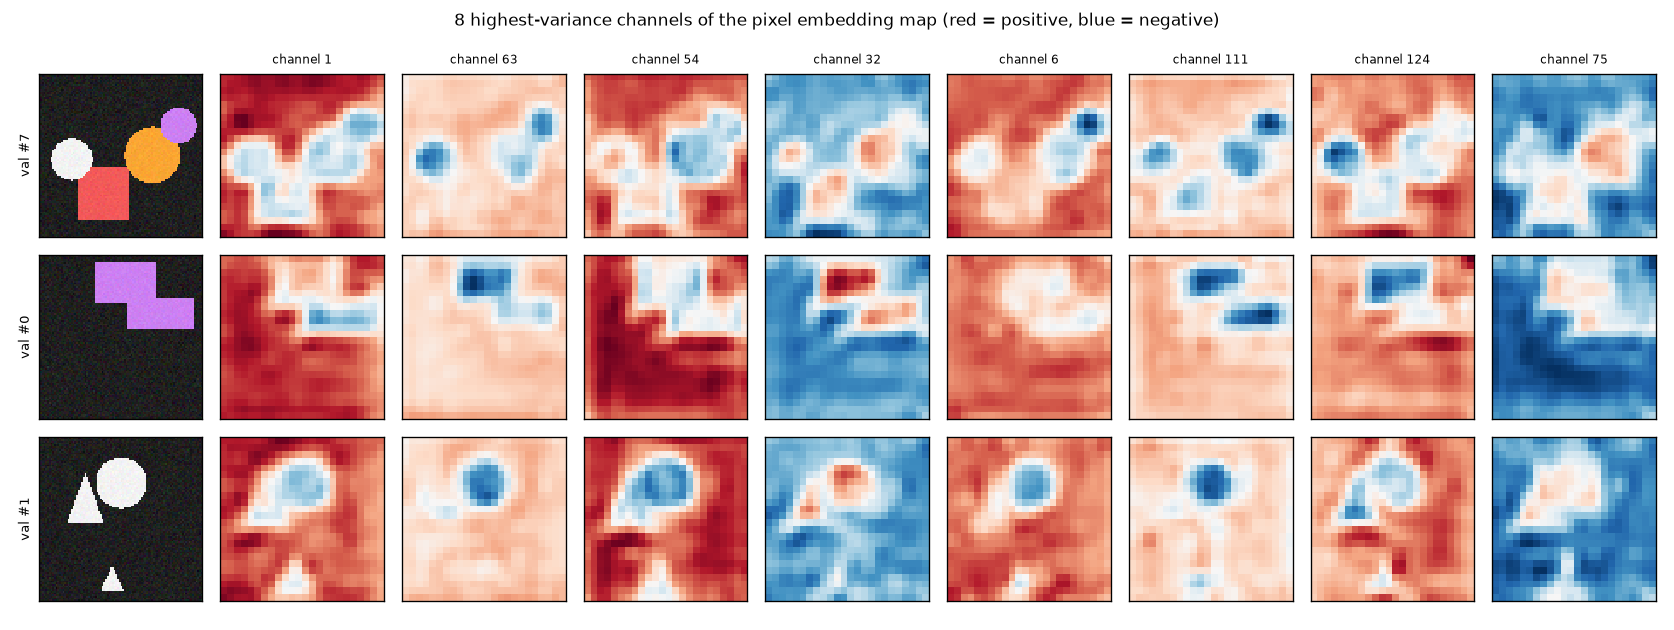
그림 13-9 가 “프로토타입” 의 실제 모습입니다. 어느 채널도 객체 하나를 깨끗이 오려 내지 않습니다. 채널 1 과 54 는 배경이 양수이고 객체 자리가 음수인 “배경 대 객체” 무늬이고, 채널 63 과 111 은 일부 객체에서만 강하게 음수입니다. 채널 32 는 반대로 배경이 음수이고 객체 안쪽이 양수입니다. 마스크는 이런 무늬 128장을 질의마다 다른 계수로 더하고 빼서 만들어집니다. YOLACT 논문이 계수가 음수일 수 있어야(프로토타입을 뺄 수 있어야) 한다고 강조한 까닭이 여기서 보입니다. 한 장만으로는 객체가 갈리지 않고, 한 장에서 다른 장을 빼야 객체 하나가 남습니다.
디코더 층을 떼면
논문은 디코더를 줄이면 분할 가지도 함께 줄어든다고 했습니다. 학습된 모델에서 추론 때 디코더를 $k$ 층만 쓰게 하고(dec_layers=k) 채점했습니다. 다시 학습하지 않은 같은 가중치입니다.
[디코더 층 수별] dec_layers = k 로 추론 (k 층만 쓰면 분할 머리의 블록도 k 개만 쓰인다; 0 = 인코더 제안, 블록 없음)
  층 수 | 박스 AP | 마스크 AP | 마스크 AP50 | 마스크 AP75 | 마스크 IoU 평균
      0 | 0.8787  | 0.7863    | 0.9657      | 0.8553      | 0.8838
      1 | 0.9233  | 0.8429    | 0.9732      | 0.8882      | 0.9068
      2 | 0.9325  | 0.8748    | 0.9844      | 0.9247      | 0.9236
      3 | 0.9349  | 0.8766    | 0.9884      | 0.9176      | 0.9274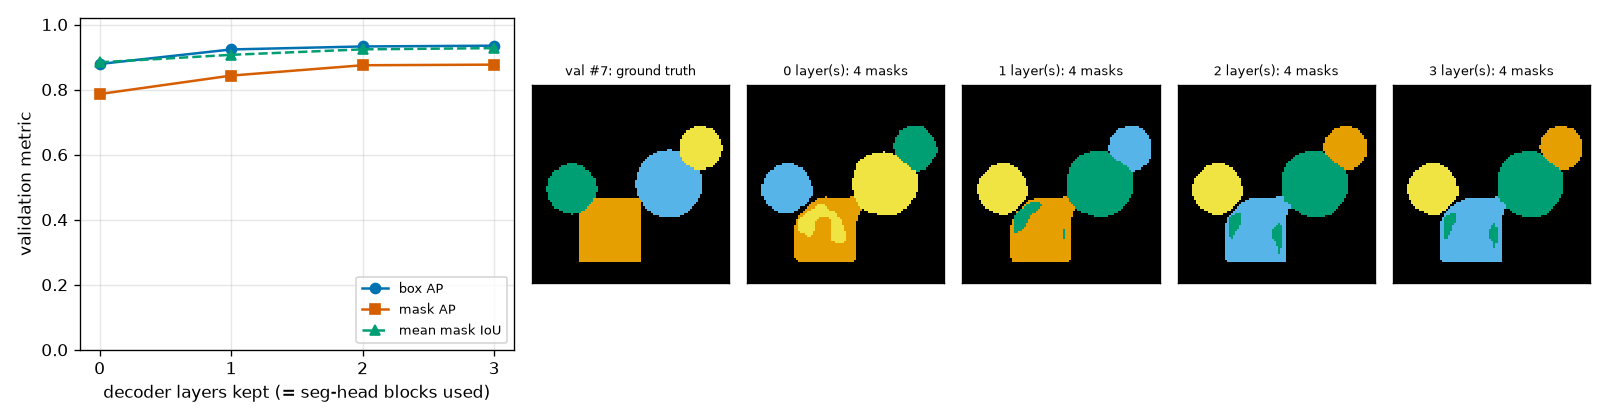
그림 13-10 과 표에서 읽을 것입니다.
- 마지막 층은 떼어도 거의 잃지 않습니다. 3층에서 2층으로 줄이면 마스크 AP 가 0.8766 에서 0.8748 로, 박스 AP 가 0.9349 에서 0.9325 로 내려갑니다. AP75 는 2층이 오히려 높습니다(0.9247 대 0.9176). 이 정도 차이는 우연과 구별할 수 없습니다.
- 마스크가 박스보다 층 수에 민감합니다. 3층에서 0층으로 가면 박스 AP 는 0.056, 마스크 AP 는 0.090 떨어집니다. 0층은 디코더도 없고 블록도 없습니다. 보간한 프로젝터 출력에 1×1 합성곱만 적용한 것이 픽셀 임베딩입니다. 디코더 한 층과 블록 하나가 붙으면 마스크 AP 가 0.057 오릅니다.
- 그래도 0층이 0.79 입니다. 블록을 하나도 거치지 않은 마스크가 쓸 만하다는 것은, 마스크에 필요한 정보의 대부분이 이미 프로젝터 출력에 있다는 뜻입니다. 오른쪽 그림에서 0층의 마스크는 객체의 자리는 맞지만 사각형 안에 다른 질의의 마스크가 섞여 있고, 층이 늘수록 그런 얼룩이 줄어듭니다.
논문은 분할 모델의 디코더가 탐지 모델보다 깊은 것(가장 작은 모델도 4층)을 두고 “쓸 만한 분할 머리의 최소 깊이” 가 있는 것 같다고 했습니다. 이 실험에서도 마스크 쪽이 층 수를 더 타는 방향은 같습니다. 다만 이 미니 모델은 2층이면 충분했고, COCO 의 복잡한 모양에서 몇 층이 필요한지는 이 실험이 말해 주지 않습니다.
박스 IoU 와 마스크 IoU
이 장의 첫 물음으로 돌아갑니다. 마스크는 박스보다 객체의 영역을 얼마나 더 잘 나타낼까요. 정답 객체마다 그 객체를 찾은 예측(같은 클래스, 점수 0.5 이상, 마스크 IoU 가 가장 큰 것)을 골라 네 가지를 쟀습니다.
- 정답 박스를 그대로 영역이라고 했을 때의 마스크 IoU(박스가 완벽할 때의 한계)
- 예측 박스를 영역이라고 했을 때의 마스크 IoU(탐지기만 있을 때 얻는 것)
- 예측 마스크의 마스크 IoU(분할 머리를 달아 얻는 것)
- 정답 마스크를 1/4 해상도로 줄였다 키운 것의 마스크 IoU(앞의 기준선)
[객체별 분석] 정답 객체 1265개 가운데 점수 ≥ 0.5 · 같은 클래스 · 겹치는 예측이 있는 것 1259개. 마스크 IoU 평균 0.9274 (찾은 것만 0.9318), 박스 IoU 평균 0.9415
  클래스      | 객체 수 | 정답 박스를 마스크로 | 예측 박스를 마스크로 | 예측 마스크 | 박스 IoU | 1/4 기준선 | 1/2 기준선
  circle      |     428 |               0.7696 |               0.7564 |      0.9300 |   0.9549 |     0.9611 |     0.9895
  rectangle   |     445 |               0.9774 |               0.9538 |      0.9452 |   0.9295 |     0.9722 |     0.9940
  triangle    |     392 |               0.4913 |               0.4843 |      0.9043 |   0.9404 |     0.9151 |     0.9751
  보이는 넓이(픽셀) | 객체 수 | 예측 마스크 IoU | 박스 IoU | 1/4 기준선 | 1/2 기준선
  0 – 300           |     305 |          0.8792 |   0.9094 |     0.9090 |     0.9743
  300 – 700         |     607 |          0.9299 |   0.9436 |     0.9550 |     0.9881
  700 이상            |     353 |          0.9647 |   0.9655 |     0.9795 |     0.9947
  가림 (보이는 비율)            | 객체 수 | 예측 마스크 IoU | 박스 IoU | 정답 박스를 마스크로 | 예측 박스를 마스크로
  가려지지 않음 (1.0)          |    1013 |          0.9393 |   0.9525 |               0.7640 |               0.7518
  조금 가려짐 (0.9 이상)        |     161 |          0.9261 |   0.9417 |               0.7744 |               0.7595
  많이 가려짐 (0.9 미만)        |      91 |          0.7973 |   0.8189 |               0.6407 |               0.5955
  가려진 객체 252개의 보이는 비율: 평균 0.899, 최소 0.467
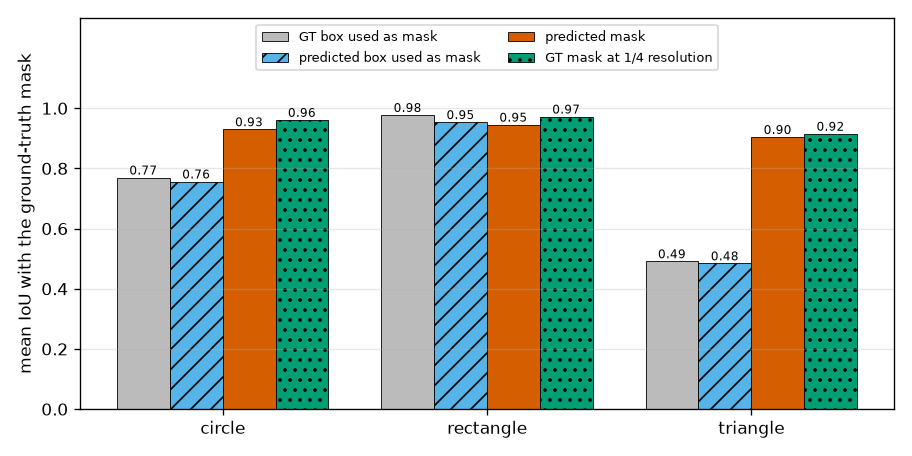
- 삼각형과 원에서 마스크가 크게 이깁니다. 삼각형은 박스를 영역으로 쓰면 0.48 인데 마스크는 0.90 입니다. 원은 0.76 대 0.93 입니다. 회색 막대(0.49, 0.77)는 앞에서 손으로 구한 0.5 와 $\pi/4 \approx 0.785$ 에서 가림과 픽셀 격자의 몫만큼 내려간 값입니다.
- 사각형에서는 박스가 마스크를 조금 이깁니다. 예측 박스를 영역으로 쓴 것이 0.9538, 예측 마스크가 0.9452 입니다. 사각형은 박스가 곧 모양이고, 박스는 실수 좌표 네 개로 변을 픽셀보다 세밀하게 놓을 수 있습니다. 마스크는 24×24 격자에서 키운 것이라 모서리가 둥글어집니다. 분할 머리가 언제나 박스보다 나은 것은 아닙니다.
- 작은 객체일수록 마스크가 나쁩니다. 보이는 넓이가 300픽셀 미만인 객체는 마스크 IoU 가 0.879, 700픽셀 이상은 0.965 입니다. 기준선도 같은 방향입니다(0.909 대 0.980). 300픽셀짜리 객체는 24×24 격자에서 19칸쯤입니다. 몇 칸으로는 경계를 정밀하게 그릴 수 없습니다. 논문 표에서 APS 가 입력 해상도를 가장 크게 탄 것과 같은 현상입니다.
- 1/2 해상도라면. 기준선의 마지막 열은 마스크 격자가 48×48 일 때입니다. 작은 객체의 기준선이 0.909 에서 0.974 로 오릅니다. 실제로 그만큼 좋아지는지는 절제 실험에서 확인합니다.
겹친 객체에서
위 출력의 마지막 표는 객체를 가려진 정도로 나눈 것입니다. 가려지지 않은 객체의 마스크 IoU 는 0.939, 조금 가려진 객체(보이는 비율 0.9 이상)는 0.926 으로 거의 같고, 많이 가려진 객체(0.9 미만, 91개)는 0.797 로 뚝 떨어집니다. 박스 IoU 도 0.819 로 함께 떨어집니다. 그래도 박스보다는 낫습니다. 많이 가려진 객체에서 예측 박스를 영역으로 쓰면 0.596 이므로, 마스크가 0.2 더 높습니다. 가려지지 않은 객체에서의 차이(0.939 대 0.752)와 비슷한 크기입니다.
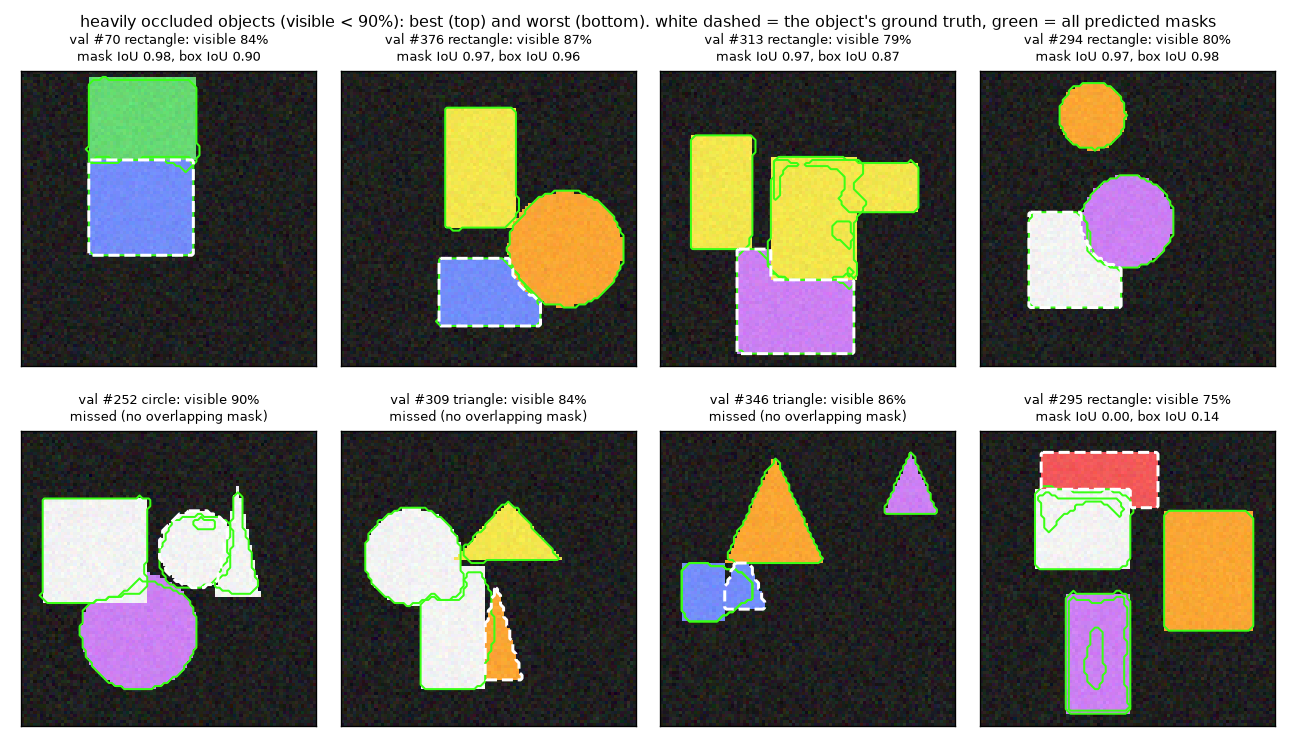
그림 13-12 의 윗줄은 잘된 경우입니다. 다른 도형에 한쪽이 덮인 사각형을 덮인 부분을 뺀 모양(ㄴ 자, 귀퉁이가 둥글게 파인 모양)대로 그렸습니다. 박스로는 나타낼 수 없는 모양입니다. 아랫줄은 실패입니다. 앞의 셋은 그 객체에 겹치는 예측이 하나도 없습니다(제목의 missed). 그 가운데 둘은 같은 색의 도형이 맞닿은 경우입니다. #252 는 흰 원이 흰 사각형 · 흰 삼각형과, #346 은 파란 삼각형이 파란 사각형과 붙어 있습니다. 색으로 경계를 알 수 없으니 모델은 이웃 도형의 마스크를 그 자리까지 넓혀 그렸습니다. #309 의 주황 삼각형은 색이 다른데도 놓쳤습니다. 넷째(#295)는 빨간 사각형이 흰 사각형에 아래쪽을 가려 가로로 긴 띠만 남은 경우인데, 그 띠를 제대로 그린 마스크가 없습니다. 이 넷은 분할 머리 이전에 탐지의 실패 입니다. 질의가 그 객체를 찾지 못하면 마스크도 없습니다.
도형 세상은 장면을 만들 때 두 도형의 박스가 작은 쪽 넓이의 35% 넘게 겹치지 않도록 막아 둡니다(rf_shapes.py 의 max_covered). 그래서 검증 세트에서 가장 많이 가려진 객체도 절반 가까이(0.467)는 보입니다.
사람이 빽빽한 사진처럼 객체의 대부분이 가려지는 경우는 이 실험에 없습니다.
분할 머리의 값
[분할 머리의 값] 매개변수 219,137 / 2,051,844 (10.7%). 추론 순전파 (배치 64, 그림 한 장당, 30번 가운데 최솟값): 분할 머리 없이 0.173 ms, 있을 때 0.258 ms, 모든 층의 마스크까지 0.286 ms
본 실험 전체 582초
미니 모델에서 분할 머리는 매개변수의 10.7% 입니다. Nano 의 2.8% 보다 훨씬 큰 것은 미니 모델의 백본이 작기 때문입니다(머리의 크기는 $D$ 로 정해지고 백본과 무관합니다). 추론 시간은 그림 한 장당 0.173 ms 에서 0.258 ms 로 약 1.5배가 됐습니다. 이 수치는 노트북 GPU, PyTorch, 배치 64 에서 잰 참고값이고, 10장에서 밝혔듯 이렇게 작은 모델의 시간은 계산량보다 연산 호출 수에 좌우됩니다. 논문에서 비슷한 크기의 두 모델을 견주면 RF-DETR (nano) 가 2.3 ms, RF-DETR-Seg (nano) 가 3.4 ms 입니다. 다만 두 모델은 해상도 · 패치 · 디코더 층 수 · 질의 수가 모두 달라서 그 차이가 분할 머리만의 값은 아닙니다.
절제 실험
마지막으로 설계의 선택들을 하나씩 바꿔 봅니다. 모든 변형은 본 실험과 똑같이 11장의 체크포인트에서 출발하고, 4 에폭만 학습합니다. 첫 줄이 본 실험과 같은 설정이고, 나머지는 거기서 한 가지만 바꾼 것입니다. 시드 3개(0, 1, 2)로 돌렸습니다.
- BCE 만(다이스 계수 0) / 다이스만(BCE 계수 0). 매칭 비용의 해당 항도 함께 0 이 됩니다.
- 점 표본 추출 대신 정답 마스크의 모든 픽셀(9,216개)에서 손실 계산
- 매칭 비용에서 마스크 항을 빼기(손실은 그대로)
- 마스크 격자를 1/4(24×24) 대신 1/2(48×48)로
- 분할 머리 없이, 탐지 손실만으로 같은 4 에폭을 더 학습(박스 AP 의 대조군)
$ python ch13_seg.py --ablations            # 시드 0
$ python ch13_seg.py --ablations --seed 1   # 시드 1, 2 도 같은 방법으로
변형 일곱 개를 차례로 학습하므로 시드 하나에 8분 남짓(500초) 걸립니다. 마지막에 그때까지 저장된 모든 시드의 결과를 모아 요약 표를 출력합니다.
[절제 요약] 4 에폭 뒤의 EMA 모델, 시드 [0, 1, 2] (3개). 평균 (최소 – 최대)
  변형                                       | 박스 AP                  | 마스크 AP                | 마스크 AP75              | 마스크 IoU 평균
  BCE + Dice, uncertain points (official)  | 0.9073 (0.9066 – 0.9085) | 0.7427 (0.7369 – 0.7533) | 0.8359 (0.8226 – 0.8612) | 0.8537 (0.8509 – 0.8559)
  BCE only                                 | 0.9218 (0.9207 – 0.9232) | 0.7074 (0.7043 – 0.7101) | 0.7861 (0.7820 – 0.7888) | 0.8485 (0.8447 – 0.8518)
  Dice only                                | 0.9206 (0.9195 – 0.9227) | 0.5607 (0.5235 – 0.5820) | 0.5900 (0.5375 – 0.6215) | 0.7983 (0.7822 – 0.8074)
  BCE + Dice, all pixels                   | 0.9166 (0.9157 – 0.9174) | 0.7325 (0.7209 – 0.7424) | 0.8163 (0.7975 – 0.8338) | 0.8542 (0.8498 – 0.8579)
  BCE + Dice, no mask term in matching     | 0.9067 (0.9059 – 0.9080) | 0.7394 (0.7338 – 0.7443) | 0.8351 (0.8242 – 0.8533) | 0.8531 (0.8518 – 0.8552)
  BCE + Dice, masks at 1/2 resolution      | 0.9057 (0.9039 – 0.9079) | 0.7747 (0.7677 – 0.7808) | 0.8528 (0.8434 – 0.8666) | 0.8666 (0.8660 – 0.8676)
  no segmentation head (detection only)    | 0.9342 (0.9335 – 0.9354) | —                        | —                        | —
절제 실험 전체 500초
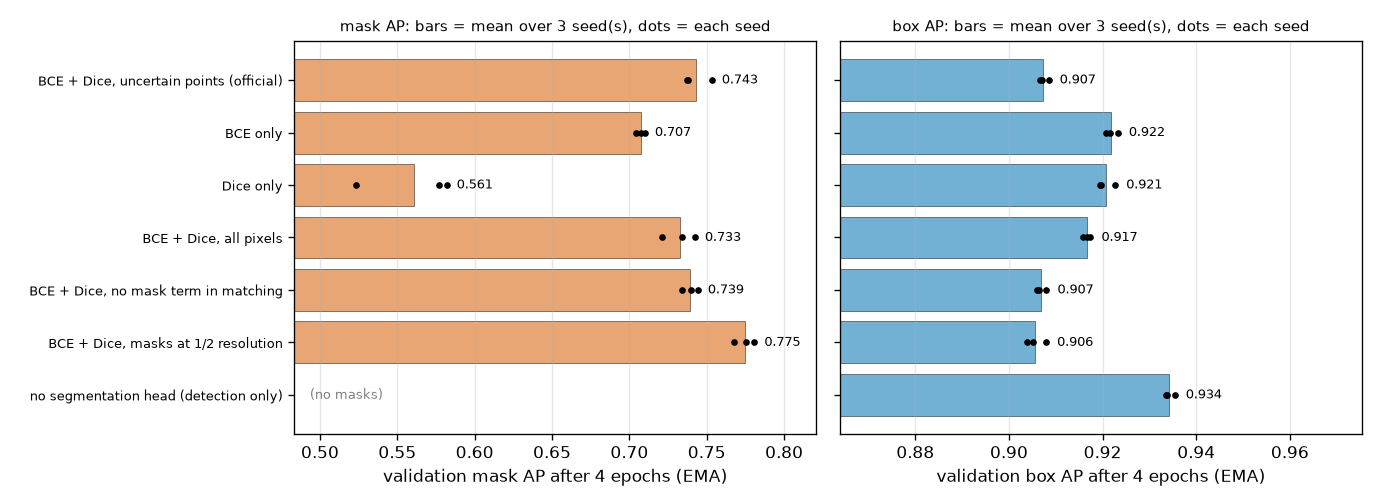
표를 읽는 규칙을 먼저 정합니다. 괄호 안은 시드 3개의 최소 – 최대입니다. 두 변형의 범위가 겹치면 차이를 읽지 않습니다.
- BCE 와 다이스를 함께 쓴 것이 가장 좋고, 다이스만 쓴 것이 가장 나쁩니다. 마스크 AP 가 둘 다 0.743, BCE 만 0.707, 다이스만 0.561 입니다. 세 범위가 서로 겹치지 않습니다. 다이스만 쓴 모델은 마스크 IoU 평균이 0.798 로 아주 나쁘지는 않은데 AP75 가 0.590 으로 낮습니다. 대강의 영역은 잡지만 경계가 무딥니다. 기울기를 유도할 때 본 대로입니다. 다이스 손실은 개별 점이 얼마나 틀렸는지 구별하지 않아, 경계를 한 칸씩 다듬는 신호가 약합니다. 반대로 BCE 만으로는 꽤 잘 됩니다. “작은 객체가 배경에 묻힌다” 는 BCE 의 약점은 이 실험에서 크게 드러나지 않았습니다. 도형 세상의 객체는 가장 작은 것도 24×24 격자에서 대여섯 칸은 되고 대부분은 수십 칸이기 때문일 수 있습니다. 다이스를 더한 이득은 0.035 입니다.
- 점 36개로 계산한 손실이 9,216개 픽셀 전부로 계산한 것보다 나쁘지 않습니다. 마스크 AP 0.743 대 0.733 이고 범위가 겹칩니다(0.737 – 0.753 대 0.721 – 0.742). 점을 256배 더 써도 나아지지 않았습니다. Mask2Former 논문이 점으로 계산해도 성능이 떨어지지 않는다고 보고한 것과 같은 방향입니다. 박스 AP 는 전체 픽셀 쪽이 조금 높았습니다(0.917 대 0.907, 범위가 겹치지 않습니다). 불확실한 점만 골라 보면 손실 값이 커지므로 탐지 쪽을 더 흔드는 것일 수 있지만, 확인하지는 않았습니다.
- 매칭 비용의 마스크 항은 여기서 차이를 만들지 않았습니다. 뺀 것이 0.739, 넣은 것이 0.743 으로 범위가 겹치고, 박스 AP 도 같습니다(0.907). 이미 박스를 잘 맞히는 탐지기에서 출발했으므로 박스와 클래스만으로 짝이 거의 정해지는 것으로 보입니다. 처음부터 학습하거나 객체가 빽빽이 겹치는 데이터에서도 그런지는 이 실험이 말해 주지 않습니다.
- 마스크 격자를 1/2 해상도로 키우면 마스크 AP 가 오릅니다. 0.743 에서 0.775 로 0.032 올랐고 범위가 겹치지 않습니다. 박스 AP 는 그대로입니다(0.906). 앞의 기준선이 예고한 방향입니다. 분할 머리가 다루는 칸은 4배가 됩니다. 논문이 분할 특징의 해상도를 NAS 결과를 가르는 변수로 꼽은 까닭을 작은 실험으로 본 셈입니다.
- 박스 AP 가 떨어진 것은 마스크 학습 때문입니다. 분할 머리 없이 같은 4 에폭을 더 학습한 대조군은 박스 AP 가 0.934 로 출발점(0.9347)에 머뭅니다. 분할 머리를 단 모델은 같은 시점에 0.907 입니다. 체크포인트에서 다시 시작해서 생긴 흔들림이 아니라는 뜻입니다. 마스크 손실을 하나만 쓴 두 변형은 0.922, 0.921 로 덜 떨어졌습니다. 마스크 손실의 계수 합이 10 에서 5 로 줄자 하락 폭도 0.027 에서 0.013 쯤으로 줄었습니다. 매칭 비용에서 마스크 항을 빼도 하락은 그대로였으므로(0.907), 원인은 매칭이 아니라 손실 쪽에 있습니다. 마스크 손실의 기울기가 탐지와 함께 쓰는 백본 · 프로젝터 · 디코더를 움직인 것입니다. 본 실험에서는 이 하락이 30 에폭에 걸쳐 회복됐습니다.
- “BCE 만”, “다이스만” 은 손실 하나를 뺀 것이라 마스크 손실의 계수 합도 10 에서 5 로 줄었습니다. 손실의 종류와 크기가 함께 바뀐 비교입니다.
- 모두 4 에폭 시점입니다. 본 실험의 마스크 AP 는 4 에폭에 0.738, 30 에폭에 0.877 이었습니다. 끝까지 학습하면 변형 사이의 차이가 줄거나 순서가 바뀔 수 있습니다.
- 박스 AP 하락의 구체적인 경로(기울기 자르기 0.1 아래에서 탐지 손실의 몫이 줄어드는지, 특징 자체가 마스크 쪽으로 옮겨 가는지)는 따로 실험하지 않았습니다.
이 실험에서 말할 수 있는 것과 없는 것
- 말할 수 있는 것. 탐지만 배운 모델에 이 장의 분할 머리를 달아 함께 학습하면, 도형 세상에서는 박스 AP 를 잃지 않고(0.9347 → 0.9349) 마스크 AP 0.877 을 얻습니다. 원과 삼각형에서는 마스크가 박스보다 영역을 훨씬 잘 나타내고, 사각형에서는 그렇지 않습니다. 마스크의 품질은 객체가 작을수록, 많이 가려질수록, 디코더 층이 적을수록 떨어집니다.
- 말할 수 없는 것. 본 실험은 시드 하나입니다. 0.01 안쪽의 차이는 읽지 마세요. 도형은 단색이고 경계가 또렷해서 COCO 의 털 · 그림자 · 투명한 물체 같은 어려움이 없습니다. 논문의 사전 학습(SAM2 의사 라벨)은 따라 하지 않았고, 30 에폭에서 마스크 손실이 아직 내려가는 중이라 더 학습하면 수치가 달라질 수 있습니다. 절제 실험은 4 에폭 시점의 비교라, 끝까지 학습했을 때의 순서와 다를 수 있습니다.
실전으로 잇기
이 장에서 손으로 만든 것은 rfdetr 패키지 안에 그대로 있습니다. 분할 모델은 RFDETRSegNano 부터 RFDETRSeg2XLarge 까지의 클래스로 제공되고, 쓰는 법은 탐지 모델과 같습니다.
달라지는 것은 둘입니다. 학습 데이터의 주석에 마스크(다각형)가 있어야 하고, 예측 결과에 객체마다의 마스크가 더 들어 있습니다.
내려받기 · 추론 · 미세 조정 · 내보내기의 실제 절차와 분할 모델의 설정 표는 14장의 “분할과 키포인트 모델” 에서 다룹니다. 이 장과 이어지는 곳만 짚어 둡니다.
| 이 장에서 본 것 | 패키지에서의 이름 |
|---|---|
| 분할 머리 | rfdetr.models.heads.segmentation.SegmentationHead |
| 마스크 격자의 배율 $r = 4$ | ModelConfig.mask_downsample_ratio |
| 마스크 BCE · 다이스 손실의 계수 5 · 5 | SegmentationTrainConfig.mask_ce_loss_coef, mask_dice_loss_coef |
| 점 표본 추출의 16 | SegmentationTrainConfig.mask_point_sample_ratio |
| 로짓을 키워 0 에서 자르는 후처리 | rfdetr.models.postprocess.PostProcess |
- 인스턴스 분할의 출력은 객체마다 (클래스, 박스, 마스크)입니다. 마스크는 칸마다 0/1 인 격자이고, 모델은 칸마다 로짓을 내어 0 보다 크면 1 로 봅니다.
- RF-DETR-Seg 는 마스크를 질의 쪽 벡터와 픽셀 임베딩의 내적 으로 만듭니다: $z_n(x, y) = \langle f(q_n), e(x, y) \rangle + \beta$. 픽셀 임베딩 맵은 그림마다 한 번만 만들고 모든 질의가 함께 씁니다.
- 픽셀 임베딩 맵의 채널은 모든 객체가 함께 쓰는 프로토타입이고, 질의 쪽 벡터는 그것을 섞는 계수입니다(YOLACT 의 해석). MaskDINO 와 뼈대가 같지만 다중 스케일 백본 특징을 쓰지 않습니다.
- 분할 머리는 프로젝터 출력을 그림의 1/4 해상도로 쌍선형 보간하고, 깊이별 분리 합성곱 블록을 디코더 층 수만큼 차례로 지납니다. 층 $l$ 의 질의는 블록을 $l$ 개 지난 맵과 내적됩니다. 디코더 층을 떼면 블록도 함께 빠집니다.
- 깊이별 분리 합성곱은 이웃을 보는 일과 채널을 섞는 일을 나눠, 보통의 3×3 합성곱의 약 1/8 – 1/9 의 매개변수를 씁니다.
- 마스크 손실은 BCE(칸마다 채점, 작은 객체가 배경에 묻힘)와 다이스 손실(겹친 비율을 채점, 크기와 무관)을 계수 5 · 5 로 더한 것입니다. $\operatorname{Dice} = 2\,\IoU / (1 + \IoU)$ 입니다.
- 손실과 매칭 비용은 마스크의 모든 칸이 아니라 칸 수의 1/16 만큼 뽑은 점에서 계산합니다. 손실은 불확실한 점 위주로 쌍마다, 매칭은 균등하게 모두 같은 점에서.
- 추론 때는 로짓을 그림 크기로 키운 뒤 0 에서 자릅니다. 채점은 IoU 를 마스크끼리 재는 마스크 AP 입니다.
- 분할 특징의 해상도가 입력 해상도의 1/4 에 묶여 있어서, 탐지에서 통하던 “공간 위치 수가 같으면 같은 성능” 규칙이 분할에서는 깨집니다. NAS 가 찾은 분할 모델은 패치 12 에 좁고 깊은 디코더를 씁니다.
- 이 튜토리얼의 실험: 11장의 미니 RF-DETR 에 분할 머리를 달아 30 에폭 함께 학습하니 박스 AP 는 0.9347 → 0.9349 로 그대로였고 마스크 AP 0.8766 을 얻었습니다(시드 1개). 마스크는 삼각형 · 원에서 박스보다 훨씬 낫고 사각형에서는 아니었으며, 작은 객체 · 많이 가려진 객체 · 얕은 디코더에서 나빠졌습니다. 4 에폭 절제(시드 3개)에서는 BCE + 다이스 > BCE 만 > 다이스만 순이었고, 점 표본 추출은 전체 픽셀보다 나쁘지 않았고, 마스크 해상도를 1/2 로 올리면 마스크 AP 가 올랐습니다.
확인 문제
2×2 격자의 픽셀 임베딩이 윗줄 $(1, 2)$, $(3, 0)$, 아랫줄 $(-1, 1)$, $(0, -2)$ 이고 질의 쪽 벡터가 $f(q) = (1, -1)$, 편향이 $\beta = 0.5$ 입니다. (가) 네 칸의 로짓과 마스크를 구하세요. (나) $\beta$ 만 2 로 바꾸면 마스크가 어떻게 달라지나요?
답 보기
(가) 왼쪽 위 $1 \times 1 + (-1) \times 2 + 0.5 = -0.5$, 오른쪽 위 $3 - 0 + 0.5 = 3.5$, 왼쪽 아래 $-1 - 1 + 0.5 = -1.5$, 오른쪽 아래 $0 + 2 + 0.5 = 2.5$. 로짓이 양수인 칸은 오른쪽 두 칸이므로 마스크는 $\begin{pmatrix} 0 & 1 \\ 0 & 1 \end{pmatrix}$ 입니다.
(나) 모든 로짓이 1.5 씩 올라 $1.0,\ 5.0,\ 0.0,\ 4.0$ 이 됩니다. 왼쪽 위가 새로 들어오고, 왼쪽 아래는 정확히 0 이라 “0 보다 크다” 를 만족하지 못해 여전히 0 입니다. 마스크는 $\begin{pmatrix} 1 & 1 \\ 0 & 1 \end{pmatrix}$. 편향은 모든 질의 · 모든 칸의 마스크를 한꺼번에 넓히거나 좁히는 손잡이입니다.
RF-DETR-Seg (medium) 은 해상도 432, 패치 12, 디코더 5층, 질의 200개입니다. (가) 프로젝터 격자와 마스크 격자의 한 변은 각각 몇 칸인가요? (나) 추론 때 그림 한 장의 마스크 로짓은 모두 몇 개인가요? (다) 학습 때 매칭된 쌍 하나의 마스크 손실은 점 몇 개에서 계산되고, 그 가운데 “불확실한 점” 은 몇 개인가요? (라) 추론 때 디코더를 3층만 쓰면 분할 머리의 블록은 몇 개가 실행되나요?
답 보기
(가) $432 / 12 = 36$ 칸, $432 / 4 = 108$ 칸. 쌍선형 보간으로 한 변을 3배로 키웁니다.
(나) $200 \times 108 \times 108 = 2{,}332{,}800$ 개.
(다) $\max(108,\ \lfloor 108 \times 108 / 16 \rfloor) = \max(108,\ 729) = 729$ 개. 후보 $3 \times 729 = 2{,}187$ 개 가운데 로짓이 0 에 가까운 $\lfloor 0.75 \times 729 \rfloor = 546$ 개를 고르고, 나머지 183개는 균등하게 뽑습니다.
(라) 3개. 블록은 층별 질의 임베딩과 한 쌍씩 짝지어 실행되므로, 질의 임베딩이 3층 것까지만 있으면 블록도 앞의 3개만 쓰입니다. 블록은 원래 5개(디코더 층 수)입니다.
채널 수 $D = 256$ 일 때 (가) 보통의 3×3 합성곱, (나) 깊이별 3×3 합성곱, (다) 1×1 합성곱의 매개변수 수를 편향까지 넣어 구하세요. (라) 층 정규화(채널마다 배율과 이동)까지 넣은 블록 하나는 몇 개이고, 블록 4개면 몇 개인가요? 본문의 RF-DETR-Seg Nano 값과 맞는지 확인하세요.
답 보기
(가) $256 \times 256 \times 9 + 256 = 590{,}080$. (나) $256 \times 9 + 256 = 2{,}560$. (다) $256 \times 256 + 256 = 65{,}792$.
(나) + (다) $= 68{,}352$ 로, (가) 의 약 8.6분의 1 입니다($D = 128$ 일 때의 8.3 보다 9 에 더 가깝습니다).
(라) 층 정규화 $2 \times 256 = 512$ 를 더해 블록 하나가 $68{,}864$ 개, 4개면 $275{,}456$ 개. 본문 출력의 “블록 275,456” 과 같습니다.
예측 마스크가 10칸, 정답 마스크가 8칸이고 겹친 칸이 6칸입니다. (가) IoU 와 다이스 계수를 정의로 구하고, $\operatorname{Dice} = 2\,\IoU/(1 + \IoU)$ 로 검산하세요. (나) 마스크 AP75 는 IoU 가 0.75 이상인 예측만 참 양성으로 칩니다. 다이스 계수로는 얼마 이상인가요?
답 보기
(가) 합집합은 $10 + 8 - 6 = 12$ 칸이므로 $\IoU = 6/12 = 0.5$. 다이스는 $2 \times 6 / (10 + 8) = 12/18 = 0.667$. 검산: $2 \times 0.5 / 1.5 = 0.667$.
(나) $2 \times 0.75 / 1.75 = 0.857$. 다이스가 IoU 보다 늘 후한 수이므로, 같은 기준을 다이스로 적으면 더 높은 숫자가 됩니다.
뽑은 점 다섯 개의 확률이 $p = (0.6,\ 0.9,\ 0.2,\ 0.4,\ 0.1)$, 정답이 $t = (1,\ 1,\ 1,\ 0,\ 0)$ 입니다. (가) 공식 구현의 다이스 손실(+1 평활)을 구하세요. (나) $\partial L_{\text{dice}} / \partial p_i$ 를 객체인 점과 배경인 점에 대해 구하세요. 확률 0.2 를 받은 객체 점과 0.9 를 받은 객체 점의 기울기는 어떻게 다른가요?
답 보기
(가) $\sum p_i t_i = 0.6 + 0.9 + 0.2 = 1.7$, $\sum p_i = 2.2$, $\sum t_i = 3$. $U = 2 \times 1.7 + 1 = 4.4$, $V = 2.2 + 3 + 1 = 6.2$ 이므로 $L_{\text{dice}} = 1 - 4.4/6.2 = 0.2903$.
(나) 객체인 점: $-(2V - U)/V^2 = -(12.4 - 4.4)/38.44 = -0.2081$. 배경인 점: $U/V^2 = 4.4/38.44 = 0.1145$.
0.2 를 받은 점과 0.9 를 받은 점의 기울기는 같습니다($-0.2081$). 다이스 손실의 기울기(확률에 대한)는 그 점이 얼마나 틀렸는지를 구별하지 않습니다. BCE 평균이라면 $-\tfrac{1}{5} \cdot \tfrac{1}{0.2} = -1.0$ 대 $-\tfrac{1}{5} \cdot \tfrac{1}{0.9} = -0.222$ 로 더 틀린 점이 4.5배 크게 밀립니다. 두 손실을 함께 쓰는 까닭입니다.
마스크 격자가 78×78 = 6,084칸이고 객체가 20칸입니다. 모델이 모든 칸에 $p = 0.02$ 를 냈습니다. (가) BCE 평균을 구하세요($-\ln 0.02 = 3.912$, $-\ln 0.98 = 0.0202$). (나) 다이스 손실을 구하세요. (다) 두 값을 견주어, 이 예측을 고치라는 신호가 어느 손실에서 더 분명한지 말해 보세요.
답 보기
(가) $(20 \times 3.912 + 6{,}064 \times 0.0202)/6{,}084 = (78.24 + 122.51)/6{,}084 = 0.0330$. 놓친 20칸의 손실 합(78.24)이 맞힌 6,064칸의 작은 손실 합(122.51)보다도 작습니다.
(나) $\sum p_i = 6{,}084 \times 0.02 = 121.68$, $\sum p_i t_i = 20 \times 0.02 = 0.4$. $L_{\text{dice}} = 1 - (0.8 + 1)/(121.68 + 20 + 1) = 1 - 1.8/142.68 = 0.9874$.
(다) BCE 는 0.033 으로 “거의 다 맞혔다” 는 값이고, 다이스 손실은 0.987 로 최댓값에 가깝습니다. 객체를 통째로 놓쳤다는 사실은 다이스 손실에서만 크게 드러납니다.
해상도 504 · 패치 12 인 모델(RF-DETR-Seg large 의 구성)과 해상도 672 · 패치 16 인 모델이 있습니다. (가) 두 모델의 프로젝터 격자는 각각 몇 칸인가요? (나) 마스크 격자는 각각 몇 칸이고, 분할 머리가 다루는 칸 수는 몇 배 차이인가요? (다) 탐지 모델이라면 두 구성의 성능이 비슷하리라고 12장의 규칙이 말합니다. 분할 모델에서는 왜 그 규칙을 그대로 쓸 수 없나요?
답 보기
(가) $504/12 = 42$, $672/16 = 42$. 같습니다.
(나) $504/4 = 126$, $672/4 = 168$. 칸 수는 $168^2 / 126^2 = 28{,}224 / 15{,}876 \approx 1.78$ 배입니다.
(다) 분할 특징은 프로젝터 격자가 아니라 입력 해상도의 1/4 로 키워지기 때문입니다. 격자가 같아 백본과 디코더의 일은 같아도, 뒤의 모델은 분할 머리가 1.78배의 칸을 다루고(더 느리고) 마스크는 더 세밀합니다. 해상도가 “공간 위치 수” 와 “분할 특징의 해상도” 를 함께 움직이므로, 논문 부록 L 의 말대로 파레토 최적점이 탐지와 다른 곳에 놓입니다.
이 장의 실험에서 (가) 사각형은 “예측 박스를 영역으로 쓴 것” 의 IoU(0.9538)가 예측 마스크(0.9452)보다 높았고, 삼각형은 0.48 대 0.90 으로 정반대였습니다. 왜 그런가요? (나) 그림 13-7 에서 클래스 점수가 0.00 인 질의가 원 하나를 깨끗한 마스크로 그렸습니다. 왜 그럴 수 있고, 이 마스크가 최종 예측에 섞이지 않는 까닭은 무엇인가요? (다) 분할 머리를 달고 4 에폭 학습하면 박스 AP 가 0.934 에서 0.907 로 떨어졌습니다. 이것이 “체크포인트에서 다시 시작한 탓” 이 아니라는 것을 어떤 실험이 보여 주나요?
답 보기
(가) 사각형은 박스가 곧 모양입니다. 박스는 실수 좌표 네 개라 변을 픽셀보다 세밀하게 놓을 수 있는데, 마스크는 24×24 격자의 로짓을 키운 것이라 모서리가 둥글어지고 변이 한 칸 안에서 흔들립니다. 삼각형은 박스의 절반이 배경이라, 박스가 아무리 정확해도 영역으로서의 IoU 가 0.5 를 넘지 못합니다. 마스크의 이득은 객체의 모양이 박스와 다를수록 큽니다.
(나) 마스크 손실은 정답과 매칭된 질의에만 걸립니다. 짝이 없는 질의의 마스크는 어떤 모양이어도 벌을 받지 않으므로, 픽셀 임베딩과 내적했을 때 우연히(또는 짝이 된 이웃 질의와 비슷한 임베딩을 가져서) 객체를 그려도 이상하지 않습니다. 후처리는 마스크를 보지 않고 클래스 점수가 높은 순으로 예측을 고르므로, 점수가 0.00 인 이 질의는 뽑히지 않습니다.
(다) 절제 실험의 대조군입니다. 분할 머리 없이, 같은 체크포인트에서 같은 설정으로 4 에폭을 더 학습한 모델의 박스 AP 는 0.934(시드 3개 0.9335 – 0.9354)로 떨어지지 않았습니다. 다시 시작한 것은 같고 마스크 손실만 다르므로, 하락은 마스크 손실에서 온 것입니다. 마스크 손실을 하나만 썼을 때 하락 폭이 절반쯤으로 준 것도 같은 쪽을 가리킵니다.
박스에서 마스크로 넘어오는 데 필요한 것은 생각보다 적었습니다. 탐지기는 그대로 두고, 프로젝터 출력을 키워 다듬은 픽셀 임베딩 맵 하나와 질의 쪽의 작은 FFN 하나, 그리고 내적 한 번입니다.
여기까지로 RF-DETR 을 이루는 생각은 모두 손으로 만들어 보았습니다. 백본과 프로젝터, 변형 어텐션 디코더, 집합 손실과 학습 설정, 가중치 공유 NAS, 분할 머리까지입니다.
14장에서는 미니 모델을 내려놓고 진짜 rfdetr 패키지를 씁니다. 사전 학습된 가중치로 추론하고, 도형 세상 데이터를 COCO 형식으로 만들어 미세 조정하고, ONNX 로 내보내 속도를 재 봅니다.