시작하기
이 튜토리얼은 실시간 객체 탐지기 RF-DETR 을 머신러닝 초급자가 처음부터 끝까지 혼자 따라갈 수 있도록 쓴 글입니다. “박스를 숫자로 어떻게 적지?” 라는 질문에서 시작해, 채점 · 손실 · 어텐션 · DETR 계보를 하나씩 쌓고, 마지막에는 RF-DETR 의 구조 · 학습 · 구조 탐색 · 분할을 작은 크기로 직접 만들어 돌려 본 뒤 공개된 진짜 모델을 내 데이터에 맞춥니다. 이 장은 그 길의 지도와 준비물입니다.
- 튜토리얼 전체의 지도: 16개 장이 어떤 순서로 무엇을 쌓는지, 급할 때의 지름길
- 실습 준비: Python · PyTorch 설치, 실습 파일과 각각 실제로 걸린 시간, GPU 가 필요한 곳
- 무대인 도형 세상(Shape World)이 어떤 데이터인지
- 표기법 약속: 박스의 두 표현, 기호, 통일해서 쓰는 용어
- 이 페이지의 쓰임새: 용어 · 수식 팝업, 풀이 상자, 코드 상자
이 튜토리얼이 약속하는 것
RF-DETR 을 소개하는 글은 대개 “DINOv2 백본에 LW-DETR 디코더를 얹고 NAS 를 했다” 는 한 줄에서 시작합니다. 초급자에게는 그 한 줄의 낱말 하나하나가 벽입니다. 이 튜토리얼은 그 벽을 밑에서부터 쌓아 올라가며 넘습니다. 약속은 네 가지입니다.
- 건너뛰지 않습니다. 수식이 나오면 한 줄씩 풀고, 각 줄 옆에 “왜 이렇게 되는지” 를 적습니다. 식마다 숫자를 넣은 손계산을 곁들이고, 같은 값을 코드로도 계산해 맞춰 봅니다.
- 직접 만들어 봅니다. IoU, AP, 어텐션, 헝가리안 매칭, 변형 어텐션, 윈도 어텐션, 손실, NAS, 분할 머리를 모두 PyTorch 로 구현합니다. 코드는 실제로 돌려 본 것이고, 본문의 출력 · 그래프 · 그림은 그 코드가 만든 결과 그대로입니다.
- 같은 세상에서 끝까지 갑니다. 2장부터 13장까지의 실습은 모두 도형 세상 이라는 하나의 작은 데이터에서 합니다(14장은 같은 장면을 더 크게 그려 씁니다). 데이터가 같으니 모델이 바뀌는 것에만 집중할 수 있고, 장마다의 결과를 서로 견줄 수 있습니다.
- 나온 대로 적습니다. 작은 실험에서는 논문의 기법이 기대만큼 듣지 않을 때도 있습니다. 그런 결과도 고르거나 다듬지 않고 적고, 왜 그럴 수 있는지를 따집니다. 또 이 튜토리얼의 미니 실험에서 본 것과 논문이 COCO 에서 보고한 것을 늘 나눠 적습니다.
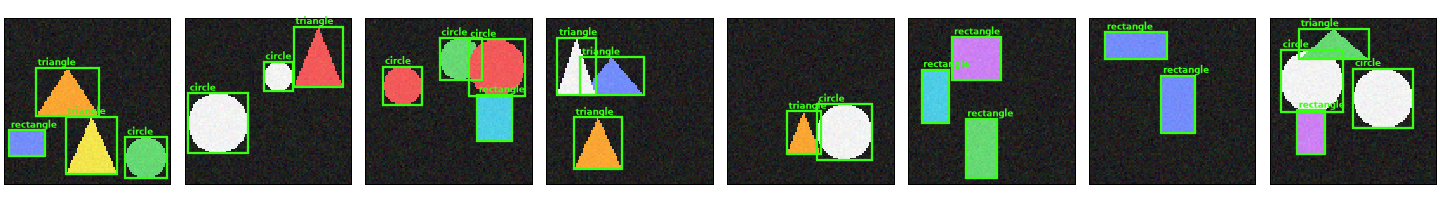
ShapesDataset(8, seed=0)). 초록 사각형이 정답 박스, 그 위의 글자가 정답 클래스입니다.
탐지기가 할 일은 그림만 보고 이 초록 박스와 이름을 맞히는 것입니다. 도형끼리 조금 겹치기도 하고, 박스가 서로 걸치기도 합니다.
누구를 위한 글인가
- 객체 탐지를 처음 배우는데, YOLO 사용법이 아니라 원리 를 알고 싶은 분.
- DETR 계열 논문을 펼쳤다가 “헝가리안 매칭”, “변형 어텐션” 에서 멈춘 분.
- RF-DETR 을 내 데이터에 써야 하는데, 설정값 하나하나가 무슨 뜻인지 알고 쓰고 싶은 분.
끝까지 읽으면 얻는 것
- 탐지 논문의 표(AP, AP50, 지연 시간)를 정의부터 읽는 눈.
- DETR → Deformable DETR → LW-DETR → RF-DETR 로 무엇이 왜 바뀌었는지에 대한 설명.
- RF-DETR 의 순전파와 손실을 텐서 모양까지 따라갈 수 있는 이해, 그리고 직접 짠 미니 구현.
rfdetr패키지로 추론 · 미세 조정 · 내보내기를 하고, 그 안에서 무슨 일이 벌어지는지 아는 것.
RF-DETR 을 한 문장으로
1장에서 자세히 다루지만, 먼저 한 문장으로 정리해 두겠습니다.
RF-DETR 은 그림을 받아 “어디에 무엇이 있는지” 를 박스 · 클래스 · 점수의 묶음으로 내놓는 실시간 객체 탐지기입니다. DINOv2 로 사전 학습한 ViT 백본 위에 LW-DETR 계열의 가벼운 디코더를 얹었고, 가중치 공유 NAS 로 한 번의 학습에서 빠른 모델부터 정확한 모델까지 여럿을 꺼냅니다.
탐지기가 하는 일을 식으로 쓰면 다음과 같습니다. 그림 한 장이 들어가고, 예측 $N$ 개가 나옵니다.
$b_i$ 는 $i$ 번째 예측의 박스(숫자 네 개), $c_i$ 는 클래스(도형 세상에서는 원 · 사각형 · 삼각형 가운데 하나), $s_i$ 는 점수(0 과 1 사이, 클수록 확신이 큽니다)입니다. 중괄호는 이 묶음이 집합, 곧 순서가 없는 모음이라는 뜻입니다. 이 식을 이루는 것들을 하나씩 채워 가는 것이 이 튜토리얼의 줄거리입니다.
- 박스를 숫자로 적고 두 박스가 얼마나 겹치는지 재는 법 (2장)
- 예측 묶음이 얼마나 좋은지 숫자 하나로 채점하는 법 (3장)
- 화살표, 곧 탐지기 안의 신경망 · 어텐션 · 백본 (4 – 6장)
- “집합을 내놓도록” 학습시키는 법과 그 개량들 (7 – 9장)
- 그 모두를 조립한 RF-DETR (10 – 13장)
튜토리얼 지도
전체는 16개 장(00 – 15)입니다. 지금 읽는 00장을 빼면 크게 네 단계로 나뉩니다. 각 단계가 다음 단계의 재료가 되므로 처음이라면 순서대로 읽기를 권합니다.
장마다 한 줄로
“배우는 것” 은 그 장의 개념, “도형 세상에서 해 보는 것” 은 그 장의 실습입니다. 괄호 안의 AP 는 그 장의 본 실행이 낸 값으로, 0 과 1 사이로 적은 것입니다(읽는 법은 3장).
| 장 | 배우는 것 | 도형 세상에서 해 보는 것 |
|---|---|---|
| 01 | 객체 탐지가 어떤 문제인지, 탐지기의 계보, “실시간” 과 파레토 곡선, RF-DETR 의 큰 그림. 수식 없이 읽습니다. | 코드 없음 |
| 02 | 박스의 두 표현, IoU 와 GIoU, 박스 회귀 손실(L1 · GIoU)과 그 기울기. | IoU · GIoU 를 구현해 손계산과 맞추고, 경사 하강법으로 박스 하나를 정답에 맞춥니다. |
| 03 | 참 양성 · 거짓 양성 · 거짓 음성, 정밀도와 재현율, PR 곡선, COCO 방식 AP, NMS. | 정답을 흐트러뜨린 “가짜 탐지기” 로 AP 가 무엇에 반응하는지 봅니다. |
| 04 | 신경망 · 역전파 · AdamW · 정규화 층을 훑고, 시그모이드 · BCE · 포컬 손실을 끝까지 유도합니다. | 양성이 약 0.6% 뿐인 분류 문제를 세 가지 설정으로 학습해 비교합니다. |
| 05 | 질의 · 열쇠 · 값으로 어텐션 손계산, 다중 머리 어텐션, 위치 인코딩, Transformer 층. | 학습되는 질의가 교차 어텐션 한 층으로 정해진 색의 도형을 찾습니다. |
| 06 | 그림을 패치로 잘라 넣는 ViT, 위치 임베딩 보간, 라벨 없이 배우는 DINO 와 DINOv2. | MiniViT 를 지도 학습하고, 미니 DINO 로 자기 증류를 돌려 봅니다. |
| 07 | 탐지를 집합 예측으로 보기, 헝가리안 매칭, 집합 손실, 객체 질의, 보조 손실. | 미니 DETR 을 처음부터 학습하고(검증 AP 0.8375) NMS 가 필요 없는지 확인합니다. |
| 08 | 쌍선형 보간, 변형 어텐션, 박스 반복 정제, 2단계 질의 선택. | 미니 Deformable DETR 을 7장과 같은 조건으로 학습해(검증 AP 0.8982) 견줍니다. |
| 09 | RT-DETR 의 생각, LW-DETR 의 부품: 윈도 어텐션, C2f 프로젝터, IA-BCE, Group DETR, 박스 재매개변수화. | 부품을 하나씩 구현해 식 · 손계산과 맞춥니다(학습은 하지 않습니다). |
| 10 | RF-DETR 의 순전파 여덟 단계와 텐서 모양, 매개변수 30,467,298개(RF-DETR Nano)를 부품별로 세기. | 9장까지의 부품으로 MiniRFDETR 을 조립하고 진짜 Nano 와 나란히 놓습니다. |
| 11 | 전체 손실, 스케줄러 없는 학습, 기울기 자르기, EMA, 층별 학습률 감쇠, 사전 학습. | 미니 RF-DETR 을 60 에폭 학습하고(EMA 모델의 검증 AP 0.9347) 절제 실험 다섯 가지를 읽습니다. |
| 12 | 파레토 최적, 가중치 공유 NAS, 다섯 손잡이, 지연 시간을 바르게 재는 법. | 한 번 학습한 모델에서 408개 구성을 꺼내 파레토 곡선을 그립니다. |
| 13 | 질의 임베딩과 픽셀 임베딩의 내적으로 만드는 마스크, 마스크 BCE 와 다이스 손실. | 11장의 모델에 분할 머리를 달아 30 에폭 학습합니다(마스크 AP 0.8766). |
| 14 | rfdetr 패키지: 추론, COCO 형식 데이터, 미세 조정, 평가, ONNX 내보내기. |
RF-DETR Nano 를 도형 세상에 5 에폭 미세 조정하고(시험 세트 AP 0.9830) ONNX 로 내보내 시간을 잽니다. |
| 15 | 부록: 막혔을 때의 점검표, 수식 모음, 용어집, 더 읽을 논문. | 코드 없음 |
7 · 8 · 11장의 값은 같은 검증 세트(그림 500장)에서 잰 것이지만 모델의 크기와 학습 설정이 서로 다르고, 14장은 그림 크기(192 픽셀)와 평가 세트가 다릅니다. “어느 기법이 얼마나 낫다” 는 결론은 조건을 맞춘 비교에서만 나옵니다. 각 장이 무엇을 말할 수 있고 무엇은 말할 수 없는지를 따로 짚습니다. 그리고 이 값들은 모두 도형 세상의 것입니다. 논문이 COCO 에서 보고한 값과 섞어 읽으면 안 됩니다.
단계별로 무엇을 얻는가
| 단계 | 장 | 끝나면 할 수 있는 것 |
|---|---|---|
| 1. 기초 체력 | 01 – 06 | RF-DETR 이 왜 나왔는지 설명하기. IoU · GIoU · AP 를 손으로 계산하기. 포컬 손실의 기울기 유도하기. 어텐션 한 번을 손으로 계산하기. ViT 의 토큰 수와 매개변수 수 세기. |
| 2. DETR 계보 | 07 – 09 | 비용 행렬에서 헝가리안 매칭을 손으로 풀기. NMS 없는 탐지기를 처음부터 학습하기. 변형 어텐션의 표본점 하나를 손으로 읽기. LW-DETR 의 부품이 각각 무엇을 덜어 냈는지 말하기. |
| 3. RF-DETR | 10 – 13 | 그림 한 장이 박스 300개가 되기까지의 텐서 모양 따라가기. 전체 손실을 손으로 계산하기. 한 번 학습한 모델에서 손잡이를 돌려 여러 모델 꺼내기. 탐지기에 분할 머리 달기. |
| 4. 실전 | 14 – 15 | 공개된 RF-DETR 로 추론하고, 내 데이터를 COCO 형식으로 만들어 미세 조정하고, ONNX 로 내보내 지연 시간 재기. 학습이 안 될 때 어디부터 볼지 알기. |
읽는 방법 세 가지와 지름길
목적에 따라 읽는 깊이를 고를 수 있습니다. 어느 길을 가든 각 장의 “핵심” 상자 와 그림 은 꼭 보세요.
| 길 | 이런 분께 | 읽는 법 |
|---|---|---|
| A. 직관의 길 | 개념만 빨리 잡고 싶은 분 | 모든 장의 도입 · 그림 · 핵심 상자 · “이 장의 정리” 만 읽고, 풀이 상자는 결과 줄(파란 바탕)만 봅니다. 코드는 돌리지 않습니다. |
| B. 수학의 길 | 논문을 읽을 수 있게 되고 싶은 분 | 모든 장을 순서대로, 풀이 상자를 한 줄씩 종이에 따라 쓰며 읽습니다. 확인 문제를 풀어 봅니다. |
| C. 구현의 길 | 직접 만들어 보고 싶은 분 | B 의 길에 더해, 각 장의 실습 파일을 직접 실행하고 본문의 출력과 견주어 봅니다. 숫자를 바꿔 다시 돌려 봅니다. |
급한 분을 위한 지름길
시간이 없다면 목적에 맞는 길 하나만 골라 가세요. 건너뛴 장의 낱말은 본문의 용어 팝업(아래 “이 페이지 쓰는 법”)으로 메울 수 있습니다.
| 목적 | 읽을 장(순서대로) | 건너뛰어도 되는 것 |
|---|---|---|
| 내 데이터에 당장 써야 한다 | 01 → 02 앞부분(박스의 두 표현, IoU) → 03 앞부분(AP 의 뜻) → 14 | 유도 전부. 14장이 “이 설정은 몇 장의 무엇” 이라고 가리킬 때 그 절만 찾아가 읽습니다. |
| RF-DETR 논문을 읽어야 한다 | 01 → 05 → 07 → 08 → 09 → 10 → 11 → 12 | 2 – 4 · 6장은 필요할 때 찾아봅니다. 13장은 분할에 관심이 있을 때만. |
| DETR 이 무엇인지만 알면 된다 | 01 → 02 → 05 → 07 | 8장부터는 DETR 을 빠르고 가볍게 만드는 이야기입니다. |
| NAS 부분만 궁금하다 | 01 → 06 의 해상도 · 패치 크기 절 → 10 → 12 | 12장은 10장의 모델과 11장의 학습 코드를 가져다 쓰지만, 읽기만 한다면 11장은 결과만 봐도 됩니다. |
- 수식에서 막히면 그 줄의 “↳” 설명을 먼저 읽습니다.
- 기호가 낯설면 그 수식을 눌러 봅니다. 그 자리에서의 뜻이 나옵니다.
- 앞 장의 개념이 가물가물하면 본문의 장 링크를 따라가거나, 점선 밑줄이 그어진 낱말을 눌러 요약을 봅니다.
- 모든 용어는 15장 부록의 용어집에 모아 두었습니다.
준비물
배경지식
이 튜토리얼은 다음 정도만 알고 있다고 가정합니다.
- Python 기초: 변수, 함수,
for반복문, 리스트 · 사전, 클래스를 읽을 수 있는 정도. - 고등학교 수학: 함수, 지수 · 로그, 그래프, 간단한 미분(“기울기”), 좌표 평면. 잊어버렸어도 괜찮습니다. 필요할 때 다시 설명합니다.
다음은 몰라도 됩니다. 필요한 만큼 본문에서 처음부터 설명합니다.
- 행렬과 벡터의 곱: 어텐션을 다루는 5장에서 모양과 함께 설명합니다.
- 확률: 4장에서 BCE 를 유도할 때 필요한 만큼만 씁니다.
- 딥러닝과 PyTorch: 4장에서 뒤 장들이 쓰는 부품을 정리합니다.
- 컴퓨터 비전: 합성곱은 4장, 그림을 토큰으로 바꾸는 법은 6장에서 다룹니다.
4장은 신경망 · 역전파 · 옵티마이저를 “뒤 장을 읽는 데 필요한 만큼” 훑습니다. 역전파 손계산이나 확률 · KL 발산의 유도를 더 느린 호흡으로 보고 싶다면 같은 양식으로 쓴 World Model 튜토리얼의 딥러닝 기초 장이 도움이 됩니다. 읽지 않아도 이 튜토리얼을 따라오는 데는 문제가 없습니다.
컴퓨터와 GPU
- Windows · macOS · Linux 아무것이나. 실습 코드는 장치를 cuda → mps → cpu 순으로 알아서 고릅니다.
- 2 · 3장은 GPU 를 쓰지 않습니다. CPU 로 몇 초 – 1분이면 끝납니다. 9 · 10장도 학습이 없어 금방 끝납니다.
- 모델을 학습하는 장(4 – 8장, 11 – 14장)은 GPU 가 있으면 좋습니다. 이 튜토리얼의 수치는 모두 메모리 8GB 짜리 노트북 GPU 한 장에서 냈고, 한 번의 본 실행은 길어야 30분 안팎입니다. CPU 만으로 본 실행을 했을 때의 시간은 재지 않았습니다.
-
GPU 가 없다면
--quick으로 코드가 도는 것만 확인하고 본문의 출력과 그림을 읽거나, Google Colab 같은 무료 GPU 환경을 쓰세요. -
14장의 일부(
rfdetr의 사전 학습 가중치)와 6장의 선택 실습(DINOv2 가중치 약 88MB)은 처음 실행할 때 파일을 내려받으므로 인터넷 연결이 필요합니다.
설치
Python 3.10 이상이 필요합니다. 터미널(Windows 는 “명령 프롬프트” 나 PowerShell)을 열고 다음을 차례로 입력합니다.
$ 는 입력하는 줄이라는 표시이므로 따라 치지 않습니다.
$ python --version              # Python 3.10 이상인지 확인 (macOS · Linux 는 python3)
$ mkdir rf-detr && cd rf-detr    # 실습 폴더. 실습 파일을 모두 여기에 둡니다
$ python -m venv .venv           # 이 폴더 전용 Python 환경 만들기
$ source .venv/bin/activate      # Windows 는: .venv\Scripts\activate
$ pip install -r requirements.txt   # torch · numpy · matplotlib · scipy
venv(가상 환경)는 이 실습 전용 Python 방을 하나 만드는 것입니다. 여기에 설치한 패키지는 다른 프로젝트와 섞이지 않습니다.
requirements.txt 에는 2 – 13장이 쓰는 패키지 네 개가 최소 버전과 함께 적혀 있습니다.
| 패키지 | 최소 버전 | 어디에 쓰나 |
|---|---|---|
torch | 2.2 | 모든 모델과 학습 |
numpy | 1.26 | 도형 세상 그림 그리기, 수치 계산 |
matplotlib | 3.8 | 본문의 그림 |
scipy | 1.11 | 헝가리안 매칭의 풀이(linear_sum_assignment, 7장부터) |
NVIDIA GPU 를 쓰려면 requirements.txt 를 설치하기 전에 PyTorch 설치 안내
에서 자기 환경을 고르고 나오는 명령으로 CUDA 판 torch 를 먼저 설치하세요.
torchvision 은 2 – 13장에서 쓰지 않습니다. 원리를 직접 구현하는 것이 목적이기 때문입니다.
설치가 잘 되었는지 확인합니다.
$ python -c "import torch; print(torch.__version__, torch.cuda.is_available())"2.x.x True
버전 숫자가 나오면 성공입니다. 두 번째 값은 NVIDIA GPU 를 쓸 수 있으면 True, 아니면 False 입니다. 어느 쪽이든 실습을 시작할 수 있습니다.
14장만 패키지가 더 필요합니다. 14장에 이르렀을 때 설치하면 됩니다.
$ pip install "rfdetr[train,onnx]" # 14장(실전)에서만rfdetr: Roboflow 가 공개한 RF-DETR 패키지. 이 튜토리얼은 1.12.1 판에서 확인했습니다.[train]:train()과evaluate()에 필요한 패키지 묶음.[onnx]: ONNX 로 내보내고 그 파일로 추론하는 데 필요한 패키지(onnx·onnxruntime).
그 밖에 선택으로 쓰이는 패키지가 둘 있습니다. 없어도 본문 실습은 그대로 돕니다.
- 6장의 선택 실습
ch06_dinov2_features.py는transformers가 필요합니다(pip install transformers). - 10 · 13장의 실습 파일은
rfdetr가 설치되어 있으면 진짜 RF-DETR Nano 와 대조하는 부분까지 돌고, 없으면 그 부분만 건너뜁니다.
실습 코드 받기
각 장의 코드는 이 튜토리얼과 함께 있는 code/ 폴더에 파일로 들어 있습니다. 본문에 보이는 코드 상자는 그 파일의 일부를
그대로 불러온 것이라 본문과 파일이 어긋나지 않습니다. 코드 상자 머리의 “파일 열기” 로 전체 파일을 볼 수 있습니다.
먼저 공용 파일 둘입니다.
| 파일 | 장 | 내용 |
|---|---|---|
requirements.txt | — | 필요한 패키지 목록 |
rf_shapes.py | 2장부터 | 도형 세상 데이터. 2 – 14장의 실습 파일이 이 파일을 불러옵니다(직접, 또는 앞 장의 파일을 거쳐). |
받은 파일은 모두 같은 폴더 에 두고, 그 폴더에서 실행하세요. 뒤 장의 파일이 앞 장의 파일에서 함수와 클래스를 가져다 쓰기 때문입니다
(예: 11장의 학습 코드는 2 · 3 · 7 · 8 · 9 · 10장의 파일을 불러옵니다). 그림은 그 폴더 아래 figures/ 에, 체크포인트(*.pt)와 기록(*.json)은 실행한 폴더에 저장됩니다.
먼저 도형 세상 파일만 실행해 설치를 확인해 보세요.
$ python rf_shapes.py그림 (3, 96, 96) torch.float32 값 범위 0.0 1.0 박스 (cx, cy, w, h) [[0.14, 0.753, 0.216, 0.151], [0.528, 0.768, 0.31, 0.344], [0.384, 0.448, 0.382, 0.292], [0.854, 0.843, 0.247, 0.247]] 클래스 [1, 2, 2, 0] → ['사각형', '삼각형', '삼각형', '원'] 마스크 (4, 96, 96) torch.bool 그림마다의 객체 수 [4, 3, 4, 3, 2, 3, 2, 4] shapes_world.png 저장
1초 남짓이면 끝나고, 실행한 폴더에 shapes_world.png 가 생깁니다. 그림 0-1 이 바로 이 그림입니다.
출력의 박스 네 개는 그림 0-1 맨 왼쪽 그림의 것입니다. 첫 박스 [0.14, 0.753, 0.216, 0.151] 은 왼쪽 아래의 파란 사각형이고, 마지막 박스는 오른쪽 아래의 초록 원입니다.
이 숫자 네 개를 읽는 법은 아래 “표기법 약속” 에서 정리합니다.
실습 파일과 실제로 걸린 시간
장마다 쓰는 실습 파일은 다음과 같습니다. 시간은 이 튜토리얼을 쓴 컴퓨터(메모리 8GB 노트북 GPU 한 장)에서 잰 값입니다. “GPU” 라고 적힌 시간은 대부분 GPU 를 다른 작업과 나눠 쓰는 상태에서 잰 것이라, 혼자 쓰면 더 짧을 수 있습니다. 대략의 크기로만 읽어 주세요.
| 파일 | 장 | 본 실행에 걸린 시간 | --quick | 만들어지는 것 |
|---|---|---|---|---|
rf_shapes.py | 00 | 1초 남짓 | — | shapes_world.png(실행한 폴더) |
ch02_boxes.py | 02 | CPU 8 – 15초 | 약 3초 | 그림 ch02-*.png 5장 |
ch03_metrics.py | 03 | CPU 1분 남짓 | 10 – 20초 | 그림 ch03-*.png 5장 |
ch04_basics.py | 04 | GPU 5분 40초 | 약 20초 | 그림 ch04-*.png 6장 |
ch05_attention.py | 05 | GPU 약 2분 | CPU 40초 안쪽 | 그림 ch05-*.png 6장 |
ch06_vit.py | 06 | GPU 10분 30초 | GPU 약 12초 / CPU 약 30초 | 그림 ch06-*.png 6장 |
ch06_dinov2_features.py (선택) | 06 | GPU 약 1분 30초 | 있음(시간은 재지 않음) | 그림 ch06-dinov2-pca.png |
ch07_detr.py | 07 | GPU 약 15분 | CPU 약 15초 | 그림 ch07-*.png 5장, ch07_detr.pt, ch07_history.json |
ch08_deformable.py | 08 | GPU 약 27분 | CPU 약 30초 | 그림 ch08-*.png 9장, ch08_deformable.pt, ch08_two_stage.pt, ch08_history.json |
ch09_lwdetr_parts.py | 09 | GPU 약 32초 | CPU 약 7초 | 그림 ch09-*.png 5장 (학습 없음) |
ch10_rfdetr_model.py | 10 | GPU 약 35초 | CPU 약 15초 | 그림 ch10-*.png 3장 (학습 없음) |
ch11_train.py | 11 | GPU 약 17분--ablations 약 16분--pretrain 약 25분 | CPU 약 20초 | 그림 ch11-*.png, ch11_rfdetr.pt, ch11_history.json |
ch12_nas.py | 12 | GPU 약 18분--search 약 15분--finetune 약 9분 | CPU 약 20초 | 그림 ch12-*.png, ch12_nas.pt, ch12_search.json |
ch13_seg.py | 13 | GPU 약 10분--ablations 약 8분 30초 | CPU 약 30초 | 그림 ch13-*.png, ch13_seg.pt |
ch14_make_coco.py | 14 | CPU 약 15초 | 1초 남짓 | COCO 형식 폴더 ch14_shapes_coco/(그림 1,400장), 그림 ch14-coco-bbox.png |
ch14_finetune.py | 14 | GPU 약 30분 | 약 35초(학습 없이 추론만) | 학습 결과 폴더 ch14_out_pretrained/ · ch14_out_scratch/, ch14_finetune_results.json, 그림 4장 |
ch14_export.py | 14 | GPU + CPU 약 5분 | 1 – 2분 | ONNX 파일(ch14_export/), ch14_export_results.json, 그림 ch14-latency.png |
파일을 모두 같은 폴더에 두었다면 대부분은 어느 장부터 돌려도 됩니다. 다만 다음 넷은 앞의 실행이 남긴 결과 파일 을 씁니다.
ch08_deformable.py: 같은 폴더에ch07_history.json이 있으면 7장의 학습 곡선을 겹쳐 그립니다. 없어도 돕니다.ch12_nas.py --search와--finetune: 먼저python ch12_nas.py가 만든ch12_nas.pt가 있어야 합니다.ch13_seg.py: 11장의ch11_rfdetr.pt에서 출발합니다. 없으면 무작위 초기화에서 시작하므로 본문과 다른 결과가 나옵니다.- 14장:
ch14_make_coco.py→ch14_finetune.py→ch14_export.py순서로 돌립니다.
빠른 확인 모드
장별 실습 파일(ch02 – ch14)에는 모두 --quick 이 있습니다. 그림 수 · 에폭 수 · 반복 횟수를 줄여 몇 초 – 2분 안에 끝나는 축소판입니다.
$ python ch07_detr.py --quick # 2 에폭짜리 축소판, 오류 확인용- 쓰임새: 설치가 맞는지, 코드가 끝까지 도는지 확인하는 것입니다. GPU 가 없어도 됩니다.
- 주의:
--quick이 내는 수치와 그림에는 의미가 없습니다. 모델이 거의 학습되지 않은 상태이기 때문입니다. 본문의 값과 견주려면 본 실행을 해야 합니다. - 함께 쓰는 인자:
--fig-dir(그림을 저장할 폴더, 기본figures)와--seed(난수 시드, 기본 0).
시드를 고정했으므로 같은 컴퓨터에서는 같은 결과가 나옵니다. 하지만 GPU 의 종류나 PyTorch 판이 다르면 소수 셋째 – 넷째 자리가 달라질 수 있고, 학습이 길수록 그 차이가 쌓입니다. AP 가 본문과 비슷한 수준이면 제대로 돈 것입니다. 걸린 시간은 컴퓨터마다 크게 다릅니다.
무대 미리 보기: 도형 세상
이 튜토리얼의 실습은 도형 세상(Shape World) 이라는 작은 탐지 데이터에서 합니다. 실제 탐지 데이터셋인 COCO 로 RF-DETR 을 학습하려면 GPU 여러 대가 필요하지만, 도형 세상의 미니 모델은 노트북 GPU 한 장으로 십여 분이면 학습됩니다. 작아도 탐지 문제의 뼈대는 그대로 들어 있습니다. 객체의 수가 그림마다 다르고, 크기와 위치가 제각각이고, 서로 겹치기도 합니다.
- 그림: 96×96 픽셀의 RGB 그림. 텐서 모양은
(3, 96, 96), 값은 0 – 1 입니다. 배경은 어두운 회색이고 약한 잡음이 섞여 있습니다. - 객체: 한 장에 1 – 4개. 크기는 그림 한 변의 0.14 – 0.42 배이고, 그림 밖으로 나가지 않습니다.
- 클래스: 세 가지입니다. 번호 0 은 원(circle), 1 은 사각형(rectangle), 2 는 삼각형(triangle).
- 색: 여덟 가지 가운데 무작위로 칠합니다. 색은 클래스와 관계가 없으므로, 모델은 색이 아니라 모양으로 클래스를 가려야 합니다.
- 겹침: 조금 겹치는 것은 허용합니다. 나중에 그린 도형이 먼저 그린 도형을 덮습니다. 다만 다른 도형에 묻혀 거의 안 보이는 객체는 만들지 않습니다.
- 정답: 객체마다 박스
(cx, cy, w, h)와 클래스 번호. 13장에서는 객체가 차지한 픽셀을 표시한 마스크도 씁니다.
클래스는 코드에서 이렇게 정해져 있습니다.
장면 하나를 뽑는 함수가 sample_scene 입니다. 클래스 · 크기 · 중심을 차례로 뽑고, 이미 놓인 도형과 너무 많이 겹치면 다시 뽑습니다.
지금 이 코드를 모두 이해할 필요는 없습니다. 눈여겨볼 것은 장면을 0 – 1 로 정규화한 좌표 로 적어 둔다는 점입니다. 그래서 같은 장면을 96 픽셀로도, 더 크게도 그릴 수 있습니다. 2 – 13장은 96 픽셀을 기본으로 쓰고, 12장의 NAS 는 해상도를 바꿔 가며 그리고, 14장은 192 픽셀로 그립니다.
실습 파일은 장면을 하나씩 뽑지 않고 ShapesDataset 으로 한꺼번에 만들어 씁니다.
기억해 둘 약속은 세 가지입니다.
-
정답의 형식: 그림 한 장의 정답은 사전 하나입니다.
"boxes"는 모양(객체 수, 4)의 정규화(cx, cy, w, h),"labels"는 모양(객체 수,)의 클래스 번호입니다. -
배치: 그림은 한 텐서
(B, 3, 96, 96)로 쌓지만, 정답은 그림마다 객체 수가 달라 쌓을 수 없으므로 목록 으로 둡니다(collate). “개수가 그림마다 다르다” 는 탐지의 어려움이 데이터를 읽는 자리에서부터 드러납니다. -
시드:
seed가 같으면 언제나 같은 데이터가 나옵니다. 이 튜토리얼은 학습용에seed=0, 검증용에seed=1, 시험용에seed=2를 씁니다.
도형 세상은 원리를 손에 익히기 위한 장난감입니다. 실제 사진에는 질감 · 조명 · 가림 · 수십 – 수백 개의 클래스가 있고, 객체가 훨씬 작거나 많습니다. 도형 세상에서 어떤 기법이 효과가 없었다고 해서 COCO 에서도 그렇다는 뜻이 아니고, 그 반대도 마찬가지입니다. 실제 데이터에서의 성능은 논문이 보고한 값을 출처와 함께 따로 적습니다.
표기법 약속
수식은 “짧게 쓴 문장” 일 뿐입니다. 기호 몇 가지만 익히면 한국어 문장처럼 읽을 수 있습니다. 이 튜토리얼에서 쓰는 약속을 미리 모아 두었습니다. 지금 다 외울 필요는 없고, 낯설 때 돌아와 찾아보세요.
박스를 적는 두 가지 방법
박스는 숫자 네 개입니다. 같은 박스를 적는 방법이 둘 있고, 이 튜토리얼은 쓰임새에 따라 둘을 오갑니다. 자세한 것은 2장에서 다룹니다.
| 이름 | 기호 | 코드에서의 이름 | 뜻 | 주로 쓰는 곳 |
|---|---|---|---|---|
| 중심 표현 | $(c_x, c_y, w, h)$ | cxcywh |
중심의 가로 · 세로 좌표, 너비, 높이 | 데이터의 정답, 모델의 출력, L1 손실 |
| 모서리 표현 | $(x_0, y_0, x_1, y_1)$ | xyxy |
왼쪽 위 모서리와 오른쪽 아래 모서리의 좌표 | 넓이 · IoU · GIoU 계산, 그림 위에 그리기 |
- 정규화 좌표: 따로 말하지 않으면 좌표는 그림의 너비 · 높이로 나눈 0 – 1 의 값입니다. 96 픽셀 그림에서 픽셀로 바꾸려면 96 을 곱합니다.
- 원점과 방향: 원점은 그림의 왼쪽 위 이고, 가로 좌표는 오른쪽으로, 세로 좌표는 아래로 갈수록 커집니다. 수학 시간의 좌표 평면과 세로 방향이 반대입니다.
- 번호는 0 부터: 클래스 번호, 층 번호 같은 코드의 번호는 0 부터 셉니다. 본문에서 1 부터 셀 때는 그렇다고 밝힙니다.
- COCO 형식은 또 다릅니다: 14장에서 만나는 COCO 형식은 픽셀 단위의
[x, y, w, h]이고, 앞의 두 수가 중심이 아니라 왼쪽 위 모서리입니다. 14장에서 서로 바꾸는 법을 다룹니다.
텐서 모양과 수치를 적는 법
-
텐서 모양:
(B, N, D)처럼 괄호 안에 축의 길이를 적습니다.B는 배치 크기(한 번에 넣는 그림 수),N은 토큰이나 질의의 수,D는 벡터의 차원입니다. 모양이 바뀌는 자리마다 새 모양을 밝힙니다. - AP 의 눈금: 이 튜토리얼의 실험 출력은 AP 를 0.9347 처럼 0 – 1 로 적습니다. 논문은 여기에 100 을 곱해 48.0 처럼 적습니다. “48.0 AP” 는 0.480 입니다.
- 출처의 구별: 수치 앞에 “이 튜토리얼의 실험에서는” 과 “논문(표 N)에서는” 을 구별해 적습니다. 논문과 공개 코드가 서로 다를 때는 둘을 나란히 적습니다.
- 로그: 수식의 log 는 모두 자연로그(밑이 약 2.718)입니다.
그리스 문자
“자세히” 칸은 그 뜻으로 처음 쓰는 장입니다.
| 기호 | 읽는 법 | 이 튜토리얼에서 주로 쓰는 뜻 | 자세히 |
|---|---|---|---|
| $\alpha$ | 알파 (alpha) | 포컬 손실의 균형 가중치(0.25). 9장부터는 IA-BCE 의 지수로도 씁니다 | 4장 |
| $\gamma$ | 감마 (gamma) | 포컬 손실에서 쉬운 칸을 얼마나 세게 깎을지 정하는 지수(2) | 4장 |
| $\eta$ | 에타 (eta) | 학습률 (한 스텝에 얼마나 고칠지) | 4장 |
| $\theta$ | 세타 (theta) | 신경망의 매개변수 전체(가중치와 편향) | 4장 |
| $\sigma(z)$ | 시그마 (sigma) | 시그모이드 함수. 실수 $z$ 를 0 과 1 사이의 값으로 바꿉니다. 7장에서만은 $\sigma$ 가 매칭의 배정을 뜻합니다 | 4장 |
| $\lambda$ | 람다 (lambda) | 손실의 항들을 섞는 계수. 그 밖에 가중치 감쇠의 세기(4장), 층별 학습률 감쇠율(11장)로도 쓰며, 그때마다 본문에서 밝힙니다 | 2장 |
| $\tau$ | 타우 (tau) | IoU 문턱값. 그 밖에 소프트맥스의 온도(6장), EMA 감쇠가 올라가는 빠르기(11장), 점수 문턱값(14장)으로도 씁니다 | 3장 |
| $\delta$ | 델타 (delta) | 박스 머리가 내는 변화량. 기준 박스를 얼마나 옮기고 키울지 | 9장 |
| $\sum$ | 시그마 (대문자) | 합. 아래 · 위에 적힌 범위에 걸쳐 더합니다 | — |
| $\prod$ | 파이 (대문자) | 곱. 아래 · 위에 적힌 범위에 걸쳐 곱합니다 | — |
자주 쓰는 기호
| 기호 | 읽는 법 | 뜻과 예 | 자세히 |
|---|---|---|---|
| $b$, $\hat{b}$ | 비, 비 햇 | $b$ 는 정답 박스, 모자(^)를 쓴 $\hat{b}$ 는 모델이 예측한 박스. 모자는 늘 “예측값” 이라는 표시입니다 | 2장 |
| $\IoU(\hat{b}, b)$ | 아이오유 | 두 박스의 교집합 넓이 ÷ 합집합 넓이. 0(안 겹침) – 1(똑같음) | 2장 |
| $\GIoU(\hat{b}, b)$ | 지아이오유 | 겹치지 않는 박스끼리도 얼마나 먼지 말해 주도록 고친 IoU. −1 – 1 | 2장 |
| $\AP$ | 에이피 | 평균 정밀도. 탐지기의 성적표에 쓰는 숫자 하나 | 3장 |
| $z$, $p$ | 제트, 피 | $z$ 는 로짓(시그모이드에 넣기 전의 실수), $p = \sigma(z)$ 는 그것을 확률로 바꾼 값 | 4장 |
| $\theta \leftarrow \theta - \eta \nabla_\theta L$ | 세타를 … 로 갱신 | 화살표는 “오른쪽을 계산해 왼쪽에 새로 넣는다”. $\nabla_\theta L$ 은 손실 $L$ 의 기울기입니다. 경사 하강법 한 스텝을 적은 식입니다 | 4장 |
| $\frac{\partial L}{\partial z}$ | 엘을 제트로 편미분 | 다른 것은 그대로 두고 $z$ 만 조금 바꿀 때 $L$ 이 바뀌는 비율 | 4장 |
| $\softmax(QK^\top / \sqrt{d_k})\,V$ | 소프트맥스 큐 케이 전치 … | 어텐션 한 번. $Q$ · $K$ · $V$ 는 질의 · 열쇠 · 값을 행으로 쌓은 행렬, $^\top$ 은 행과 열을 바꾸는 전치 | 5장 |
| $\argmin$, $\argmax$ | 아그민, 아그맥스 | 뒤의 값을 가장 작게(크게) 만드는 입력. 최솟값 자체가 아니라 그때의 입력입니다. 7장의 매칭이 “비용이 가장 작은 배정” 을 이렇게 적습니다 | 7장 |
| $\varnothing$ | 공집합 기호 | “객체 없음” 클래스. 객체를 맡지 않은 질의가 내야 하는 답 | 7장 |
| $\sg(\hat{b})$ | 기울기 차단 (stop-gradient) | 값은 그대로 쓰되, 이 부분으로는 기울기를 흘리지 않습니다 | 8장 |
| $\approx$ | 근사적으로 같다 | 정확히는 아니지만 거의 같다 | — |
| $:=$ | 정의한다 | 왼쪽 이름을 오른쪽 식으로 정한다 | — |
장이 열넷이다 보니 같은 글자가 장마다 다른 뜻으로 쓰이는 곳이 있습니다. 널리 쓰이는 관례를 따르느라 그렇습니다. 대표적인 것은 다음과 같습니다.
- $p$: 4장부터의 손실에서는 확률, 6 · 10 · 12장의 구조 이야기에서는 패치 크기(픽셀).
- $N$: 5 · 6 · 9장에서는 토큰의 수, 7장부터의 디코더 이야기에서는 객체 질의의 수.
- $K$: 4 · 7 · 11장에서는 클래스의 수, 8 · 10장에서는 변형 어텐션의 표본점 수.
- $L$: 4장에서는 손실, 6장부터는 층의 수로도 씁니다. 7장부터 손실은 주로 $\mathcal{L}$ 로 적습니다.
헷갈릴 때는 그 수식을 눌러 보세요. 그 장 · 그 절에서의 뜻이 나옵니다. 한 장 안에서 두 뜻으로 쓸 수밖에 없는 곳은 본문의 “주의” 상자로 밝혀 두었습니다.
용어를 통일하는 원칙
탐지 분야의 글은 영어 낱말을 소리 나는 대로 옮겨 쓰는 일이 많아, 같은 것을 두세 가지 이름으로 부르곤 합니다. 이 튜토리얼은 다음 원칙을 지킵니다.
- 한 개념에는 한 이름만 씁니다. 처음부터 끝까지 같은 낱말로 부릅니다.
- 뜻이 드러나는 우리말을 고릅니다. 처음 나올 때 영어 원어를 한 번 함께 적습니다.
- 모델 · 논문 · 데이터셋의 이름은 영어 그대로 씁니다. DETR, Deformable DETR, LW-DETR, RF-DETR, DINOv2, ViT, Transformer, COCO 가 그렇습니다.
- 코드의 이름은 코드 글꼴로 그대로 씁니다.
num_queries,class_embed처럼 공식 구현의 식별자는 바꾸지 않습니다.
논문이나 다른 글과 맞춰 읽을 때 필요한 대응표입니다.
| 영어 | 이 튜토리얼의 말 | 메모 |
|---|---|---|
| bounding box | 박스 | “경계 상자” 라고도 합니다 |
| ground truth | 정답 | 정답 박스, 정답 클래스 |
| score, confidence | 점수 | “신뢰도” 라고도 합니다 |
| threshold | 문턱값 | IoU 문턱값, 점수 문턱값 |
| backbone / projector / head | 백본 / 프로젝터 / 머리 | 분류 머리, 박스 머리, 분할 머리. multi-head attention 은 다중 머리 어텐션 |
| query / key / value | 질의 / 열쇠 / 값 | object query 는 객체 질의 |
| self- / cross-attention | 자기 어텐션 / 교차 어텐션 | |
| deformable attention | 변형 어텐션 | reference point 는 기준점, sampling point 는 표본점 |
| Hungarian matching | 헝가리안 매칭 | cost 는 비용, assignment 는 배정 |
| weight / parameter | 가중치 / 매개변수 | hyperparameter 만은 하이퍼파라미터 |
| gradient | 기울기 | stop-gradient 는 기울기 차단 |
| sample / noise | 표본 / 잡음 | sampling 은 표본 추출, 또는 “뽑기” |
| pre-training / fine-tuning | 사전 학습 / 미세 조정 | |
| latency / throughput | 지연 시간 / 처리량 | |
| layer / shape / hidden | 층 / 모양 / 은닉 | 텐서의 shape 가 “모양” |
| knob (NAS) | 손잡이 | 해상도 · 패치 크기 · 윈도 수 · 디코더 층 수 · 질의 수 |
띄어쓰기도 하나 약속합니다. 영어 낱말이나 숫자 · 기호 뒤의 조사는 띄어 씁니다(“DETR 은”, “IoU 가”, “0.5 를”). 조사가 어디서 시작하는지 한눈에 보이게 하기 위해서입니다.
이 페이지 쓰는 법
용어 팝업과 수식 팝업
- 점선 밑줄이 그어진 낱말 을 누르면 그 뜻 · 대표 식 · 자세히 설명한 장이 담긴 카드가 열립니다. 예: 헝가리안 매칭, 변형 어텐션.
- 수식 을 누르면 그 식에 나오는 기호가 그 자리에서 무슨 뜻인지 보여 줍니다. 같은 글자도 장 · 절마다 뜻이 다를 수 있어서입니다.
- 카드 안의 관련 항목을 누르면 같은 카드 안에서 옮겨 갑니다.
- Esc 를 누르거나 카드 바깥을 누르면 닫힙니다.
그 밖에 화면 위쪽 머리 막대에서 밝은 화면과 어두운 화면을 바꿀 수 있고, 넓은 화면에서는 오른쪽에, 좁은 화면에서는 첫 소제목 앞에 “이 장의 목차” 가 있습니다.
풀이 상자 읽는 법
이 튜토리얼에서 수식 유도와 손계산은 모두 다음과 같은 풀이 상자 에 들어 있습니다. 예로 아주 쉬운 것을 하나 풀어 보겠습니다. 정규화 중심 표현으로 $(0.5,\ 0.5,\ 0.25,\ 0.5)$ 인 박스가 96 픽셀 그림에서 가로로 어디부터 어디까지인지 구합니다.
각 줄은 바로 위 줄에서 한 가지만 바꾼 것이고, “↳” 뒤에 그 변형의 이유를 적었습니다. 줄을 건너뛰지 않으므로, 종이에 따라 쓰며 읽으면 혼자서도 모든 유도를 끝까지 따라갈 수 있습니다. 답은 늘 다른 방법으로 한 번 검산해 보세요. 여기서는 두 끝의 차이 $60 - 36 = 24$ 픽셀이 박스의 너비 $0.25 \times 96 = 24$ 픽셀과 같으니 맞습니다.
코드 상자와 출력 상자
코드 상자는 세 가지를 알면 됩니다. 위의 “무대 미리 보기” 에 있는 상자로 직접 해 보세요.
- 머리의 이름:
rf_shapes.py · scene처럼 “파일 이름 · 영역 이름” 입니다. 실습 파일 안에서 그 영역 이름으로 표시된 부분을 그대로 불러온 것입니다. - “파일 열기”: 그 파일 전체를 새 창에 엽니다. 저장해서 실행할 수 있습니다.
- 접힌 상자: 긴 코드는 접혀 있습니다. 펼쳐서 전체를 읽을 수 있습니다.
터미널에 입력하는 명령은 머리에 “터미널” 이라고 적힌 상자에, 그 명령이 낸 출력은 바로 아래의 출력 상자에 있습니다. 출력 상자의 내용은 이 튜토리얼을 쓰며 실제로 나온 출력 그대로 입니다. 본문이 인용하는 숫자는 모두 그 출력에서 온 것입니다.
다른 상자들
더 알면 좋은 배경 지식입니다. 처음 읽을 때는 건너뛰어도 됩니다.
실습 · 구현에서 도움이 되는 요령입니다.
초급자가 자주 빠지는 함정이나 헷갈리기 쉬운 부분입니다. 논문과 공개 코드가 서로 다른 곳도 여기에 적습니다.
그 절에서 꼭 가져가야 할 한두 문장입니다. 복습할 때 이것만 다시 읽어도 됩니다.
장 끝마다 확인 문제가 있습니다. 숫자를 직접 계산하는 문제가 꼭 섞여 있습니다. 하나 풀어 보세요. 96×96 그림에서 정규화 중심 표현으로 $(0.5,\ 0.5,\ 0.25,\ 0.5)$ 인 박스의 넓이는 몇 픽셀이고, 그림 전체의 몇 % 인가요?
답 보기
너비는 $0.25 \times 96 = 24$ 픽셀, 높이는 $0.5 \times 96 = 48$ 픽셀이므로 넓이는 $24 \times 48 = 1152$ 픽셀입니다. 그림 전체는 $96 \times 96 = 9216$ 픽셀이므로 $1152 / 9216 = 0.125$, 곧 12.5% 입니다. 정규화 좌표에서 바로 $0.25 \times 0.5 = 0.125$ 로 구해도 같습니다. 정규화 좌표의 넓이는 “그림에서 차지하는 비율” 입니다.
이 튜토리얼이 다루지 않는 것
- COCO · Objects365 같은 큰 데이터셋에서의 실제 학습. GPU 여러 대가 필요한 규모라 직접 하지 않고, 논문이 보고한 값을 출처와 함께 읽습니다.
- YOLO 계열 · D-FINE 등 다른 탐지기의 내부. RF-DETR 과 견주는 데 필요한 만큼만 1 · 9장에서 짚습니다.
- TensorRT 엔진 만들기와 NVIDIA T4 에서의 지연 시간 재현. 논문의 측정 절차는 12장에서 설명하고, 14장에서는 ONNX 까지 내보내 이 튜토리얼의 컴퓨터에서 잽니다.
- 열린 어휘 탐지, 키포인트 탐지, 영상에서의 추적. RF-DETR 과의 관계만 1장에서 짚습니다.
- 데이터 모으기와 라벨 붙이기의 실무. 14장은 이미 정답이 있는 데이터를 COCO 형식으로 바꾸는 데서 시작합니다.
- RF-DETR = DINOv2 백본 + LW-DETR 계열의 가벼운 디코더 + 가중치 공유 NAS 로 만든 실시간 객체 탐지기.
- 튜토리얼은 기초 체력(01 – 06) → DETR 계보(07 – 09) → RF-DETR(10 – 13) → 실전과 부록(14 – 15) 순서입니다. 급하면 목적별 지름길을 고릅니다.
- 무대는 2장부터 13장까지 도형 세상 하나(96×96, 원 · 사각형 · 삼각형 1 – 4개). 14장은 같은 장면을 192 픽셀로 그려 진짜 RF-DETR 을 미세 조정합니다.
- 실습 코드는
code/폴더에 있고 모두 같은 폴더에 두고 실행합니다. 패키지는requirements.txt의 넷이면 되고, 14장만rfdetr가 더 필요합니다. - 본 실행은 노트북 GPU 로 길어야 30분 안팎이고,
--quick은 GPU 없이도 코드가 도는 것을 확인해 줍니다. - 박스는 따로 말하지 않으면 정규화 중심 표현
(cx, cy, w, h)입니다. 원점은 왼쪽 위, 세로 좌표는 아래로 커집니다. - 낯선 낱말과 수식은 눌러서 뜻을 볼 수 있고, 유도는 풀이 상자에서 한 줄씩 풉니다.
준비가 끝났습니다. 다음 장에서 객체 탐지가 어떤 문제인지, 그리고 RF-DETR 이 그 흐름의 어디에 서 있는지를 수식 없이 큰 그림으로 잡아 보겠습니다.